O SLS oferece um service de transformação de dados (nova versão) totalmente gerenciado, escalável e com alta disponibilidade para normalização, extração, limpeza, filtragem e distribuição de dados em vários Logstores.
Como funciona
A transformação de dados (nova versão) processa dados de log em tempo real por meio de jobs de consumo hospedados e regras SPL. SPL syntax. Standard consumption overview.
A transformação de dados utiliza a API de consumo em tempo real do SLS e não depende da configuração de índice do Logstore de source.
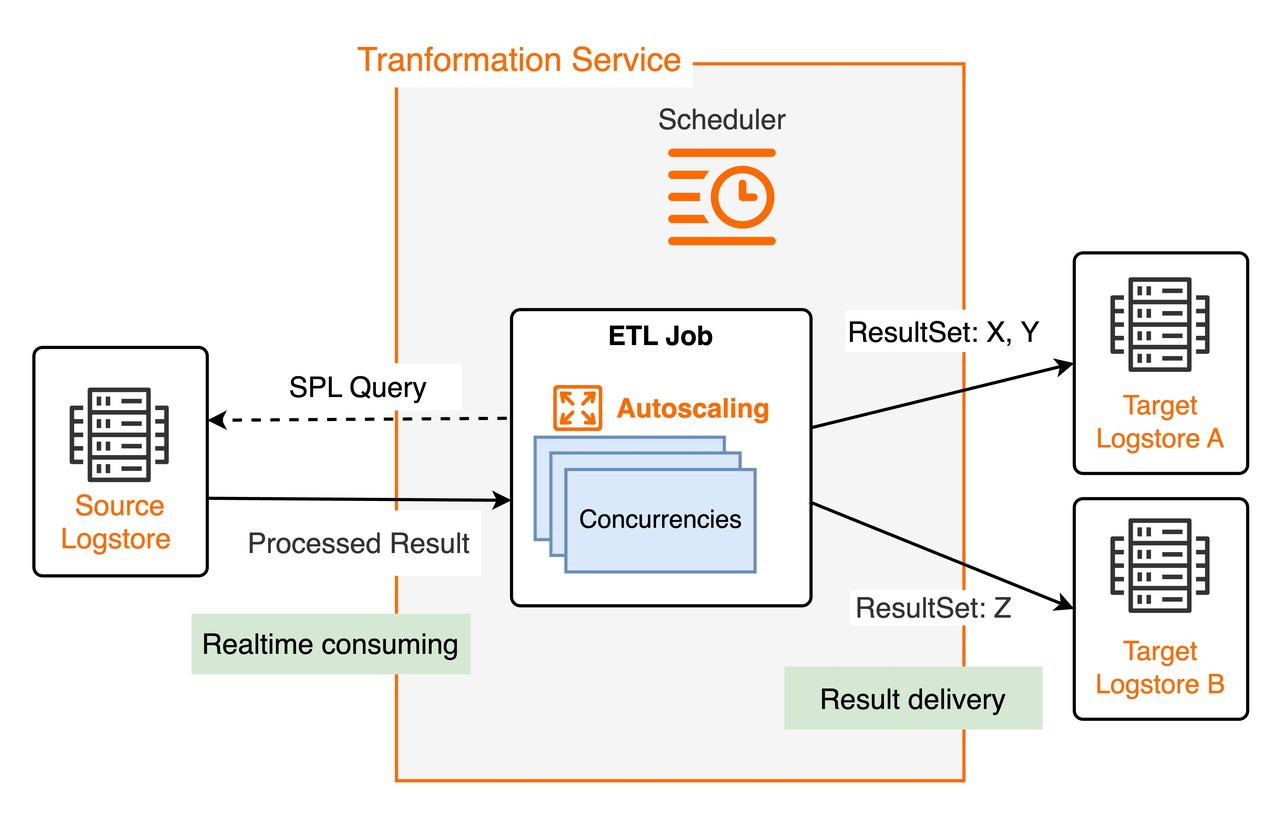
Mecanismo de agendamento
O agendador inicia uma ou mais instâncias por job para processar dados simultaneamente. Cada instância consome dados de um ou mais shards do Logstore de source. O número de instâncias se ajusta conforme o uso de recursos e o progresso do processamento, garantindo dimensionamento elástico. A concorrência máxima por job corresponde à quantidade de shards do Logstore de source.
Instâncias em execução
Com base nas regras SPL do job e nas configurações do Logstore de destino, cada instância consome dados de log de source dos shards alocados e, em seguida, distribui e grava os resultados no Logstore de destino. As instâncias salve automaticamente os checkpoints dos shards, permitindo que um job reiniciado retome o processamento a partir do último checkpoint salvo.
Parar e retomar jobs
Parada automática: Um job com horário de término configurado é interrompido após processar todos os logs anteriores a esse momento. Sem um horário de término definido, o job executa continuamente. ETL.
Processamento retomável: Após uma parada inesperada, o job reiniciado retoma automaticamente a partir do último checkpoint de shard salvo, assegurando a consistência dos dados.
Visualize status de execução do job
O SLS suporta monitoramento para jobs de transformação de dados. Observe and monitor data transformation (new version) jobs.
Cenários
A transformação de dados atende aos seguintes cenários:
Normalização de dados e extração de informações: Extraia campos de logs com formatação inconsistente e padronize os formatos para gerar dados estruturados, adequados para processamento de fluxo e análise em data warehouse.
-
Encaminhamento e distribuição de dados:
Consolide tipos mistos de logs em um único Logstore e distribua-os para Logstores downstream por característica (módulo de source, componente de negócio), promovendo isolamento de dados e computação específica por cenário.
Em implantações multirregião, agregue logs de cada região em uma região central com aceleração entre regiões para facilitar o gerenciamento centralizado.
Limpeza e filtragem de dados: Remova entradas inválidas ou campos não utilizados e grave as informações-chave filtradas em Logstores downstream para viabilizar análises focadas.
Mascaramento de dados: Oculte dados sensíveis, como senhas, números de telefone e endereços.
Recursos
O SPL oferece uma linguagem unificada para coleta, consulta e processamento de dados, reduzindo a necessidade de aprender múltiplas sintaxes.
Depuração linha a linha e sugestões de código proporcionam uma experiência de codificação SPL semelhante a um IDE.
Processamento em tempo real com visibilidade dos dados em segundos, dimensionamento elástico e alto throughput.
Instruções integradas de processamento de dados e funções SQL para análise de logs.
Métricas de observabilidade em tempo real, painéis e regras personalizadas de monitoramento baseadas em métricas de execução.
Service totalmente gerenciado e livre de manutenção, com integrações ao ecossistema de big data e open source da Alibaba Cloud.
Faturamento
Logstores com modelo pay-by-ingested-data: A transformação de dados (nova versão) é gratuita. O tráfego de saída gerado ao extrair ou gravar dados pelo endpoint público do SLS é cobrado com base no volume de dados compactados. Billable items for the pay-by-ingested-data mode.
Logstores com modelo pay-by-feature: A cobrança refere-se aos recursos de computação e rede consumidos pela transformação de dados (nova versão). Billable items for the pay-by-feature mode.
A filtragem dentro de um job de transformação de dados (nova versão) não reduz o volume de dados faturável. Isso se aplica a filtragens como a instrução SPL
wheree às funções de descarte da linguagem específica de domínio (DSL) da transformação de dados (versão antiga). No modo pay-by-ingested-data, o faturamento baseia-se nos dados brutos ingeridos no LogStore de source. A filtragem em um job de transformação afeta apenas os dados gravados no LogStore de destino; ela não altera o volume já ingerido no LogStore de source.Para reduzir o volume de dados faturável, filtre os logs no momento da coleta. Na configuração de coleta do Logtail, utilize um plug-in de filtragem de dados, como o plug-in estendido
processor_filter_regex, para coletar apenas os logs necessários — por exemplo, somente logs cujo nível seja error. Logs não coletados nunca são ingeridos em um LogStore, o que diminui o volume faturável na source e os exclui da transformação de dados. Para mais informações, consulte Logtail data filtering plug-ins.