Implante o LoongCollector no modo DaemonSet e crie uma configuração de coleta no console do SLS para centralizar a coleta de logs de contêineres do Kubernetes e habilitar o processamento estruturado, permitindo consultas e análises eficientes.
Requisitos
-
Ambiente de execução
Compatível com Container Service for Kubernetes (ACK) (edições gerenciada e dedicada) e clusters Kubernetes autogerenciados.
Kubernetes 1.10.0 ou posterior com suporte a
Mount propagation: HostToContainer.-
Runtime de contêiner (apenas Docker e Containerd)
-
Docker:
Requer acesso ao docker.sock.
A coleta de saída padrão oferece suporte apenas ao driver de log JSON.
Oferece suporte apenas aos drivers de armazenamento overlay e overlay2. Para utilizar outros tipos de drivers de armazenamento, monte manualmente o diretório de logs.
Containerd: Requer acesso ao containerd.sock.
-
-
Requisitos de recursos: O LoongCollector (Logtail) é executado com a classe de alta prioridade system-cluster-critical. A implantação em um cluster com recursos limitados pode causar a evicção de Pods existentes.
CPU: Reserve pelo menos 0,1 núcleo.
Memória: Reserve pelo menos 150 MB para o componente de coleta e pelo menos 100 MB para o componente controlador.
O uso real depende da taxa de coleta, da quantidade de diretórios e arquivos monitorados e do congestionamento de envio. Mantenha a utilização de recursos abaixo de 80% dos limites especificados.
-
Requisitos de permissão: Para realizar a implantação, a conta Alibaba Cloud ou o usuário RAM deve ter a permissão AliyunLogFullAccess.
Para criar políticas personalizadas com permissões refinadas, copie as permissões da política de sistema AliyunCSManagedLogRolePolicy e conceda-as ao usuário ou função RAM de destino.
Configuração de coleta
-
Instalar o LoongCollector: Implante o LoongCollector no modo DaemonSet. Isso garante que um contêiner de coleta seja executado em cada nó do cluster para coletar logs de todos os contêineres nesse nó.
Para o padrão Sidecar, consulte Coletar logs de texto de pods do Kubernetes (padrão Sidecar) .
Criar um Logstore: Um Logstore armazena os logs coletados.
-
Criar e configurar regras de coleta de logs
Configuração global e de entrada: Defina o nome da configuração de coleta e especifique a origem e o escopo da coleta de logs.
-
Processamento e estruturação de logs: Configure regras de processamento com base no formato do log.
Logs multilinha: Trate entradas de log que abrangem várias linhas, como pilhas de exceção Java ou tracebacks Python, definindo uma expressão regular de primeira linha para identificar o início de cada entrada.
Análise estruturada: Configure plugins de análise, como expressões regulares, delimitadores ou modo NGINX, para extrair strings brutas em pares chave-valor estruturados, possibilitando consultas e análises eficientes.
Filtragem de logs: Configure listas de bloqueios de coleta e regras de filtragem de conteúdo para excluir dados de log indesejados. Essa prática ajuda a reduzir a transmissão e o armazenamento redundantes de dados.
Categorização de logs: Configure tópicos e tags de log para distinguir logs de diferentes serviços, contêineres ou origens de caminho.
Configuração de consulta e análise: A indexação de texto completo é ativada por padrão para buscas por palavras-chave. Para consultas precisas e análise de campos estruturados, ative índices de campo a fim de melhorar a eficiência da busca.
Verificação e solução de problemas: Após concluir a configuração, verifique se os logs foram coletados com êxito. Caso encontre problemas como falha na coleta de dados, falha de heartbeat ou erros de análise, consulte as Perguntas frequentes sobre solução de problemas.
Etapa 1: Instalar o LoongCollector
O LoongCollector é o agente de coleta de logs de última geração do Simple Log Service e sucessor do Logtail. O LoongCollector e o Logtail não podem coexistir. Para instalar o Logtail, consulte Instalar, executar, atualizar e desinstalar o Logtail .
Instale o LoongCollector usando um dos métodos abaixo. Para obter detalhes sobre os parâmetros, consulte Instalação e configuração. Se o LoongCollector ou o Logtail já estiver instalado, pule para a Etapa 2: Criar um Logstore.
Alterar o horário do host enquanto o LoongCollector (Logtail) está em execução pode causar coleta duplicada ou perda de dados.
Cluster ACK
Instale o LoongCollector no console do Container Service for Kubernetes. Por padrão, os logs são enviados para um Project do Simple Log Service na conta Alibaba Cloud atual.
Faça login no ACK console. No painel de navegação à esquerda, clique em Clusters.
Clique no nome do cluster de destino.
No painel de navegação à esquerda, clique em Add-ons.
-
Mude para a aba correspondente, localize o LoongCollector e clique em Install.
NotaAo criar um cluster, você pode selecionar Enable Log Service na página Component Configurations. É possível escolher entre Create Project ou Select Project. Ao instalar o LoongCollector em um cluster existente, a caixa de diálogo de instalação permite especificar um nome de Project por meio do parâmetro
projectName. Se deixado em branco, o valor padrãok8s-log-{cluster_id}será utilizado.Após a conclusão da instalação, o Simple Log Service cria automaticamente os seguintes recursos na conta atual. Você pode visualizá-los no console do Simple Log Service.
Tipo de recurso
Nome do recurso
Descrição
Project
k8s-log-${cluster_id}Isola logs de diferentes serviços.
Para um gerenciamento flexível de logs, Crie um Project.
Grupo de máquinas
k8s-group-${cluster_id}Conjunto de nós de coleta de logs. Os endereços IP dos nós do Kubernetes mudam dinamicamente conforme o cluster escala horizontalmente, portanto, identificar um grupo de máquinas por endereço IP pode causar falhas de heartbeat. Por isso, grupos de máquinas em cenários Kubernetes utilizam um identificador personalizado. Para mais informações, consulte o Guia para associar grupos de máquinas a configurações de coleta.
ImportanteO componente LoongCollector não cria um Logstore chamado config-operation-log. Se esse Logstore já existir, o LoongCollector não gravará logs nele.
Cluster autogerenciado
-
Conecte-se ao cluster Kubernetes e execute o comando apropriado para sua região:
Regiões da China
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Regiões fora da China
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
Acesse o diretório
loongcollector-custom-k8s-packagee modifique o arquivo de configuração./loongcollector/values.yaml.* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
No diretório
loongcollector-custom-k8s-package, execute o seguinte comando para instalar o LoongCollector e suas dependências:* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
Após a conclusão da instalação, verifique se os componentes estão em execução.
Se um pod falhar ao iniciar, verifique as configurações no arquivo values.yaml e certifique-se de que as imagens necessárias foram baixadas.
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')O Simple Log Service também cria automaticamente os recursos listados abaixo. Você pode visualizá-los no console do Simple Log Service.
Tipo de recurso
Nome do recurso
Descrição
Project
O valor de
projectNameespecificado no arquivo values.yamlIsola logs de diferentes serviços.
Para um gerenciamento flexível de logs, Crie um Project.
Grupo de máquinas
k8s-group-${cluster_id}Conjunto de nós de coleta de logs. Os endereços IP dos nós do Kubernetes mudam dinamicamente conforme o cluster escala horizontalmente, portanto, identificar um grupo de máquinas por endereço IP pode causar falhas de heartbeat. Por isso, grupos de máquinas em cenários Kubernetes utilizam um identificador personalizado. Para mais informações, consulte o Guia para associar grupos de máquinas a configurações de coleta.
ImportanteO componente LoongCollector não cria um Logstore chamado config-operation-log. Se esse Logstore já existir, o LoongCollector não gravará logs nele.
Etapa 2: Criar um Logstore
Um Logstore é a unidade básica de armazenamento de logs no SLS.
Faça login no console do Simple Log Service e clique no nome do project de destino.
-
No painel de navegação à esquerda, selecione
 , clique em + e crie um Logstore:
Logstore Name: Insira um nome exclusivo dentro do project. Este nome não pode ser alterado após a criação.
Logstore Type: Selecione Standard ou Query com base na comparação de recursos.
-
Billing Mode:
Pay-by-feature (Cannot Be Changed): O faturamento é feito independentemente para cada recurso, como armazenamento, índice e operações de leitura/gravação. Este modo é adequado para casos de uso em pequena escala ou quando o uso de recursos é incerto.
Pay-by-ingested-data: O faturamento ocorre apenas pelo volume de dados brutos gravados. Este modo oferece 30 dias de armazenamento gratuito e recursos gratuitos, como transformação e entrega de dados. É ideal para casos de uso empresarial em que o período de retenção é próximo de 30 dias ou o pipeline de processamento de dados é complexo.
Data Retention Period: Quantidade de dias para reter os logs. O valor pode variar de 1 a 3.650. Um valor de 3.650 indica retenção permanente. O valor padrão é 30 dias.
Mantenha os valores padrão para as outras configurações e clique em OK. Gerenciar um Logstore.
Etapa 3: Configurar uma regra de coleta de logs
Defina quais logs coletar, como analisá-los e como filtrar o conteúdo. Em seguida, aplique a configuração a um grupo de máquinas.
Na página Logstore
 , clique no ícone
 antes do nome do Logstore desejado para expandi-lo.
-
Clique no ícone
 ao lado de Import Data. Na caixa de diálogo Quick Data Import, selecione um modelo com base na origem do log e clique em Integrate Now:
-
Para saída padrão de contêiner, selecione K8s-Standard Output-New.
Existem dois modelos disponíveis para coletar a saída padrão de contêineres: um novo e um antigo. Recomendamos o uso da versão mais recente. Para comparar as versões, consulte Apêndice: Comparação entre as versões nova e antiga da saída padrão de contêiner .
Para logs de texto do cluster, selecione Kubernetes-File.
-
-
Na seção Machine Group Configurations, conclua a configuração e clique em Next:
Scenario: Selecione Docker Containers.
Deployment method: Selecione ACK DaemonSet ou Self-managed Cluster in DaemonSet Mode.
Na lista Source Machine Group, mova o grupo de máquinas criado pelo sistema
k8s-group-${cluster_id}para a lista Applied Machine Group.
Na página Logtail Configuration, defina as configurações abaixo e clique em Next.
1. Configuração global e de entrada
Nesta etapa, defina o nome, a origem dos logs e o escopo da sua configuração de coleta.
Saída padrão de contêiner
Global Configurations
-
Configuration Name: Insira um nome personalizado para a configuração de coleta. O nome deve ser exclusivo dentro do projeto e não pode ser modificado após a criação. Convenções de nomenclatura:
Pode conter apenas letras minúsculas, dígitos, hifens (-) e sublinhados (_).
Deve começar e terminar com uma letra minúscula ou um dígito.
Configuração de entrada
-
Ative os controles Stdout and Stderr e/ou Standard Error. Ambos vêm ativados por padrão.
ImportanteNão recomendamos ativar a saída padrão e o erro padrão simultaneamente, pois isso pode causar a coleta de logs fora de ordem.
Logs de texto do cluster
Global Configurations:
-
Configuration Name: Insira um nome personalizado para a configuração de coleta. O nome deve ser exclusivo dentro do projeto e não pode ser modificado após a criação. Convenções de nomenclatura:
Pode conter apenas letras minúsculas, dígitos, hifens (-) e sublinhados (_).
Deve começar e terminar com uma letra minúscula ou um dígito.
Input Configurations:
-
File Path Type:
Path in Container: Coleta arquivos de log de dentro de um contêiner.
Host Path: Coleta logs de serviços locais na máquina host.
-
File Path: O caminho absoluto para a coleta de logs.
Linux: Deve começar com uma barra (/), como
/data/mylogs/**/*.log. Esse caminho indica todos os arquivos terminados em .log no diretório/data/mylogse seus subdiretórios.Windows: Deve começar com uma letra de unidade, como
C:\Program Files\Intel\**\*.log.
-
Maximum Directory Monitoring Depth: A profundidade máxima de diretório que o caractere curinga
**em File Path pode corresponder. O valor padrão é 0 (apenas o diretório atual) e o intervalo válido vai de 0 a 1.000.Recomendamos definir esse valor como 0 e configurar o caminho diretamente para o diretório que contém os arquivos de log.
2. Processamento e estruturação de logs
Configure regras de processamento para converter logs brutos em dados estruturados e pesquisáveis. Adicione uma amostra de log antes de configurar as regras.
Na página Logtail Configuration, na área Processor Configurations, clique em Add Sample Log e insira o conteúdo do log que deseja coletar. O sistema usa a amostra para identificar o formato do log e ajudar a gerar expressões regulares e regras de análise, o que simplifica o processo de configuração.
Caso de uso 1: Processar logs multilinha
Logs como stack traces do Java e objetos JSON frequentemente abrangem várias linhas. Por padrão, eles são divididos em registros incompletos. Ative o modo multilinha e configure uma expressão regular para a primeira linha a fim de mesclar linhas consecutivas em registros completos.
Exemplo:
|
Log bruto não processado |
No modo padrão, cada linha é tratada como um log separado, fragmentando o stack trace e perdendo o contexto. |
Com o modo multilinha ativado, uma expressão regular de primeira linha identifica um log completo, preservando sua estrutura semântica. |
|
|
|
|


Procedimento: Na página Logtail Configuration, na área Processor Configurations, ative Multi-line Mode.
-
Type: Selecione Custom ou Multi-line JSON.
-
Custom: Se o formato do log bruto não for fixo, configure uma Regex to Match First Line para identificar a linha inicial de cada entrada de log.
-
Regex to Match First Line: Gere automaticamente ou insira manualmente. A expressão deve corresponder a uma linha inteira de dados. No exemplo acima, a expressão regular correspondente é
\[\d+-\d+-\w+:\d+:\d+,\d+]\s\[\w+]\s.*.Geração automática: Clique em Auto-generate Regular Expression. Na caixa de texto Log Sample, selecione o conteúdo do log a ser extraído e clique em Generate Regex.
Entrada manual: Clique em Manually Enter Regular Expression. Após inserir a expressão, clique em Validate.
-
Multi-line JSON: Selecione esta opção quando os logs brutos estiverem no formato JSON padrão. O LoongCollector lida automaticamente com quebras de linha dentro de entradas JSON únicas.
-
Processing Method If Splitting Fails:
Discard: Se um segmento de texto não corresponder à expressão regular da primeira linha, ele será descartado.
Retain Single Line: O texto não correspondido é dividido e retido conforme o modo original de linha única.
Caso de uso 2: Estruturar logs
Quando os logs brutos são texto não estruturado (por exemplo, logs de acesso do Nginx), a consulta direta torna-se ineficiente. O LoongCollector oferece plugins de análise que convertem logs brutos em pares chave-valor estruturados para análise, monitoramento e alertas.
Exemplo:
Log bruto não processado
Log após análise estruturada
192.168.*.* - - [15/Apr/2025:16:40:00 +0800] "GET /nginx-logo.png HTTP/1.1" 0.000 514 200 368 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.*.* Safari/537.36"body_bytes_sent: 368 http_referer: - http_user_agent : Mozi11a/5.0 (Nindows NT 10.0; Win64; x64) AppleMebKit/537.36 (KHTML, like Gecko) Chrome/131.0.x.x Safari/537.36 remote_addr:192.168.*.* remote_user: - request_length: 514 request_method: GET request_time: 0.000 request_uri: /nginx-logo.png status: 200 time_local: 15/Apr/2025:16:40:00Procedimento: Na área Processor Configurations da página Logtail Configuration:
Adicionar um plugin de análise: Clique em Add Processor e configure um plugin de análise regex, delimitador ou JSON com base no formato do seu log. Para este exemplo NGINX, selecione .
-
NGINX Log Configuration: Copie toda a definição
log_formatdo arquivo de configuração do seu servidor Nginx (nginx.conf) e cole-a nesta caixa de texto.Exemplo:
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')ImportanteA definição de formato aqui deve corresponder exatamente ao formato que gera os logs no servidor; caso contrário, a análise falhará.
-
Parâmetros comuns: Os parâmetros a seguir são comuns a vários plugins de análise de dados e funcionam da mesma maneira.
Original field: Especifica o campo de origem a ser analisado. O padrão é
content, que representa toda a entrada de log coletada.Keep original field on failure: Recomendado. Se a análise de um log falhar (por exemplo, devido a incompatibilidade de formato), esta opção retém o conteúdo original do log no campo original especificado.
Keep original field on success: Quando selecionado, o conteúdo original do log é retido mesmo após uma análise bem-sucedida.
3. Filtragem de logs
Coletar logs irrelevantes ou de baixo valor, como os de nível DEBUG ou INFO, desperdiça armazenamento, aumenta custos, prejudica o desempenho das consultas e pode introduzir riscos de segurança. Implemente políticas de filtragem granulares para garantir uma coleta de logs eficiente e segura.
Filtragem de conteúdo
Filtre logs com base no conteúdo dos campos, por exemplo, coletando apenas logs onde o nível seja WARNING ou ERROR.
Exemplo:
Logs brutos não processados
Coletar apenas logs
WARNINGouERROR{"level":"WARNING","timestamp":"2025-09-23T19:11:40+0800","cluster":"yilu-cluster-0728","message":"Disk space is running low","freeSpace":"15%"} {"level":"ERROR","timestamp":"2025-09-23T19:11:42+0800","cluster":"yilu-cluster-0728","message":"Failed to connect to database","errorCode":5003} {"level":"INFO","timestamp":"2025-09-23T19:11:47+0800","cluster":"yilu-cluster-0728","message":"User logged in successfully","userId":"user-123"}{"level":"WARNING","timestamp":"2025-09-23T19:11:40+0800","cluster":"yilu-cluster-0728","message":"Disk space is running low","freeSpace":"15%"} {"level":"ERROR","timestamp":"2025-09-23T19:11:42+0800","cluster":"yilu-cluster-0728","message":"Failed to connect to database","errorCode":5003}Procedimento: Na área Processor Configurations da página Logtail Configuration:
Clique em Add Processor e selecione .
Field Name: O campo do log a ser filtrado.
Field Value: A expressão regular para filtragem. Apenas correspondência de texto completo é suportada; correspondência parcial de palavras-chave não é permitida.
Lista de bloqueios de coleta
Utilize uma lista de bloqueios para excluir diretórios ou arquivos específicos, evitando o upload de logs irrelevantes ou sensíveis.
Procedimento: Na página Logtail Configuration, acesse a área , ative Collection Blacklist e clique em Add.
Suporta correspondência exata e com caracteres curinga para diretórios e nomes de arquivos. Os únicos caracteres curinga suportados são o asterisco (*) e o ponto de interrogação (?).
-
File Path Blacklist: Os caminhos de arquivo a serem ignorados. Exemplos:
/home/admin/private*.log: Ignora todos os arquivos no diretório/home/admin/que começam com "private" e terminam com ".log"./home/admin/private*/*_inner.log: Ignora arquivos terminados em "_inner.log" localizados em subdiretórios que começam com "private" sob o diretório/home/admin/.
-
File Blacklist: Os nomes de arquivos a serem ignorados durante a coleta. Exemplo:
app_inner.log: Ignora todos os arquivos chamadosapp_inner.log.
-
Directory Blacklist: O caminho do diretório não pode terminar com uma barra (/). Exemplos:
/home/admin/dir1/: A lista de bloqueios de diretório não terá efeito./home/admin/dir*: Ignora todos os arquivos dentro de subdiretórios de/home/admin/que começam com "dir"./home/admin/*/dir: Ignora todos os arquivos em qualquer subdiretório de segundo nível chamado "dir" sob/home/admin/. Por exemplo, arquivos em/home/admin/a/dirsão ignorados, mas arquivos em/home/admin/a/b/dirsão coletados.
Filtragem de contêineres
Defina condições de coleta com base em metadados do contêiner — como variáveis de ambiente, rótulos de Pod, namespaces e nomes de contêineres — para controlar precisamente quais logs de contêineres são coletados.
Procedimento: Na área Input Configurations da página Logtail Configuration, ative Container Filtering e clique em Add.
Múltiplas condições são combinadas com um "E" lógico. Toda correspondência de expressão regular baseia-se no mecanismo RE2 do Go, que possui limitações em comparação com mecanismos como PCRE. Certifique-se de que suas expressões estejam em conformidade com o Apêndice: Limites de uso de expressões regulares (Filtragem de contêineres) .
Lista de bloqueios/permissões de variáveis de ambiente: Filtra contêineres com base em suas variáveis de ambiente.
Lista de bloqueios/permissões de rótulos de Pod K8s: Filtra Pods com base em seus rótulos.
Correspondência regex de nome de Pod K8s: Coleta logs de Pods cujos nomes correspondem à expressão regular especificada.
Correspondência regex de namespace K8s: Seleciona contêineres para coleta com base no nome do namespace.
Correspondência regex de nome de contêiner K8s: Coleta logs de contêineres cujos nomes correspondem à expressão regular especificada.
Lista de bloqueios/permissões de rótulos de contêiner: Coleta logs de contêineres com rótulos correspondentes. Destinado a cenários Docker e não recomendado para cenários K8s.
4. Categorização de logs
Em cenários onde múltiplas aplicações compartilham um formato de log, distinguir a origem torna-se difícil. Configure tópicos e tags de log para permitir associação automática de contexto e categorização lógica.
Tópicos de log
Quando várias aplicações ou instâncias compartilham um formato de log, mas possuem caminhos diferentes (por exemplo,
/apps/app-A/run.loge/apps/app-B/run.log), distinguir a origem é difícil. Para resolver isso, gere um tópico de log com base no grupo de máquinas, em um nome personalizado ou na extração do caminho do arquivo para diferenciar logs de diversas fontes comerciais ou de caminho.Procedimento: Acesse e selecione um método de geração de tópico entre as três opções a seguir:
Tópico de grupo de máquinas: Quando uma configuração de coleta é aplicada a vários grupos de máquinas, o LoongCollector usa automaticamente o nome do grupo de máquinas como valor do campo
__topic__. Adequado para cenários onde os logs são categorizados por cluster de hosts.Custom: O formato é
customized://<custom_topic_name>, por exemplo,customized://app-login. Ideal para cenários de tópicos estáticos com identificadores de negócio fixos.-
Extração de caminho de arquivo: Extrai informações-chave do caminho completo do arquivo de log para marcar dinamicamente a origem do log. Útil quando múltiplos usuários ou aplicações compartilham o mesmo nome de arquivo de log, mas possuem caminhos diferentes.
Quando vários usuários ou serviços gravam logs em diretórios de nível superior diferentes com subcaminhos e nomes de arquivo idênticos, a origem não pode ser distinguida apenas pelo nome do arquivo. Por exemplo:
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Nesse caso, configure a extração de caminho de arquivo e use uma expressão regular para extrair informações-chave do caminho completo. O resultado correspondente é então enviado ao Logstore como o tópico do log.
Regra de extração: Grupos de captura regex
Ao configurar uma expressão regular, o sistema determina automaticamente o formato do campo de saída com base no número e na nomenclatura dos grupos de captura, conforme descrito abaixo:
Na expressão regular para um caminho de arquivo, as barras (/) devem ser escapadas.
Tipo de grupo de captura
Caso de uso
Campo gerado
Exemplo de regex
Exemplo de caminho
Campo gerado
Grupo de captura único (um
(.*?))Uma única dimensão é necessária para distinguir origens (ex.: nome de usuário, ambiente).
Gera um campo
__topic__.\/logs\/(.*?)\/app\.log/logs/userA/app.log__topic__:userAMúltiplos grupos de captura sem nome (vários
(.*?))Múltiplas dimensões são necessárias, mas sem rótulos semânticos.
Gera campos Tag formatados como
__tag__:__topic_{i}__:value, onde{i}é o índice do grupo de captura.\/logs\/(.*?)\/(.*?)\/app\.log/logs/userA/svcA/app.log__tag__:__topic_1__:userA;__tag__:__topic_2__:svcAMúltiplos grupos de captura nomeados (usando
(?P<name>.*?))Múltiplas dimensões são necessárias com nomes de campos semânticos claros para facilitar consultas e análises.
Gera campos Tag formatados como
__tag__:{name}:value.\/logs\/(?P<user>.*?)\/(?P<service>.*?)\/app\.log/logs/userA/svcA/app.log__tag__:user:userA;__tag__:service:svcA
Marcação de logs
Ative o recurso de enriquecimento de tags de log para extrair informações-chave de variáveis de ambiente do contêiner ou rótulos de Pod do Kubernetes e anexá-las como Tags para agrupamento granular de logs.
Procedimento: Na página Logtail Configuration, na área Input Configurations, ative Log Tag Enrichment e clique em Add.
-
Environment Variables: Configure um nome de variável de ambiente e uma chave de Tag. O valor da variável de ambiente será armazenado como o valor da Tag.
Nome da variável de ambiente: O nome da variável de ambiente a ser extraída.
Chave da Tag: A chave para a nova Tag.
-
Pod Labels: Configure uma chave de rótulo de Pod e uma chave de Tag. O valor do rótulo do Pod será armazenado como o valor da Tag.
Chave do rótulo do Pod: A chave do rótulo do Pod Kubernetes a ser extraída.
Chave da Tag: A chave para a nova Tag.
5. Configuração de saída
Por padrão, todos os logs são enviados para o Logstore atual com compressão lz4. Para distribuir logs da mesma origem para diferentes Logstores, siga as etapas abaixo.
Distribuição dinâmica para múltiplos destinos
ImportanteA distribuição dinâmica para múltiplos destinos está disponível apenas para LoongCollector 3.0.0 e versões posteriores. Este recurso não é suportado pelo Logtail.
É possível configurar no máximo cinco destinos de saída.
Após configurar múltiplos destinos de saída, esta configuração de coleta deixará de aparecer na lista de configurações de coleta do Logstore atual. Para visualizar, modificar ou excluir a configuração, consulte Como gerenciar configurações de distribuição para múltiplos destinos?.
Procedimento: Na página Logtail Configuration, na área Output Configurations:
Clique em
 para expandir a configuração de saída.
-
Clique em Add Output Targets e conclua a seguinte configuração:
Logstores: Selecione o Logstore de destino.
Compression Method: Suporta lz4 e zstd.
-
Route Settings: Roteie logs com base em campos Tag. Logs que correspondem à configuração de roteamento são enviados para o Logstore de destino. Se deixado em branco, todos os logs coletados serão enviados para o Logstore de destino.
-
Tag Name: A chave da Tag usada para roteamento. Insira a chave diretamente (ex.:
__path__) sem o prefixo__tag__:. Os campos Tag dividem-se em duas categorias:As Tags são explicadas em Gerenciar Tags de Coleta do LoongCollector .
Relacionadas ao agente: Geradas pelo agente de coleta e independentes de quaisquer plugins. Exemplos incluem
__hostname__e__user_defined_id__.Relacionadas ao plugin de entrada: Fornecidas e enriquecidas pelos plugins de entrada. Exemplos incluem
__path__da coleta de arquivos e_pod_name_ou_container_name_da coleta K8s.
Tag Value: Logs cujo valor de Tag corresponde a esta configuração são enviados para o Logstore de destino.
Discard this tag?: Se ativado, este campo Tag não será incluído nos logs enviados.
-
Etapa 4: Consulta e análise
Após configurar o processamento de logs e os plugins, clique em Next para prosseguir para a página Query and Analysis Configurations:
Por padrão, o sistema ativa o índice de texto completo, que permite pesquisar o conteúdo bruto do log por palavra-chave.
Para consultar dados por campos específicos, clique em Automatic Index Generation após o carregamento dos dados em Preview Data. O Log Service gera um índice de campo com base na primeira entrada de log dos dados de visualização.
Após concluir a configuração, clique em Next para finalizar o processo de coleta.
Etapa 5: Validar e solucionar problemas
Após criar e aplicar uma configuração de coleta a um grupo de máquinas, o sistema a implanta automaticamente e inicia a coleta de logs incrementais.
Visualizar logs coletados
Confirme se o arquivo de log tem novo conteúdo: O LoongCollector coleta apenas logs incrementais. Execute
tail -f /path/to/your/log/filee acione operações de negócio para garantir que novos logs estejam sendo gravados.-
Pesquise logs: Acesse a página Search & Analyze do Logstore de destino. Clique em Search & Analyze. O intervalo de tempo padrão corresponde aos últimos 15 minutos. Verifique se novos logs foram ingeridos. Cada log de texto de contêiner coletado inclui os seguintes campos por padrão:
Parâmetro
Descrição
__tag__:__hostname__Nome do host do contêiner.
__tag__:__path__Caminho do arquivo de log dentro do contêiner.
__tag__:_container_ip_Endereço IP do contêiner.
__tag__:_image_name_Nome da imagem utilizada pelo contêiner.
__tag__:_pod_name_Nome do Pod.
__tag__:_namespace_Namespace do Pod.
__tag__:_pod_uid_Identificador exclusivo (UID) do Pod.
Consultar os nós históricos de um Pod
Caso um Pod tenha sido movido ou reiniciado, consulte os logs de eventos do Kubernetes do seu cluster ACK no Simple Log Service para identificar os nós onde o Pod foi executado anteriormente.
Faça login no console do Simple Log Service e localize o projeto
k8s-log-{cluster_id}na lista de projetos.Clique no LogStore k8s-event para acessar a página de consulta e análise.
Na caixa de pesquisa, insira uma instrução de consulta que filtre pelo nome do Pod, por exemplo,
pod_name: my-pode clique em Search & Analyze.Nos resultados retornados, verifique o valor do campo
hostname. Esse valor corresponde ao nome do host do nó onde o Pod foi executado.
NotaNo LogStore k8s-event, os nomes dos campos são
pod_nameehostname, sem o prefixo__tag__:. O formato com o prefixo__tag__:aplica-se à coleta de stdout e logs de texto de contêineres, mas não aos logs de eventos do Kubernetes.Solucionar problemas comuns
Falha no heartbeat do grupo de máquinas
-
Verifique o identificador de usuário: Se o servidor não for uma instância ECS, ou se a instância ECS e o Projeto pertencerem a contas Alibaba Cloud diferentes, garanta que o identificador de usuário correto exista no diretório especificado.
No Linux, execute o comando
cd /etc/ilogtail/users/ && touch <uid>para criar um arquivo de identificador de usuário.Windows: Acesse o diretório
C:\LogtailData\users\e crie um arquivo vazio chamado<uid>.
O identificador de usuário estará configurado corretamente se o caminho especificado contiver um arquivo cujo nome seja o ID da conta Alibaba Cloud do Projeto atual.
-
Verifique o identificador do grupo de máquinas: Se você utilizar um identificador personalizado para um grupo de máquinas, confirme se o arquivo
user_defined_idexiste no diretório especificado. Caso exista, verifique se o conteúdo corresponde ao identificador personalizado configurado para o grupo de máquinas.-
Linux:
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') Windows: No diretório
C:\LogtailData, crie um arquivo chamadouser_defined_ide grave o identificador personalizado nele. (Se o diretório não existir, crie-o manualmente.)
-
Se o identificador de usuário e o identificador do grupo de máquinas estiverem configurados corretamente, consulte Solução de problemas de grupos de máquinas do LoongCollector (Logtail) para obter mais orientações sobre solução de problemas.
Erros de coleta de logs ou erros de formato
Esse problema geralmente ocorre quando a conexão de rede e a configuração básica estão corretas, mas o conteúdo do log não corresponde às regras de análise. Para diagnosticar o problema, visualize a mensagem de erro específica:
Na página Logtail Configuration, clique no nome da configuração do LoongCollector (Logtail) que apresenta erros de coleta. Na aba Log Collection Error, clique em Select Time Range para definir o período da consulta.
Na seção , visualize o tipo de alerta do log de erro e consulte Tipos comuns de erros na coleta de dados para encontrar a solução correspondente.
Próximas etapas
Visualização de dados: Utilize painéis de visualização para monitorar tendências de métricas principais.
Alertas de anomalias de dados: Configure políticas de alerta para detectar anomalias nos dados em tempo real.
Solução de problemas na coleta de logs de contêineres
Verifique se novos logs estão sendo gerados no arquivo de log de destino. O Logtail não coleta dados até que novos logs apareçam.
Perguntas frequentes
Gerenciar configurações de distribuição para múltiplos destinos
Como as configurações de distribuição para múltiplos destinos se aplicam a vários logstores, gerencie-as a partir da página de gerenciamento no nível do Projeto:
Faça login no console do Simple Log Service e clique no nome do Projeto de destino.
-
Na página do Projeto, no painel de navegação à esquerda, clique em
 .Nota
Esta página gerencia todas as configurações de coleta dentro do Projeto, incluindo configurações de logstores que tenham sido excluídos acidentalmente.
Enviar logs do ACK para um Projeto entre contas
É possível enviar logs de contêineres para um Projeto do Simple Log Service (SLS) em outra conta Alibaba Cloud instalando manualmente o componente LoongCollector (Logtail) no cluster ACK e configurando-o com o ID da conta Alibaba Cloud de destino ou com uma credencial de acesso (AccessKey).
Descrição do cenário: Se você precisar coletar dados de log no Projeto SLS de outra conta por motivos organizacionais, de permissão ou monitoramento, instale o LoongCollector (Logtail) manualmente para habilitar a coleta entre contas.
Procedimento: Siga estas etapas para instalar o LoongCollector manualmente. Para obter informações sobre como instalar o Logtail, consulte Instalar e configurar o Logtail.
-
Conecte-se ao cluster Kubernetes e execute o comando apropriado para sua região:
Regiões da China
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Regiões fora da China
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
Acesse o diretório
loongcollector-custom-k8s-packagee modifique o arquivo de configuração./loongcollector/values.yaml.* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
No diretório
loongcollector-custom-k8s-package, execute o comando a seguir para instalar o LoongCollector e suas dependências:* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]') -
Após concluir a instalação, verifique se os componentes estão em execução.
Se um pod falhar ao iniciar, verifique as configurações no arquivo values.yaml e garanta que as imagens necessárias foram baixadas.
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')O Simple Log Service também cria automaticamente os recursos listados abaixo. Você pode visualizá-los no console do Simple Log Service.
Tipo de recurso
Nome do recurso
Descrição
Projeto
O valor de
projectNameespecificado no arquivo values.yamlIsola logs de diferentes serviços.
Para um gerenciamento flexível de logs, Crie um Projeto.
Grupo de máquinas
k8s-group-${cluster_id}Conjunto de nós de coleta de logs. Os endereços IP dos nós do Kubernetes mudam dinamicamente conforme o cluster escala horizontalmente, portanto, identificar um grupo de máquinas por endereço IP pode causar falhas de heartbeat. Por isso, grupos de máquinas em cenários Kubernetes utilizam um identificador personalizado. Para mais informações, consulte Guia para associar grupos de máquinas a configurações de coleta.
ImportanteO componente LoongCollector não cria um logstore chamado config-operation-log. Se esse logstore já existir, o LoongCollector não gravará logs nele.
Usar múltiplas configurações para a mesma origem
Por padrão, para evitar duplicação de dados, o Simple Log Service (SLS) permite que apenas uma configuração de coleta colete logs de cada origem:
Um arquivo de log de texto pode corresponder a apenas uma configuração de coleta do Logtail.
-
Saída padrão (stdout) de um contêiner:
Se você usar a nova versão do modelo de saída padrão, o stdout poderá ser coletado por apenas uma configuração de coleta de saída padrão por padrão.
Se você usar a versão antiga do modelo de saída padrão, nenhuma configuração extra será necessária e múltiplas coletas serão suportadas por padrão.
Faça login no console do Simple Log Service e acesse o Projeto de destino.
No painel de navegação à esquerda, escolha
Logstores e localize o logstore de destino.Clique no ícone
ao lado do nome para expandir o logstore.Clique em Logtail Configuration. Na lista de configurações, localize a configuração do Logtail desejada e clique em Manage Logtail Configuration na coluna Actions.
-
Na página de configuração do Logtail, clique em Edit e role até a seção Input Configurations:
Para coletar logs de arquivos de texto, ative Allow File to Be Collected for Multiple Times.
Para coletar a saída padrão de contêineres, ative Allow Collection by Different Logtail Configurations.
Erro de dependência ao desinstalar o loongcollector
Problema: Ao tentar desinstalar o componente loongcollector (logtail-ds) no Container Service for Kubernetes (ACK), você recebe um erro informando que as dependências do componente não foram atendidas.
Dependencies of addons are not met: terway-eniip depends on logtail-ds(>0.0) whose version is v3.x.x.x-aliyun or will be v3.x.x.x-aliyun.Causa: O plugin de rede
terway-eniiptem a coleta de logs ativada, o que cria uma dependência do componente loongcollector (logtail-ds). Portanto, o ACK não permite desinstalar o loongcollector (logtail-ds) até que essa dependência seja removida.Solução: Siga estas etapas para remover a dependência e, em seguida, desinstalar o componente:
Faça login no console do ACK.
Na lista de clusters, clique no nome do cluster de destino para acessar sua página de detalhes.
No painel de navegação à esquerda, clique em Add-ons.
Na lista de add-ons, pesquise pelo componente
terway-eniipe clique em .Na caixa de diálogo exibida, clique em OK.
Depois que a configuração entrar em vigor, tente desinstalar o componente loongcollector (logtail-ds) novamente.
Última entrada de log atrasada ou truncada
Causa: O truncamento de logs geralmente ocorre quando falta uma quebra de linha final no arquivo de log ou quando uma entrada de log multilinha, como uma pilha de exceções, não foi totalmente gravada. Como o coletor não consegue determinar se a entrada de log está completa, a última entrada pode ser dividida ou atrasada. A forma como isso é tratado depende da versão do seu LoongCollector (Logtail):
Versões anteriores à 1.8: Se a última linha de um log não tiver uma quebra de linha (retorno de carro) ou se um bloco de log multilinha estiver incompleto, o coletor aguarda a próxima operação de gravação para acionar uma saída. Isso pode atrasar significativamente a última entrada de log até que um novo log seja gravado.
-
Versão 1.8 e posteriores: Essas versões introduzem um mecanismo de flush por tempo limite para evitar que logs fiquem presos. Quando uma linha de log incompleta é detectada, o sistema inicia um temporizador. Após o término do período de tempo limite, o conteúdo atual é enviado automaticamente para garantir que o log seja eventualmente coletado.
Tempo limite padrão: 60 segundos (garante a integridade dos dados na maioria dos cenários)
Você pode ajustar esse valor conforme suas necessidades. No entanto, recomendamos que não o defina como 0, pois isso pode causar truncamento de logs ou perda parcial de dados.
Solução:
Você pode estender o tempo de espera para garantir que uma entrada de log completa seja gravada antes de ser coletada:
Faça login no console do Simple Log Service e acesse o Projeto de destino.
No painel de navegação à esquerda, escolha
 Logstores e localize o logstore de destino.
Clique no ícone
 ao lado do nome para expandir o logstore.
Clique em Logtail Configuration. Na lista de configurações, localize a configuração do Logtail desejada e clique em Manage Logtail Configuration na coluna Actions.
-
Na página de configuração do Logtail, clique em Edit.
-
Acesse e adicione a seguinte configuração JSON para personalizar o período de tempo limite.
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Valor padrão: Determinado pelo parâmetro de inicialização
default_reader_flush_timeout, que geralmente é de alguns segundos.Unidade: Segundos.
Valor recomendado: ≥ 1 segundo. Recomendamos que não defina como 0, pois isso pode causar truncamento de logs ou perda parcial de dados.
-
Após concluir a configuração, clique em OK.
Failover e recuperação de rede do LoongCollector
Se o LoongCollector (Logtail) detectar um problema de conectividade de rede interna, como falha ou tempo limite, ele alternará automaticamente para a rede pública. Esse mecanismo de failover garante uma coleta de logs confiável e evita acúmulos ou perda de dados.
LoongCollector: Alterna automaticamente de volta para a rede interna após a recuperação da rede.
Logtail: Não alterna automaticamente de volta. É necessário reiniciá-lo para restaurar a comunicação pela rede interna.
Apêndice: Processadores nativos
Na página Logtail Configuration, na área Processor Configurations, adicione plug-ins de processamento para estruturar logs brutos. Para adicionar um plug-in de processamento a uma configuração de coleta existente, siga estas etapas:
No painel de navegação à esquerda, escolha
 Logstores e localize o Logstore de destino.
Clique em
 à esquerda do nome para expandir o Logstore.
Clique em Logtail Configuration. Na lista de configurações, encontre a configuração do Logtail desejada e clique em Manage Logtail Configuration.
Na página de configuração do Logtail, clique em Edit.
Esta seção apresenta apenas os plug-ins de processamento mais utilizados, que cobrem cenários comuns de processamento de logs. Para conhecer mais recursos, consulte Plug-ins de processamento de extensão .
ImportanteRegras para combinação de plug-ins (aplica-se ao LoongCollector / Logtail 2.0 e versões posteriores):
Os plug-ins de processamento nativos e de extensão podem ser usados de forma independente ou combinados, conforme necessário.
Recomendamos o uso prioritário dos plug-ins de processamento nativos, pois oferecem melhor desempenho e maior estabilidade.
Quando os recursos nativos não atenderem aos requisitos do negócio, adicione plug-ins de processamento de extensão após os nativos já configurados para realizar um processamento complementar.
Restrição de ordem:
Todos os plug-ins são executados sequencialmente na ordem em que foram configurados, formando uma cadeia de processamento. Observação: Todos os plug-ins de processamento nativos devem preceder quaisquer plug-ins de processamento de extensão. Após adicionar qualquer plug-in de processamento de extensão, não é possível adicionar mais plug-ins de processamento nativos.
Análise com expressão regular
Este processador utiliza uma expressão regular para analisar logs e convertê-los em pares chave-valor. Em seguida, consulte e analise cada campo extraído de forma independente.
Exemplo:
Log bruto
Resultado da análise
127.0.0.1 - - [16/Aug/2024:14:37:52 +0800] "GET /wp-admin/admin-ajax.php?action=rest-nonce HTTP/1.1" 200 41 "http://www.example.com/wp-admin/post-new.php?post_type=page" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/127.0.0.0 Safari/537.36 Edg/127.0.0.0"body_bytes_sent: 41 http_referer: http://www.example.com/wp-admin/post-new.php?post_type=page http_user_agent: Mozilla/5.0 (Windows NT 10.0; Win64; ×64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/127.0.0.0 Safari/537.36 Edg/127.0.0.0 remote_addr: 127.0.0.1 remote_user: - request_method: GET request_protocol: HTTP/1.1 request_uri: /wp-admin/admin-ajax.php?action=rest-nonce status: 200 time_local: 16/Aug/2024:14:37:52 +0800Etapas: Na página Logtail Configuration, na área Processor Configurations, clique em Add Processor e selecione :
-
Regular Expression: Corresponde às entradas de log. Gere-a automaticamente ou insira-a manualmente.
-
Para gerar uma expressão regular automaticamente:
Clique em Generate Regular Expression.
Na caixa Log Sample, destaque o conteúdo a ser extraído.
-
Clique em Generate.
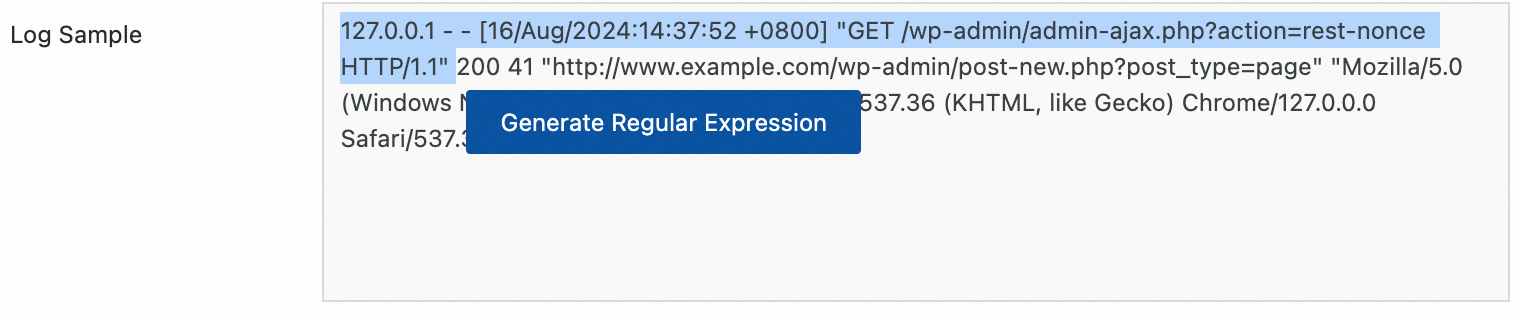
Insira manualmente uma expressão regular com base no formato do seu log.
Após configurar a expressão, clique em Validate para testar se ela analisa corretamente sua amostra de log.
-
Extracted Field: Atribua um nome (chave) ao conteúdo extraído (valor).
Para obter informações sobre outros parâmetros, consulte a descrição dos parâmetros de configuração comuns em Cenário 2: Logs estruturados.
Análise com delimitador
Este processador usa um delimitador para converter logs em pares chave-valor. É possível utilizar delimitadores de caractere único ou múltiplo.
Exemplo:
Log bruto
Usando um caractere especificado
,dividir um campo05/May/2025:13:30:28,10.10.*.*,"POST /PutData?Category=YunOsAccountOpLog&AccessKeyId=****************&Date=Fri%2C%2028%20Jun%202013%2006%3A53%3A30%20GMT&Topic=raw&Signature=******************************** HTTP/1.1",200,18204,aliyun-sdk-javaip:10.10.*.* request:POST /PutData?Category=YunOsAccountOpLog&AccessKeyId=****************&Date=Fri%2C%2028%20Jun%202013%2006%3A53%3A30%20GMT&Topic=raw&Signature=******************************** HTTP/1.1 size:18204 status:200 time:05/May/2025:13:30:28 user_agent:aliyun-sdk-javaProcedimento: Na página Logtail Configuration, na área Processor Configurations, clique em Add Processor e selecione :
-
Delimiter: O caractere que separa os campos no log.
Exemplo: Para um arquivo CSV, selecione Custom e insira uma vírgula (,).
Quote: O caractere usado para envolver o valor de um campo. Isso é necessário caso o valor contenha o delimitador, evitando divisões incorretas.
-
Extracted Field: Atribua um nome de campo (Key) para cada coluna em ordem sequencial. Os nomes dos campos devem obedecer às seguintes regras:
Podem conter apenas letras, dígitos e sublinhados (_).
Devem começar com uma letra ou um sublinhado (_).
Comprimento máximo: 128 bytes.
Para obter informações sobre outros parâmetros, consulte a descrição dos parâmetros de configuração comuns em Cenário 2: Logs estruturados.
Análise de JSON padrão
Este processador converte uma entrada de log que seja um objeto JSON em pares chave-valor.
Exemplo:
Log bruto
Resultado da análise
{"url": "POST /PutData?Category=YunOsAccountOpLog&AccessKeyId=U0Ujpek********&Date=Fri%2C%2028%20Jun%202013%2006%3A53%3A30%20GMT&Topic=raw&Signature=pD12XYLmGxKQ%2Bmkd6x7hAgQ7b1c%3D HTTP/1.1", "ip": "10.200.98.220", "user-agent": "aliyun-sdk-java", "request": {"status": "200", "latency": "18204"}, "time": "05/Jan/2025:13:30:28"}ip: 10.200.98.220 request: {"status": "200", "latency" : "18204" } time: 05/Jan/2025:13:30:28 url: POST /PutData?Category=YunOsAccountOpLog&AccessKeyId=U0Ujpek******&Date=Fri%2C%2028%20Jun%202013%2006%3A53%3A30%20GMT&Topic=raw&Signature=pD12XYLmGxKQ%2Bmkd6x7hAgQ7b1c%3D HTTP/1.1 user-agent:aliyun-sdk-javaProcedimento: Na página Logtail Configuration, na seção Processor Configurations, clique em Add Processor e selecione :
Original Field: O valor padrão é
content. Este campo armazena o conteúdo bruto do log a ser analisado.Para obter informações sobre outros parâmetros, consulte a descrição dos parâmetros de configuração comuns em Cenário 2: Logs estruturados.
Análise de JSON aninhado
Este processador expande um objeto JSON aninhado em pares chave-valor. Controle a expansão com a configuração
JSON expansion depth.Exemplo:
Log bruto
Resultado (profundidade: 0)
Resultado (profundidade: 1)
{"s_key":{"k1":{"k2":{"k3":{"k4":{"k51":"51","k52":"52"},"k41":"41"}}}}}0_s_key_k1_k2_k3_k41:41 0_s_key_k1_k2_k3_k4_k51:51 0_s_key_k1_k2_k3_k4_k52:521_s_key:{"k1":{"k2":{"k3":{"k4":{"k51":"51","k52":"52"},"k41":"41"}}}}Procedimento: Na página Logtail Configuration, na seção Processor Configurations, clique em Add Processor e selecione :
Original Field: O nome do campo original a ser expandido, como
content.JSON Expansion Depth: O número de níveis a serem expandidos dentro do objeto JSON.
0expande todos os níveis (padrão),1expande apenas o nível superior, e assim por diante.Character to Concatenate Expanded Keys: O caractere usado para unir chaves de objetos aninhados. O padrão é o sublinhado (
_).Name Prefix of Expanded Keys: Um prefixo a ser adicionado ao nome de cada chave expandida.
-
Expand Array: Ative esta opção para expandir um array em pares chave-valor indexados.
Por exemplo,
{"k":["a","b"]}é expandido para{"k[0]":"a","k[1]":"b"}.Para renomear um campo expandido (por exemplo, de
prefix_s_key_k1paranew_field_name), adicione um processador Rename Fields após este. Para obter informações sobre outros parâmetros, consulte a descrição dos parâmetros de configuração comuns em Cenário 2: Logs estruturados.
Análise de array JSON
Use a função
json_extractpara extrair um objeto JSON de um array JSON.Exemplo:
Log bruto
Resultado da análise
[{"key1":"value1"},{"key2":"value2"}]json1:{"key1":"value1"} json2:{"key2":"value2"}Procedimento: Na página Logtail Configuration, na seção Processor Configurations, defina o Processing Method como SPL. Em seguida, configure a SPL statement para usar a função json_extract e extrair objetos JSON do array JSON.
Exemplo: Do campo de log
content, extraia elementos de um array JSON e armazene os resultados respectivamente nos novos camposjson1ejson2.* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Análise de log Apache
Este processador analisa logs de acesso do Apache e os converte em pares chave-valor com base na diretiva
LogFormatdo Apache.Exemplo:
Log bruto
Análise do Apache Common Log Format
combined1 192.168.1.10 - - [08/May/2024:15:30:28 +0800] "GET /index.html HTTP/1.1" 200 1234 "https://www.example.com/referrer" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.X.X Safari/537.36"http_referer:https://www.example.com/referrer http_user_agent:Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.X.X Safari/537.36 remote_addr:192.168.1.10 remote_ident:- remote_user:- request_method:GET request_protocol:HTTP/1.1 request_uri:/index.html response_size_bytes:1234 status:200 time_local:[08/May/2024:15:30:28 +0800]Procedimento: Na página Logtail Configuration, na seção Processor Configurations, clique em Add Processor e selecione :
Log Format: combined
-
APACHE LogFormat Configuration: O sistema preenche este campo automaticamente com base no Log Format selecionado.
ImportanteVerifique se o conteúdo preenchido automaticamente é idêntico à diretiva LogFormat definida no arquivo de configuração do Apache do seu servidor, geralmente localizado em
/etc/apache2/apache2.conf. Para outros parâmetros, consulte a descrição dos parâmetros de configuração comuns em Cenário 2: Log estruturado.
Mascaramento de dados
Mascare dados sensíveis em seus logs.
Exemplo:
Log bruto
Resultado mascarado
[{'account':'1812213231432969','password':'04a23f38'}, {'account':'1812213685634','password':'123a'}][{'account':'1812213231432969','password':'********'}, {'account':'1812213685634','password':'********'}]Procedimento: Na página Logtail Configuration, na seção Processor Configurations, clique em Add Processor e selecione :
Original Field: O campo de origem que contém o conteúdo a ser mascarado.
-
Data Masking Method:
const: Substitui o conteúdo sensível por uma string especificada.
md5: Substitui o conteúdo sensível pelo seu valor de hash MD5.
Replacement String: A string a ser usada para mascaramento. Obrigatória quando o Data Masking Method estiver definido como const.
Content Expression that Precedes Replaced Content: Uma expressão regular na sintaxe RE2 para localizar o conteúdo imediatamente anterior aos dados sensíveis.
Content Expression to Match Replaced Content: Uma expressão regular na sintaxe RE2 para corresponder aos dados sensíveis que você deseja substituir.
Análise de tempo
Analisa o campo de tempo no log e define o resultado analisado como o campo
__time__do log.Exemplo:
Log bruto
Resultado da análise
{"level":"INFO","timestamp":"2025-09-23T19:11:47+0800","cluster":"yilu-cluster-0728","message":"User logged in successfully","userId":"user-123"}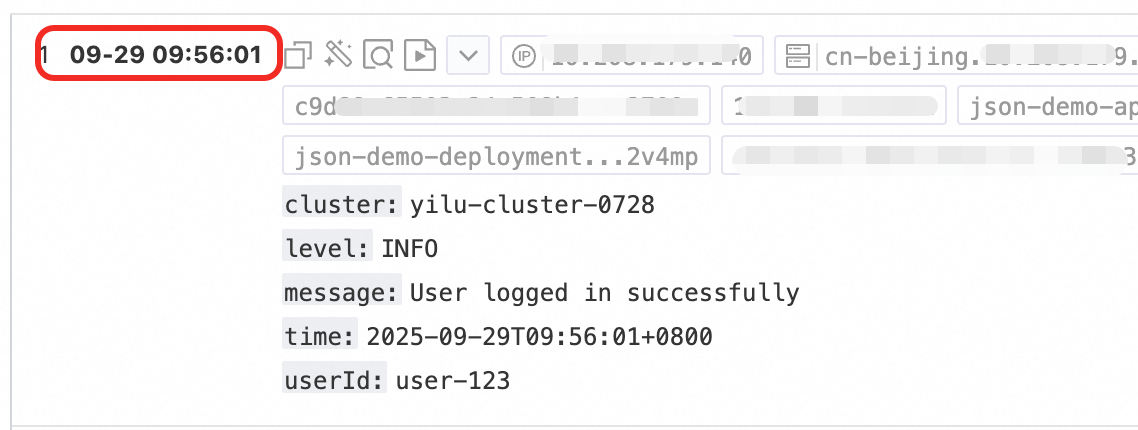
Procedimento: Na página Logtail Configuration, na seção Processor Configurations, clique em Add Processor e selecione :
Original Field: O campo de origem que contém a string de tempo a ser analisada.
Time Format: O formato de tempo correspondente à string de tempo em seus logs.
Time Zone: O fuso horário do campo de tempo do log. Se não for especificado, o padrão será o fuso horário da máquina que executa o LoongCollector (Logtail).
Apêndice: Limitações de expressões regulares (filtragem de contêineres)
As expressões regulares para filtragem de contêineres usam o mecanismo Go RE2. Em comparação com outros mecanismos, como PCRE, o mecanismo RE2 possui várias limitações de sintaxe. Tenha em mente os pontos abaixo ao escrever expressões regulares:
1. Diferenças na sintaxe de grupos nomeados
O Go usa a sintaxe
(?P<name>...)para definir um grupo nomeado e não oferece suporte à sintaxe(?<name>...)do PCRE.Correto:
(?P<year>\d{4})Incorreto:
(?<year>\d{4})
2. Recursos de expressão regular não suportados
O mecanismo RE2 não oferece suporte aos seguintes recursos comuns, porém complexos, de expressões regulares. Evite usá-los:
Asserções:
(?=...),(?!...),(?<=...)e(?<!...)Expressões condicionais:
(?(condition)true|false)Correspondência recursiva:
(?R)e(?0)Referências a subprogramas:
(?&name)e(?P>name)Grupos atômicos:
(?>...)
3. Recomendações
Utilize uma ferramenta como o Regex101 para depurar suas expressões regulares. Para garantir compatibilidade, selecione o modo Golang (RE2) para validação. Caso utilize alguma sintaxe não suportada, o plug-in falhará ao analisar ou corresponder à expressão.
Apêndice: Comparação de versões da saída padrão de contêineres
Para melhorar a eficiência de armazenamento e a consistência da coleta, o formato de metadados de log da saída padrão de contêineres foi atualizado. O novo formato consolida os metadados sob o campo
__tag__, o que otimiza o armazenamento e padroniza o formato.-
Principais vantagens da nova saída padrão
-
Desempenho significativamente aprimorado
Refatorada em C++, a nova versão oferece uma melhoria de desempenho de 180% a 300% em relação à implementação anterior em Go.
Oferece suporte a processamento de dados com plug-ins nativos e processamento paralelo multithread, aproveitando totalmente os recursos do sistema.
Permite combinações flexíveis de plug-ins nativos e plug-ins Go para atender às necessidades de cenários complexos.
-
Maior confiabilidade
Suporta uma fila de rotação para logs de saída padrão e unifica o mecanismo de coleta de logs com o mecanismo de coleta de arquivos, proporcionando alta confiabilidade quando os logs de saída padrão sofrem rotação rápida.
-
Menor consumo de recursos
O uso de CPU é reduzido em 20% a 25%.
O uso de memória é reduzido em 20% a 25%.
-
Consistência operacional aprimorada
Configuração de parâmetros unificada: Os parâmetros de configuração do novo plug-in de coleta de saída padrão são consistentes com os do plug-in de coleta de arquivos.
Gerenciamento de metadados unificado: A nomenclatura dos campos de metadados do contêiner e o local de armazenamento das tags são unificados com o cenário de coleta de arquivos, permitindo que o lado do consumidor mantenha apenas um conjunto de lógica de processamento.
-
-
Comparação de recursos entre as versões nova e antiga
Recurso
Versão antiga
Nova versão
Método de armazenamento
Os metadados são incorporados ao conteúdo do log como campos regulares.
Os metadados são consolidados sob a tag
__tag__.Eficiência de armazenamento
Cada entrada de log carrega uma cópia completa dos metadados, consumindo mais espaço de armazenamento.
Várias entradas de log no mesmo contexto podem reutilizar os metadados, economizando custos de armazenamento.
Consistência de formato
O formato é inconsistente com o formato de coleta de arquivos de contêiner.
A nomenclatura de campos e a estrutura de armazenamento estão totalmente alinhadas com a coleta de arquivos de contêiner, proporcionando uma experiência unificada.
Método de acesso à consulta
Consulte metadados diretamente pelo nome do campo, como
_container_name_.Acesse o par chave-valor correspondente através de
__tag__, como__tag__: _container_name_. -
Mapeamento de campos de metadados do contêiner
Nome do campo antigo
Novo nome do campo
_container_ip_
__tag__:_container_ip_
_container_name_
__tag__:_container_name_
_image_name_
__tag__:_image_name_
_namespace_
__tag__:_namespace_
_pod_name_
__tag__:_pod_name_
_pod_uid_
__tag__:_pod_uid_
Na nova versão, todos os campos de metadados são armazenados na seção de tags do log no formato
__tag__:<key>, em vez de serem incorporados ao conteúdo do log. -
Impacto da nova versão nos usuários
Adaptação do lado do consumidor: Como o local de armazenamento muda do conteúdo para a tag, ajuste sua lógica de consumo de logs adequadamente. Por exemplo, acesse os campos através de __tag__ ao executar uma consulta.
Compatibilidade com SQL: As consultas SQL já são automaticamente compatíveis com ambas as versões, portanto, não é necessário modificar suas instruções de consulta para processar logs de nenhuma das versões.
Mais informações
Parâmetros globais
Parâmetros de entrada
Parâmetros do processador
Parâmetro
Descrição
Amostra de log
Uma amostra do log que você deseja coletar. Utilize uma amostra de log do seu caso de uso real. A amostra ajuda a configurar os parâmetros de processamento com mais facilidade. É possível adicionar várias amostras. O comprimento total não pode exceder 1.500 caracteres.
[2023-10-01T10:30:01,000] [INFO] java.lang.Exception: exception happened
    at TestPrintStackTrace.f(TestPrintStackTrace.java:3)
    at TestPrintStackTrace.g(TestPrintStackTrace.java:7)
    at TestPrintStackTrace.main(TestPrintStackTrace.java:16)
Modo multilinha
-
Tipo de log multilinha: Um log multilinha é uma entrada que abrange várias linhas. Você deve definir uma regra para identificar o início de cada entrada de log.
-
Custom: Usa um Regex to Match First Line para identificar cada entrada de log.
-
Multi-line JSON: Cada objeto JSON é expandido em várias linhas. Exemplo:
{
  "name": "John Doe",
  "age": 30,
  "address": {
    "city": "New York",
    "country": "USA"
  }
}
-
-
Ação em caso de falha na divisão:
Exception in thread "main" java.lang.NullPointerException
    at com.example.MyClass.methodA(MyClass.java:12)
    at com.example.MyClass.methodB(MyClass.java:34)
    at com.example.MyClass.main(MyClass.java:½0)
Se o Log Service falhar ao dividir o conteúdo de log anterior:
-
Discard: Descarta este segmento de log.
-
Retain Single Line: Mantém cada linha de texto como uma entrada de log separada, resultando em quatro entradas de log no total.
-
Modo de processamento
Processors, que inclui o Native Processor e o Extended Processor. Para mais informações sobre processadores, consulte Usar processadores nativos e estendidos.
ImportantePara limitações de uso do processador, consulte os avisos do console.
-
Logtail 2.0 e posterior:
-
É possível combinar processadores nativos de qualquer maneira.
-
É possível combinar processadores nativos e estendidos, mas todos os processadores estendidos devem seguir todos os processadores nativos.
-
-
Versões do Logtail anteriores à 2.0:
-
Não é possível usar processadores nativos e estendidos juntos.
-
Processadores nativos só podem ser usados para coletar logs de texto. Ao usar processadores nativos, você deve atender aos seguintes requisitos:
-
O primeiro processador deve ser um processador de análise de expressão regular, análise baseada em delimitador, análise JSON, análise de padrão Nginx, análise de padrão Apache ou análise de padrão IIS.
-
Após o processador de análise inicial, você pode adicionar no máximo um processador de análise de tempo, um processador de filtragem e vários processadores de mascaramento de dados.
-
-
Para os parâmetros Retain Original Field if Parsing Fails e Retain Original Field if Parsing Succeeds, apenas as seguintes combinações são válidas.
-
Carregar apenas logs analisados com sucesso:
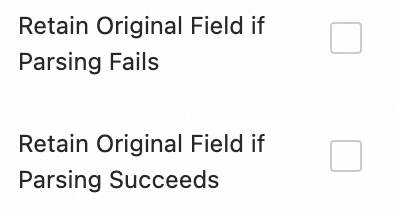
-
Carregar logs analisados em caso de sucesso e logs brutos em caso de falha:
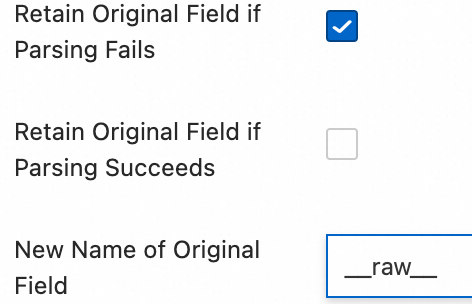
-
Em caso de sucesso, carrega os logs analisados e anexa o campo de log bruto. Em caso de falha, carrega os logs brutos.
Por exemplo, se o log original
"content": "{"request_method":"GET", "request_time":"200"}"for analisado com sucesso, anexar o campo original adiciona um novo campo ao log analisado. O nome do campo é o campo original renomeado (se deixado em branco, o nome assume o nome do campo original por padrão), e o valor do campo é o log original{"request_method":"GET", "request_time":"200"}.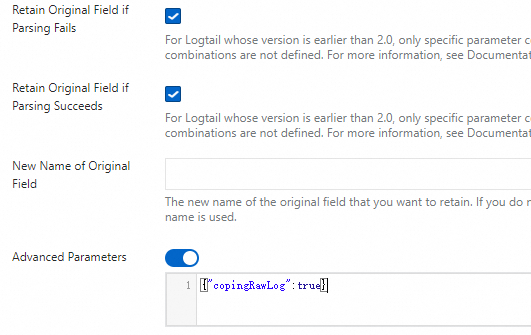
-
-
-