Quando a utilização de CPU de uma instância do ApsaraDB RDS for SQL Server está alta — incluindo picos de 100% — a causa raiz geralmente se enquadra em uma de três categorias. Use a tabela abaixo para identificar sua situação e siga as etapas de resolução correspondentes.
Antes de executar operações de alto risco, como modificar configurações da instância ou dados, verifique as capacidades de recuperação de desastres e tolerância a falhas da instância para garantir a segurança dos dados. Recomendamos criar snapshots ou ativar o backup (por exemplo, ative o backup de log para uma instância RDS) antes de fazer qualquer alteração. Caso você tenha exposto informações sensíveis, como nomes de usuário ou senhas, no console da Alibaba Cloud, modifique essas informações o quanto antes.
|
Sintoma |
Causa provável |
|
QPS e utilização de CPU sobem juntos; sem consultas lentas |
|
|
Consultas lentas presentes; curvas de QPS e CPU não coincidem; alto I/O por consulta |
|
|
CPU alta com execução paralela de consultas; esperas CXPACKET em destaque |
Paralelismo excessivo (esperas CXPACKET)
Identificar a causa
Quando o SQL Server executa consultas em paralelo, as threads processam quantidades desiguais de dados. As threads mais rápidas aguardam as mais lentas concluírem antes de combinar os resultados — essas são as esperas CXPACKET. Quando o tempo acumulado de espera CXPACKET é alto, a utilização de CPU aumenta.
Use o Activity Monitor no SQL Server Management Studio (SSMS) ou execute a consulta a seguir várias vezes para verificar se existe um grande número de esperas CXPACKET:
WITH [Waits] AS (
SELECT [wait_type],
       [wait_time_ms] / 1000.0 AS [WaitS],
       ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],
       [signal_wait_time_ms] / 1000.0 AS [SignalS],
       [waiting_tasks_count] AS [WaitCount],
       100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
                                    ROW_NUMBER() OVER(
                                                      ORDER BY [wait_time_ms] DESC) AS [RowNum]
FROM sys.dm_os_wait_stats
WHERE [wait_type] NOT IN ( N'BROKER_EVENTHANDLER',
                            N'BROKER_RECEIVE_WAITFOR',
                             N'BROKER_TASK_STOP',
                              N'BROKER_TO_FLUSH',
                               N'BROKER_TRANSMITTER',
                                N'CHECKPOINT_QUEUE',
                                 N'CHKPT',
                                  N'CLR_AUTO_EVENT',
                                   N'CLR_MANUAL_EVENT',
                                    N'CLR_SEMAPHORE', -- Maybe uncomment these four if you have mirroring issues N'DBMIRROR_DBM_EVENT', N'DBMIRROR_EVENTS_QUEUE', N'DBMIRROR_WORKER_QUEUE', N'DBMIRRORING_CMD', N'DIRTY_PAGE_POLL', N'DISPATCHER_QUEUE_SEMAPHORE', N'EXECSYNC', N'FSAGENT', N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX', -- Maybe uncomment these six if you have AG issues N'HADR_CLUSAPI_CALL', N'HADR_FILESTREAM_IOMGR_IOCOMPLETION', N'HADR_LOGCAPTURE_WAIT', N'HADR_NOTIFICATION_DEQUEUE', N'HADR_TIMER_TASK', N'HADR_WORK_QUEUE', N'KSOURCE_WAKEUP', N'LAZYWRITER_SLEEP', N'LOGMGR_QUEUE', N'MEMORY_ALLOCATION_EXT', N'ONDEMAND_TASK_QUEUE', N'PREEMPTIVE_XE_GETTARGETSTATE', N'PWAIT_ALL_COMPONENTS_INITIALIZED', N'PWAIT_DIRECTLOGCONSUMER_GETNEXT', N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP', N'QDS_ASYNC_QUEUE', N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP', N'QDS_SHUTDOWN_QUEUE', N'REDO_THREAD_PENDING_WORK', N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE', N'SERVER_IDLE_CHECK', N'SLEEP_BPOOL_FLUSH', N'SLEEP_DBSTARTUP', N'SLEEP_DCOMSTARTUP', N'SLEEP_MASTERDBREADY', N'SLEEP_MASTERMDREADY', N'SLEEP_MASTERUPGRADED', N'SLEEP_MSDBSTARTUP', N'SLEEP_SYSTEMTASK', N'SLEEP_TASK', N'SLEEP_TEMPDBSTARTUP', N'SNI_HTTP_ACCEPT', N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH', N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP', N'SQLTRACE_WAIT_ENTRIES', N'WAIT_FOR_RESULTS', N'WAITFOR', N'WAITFOR_TASKSHUTDOWN', N'WAIT_XTP_RECOVERY', N'WAIT_XTP_HOST_WAIT', N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG', N'WAIT_XTP_CKPT_CLOSE', N'XE_DISPATCHER_JOIN', N'XE_DISPATCHER_WAIT', N'XE_TIMER_EVENT') AND [waiting_tasks_count] > 0 )

  SELECT MAX ([W1].[wait_type]) AS [WaitType],
             CAST (MAX ([W1].[WaitS]) AS DECIMAL (16, 2)) AS [Wait_S],
                  CAST (MAX ([W1].[ResourceS]) AS DECIMAL (16, 2)) AS [Resource_S],
                       CAST (MAX ([W1].[SignalS]) AS DECIMAL (16, 2)) AS [Signal_S],
                            MAX ([W1].[WaitCount]) AS [WaitCount],
                                CAST (MAX ([W1].[Percentage]) AS DECIMAL (5, 2)) AS [Percentage],
                                     CAST ((MAX ([W1].[WaitS]) / MAX ([W1].[WaitCount])) AS DECIMAL (16, 4)) AS [AvgWait_S],
                                          CAST ((MAX ([W1].[ResourceS]) / MAX ([W1].[WaitCount])) AS DECIMAL (16, 4)) AS [AvgRes_S],
                                               CAST ((MAX ([W1].[SignalS]) / MAX ([W1].[WaitCount])) AS DECIMAL (16, 4)) AS [AvgSig_S]
  FROM [Waits] AS [W1]
  INNER JOIN [Waits] AS [W2] ON [W2].[RowNum] <= [W1].[RowNum]
GROUP BY [W1].[RowNum]
HAVING SUM ([W2].[Percentage]) - MAX([W1].[Percentage]) < 95;
Se CXPACKET aparecer no topo com um percentual elevado, o paralelismo está contribuindo para a pressão sobre a CPU. Siga as etapas de resolução abaixo.
Se CXPACKET não for dominante, verifique as outras causas descritas neste tópico.
Resolução: limitar o paralelismo por consulta
Use essa abordagem quando apenas consultas específicas provocam paralelismo excessivo.
-
Identifique as consultas que mais consomem CPU executando a instrução a seguir para obter as 50 principais consultas por tempo total de CPU:
SELECT TOP 50 [Avg. MultiCore/CPU time(sec)] = qs.total_worker_time / 1000000 / qs.execution_count,
              [Total MultiCore/CPU time(sec)] = qs.total_worker_time / 1000000,
              [Avg. Elapsed Time(sec)] = qs.total_elapsed_time / 1000000 / qs.execution_count,
              [Total Elapsed Time(sec)] = qs.total_elapsed_time / 1000000,
              qs.execution_count,
              [Avg. I/O] = (total_logical_reads + total_logical_writes) / qs.execution_count,
              [Total I/O] = total_logical_reads + total_logical_writes,
              Query = SUBSTRING(qt.[text], (qs.statement_start_offset / 2) + 1, ((CASE qs.statement_end_offset
                                                                                    WHEN -1 THEN DATALENGTH(qt.[text])
                                                                                    ELSE qs.statement_end_offset
                                                                                END - qs.statement_start_offset) / 2) + 1),
              Batch = qt.[text],
              [DB] = DB_NAME(qt.[dbid]),
              qs.last_execution_time,
              qp.query_plan
FROM sys.dm_exec_query_stats AS qs CROSS APPLY sys.dm_exec_sql_text(qs.[sql_handle]) AS qt CROSS APPLY sys.dm_exec_query_plan(qs.plan_handle) AS qp
where qs.execution_count > 5 --more than 5 occurences ORDER BY [Total MultiCore/CPU time(sec)] DESC;
Para instâncias do SQL Server 2008 R2, visualize os logs de consultas lentas no console do ApsaraDB RDS: acesse a página de detalhes da instância, clique em Logs no painel de navegação à esquerda e abra a aba Slow Log Summary .
-
Analise o plano de execução da consulta com alto consumo de CPU. Adicione
OPTION (MAXDOP 1)ao final da instrução para forçar a execução em thread única:SELECT column1,column2 FROM table1 o INNER JOIN table2 d ON (o.d_id = d.d_id) OPTION (maxdop 1);
Resolução: limitar o paralelismo no nível da instância
Use essa abordagem quando o paralelismo causa pressão ampla sobre a CPU em muitas consultas.
-
Verifique a configuração atual do grau máximo de paralelismo (DOP):
SELECT * FROM SYS.CONFIGURATIONS
WHERE NAME LIKE '%MAX%';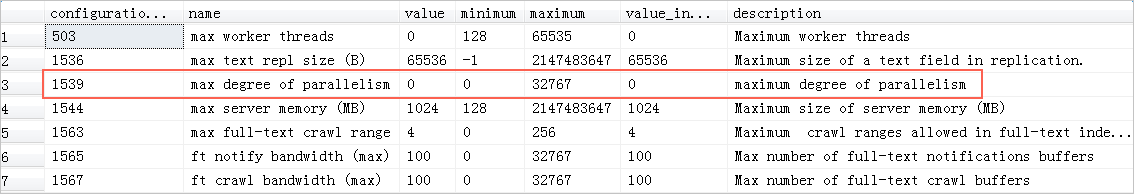
-
Defina o DOP máximo como
1para limitar todas as consultas da instância à execução em thread única:sp_rds_configure 'max degree of parallelism',1;Para instâncias do SQL Server 2008 R2, modifique este parâmetro no console do ApsaraDB RDS. Para mais detalhes, consulte Reconfigurar os parâmetros de uma instância do ApsaraDB RDS for SQL Server pelo console do ApsaraDB RDS .
Alta carga da aplicação
Identificar a causa
Esta causa se aplica quando:
Não há consultas lentas, ou as consultas lentas não são a causa raiz.
A curva de consultas por segundo (QPS) e a curva de utilização de CPU se movem juntas — quando o QPS sobe, a CPU sobe proporcionalmente.
Esse padrão é comum em sistemas OLTP (processamento de transações online) otimizados, como sistemas de processamento de pedidos, e em aplicações web com altas taxas de leitura. As consultas são simples e já estão eficientes — há pouco espaço para otimizá-las ainda mais.
Resolução
Otimize a arquitetura da aplicação ou atualize o tipo de instância:
Atualize o tipo de instância para adicionar recursos de CPU. Para mais detalhes, consulte Alterar as especificações de uma instância do ApsaraDB RDS for SQL Server.
Otimize as consultas para reduzir o I/O lógico e melhorar a escalabilidade da aplicação. Minimize o número de linhas lidas por cada consulta.
I/O excessivo por varreduras de tabela
Identificar a causa
Esta causa se aplica quando:
Há consultas SQL lentas.
A curva de QPS e a curva de utilização de CPU não coincidem — a CPU está alta mesmo com QPS moderado.
As consultas com alto consumo de CPU envolvem grande número de operações de I/O.
O QPS costuma ser baixo, as consultas individuais são custosas e grandes volumes de dados são varridos por consulta. Essas consultas podem ser otimizadas.
Resolução
-
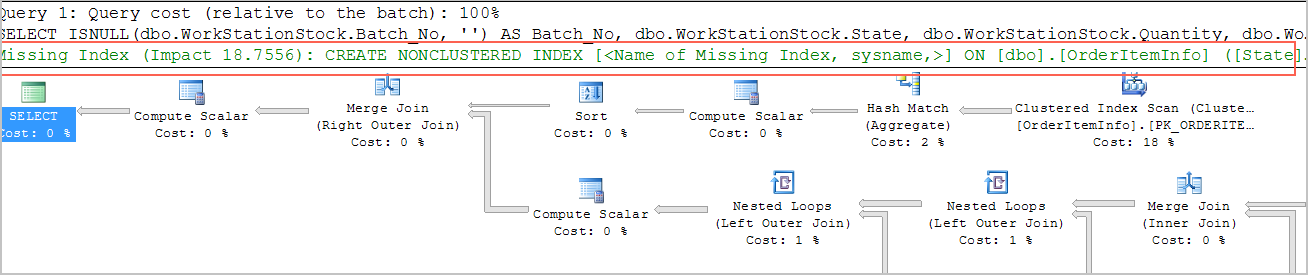
Verifique se existem índices nas tabelas grandes envolvidas nas consultas lentas. Analise o plano de execução e procure por operações de varredura de tabela. O plano de execução exibe sugestões de índices ausentes — use-as como ponto de partida:
Use o CloudDBA para detectar e diagnosticar problemas de desempenho. Para mais detalhes, consulte Visualizar as informações de armazenamento de uma instância do ApsaraDB RDS for SQL Server.
Prevenir a saturação da CPU
Adote estas práticas para reduzir o risco de a CPU atingir 100%:
Configure regras de alerta para a utilização de CPU para agir antes que a saturação ocorra e planejar mudanças de capacidade com antecedência.
Otimize o SQL durante o desenvolvimento. Aplique as regras de otimização de consultas desde o início — reduza o I/O lógico e projete a aplicação pensando em escalabilidade desde a concepção.
Execute testes de carga antes de lançar novos recursos. Use dados de produção e teste em um ambiente semelhante ao de produção antes de qualquer novo recurso ou módulo entrar em operação.
Monitore com o CloudDBA. Verifique regularmente o desempenho das instâncias RDS para identificar problemas com antecedência.