O Database Autonomy Service (DAS) monitora sua instância ApsaraDB RDS for MySQL e aumenta automaticamente a CPU e a memória durante picos de tráfego, reduzindo-as quando a carga diminui. Isso mantém o desempenho estável sem intervenção manual.
Casos de uso
O dimensionamento automático de desempenho é indicado nas seguintes situações:
Tráfego imprevisível. Sua carga de trabalho apresenta picos repentinos — como promoções relâmpago, jobs em lote ou horários de pico comercial — e você precisa que o banco de dados responda sem planejamento prévio.
Evitar provisionamento excessivo. Reduzir as especificações após os horários de pico alinha os custos de recursos à demanda real.
Instâncias de uso geral ou dedicadas. Ambas as famílias de instâncias são compatíveis, embora o comportamento de dimensionamento seja diferente (consulte Como funciona).
Se os picos de tráfego ocorrerem em horários fixos, use o recurso de dimensionamento automático agendado.
Pré-requisitos
Sua instância RDS não deve usar um tipo de instância descontinuado. Se estiver usando, altere o tipo da instância antes de prosseguir.
O saldo da sua conta Alibaba Cloud é suficiente.
Existe uma função vinculada ao service para o DAS. O DAS cria a função AliyunServiceRoleForDAS automaticamente na primeira vez que você ativa o recurso. Portanto, nenhuma configuração manual é necessária, a menos que a função tenha sido excluída.
Como funciona
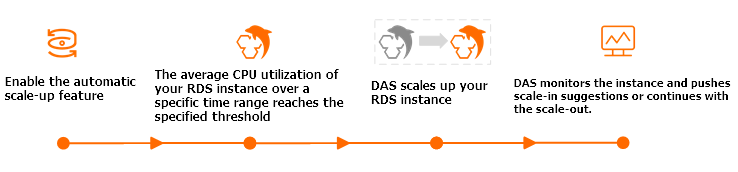
Todas as decisões de dimensionamento baseiam-se na utilização média da CPU dentro de uma janela de observação.
Scale-up
Quando a utilização da CPU atinge o limiar configurado durante toda a janela de observação, o DAS aciona um scale-up. O comportamento exato depende do tipo da sua instância.
Disco em cloud + tipo de instância dedicada (RDS High-availability Edition)
O DAS seleciona o próximo conjunto de especificações dentro do intervalo configurado e executa o scale-up da instância. Após o aumento, o DAS continua o monitoramento. Se a utilização da CPU ultrapassar o limiar novamente na próxima janela de observação, outro scale-up será executado. Esse ciclo se repete até que a instância atinja as especificações máximas definidas por você.
SSD Local Premium + tipo de instância de uso geral (RDS High-availability Edition ou RDS Enterprise Edition)
O DAS dobra a quantidade de núcleos de CPU. Por exemplo, 4 núcleos tornam-se 8 após um scale-up. O IOPS aumenta em 1.000 para cada núcleo de CPU adicionado.
Duas restrições se aplicam:
Os núcleos de CPU só podem ser dobrados uma vez. Após a instância atingir 8 núcleos, não é possível fazer scale-up para 16.
Se o host não tiver recursos de CPU suficientes, o scale-up é ignorado.
Scale-down
O sistema reverte para as especificações originais apenas se o scale-up inicial tiver ocorrido após a ativação do scale-down automático. Caso um scale-up tenha acontecido antes da ativação do scale-down, a instância permanecerá com as especificações aumentadas mesmo depois que o scale-down for ativado.
Instâncias com disco em cloud (RDS High-availability Edition)
Após o término do período de resfriamento, o DAS aciona um scale-down se a utilização da CPU permanecer abaixo de 30% por mais de 99% da janela de observação de scale-down. As especificações são reduzidas incrementalmente até retornarem aos valores originais.
A janela de observação de scale-down corresponde à duração da Janela de Observação mais 10 minutos. Por exemplo, uma janela de observação de 30 minutos resulta em uma janela de scale-down de 40 minutos.
O recurso de scale-down automático requer a nova arquitetura do RDS (kindCode = 18). Para verificar a arquitetura da sua instância, chame a API DescribeDBInstanceAttribute.
SSD Local Premium + tipo de instância de uso geral (RDS High-availability Edition ou RDS Enterprise Edition)
O DAS reduz o IOPS e os núcleos de CPU para as especificações originais se a utilização da CPU permanecer abaixo de 30% por mais de 99% da janela de observação de scale-down configurada.
Faturamento
|
Tipo de instância |
Método de faturamento |
Detalhes |
|
SSD Local Premium + uso geral (RDS High-availability Edition ou RDS Enterprise Edition) |
Pagamento conforme o uso, faturado por hora |
Fórmula: (taxa por núcleo de CPU × número de núcleos de CPU adicionados) × duração do scale-up em minutos |
|
Disco em cloud (RDS High-availability Edition) |
Cobrado pela taxa da instância após o scale-up |
Os preços variam conforme a região e as especificações. Consulte a página de compra do ApsaraDB RDS para ver as taxas atuais. |
Impactos potenciais
Switchover de instância (apenas para instâncias com disco em cloud). Uma alteração de especificação pode desencadear um switchover de instância. Configure sua aplicação para reconectar automaticamente. Para detalhes sobre os impactos, consulte Impactos de um switchover de instância.
Atualização da versão secundária do mecanismo. Se sua instância não estiver executando a versão secundária mais recente do mecanismo, o sistema a atualizará durante a alteração de especificação para garantir desempenho e estabilidade.
-
O dimensionamento aplica-se apenas à instância primária. Se ocorrer um switchover entre primária e secundária após um scale-up:
O DAS executa o scale-up ou scale-down da nova instância primária (anteriormente secundária) quando ela atender às condições de dimensionamento.
A nova instância secundária (anteriormente primária) tem suas especificações reduzidas aos valores originais se atender às condições de scale-down.
Ativar o dimensionamento automático de desempenho
Acesse a página Instances. Na barra de navegação superior, selecione a região onde sua instância RDS está localizada. Encontre a instância e clique em no ID dela.
-
Abra o painel Autonomous Function Management usando um dos seguintes caminhos:
Autonomy Services > Diagnostics > aba Autonomy Center > Autonomy Service Settings
Autonomy Services > Dashboard > Autonomy Service Settings
Na aba Autonomous Function Settings, ative o service de autonomia.
-
Na aba Optimization and Throttling, selecione o recurso apropriado para o tipo da sua instância:
Instâncias com disco em cloud: selecione Automatic Performance Scaling
Instâncias com SSD Local Premium + uso geral: selecione Automatic Resource Elasticity
-
Configure os parâmetros correspondentes ao tipo da sua instância.
Disco em cloud + tipo de instância dedicada
Parâmetro
Descrição
Observation Window
Período de monitoramento usado pelo DAS para avaliar a utilização média da CPU. Um scale-up é acionado quando a utilização média da CPU atinge o limiar dentro desta janela. A janela de scale-down corresponde a este valor mais 10 minutos.
Maximum Specifications
Limite superior para o scale-up. O DAS aumenta as especificações incrementalmente até que a instância atinja este limite.
Automatic Scale-down/in
Quando selecionado, aciona um scale-down após o período de resfriamento se a utilização da CPU estiver abaixo de 30% por mais de 99% da janela de observação de scale-down. As especificações são reduzidas aos valores originais em pequenos incrementos.
Quiescent Period
Intervalo mínimo entre duas operações consecutivas de dimensionamento (período de resfriamento). O DAS monitora a utilização da CPU durante este período, mas não aciona o dimensionamento mesmo que as condições sejam atendidas. Se o período de resfriamento e a janela de observação terminarem simultaneamente e as condições forem atendidas, o DAS aciona o dimensionamento imediatamente.
SSD Local Premium + tipo de instância de uso geral
Parâmetro
Descrição
Scale-up Observation Window
Período de monitoramento usado para avaliar a utilização da CPU para scale-up. O scale-up é acionado quando a utilização média da CPU atinge o limiar.
Scale-down Observation Window
Período de monitoramento usado para avaliar a utilização da CPU para scale-down. O scale-down é acionado se a utilização da CPU permanecer abaixo de 30% por mais de 99% desta janela.
Clique em OK.
-
(Opcional) Na seção Alert Configuration, configure um modelo de alerta para receber notificações sobre eventos de dimensionamento. O sistema sugere um modelo de alerta com regras pré-configuradas para eventos de autonomia. Para configurá-lo:
-
Na etapa Select Alert Contact Group, selecione um grupo de contatos de alerta. Para mais informações, consulte Gerenciar contatos de alerta.
Clique em Add Contact para adicionar um contato individual.
Clique em Create Contact Group para criar um novo grupo.
Use Edit ou Remove na coluna Actions para gerencie contatos existentes.
Na etapa Associate with Resources, confirme os recursos associados.
Clique em Submit Configuration e confirme na caixa de diálogo.
NotaSe já existir um modelo de alerta para sua instância, adicione as regras de eventos de autonomia necessárias a ele em vez de criar um novo modelo. Para configurar modelos do zero, consulte Configurar modelos de alerta e Configurar regras de alerta.
-
Perguntas frequentes
Minha instância atingiu as especificações máximas. Quais são minhas opções?
Adquira uma instância que execute uma edição superior do RDS. Por exemplo, uma instância RDS High-availability Edition com tipo de instância dedicada suporta até 104 núcleos de CPU e 768 GB de memória. Em seguida, migre seus dados para a nova instância.
Para obter detalhes sobre os tipos de instância disponíveis e opções de migração, consulte Especificações e Migrar dados entre instâncias ApsaraDB RDS for MySQL.
Próximos passos
Dimensionamento automático agendado: Configure políticas de dimensionamento em um cronograma fixo e restaure as especificações automaticamente após cada período. Consulte Usar o recurso de dimensionamento automático agendado.
Alteração manual de especificações: Altere as especificações da instância manualmente para instâncias que não suportam o dimensionamento automático de desempenho. Consulte Alterar especificações da instância.