O PolarDB for PostgreSQL Enterprise Edition é um banco de dados nativo da cloud desenvolvido sobre a base do PostgreSQL e expandido com uma arquitetura que desacopla computação e armazenamento. Se você já executa cargas de trabalho PostgreSQL, obtém compatibilidade total com as versões 11, 14, 15, 16 e 17 — seu código, drivers e ferramentas funcionam sem modificações. Além disso, o PolarDB oferece dimensionamento elástico em minutos, recuperação de falhas em segundos e armazenamento distribuído compartilhado que suporta centenas de terabytes sem duplicar dados entre os nós.
Como funciona
O PolarDB for PostgreSQL Enterprise Edition separa armazenamento e computação. Todos os nós de computação compartilham uma única cópia dos dados, o que permite upgrades e downgrades de configuração em nível de minuto, recuperação de falhas em nível de segundo, consistência global de dados e serviços gratuitos de backup e recuperação de desastres.
Os nós de computação (primário e somente leitura) acessam dados em nós de armazenamento remoto em vez de manterem cada um sua própria cópia. Os dados trafegam entre computação e armazenamento por meio de uma rede Remote Direct Memory Access (RDMA), eliminando gargalos de I/O. O protocolo Parallel-RAFT mantém a consistência do armazenamento, e o endpoint do cluster utiliza um Log Sequence Number (LSN) para garantir consistência global de leitura em todos os nós.
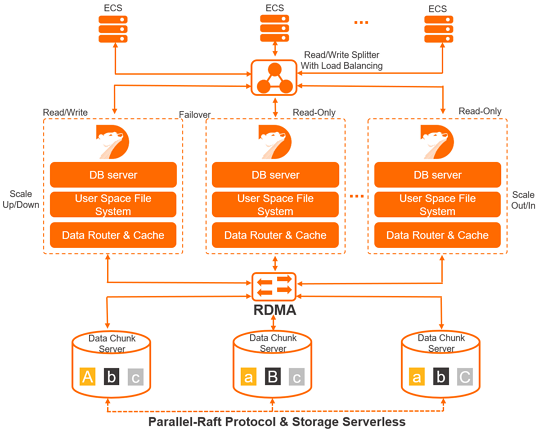
Um cluster consiste em um nó primário e até 15 nós somente leitura:
Nó primário — processa solicitações de leitura e escrita.
Nós somente leitura — atendem solicitações de leitura e participam de failover ativo-ativo com o nó primário, permitindo que um nó somente leitura seja promovido a primário em segundos caso o primário falhe.
Separação de leitura e escrita — o endpoint do cluster distribui automaticamente as solicitações SQL entre os nós sem custo adicional, oferecendo balanceamento de carga transparente e de alto throughput.
Como os nós de computação armazenam apenas metadados e os arquivos de dados residem no armazenamento distribuído compartilhado, adicionar um nó somente leitura significa conectá-lo aos dados já existentes — nenhuma cópia de dados é necessária.
Principais recursos
Dimensionamento elástico
Dimensione a configuração para cima ou para baixo em 5 minutos utilizando virtualização de contêineres e armazenamento de blocos distribuído compartilhado.
Adicione ou remova nós somente leitura em 5 minutos. O endpoint do cluster oculta as alterações de nós das aplicações.
Alta disponibilidade e confiabilidade dos dados
Zero perda de dados em falha de nó único: O armazenamento compartilhado elimina o risco de divergência de réplicas causada por replicação assíncrona.
Recuperação de desastres multizona: Os dados são replicados entre zonas para proteger contra falhas no nível de zona.
Replicação física baseada em redo: A replicação utiliza logs de redo, não registros WAL. Mesmo operações de Data Definition Language (DDL) — como adicionar um índice ou uma coluna a uma tabela grande — não causam atrasos na replicação.
Consistência global de leitura: O endpoint do cluster usa LSN para evitar leituras obsoletas causadas por atraso de replicação entre o nó primário e os nós somente leitura.
Desempenho
Kernel de banco de dados profundamente otimizado com rede baseada em RDMA e armazenamento distribuído compartilhado.
Suporta mais de 500.000 solicitações de leitura por segundo e mais de 150.000 solicitações de escrita por segundo para cargas de trabalho de Online Transaction Processing (OLTP).
Em um cluster de armazenamento compartilhado, uma escrita no primário torna-se imediatamente visível para todos os nós somente leitura — os dados são modificados uma única vez e refletidos em todos os lugares.
Capacidade de armazenamento
Um único cluster suporta até 500 TB de armazenamento por padrão. O armazenamento escala automaticamente conforme o volume de dados (armazenamento serverless), então você paga apenas pelo que utiliza.
O PolarStore (PSL4/PSL5) suporta armazenamento em nível de petabyte. Para reservar esses recursos, contact us .
Backup sem bloqueio
A tecnologia de snapshot no armazenamento distribuído subjacente permite fazer backup de terabytes de dados em minutos sem bloquear tabelas ou impactar o desempenho.
Eficiência de custos
Expansão apenas de computação: Ao adicionar um nó somente leitura, você paga apenas pelo nó de computação — não por réplicas adicionais de armazenamento.
Armazenamento serverless: O armazenamento expande e contrai automaticamente; você paga apenas pelo uso real.
Backup e recuperação de desastres gratuitos: Os serviços de backup e recuperação de desastres estão incluídos sem custo adicional.
Segurança
Listas de permissões, redes Virtual Private Cloud (VPC) e armazenamento de dados com múltiplas réplicas fornecem segurança em camadas para acesso, armazenamento e gerenciamento do banco de dados.
Gerencie seu cluster
Utilize qualquer um dos métodos a seguir para crie e gerencie um cluster do PolarDB for PostgreSQL Enterprise Edition:
|
Método |
Descrição |
|
Interface web gráfica |
|
|
Interface de linha de comando do Alibaba Cloud |
|
|
Acesso programático |
|
|
Cobertura completa de API para todas as operações do console |
Conecte-se ao seu cluster
Após criar um cluster, conecte-se usando uma das opções a seguir:
DMS: Connect to a PolarDB cluster using DMS para desenvolvimento de banco de dados baseado em navegador.
Cliente: Utilize um cliente PostgreSQL de uso geral, como o pgAdmin.