O Qwen3 é a série mais recente de modelos grandes de linguagem da equipe Qwen no Alibaba Cloud. A série inclui dois modelos MoE e seis modelos densos, com melhorias em raciocínio, seguimento de instruções, agentes e capacidades multilíngues. O PAI-Model Gallery oferece todos os 22 modelos, incluindo as versões Base e FP8. Este tópico usa o Qwen3-235B-A22B como exemplo para demonstrar como implantar, invocar, ajustar fino e avaliar modelos dessa série no Model Gallery.
Implantar e invocar um modelo
Implantar um modelo
Este exemplo implanta o modelo Qwen3-235B-A22B com SGLang.
-
Acesse a página do Model Gallery.
Faça login no PAI console e selecione uma região no canto superior esquerdo. Alterne entre regiões para encontrar recursos de computação disponíveis.
No painel de navegação à esquerda, escolha Workspaces e clique em nome do workspace desejado para abri-lo.
No painel de navegação à esquerda, escolha QuickStart > Model Gallery.
Na lista de modelos à direita da página do Model Gallery, clique em cartão do modelo Qwen3-235B-A22B para abrir a página de detalhes do modelo.
-
No canto superior direito, clique em Deploy. Configure os parâmetros abaixo e mantenha os padrões para os demais, a fim de implantar o modelo na plataforma de service de inferência EAS.
Deployment Method: Defina Inference Engine como SGLang e Deployment Template como Single-Node.
-
Resource Information: Em Resource Type, selecione recursos públicos. O sistema recomenda um tipo de instância adequado. Para a configuração mínima de cada modelo, consulte Apêndice: Recursos de computação e limites de tokens.
ImportanteSe nenhuma especificação de instância estiver disponível, os recursos públicos nessa região estão esgotados. Considere as seguintes opções:
Alternar regiões. A região China (Ulanqab) oferece mais recursos preemptíveis Lingjun (ml.gu7ef.8xlarge-gu100, ml.gu7xf.8xlarge-gu108, ml.gu8xf.8xlarge-gu108, ml.gu8tf.8.40xlarge). Recursos preemptíveis podem ser recuperados, portanto defina seu lance com cuidado.
Usar um grupo de recursos EAS. Acesse a página de assinatura de recursos dedicados EAS para adquirir recursos dedicados EAS.
Depurar online
Na parte inferior da página Service details, clique em depuração online. A figura a seguir mostra um exemplo.

Invocar a API
-
Obtenha o endpoint e o token do service.
Em Model Gallery > Job Management > Deployment Jobs, clique em nome do service implantado para abrir a página de detalhes do service.
-
Clique em View Call Information para obter o Internet Endpoint e o token.

-
Exemplo de chamada à API de chat
/v1/chat/completionspara um service implantado com SGLang.curl -X POST \ -H "Content-Type: application/json" \ -H "Authorization: <EAS_TOKEN>" \ -d '{ "model": "<model_name, obtained from the /v1/models API>", "messages": [ { "role": "system", "content": "You are a helpful assistant." }, { "role": "user", "content": "hello!" } ] }' \ <EAS_ENDPOINT>/v1/chat/completionsfrom openai import OpenAI ##### API configuration ##### # Replace <EAS_ENDPOINT> with the service endpoint and <EAS_TOKEN> with the service token. openai_api_key = "<EAS_TOKEN>" openai_api_base = "<EAS_ENDPOINT>/v1" client = OpenAI( api_key=openai_api_key, base_url=openai_api_base, ) models = client.models.list() model = models.data[0].id print(model) stream = True chat_completion = client.chat.completions.create( messages=[ {"role": "user", "content": "Hello, could you please introduce yourself"} ], model=model, max_completion_tokens=2048, stream=stream, ) if stream: for chunk in chat_completion: print(chunk.choices[0].delta.content, end="") else: result = chat_completion.choices[0].message.content print(result)Substitua <EAS_ENDPOINT> pelo endpoint do service e <EAS_TOKEN> pelo token do service.
Os métodos de invocação variam conforme o método de implantação. Para mais métodos de invocação, consulte Invoke an API for a deployed LLM service.
Integração com terceiros
Para se conectar ao Chatbox, Dify ou Cherry Studio, consulte Integrate with third-party clients.
Configuração avançada
Edite a configuração JSON do service para ativar recursos avançados, como ajustar o limite de tokens e habilitar chamada de ferramentas (Function Calling).
Procedimento: Na página de implantação, edite o JSON na seção Service Configuration. Se o service já estiver implantado, atualize-o para acessar a página de implantação.

Modificar limite de tokens
Os modelos Qwen3 suportam nativamente 32.768 tokens. O escalonamento RoPE estende esse valor para 131.072, embora o desempenho possa diminuir ligeiramente. Modifique o campo containers.script no JSON de configuração do service:
-
vLLM:
vllm serve ... --rope-scaling '{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":32768}' --max-model-len 131072 -
SGLang:
python -m sglang.launch_server ... --json-model-override-args '{"rope_scaling":{"rope_type":"yarn","factor":4.0,"original_max_position_embeddings":32768}}'
Analisar chamadas de ferramentas
O vLLM e o SGLang conseguem analisar o conteúdo de chamada de ferramentas gerado pelo modelo em mensagens estruturadas. Modifique o campo containers.script no JSON de configuração do service:
-
vLLM:
vllm serve ... --enable-auto-tool-choice --tool-call-parser hermes -
SGLang:
python -m sglang.launch_server ... --tool-call-parser qwen25
Controlar modo de pensamento
O Qwen3 usa o modo de pensamento por padrão. Um interruptor rígido desativa totalmente o pensamento; um interruptor suave permite que o modelo siga suas instruções sobre se deve pensar ou não.
Usar o interruptor suave/no_think
O exemplo a seguir mostra o corpo da requisição:
{
  "model": "<MODEL_NAME>",
  "messages": [
    {
      "role": "user",
      "content": "/no_think Hello!"
    }
  ],
  "max_tokens": 1024
}
Interruptor rígido
-
Controle via parâmetros de API (vLLM e SGLang): Adicione o parâmetro
chat_template_kwargsà chamada de API. Exemplo:curl -X POST \ -H "Content-Type: application/json" \ -H "Authorization: <EAS_TOKEN>" \ -d '{ "model": "<MODEL_NAME>", "messages": [ { "role": "user", "content": "Give me a short introduction to large language models." } ], "temperature": 0.7, "top_p": 0.8, "max_tokens": 8192, "presence_penalty": 1.5, "chat_template_kwargs": {"enable_thinking": false} }' \ <EAS_ENDPOINT>/v1/chat/completionsfrom openai import OpenAI # # Replace <EAS_ENDPOINT> with the service endpoint and <EAS_TOKEN> with the service token. openai_api_key = "<<EAS_TOKEN>" openai_api_base = "<EAS_ENDPOINT>/v1" client = OpenAI( api_key=openai_api_key, base_url=openai_api_base, ) chat_response = client.chat.completions.create( model="<MODEL_NAME>", messages=[ {"role": "user", "content": "Give me a short introduction to large language models."}, ], temperature=0.7, top_p=0.8, presence_penalty=1.5, extra_body={"chat_template_kwargs": {"enable_thinking": False}}, ) print("Chat response:", chat_response)Substitua <EAS_ENDPOINT> pelo endpoint do service, <EAS_TOKEN> pelo token e <MODEL_NAME> pelo nome do modelo obtido pela API
/v1/models. -
Desativar modificando a configuração do service (BladeLLM): Use um modelo de chat que impeça o modelo de gerar conteúdo de pensamento na inicialização.
-
Na página do modelo no Model Gallery, verifique se há um método fornecido para desativar o modo de pensamento no BladeLLM. Por exemplo, com o Qwen3-8B, modifique o campo
containers.scriptno JSON de configuração do service para desativar o modo de pensamento:blade_llm_server ... --chat_template /model_dir/no_thinking.jinja -
Crie seu próprio modelo de chat, como
no_thinking.jinja, monte-o a partir do OSS e atualize o campocontainers.scriptno JSON de configuração do service.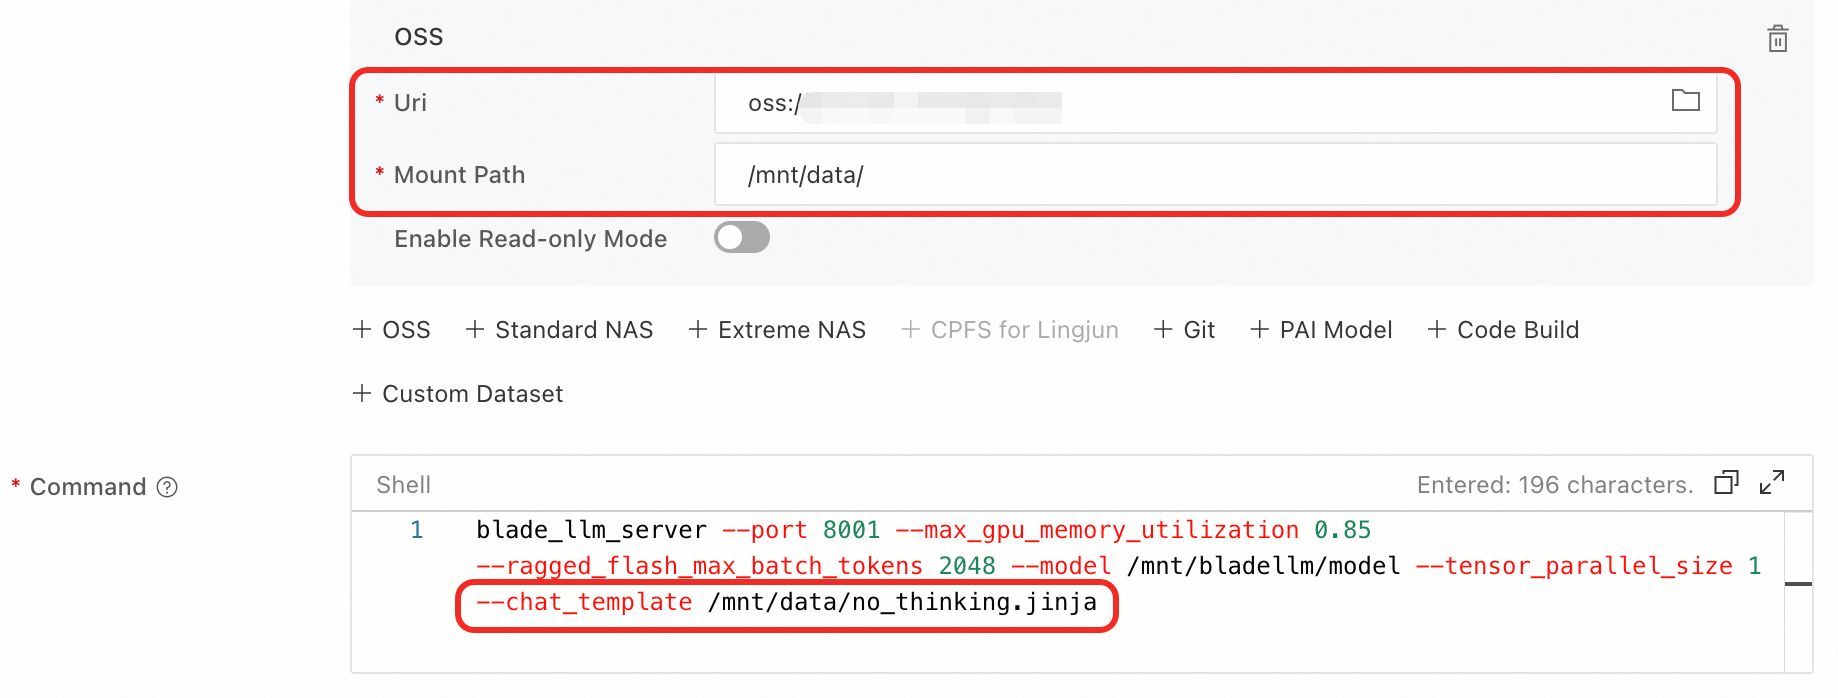
-
Analisar conteúdo de pensamento
Para gerar o conteúdo de pensamento separadamente, modifique o campo containers.script no JSON de configuração do service:
-
vLLM:
vllm serve ... --enable-reasoning --reasoning-parser qwen3 -
SGLang:
python -m sglang.launch_server ... --reasoning-parser deepseek-r1
Ajustar fino um modelo
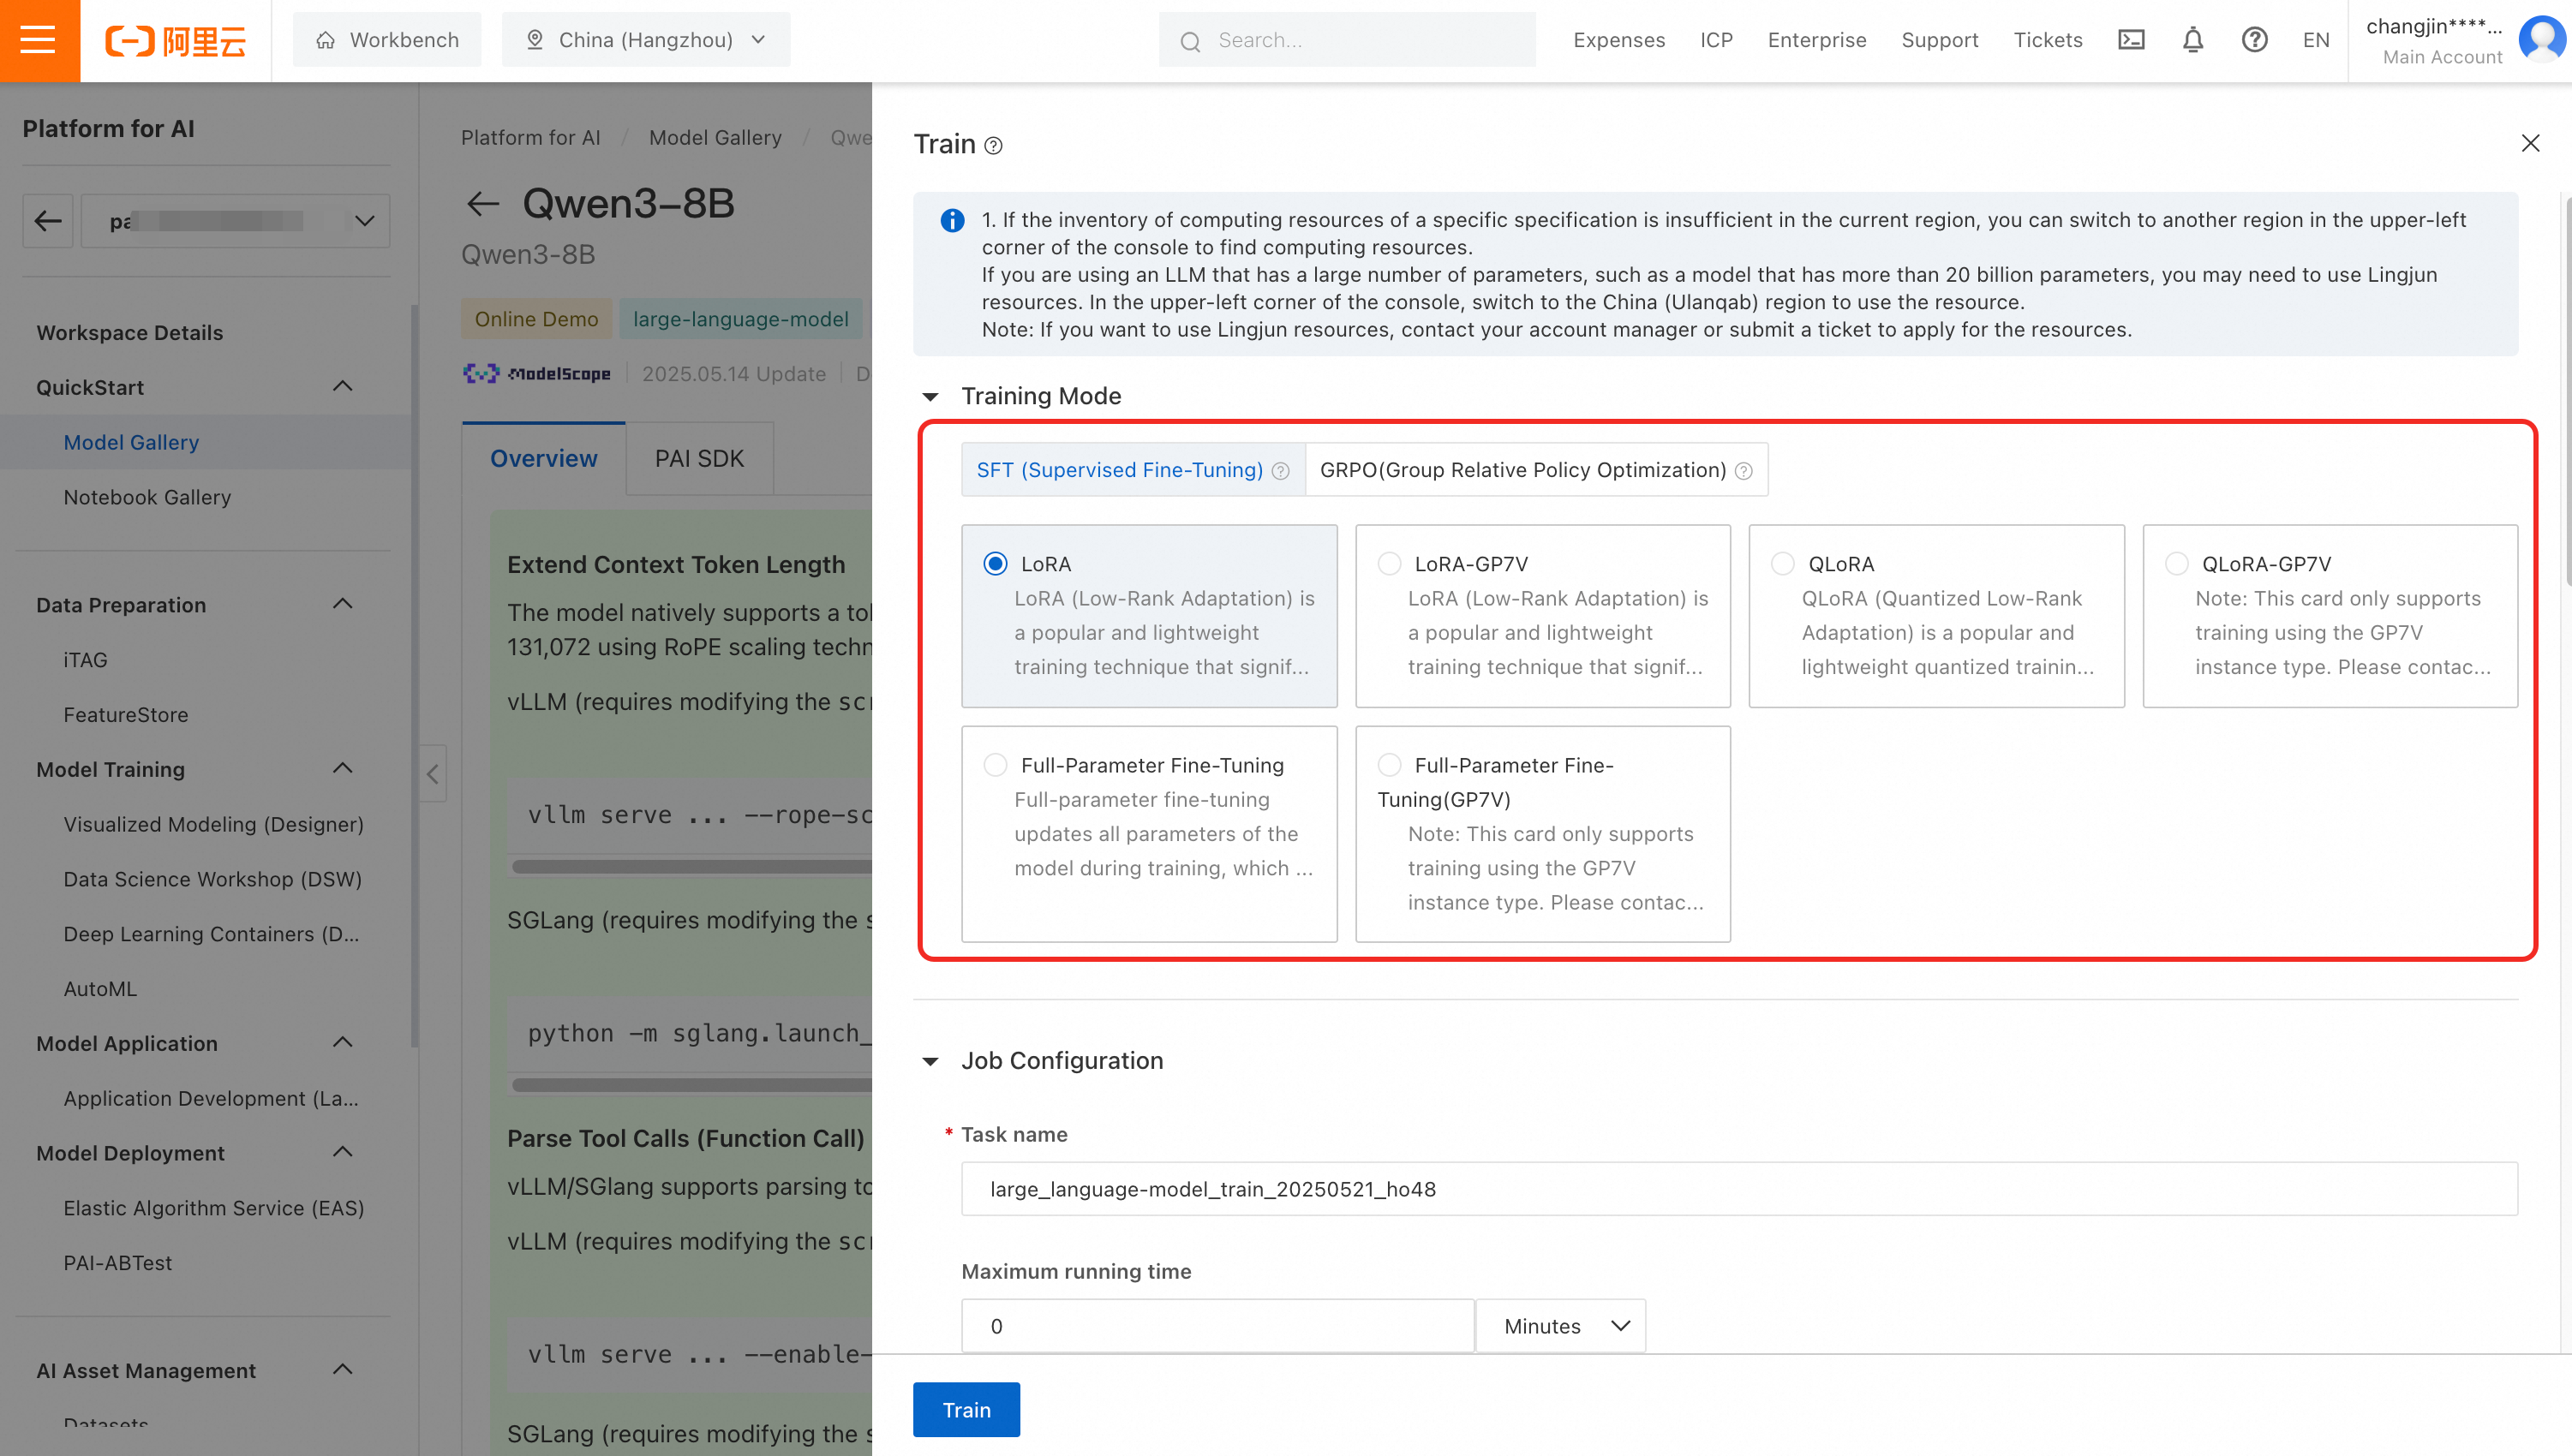
Os modelos Qwen3-32B, 14B, 8B, 4B, 1,7B e 0,6B suportam SFT (ajuste fino de parâmetros completos, LoRA e QLoRA) e treinamento GRPO.
Use o envio de tarefas de treinamento com um clique para treinar um modelo dedicado aos cenários de negócios da sua empresa.

Avaliar um modelo
Para instruções detalhadas sobre avaliação de modelos, consulte Model evaluation e Best practices for LLM evaluation.
Apêndice: Recursos de computação e limites de tokens
A tabela a seguir lista a configuração mínima de implantação de cada modelo Qwen3 e o número máximo de tokens que cada tipo de instância suporta em diferentes frameworks de inferência.
Entre os modelos FP8, apenas o Qwen3-235B-A22B requer menos poder de computação do que seu modelo original. Os outros modelos FP8 exigem o mesmo poder de computação que suas versões não-FP8, portanto não estão listados na tabela. Por exemplo, para o poder de computação necessário pelo Qwen3-30B-A3B-FP8, consulte Qwen3-30B-A3B.
Modelo | Máximo de tokens (entrada + saída) | Configuração mínima | |
Implantação acelerada com SGLang | Implantação acelerada com vLLM | ||
Qwen3-235B-A22B | 32.768 (com escalonamento RoPE: 131.072) | 32.768 (com escalonamento RoPE: 131.072) | 8 × GPU H / GU120 (8 × 96 GB VARM) |
Qwen3-235B-A22B-FP8 | 32.768 (com escalonamento RoPE: 131.072) | 32.768 (com escalonamento RoPE: 131.072) | 4 × GPU H / GU120 (4 × 96 GB VARM) |
Qwen3-30B-A3B Qwen3-30B-A3B-Base Qwen3-32B | 32.768 (com escalonamento RoPE: 131.072) | 32.768 (com escalonamento RoPE: 131.072) | 1 × GPU H / GU120 (96 GB VARM) |
Qwen3-14B Qwen3-14B-Base | 32.768 (com escalonamento RoPE: 131.072) | 32.768 (com escalonamento RoPE: 131.072) | 1 × GPU L / GU60 (48 GB VARM) |
Qwen3-8B Qwen3-4B Qwen3-1,7B Qwen3-0,6B Qwen3-8B-Base Qwen3-4B-Base Qwen3-1,7B-Base Qwen3-0,6B-Base | 32.768 (com escalonamento RoPE: 131.072) | 32.768 (com escalonamento RoPE: 131.072) | 1 × A10 / GU30 (24 GB VARM) Importante Um modelo 8B com escalonamento RoPE requer 48 GB de VARM. |
FAQ
P: Os services de modelo implantados no PAI suportam sessões que retêm contexto entre múltiplas requisições?
Não. As APIs de service de modelo implantadas no PAI são stateless. Cada chamada é totalmente independente, e o servidor não retém contexto ou estado de sessão entre requisições.
Para implementar conversas de múltiplas rodadas, o cliente deve armazenar o histórico da conversa e anexá-lo a cada requisição. Para um exemplo de requisição, consulte How do I implement a multi-turn conversation?