Uma base de conhecimento complementa um LLM com dados privados e informações atualizadas. Por meio da geração aumentada por recuperação (RAG), o LLM melhora a precisão das respostas ao recuperar primeiro o conteúdo relevante da base de conhecimento antes de gerar uma resposta.
Importante
-
Restrições de acesso ao console: Apenas usuários que criaram aplicações do Alibaba Cloud Model Studio na região de Singapore antes de 21 de abril de 2025 podem acessar a aba Application Development.
Esta aba contém os seguintes recursos: Applications ( agent application e workflow application ), Components ( prompt engineering e plug-in ) e Data ( knowledge base e application data ). Todos estes são recursos de pré-visualização. Use-os com cautela em ambientes de produção.
-
Restrições de chamada de API: Apenas usuários que criaram aplicações do Alibaba Cloud Model Studio na região de Singapore antes de 21 de abril de 2025 podem chamar as APIs de dados de aplicação, base de conhecimento e prompt engineering.
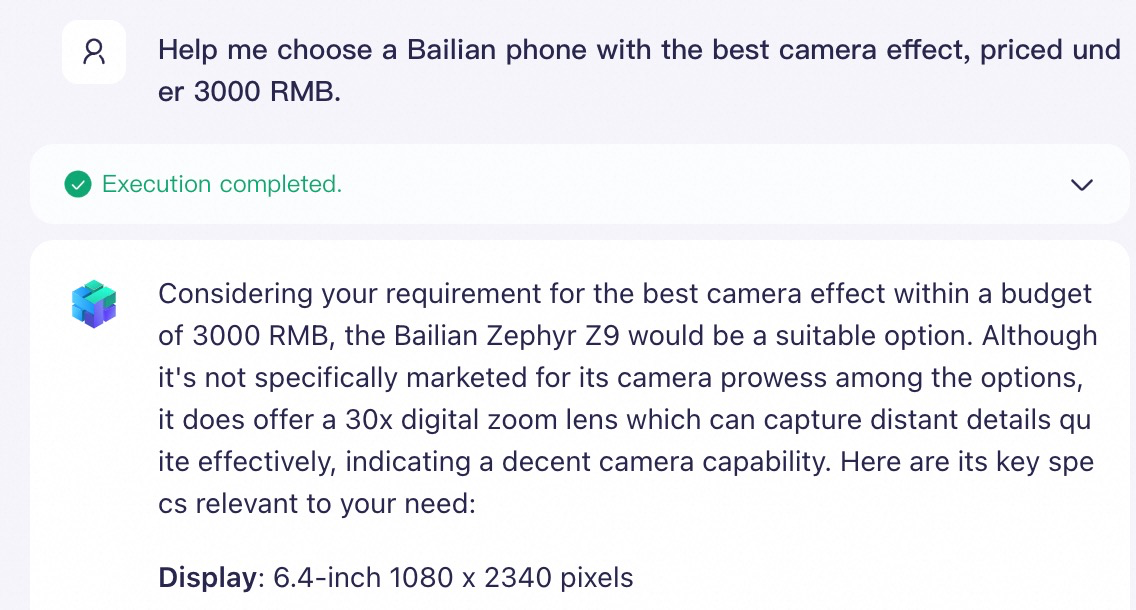
Aplicação sem base de conhecimento dedicada Sem uma base de conhecimento dedicada, um LLM não consegue responder com precisão a perguntas específicas de domínio. Por exemplo, quando um usuário envia "Por favor, ajude-me a escolher o melhor celular com câmera do Alibaba Cloud Model Studio, com orçamento de 3.000 yuans" na interface de chat, o assistente de IA não pode fornecer recomendações precisas de produtos devido à falta de uma base de conhecimento relevante. | Aplicação com base de conhecimento dedicada Com uma base de conhecimento dedicada, um LLM responde com precisão a perguntas específicas de domínio.
|
Modelos suportados
Os modelos a seguir podem ser usados com uma base de conhecimento. Configure o Qwen para usar uma base de conhecimento
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Versão open source do Qwen (por exemplo, Qwen2.5)
Para obter uma lista atualizada dos modelos disponíveis, consulte a página Application Management ao criar uma aplicação.
Início rápido
Este guia de início rápido mostra como criar uma aplicação de perguntas e respostas com LLM sem código para responder a questões específicas de domínio, usando "celulares do Alibaba Cloud Model Studio" como exemplo.
1. Criar uma base de conhecimento
- Acesse a página Knowledge Base e clique em Create Knowledge Base. Insira um Name e uma Description, mantenha as demais configurações com os valores padrão e clique em Next Step.
- Selecione a Default Category e faça upload do arquivo Alibaba Cloud Model Studio Phone Series Product Introduction.docx. Clique em Next Step e, em seguida, clique em Complete.
2. Integrar com aplicações de negócios
Após criar uma base de conhecimento, associe-a a uma aplicação do Alibaba Cloud Model Studio ou a uma aplicação externa dentro do mesmo workspace para processar solicitações de recuperação.
Agent application
-
Acesse a página App Center, localize sua agent application, clique em Configure no cartão correspondente e selecione um modelo para a aplicação.
-
Clique no ícone + ao lado de Document Knowledge Base para adicionar a base de conhecimento recém-criada. Mantenha os valores padrão para o limiar de similaridade e peso.
(Opcional) Limiar de similaridade: Filtrar resultados de recuperação
Uma base de conhecimento utiliza busca semântica para encontrar texto conceitualmente relevante em seus dados ou arquivos privados, mesmo sem palavras-chave correspondentes.
Por exemplo, um usuário envia a seguinte consulta:
Qual celular da Alibaba Cloud é melhor para fotografia?A resposta real (por exemplo, "Qwen Vivid 7...") não contém nenhuma palavra-chave da consulta.
Na tabela abaixo, a similaridade de palavras-chave é calculada usando o índice de Jaccard , e a similaridade semântica é a similaridade de cosseno calculada pelo modelo
text-embedding-v4.Texto recuperado
Similaridade de palavras-chave
Similaridade semântica
Qwen Vivid 7: Uma nova experiência em fotografia inteligente
0
0,43
Alibaba Cloud Model Studio Ace Ultra: A escolha para gamers
0,17
0,32
Alibaba Cloud Model Studio Flex Fold+: Uma nova era de telas dobráveis
0,25
0,24
Limiar de similaridade: Apenas textos com pontuação de similaridade semântica superior a este valor são recuperados. Definir esse limiar muito alto pode filtrar textos relevantes.
(Opcional) Peso: Influenciar a ordem de recuperação de múltiplas bases de conhecimento
Quando uma agent application está associada a várias bases de conhecimento, atribua um peso a cada uma com base na importância da fonte de informação. Durante a recuperação de múltiplas fontes, se chunks de diferentes bases de conhecimento tiverem a mesma pontuação de similaridade, o sistema prioriza chunks da base de conhecimento com maior peso.
- Limitação principal: O peso só tem efeito entre bases de conhecimento do mesmo tipo. Por exemplo, o peso de uma base de conhecimento de busca de documentos não afeta a ordem de recuperação de uma base de conhecimento de consulta de dados, e vice-versa.
- Funcionamento: O sistema calcula primeiro a relevância da consulta do usuário em relação ao conteúdo de cada base de conhecimento para identificar os chunks mais relevantes. Em seguida, multiplica a pontuação de similaridade de cada chunk pelo peso de sua base de conhecimento correspondente. Após o reranking baseado nessas pontuações ponderadas, os resultados são fornecidos ao LLM como contexto, garantindo que chunks com maiores pontuações ponderadas tenham prioridade na resposta final.
-
Na caixa de entrada à direita, insira uma pergunta. O LLM usará a base de conhecimento para gerar uma resposta.
Por exemplo: "Ajude-me a escolher o celular do Alibaba Cloud Model Studio com a melhor câmera por menos de 3.000 CNY."
Estratégia de geração em lote: Quando você precisa que uma agent application gere um grande volume de conteúdo a partir de uma base de conhecimento, como perguntas de quiz ou resumos, uma única solicitação pode retornar menos itens do que o solicitado porque o comprimento de saída de uma resposta do LLM é limitado. Divida a solicitação em vários lotes de cerca de 30 itens cada e conclua-os em múltiplos turnos. Por exemplo, envie primeiro "Gere as perguntas 1-30 com base na base de conhecimento" e, após a conclusão desse lote, envie "Continue com as perguntas 31-60". Referência medida: uma única solicitação para 100 perguntas retornou apenas cerca de 24 perguntas, enquanto três lotes de 30 perguntas cada retornaram todas as 30 perguntas por lote, totalizando 90 perguntas. O número real de itens gerados varia conforme o modelo selecionado e o comprimento do conteúdo, portanto use seus próprios testes como referência final.
Workflow application
-
Acesse a página App Center, localize sua workflow application e clique em Configure no cartão correspondente. Arraste um nó Knowledge Base para o canvas e conecte-o após o nó Start.
-
Configure o nó Knowledge Base:
-
Input: Na lista suspensa Value à direita da variável
content, selecione Built-in Variable > query. A lista suspensa possui estrutura de árvore; talvez seja necessário expandir o grupo "Built-in Variable" para selecionar a variável query. -
Select Knowledge Base: Selecione uma base de conhecimento para o nó de duas maneiras possíveis.
- Selecionar uma base de conhecimento fixa: Escolha a base de conhecimento criada na etapa anterior no menu suspenso. Utilize este método quando a mesma base de conhecimento for necessária para cada chamada.
- Seleção dinâmica: Configure a variável
CodeListpara especificar dinamicamente uma base de conhecimento com base na saída de um nó upstream. Indicado para cenários onde é necessário recuperar diferentes bases de conhecimento conforme entradas distintas.
-
Definir TopK (Opcional): Esta configuração determina o número de chunks retornados aos nós downstream, que geralmente são nós LLM.
Aumentar este valor geralmente melhora a precisão das respostas do LLM, mas também eleva o consumo de tokens de entrada do LLM.
-
-
Arraste um nó LLM para o canvas e conecte-o após o nó Knowledge Base e antes do nó End.
-
Configure o nó LLM:
-
Na lista Model configuration, selecione um modelo para o nó.
-
No campo Prompt, insira um prompt que instrua o LLM a usar a base de conhecimento. Digite "/" para inserir a variável
result(que representa os resultados retornados da recuperação da base de conhecimento).Por exemplo, insira o título do prompt como
# Knowledge Basee o corpo comoLembre-se dos seguintes materiais {Knowledge Base 1/result}, eles podem ser úteis para responder às perguntas.
-
-
Configure o nó End: Insira
/e selecione LLM 1 > result para emitir o resultado do LLM. -
Clique em Test no canto superior direito da página. Na caixa de entrada à direita, insira uma pergunta. O LLM usará a base de conhecimento para gerar uma resposta.
Por exemplo: "Ajude-me a escolher o celular do Alibaba Cloud Model Studio com a melhor câmera por menos de 3.000 CNY."
External application
Além de criar aplicações dentro do Alibaba Cloud Model Studio, utilize o Model Studio SDK para recuperar dados de uma base de conhecimento destinada a aplicações externas de IA.
Para obter etapas detalhadas de integração, consulte o Guia da API de Base de Conhecimento.
3. Otimizar o desempenho de RAG (Opcional)
Caso receba resultados incompletos ou imprecisos no processo de perguntas e respostas, consulte Otimização de desempenho de RAG.
Guia prático
Na página de base de conhecimento, visualize e gerencie todas as bases de conhecimento no workspace atual.
ID da base de conhecimento: O
IDde cada base de conhecimento, utilizado para chamadas de API.
Criar uma base de conhecimento
Após clicar em Create Knowledge Base, crie a base de conhecimento em três etapas: forneça informações básicas e selecione um tipo de base de conhecimento, configure uma fonte de dados e defina parâmetros de índice.
-
Na página de base de conhecimento, clique em Create Knowledge Base.
-
Informações básicas
Selecione um Knowledge Base Type conforme seu caso de uso. Uma única base de conhecimento suporta apenas um tipo. Se selecionar o tipo document search, escolha também um caso de uso: Basic document Q&A, Rich-text Reply.
- Basic document Q&A: Ideal para busca semântica em documentos de texto simples.
- Rich-text Reply: Recomendado para casos de uso que exigem respostas contendo texto e imagens.
Não é possível alterar o tipo da base de conhecimento após sua criação.
-
Document search
-
Casos de uso:
- Projetado para recuperar informações de dados não estruturados, como documentos corporativos internos e manuais de produtos. Dados não estruturados são informações não organizadas em um modelo ou esquema predefinido, podendo incluir texto, tabelas e imagens.
- Se seus arquivos contêm imagens que devem ser incluídas nas respostas da aplicação, selecione document search.
-
Fonte de dados: Faça upload de arquivos locais ou importe-os do Object Storage Service (OSS).
Criação de busca de documentos
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento visando a recuperação. Utilize upload local ou importação da nuvem (selecionando uma categoria ou arquivo existente).
-
Upload local: Carregue arquivos diretamente do seu computador. Expanda o painel retrátil abaixo para saber como selecionar um método de parsing.
Métodos de parsing
Configure a estratégia de parsing conforme suas necessidades. Se não tiver certeza sobre qual opção escolher, recomendamos usar as configurações padrão.
- Digital Parsing: Não analisa ilustrações ou gráficos nos arquivos. Este é o método de parsing mais rápido. Um documento de texto simples de 10 a 20 páginas é geralmente processado em alguns segundos a 1 minuto.
- Intelligent Document Parsing: Reconhece e extrai texto de ilustrações nos arquivos para gerar resumos textuais. Esses resumos, juntamente com outro conteúdo não imagético, são divididos em chunks e vetorizados para recuperação. Este método é relativamente rápido. Um documento de 10 a 20 páginas com ilustrações leva normalmente de 1 a 5 minutos para ser processado.
- LLM Parsing: Permite que aplicações usando o modelo Qwen-VL respondam a perguntas sobre o conteúdo de ilustrações e gráficos nos arquivos. Para ativar o reconhecimento e compreensão desse conteúdo, selecione LLM Parsing. Como este método chama um LLM para compreensão profunda, um documento de 10 a 20 páginas com gráficos leva tipicamente de 2 a 10 minutos para ser processado.
- Parsing Qwen-VL: Projetado especificamente para arquivos de imagem. Especifique um modelo Qwen-VL e forneça um prompt para orientar o reconhecimento e extração do layout e elementos da imagem. Uma única imagem é geralmente processada em alguns segundos a 1 minuto.
-
Importação da nuvem: Importe arquivos existentes de Object Storage Service (OSS).
-
-
Configuração de índice: Define como os dados importados são processados e armazenados, afetando diretamente o desempenho da recuperação.
Dentre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar custos. Todas as outras configurações são gratuitas.
Extração de metadados
Metadados consistem em atributos adicionais para dados não estruturados, integrados aos chunks como pares chave-valor.
- Finalidade: Metadados fornecem contexto importante para chunks e podem melhorar significativamente a precisão da recuperação da base de conhecimento. Por exemplo, considere uma base de conhecimento contendo milhares de arquivos de introdução de produtos onde o nome do arquivo é o nome do produto. Quando um usuário busca por "visão funcional do Produto A", se o corpo de todos os arquivos contiver "visão funcional", mas nenhum mencionar "Produto A", a base de conhecimento poderá recuperar muitos chunks irrelevantes. No entanto, se você adicionar o nome do produto como metadado a todos os chunks, a base de conhecimento filtrará com precisão os chunks relacionados ao "Produto A" que também contenham "visão funcional". Isso melhora a precisão da recuperação e reduz o consumo de tokens de entrada do LLM.
- Uso: Ao chamar uma aplicação via API, especifique
metadatano parâmetro de solicitaçãometadata_filter. Quando a aplicação recupera informações da base de conhecimento, ela filtra primeiro os arquivos relevantes com base nosmetadataespecificados. - Nota: Não é possível configurar a extração de metadados após a criação da base de conhecimento.
Configuração de metadados
Ative Metadata extraction e clique em Settings para anexar metadados uniformes ou personalizados a todos os arquivos na base de conhecimento. Durante o chunking, os metadados de cada arquivo são integrados aos respectivos chunks.
Novo modelo de metadados
Métodos de extração de valores-
Constante: Anexa um atributo fixo a todos os arquivos na base de conhecimento.
Conforme mostrado no exemplo anterior, se todos os arquivos na base de conhecimento tiverem o mesmo autor, defina uma constante para um campo chamado
author. -
Variável: Anexa um atributo variável a cada arquivo na base de conhecimento. Os atributos suportados atualmente são
file_nameecat_name. Se selecionarfile_name, o Alibaba Cloud Model Studio anexa o nome do arquivo aos seus metadados, conforme o exemplo anterior. Se selecionarcat_name, o Alibaba Cloud Model Studio anexa o nome da categoria que contém o arquivo aos metadados do arquivo. -
LLM: O sistema compara o conteúdo do arquivo com a regra Entity Description configurada, extrai as informações relevantes e as anexa como atributo de metadado.
Conforme mostrado no modelo de metadados do exemplo anterior, para extrair todos os anos que aparecem em cada arquivo como atributos de arquivo, configure um campo LLM chamado
date. A descrição da entidade é configurada da seguinte forma:Na caixa de entrada Entity Description, insira
informações de data, extraia apenas o anoe clique em OK. -
RegEx: O sistema compara o conteúdo textual de cada arquivo na base de conhecimento com a expressão regular especificada. O conteúdo correspondente à expressão é extraído e adicionado como atributo aos metadados do arquivo.
Conforme mostrado no modelo de metainformações do exemplo acima, se precisar extrair todas as referências que aparecem em cada arquivo (assumindo que uma referência seja qualquer texto começando com '《' e terminando com '》'), configure um campo de expressão regular chamado
reference. A expressão regular é configurada da seguinte forma:Defina o valor da expressão regular como
《.*?》. -
Busca por palavras-chave: O sistema pesquisa palavras-chave predefinidas em cada arquivo e adiciona as palavras-chave correspondentes como atributos aos metadados do arquivo.
Por exemplo, no modelo de metadados do exemplo anterior, as palavras-chave predefinidas são:
Como o arquivo contém apenas as palavras-chave "financiamento", "indústria", "verde" e "capital", o sistema extrai apenas essas quatro palavras-chave como valor para o atributo
keywordsdo arquivo.
Used for Retrieval: Se ativado, o campo e o valor de metadados são usados para recuperação na base de conhecimento junto com o conteúdo do chunk. Se desativado, apenas o conteúdo do chunk é usado para recuperação.
Used for Model Reply: Se ativado, o campo e o valor de metadados são fornecidos ao LLM como entrada para geração de resposta junto com o conteúdo do chunk. Se desativado, apenas o conteúdo do chunk é fornecido ao LLM para geração de resposta.
Montagem de cabeçalho Excel
Quando ativado, a base de conhecimento trata a primeira linha de todos os arquivos XLSX e XLS como cabeçalho e a anexa automaticamente a cada chunk (linha de dados). Isso evita que o LLM interprete erroneamente o cabeçalho como uma linha de dados comum.
Escopo: Esta configuração aplica-se apenas a arquivos de tabela XLSX e XLS na base de conhecimento, tratando a primeira linha de cada arquivo como cabeçalho. Não se aplica a formatos não tabulares como PDF, Word ou Markdown. A configuração entra em vigor quando a base de conhecimento é criada (durante o chunking de documentos) e, assim como a estratégia de chunking, não pode ser alterada após a criação da base de conhecimento.
Lógica de processamento: A base de conhecimento divide arquivos de tabela por linha de dados: cada linha, exceto a primeira (cabeçalho), torna-se um chunk separado. Quando esta configuração está ativada, a linha de cabeçalho é anexada automaticamente a cada chunk de linha de dados, de modo que cada chunk carrega tanto os nomes das colunas (cabeçalho) quanto os dados da linha. Isso permite que o LLM interprete cada campo corretamente com base no nome da coluna, e a linha de cabeçalho deixa de ser processada como uma linha de dados comum, evitando confusão semântica durante a recuperação e perguntas e respostas.
Não é necessário ativar esta configuração se a base de conhecimento contiver arquivos em outros formatos, como PDF, ou se os arquivos de tabela não contiverem uma linha de cabeçalho.
Método de chunking
Selecione smart chunking (recomendado).
Finalidade: Uma base de conhecimento divide arquivos em chunks e os converte em vetores usando um modelo de embedding. Os chunks e vetores são então armazenados como pares chave-valor em um banco de dados vetorial. Após a criação da base de conhecimento, visualize ou edite o conteúdo específico (texto e imagens) de cada chunk.
Título do chunk: Além do conteúdo do corpo, cada chunk carrega um título exibido na lista de chunks, usado para identificar o chunk e incluído na recuperação. A base de conhecimento gera o título do chunk automaticamente durante o parsing inteligente de documentos , com base na hierarquia de títulos detectada. Possui duas formas: um título curto (
title, o título mais próximo ao qual o chunk pertence) e um título hierárquico (hier_title, o caminho completo do título de nível superior até o título atual, com níveis unidos por|>, por exemploHeading 1|>Heading 2). Portanto, quanto mais clara for a estrutura de títulos de um documento (como arquivos PDF, Word ou Markdown com títulos de seção bem formados), mais completos serão os títulos de chunk gerados; para arquivos semelhantes a tabelas divididos por linhas de dados e que geralmente carecem de hierarquia textual de títulos (como Excel), o título do chunk depende da detecção de uma hierarquia de títulos durante o parsing, podendo estar vazio quando nenhuma for detectada. Edite também o título do chunk manualmente no gerenciamento de chunks.Nota: Após a criação da base de conhecimento, não é possível alterar as configurações de chunking de documentos . Uma estratégia de chunking inadequada pode reduzir o desempenho de recuperação e recall.
Reescrita de conversa em múltiplas rodadas
Quando ativado, este recurso usa um modelo dedicado para reescrever a consulta do usuário incorporando o histórico da conversa. Esse processo cria uma consulta completa e autônoma para recuperação na base de conhecimento.
Modelo de embedding
Um modelo de embedding converte o prompt de entrada original e o texto de conhecimento em vetores numéricos para que o sistema possa calcular a similaridade semântica. O modelo padrão Official Vector (text-embedding-v2) suporta vários idiomas além de chinês e inglês e normaliza os vetores resultantes. Essa configuração não pode ser alterada.
As dimensões de vetor para são fixas e não podem ser modificadas:
- Official Vector (text-embedding-v2): 1.536 dimensões
- qwen3-vl-embedding: Ativado automaticamente quando o caso de uso de compreensão visual é selecionado. Suporta a geração de vetores para imagens e documentos rich-text após a compreensão visual.
Modelo de reranking
Um modelo de reranking é externo à base de conhecimento. Ele reclassifica os fragmentos candidatos da recuperação vetorial inicial e retorna os K principais fragmentos com as maiores pontuações de similaridade. O reranker oficial recomendado, qwen3-rerank (hybrid), considera tanto a relevância semântica quanto os recursos de correspondência de texto (como pontuações BM25) para lidar melhor com consultas que exigem correspondências precisas de palavras-chave. Se você precisar apenas de classificação semântica, selecione qwen3-rerank.
Modo do modelo de rerankingAo criar uma base de conhecimento, você pode selecionar um dos três modos a seguir para o modelo de reranking:
- Modo Q&A (padrão): Pontua com base na "relevância de Q&A" entre a consulta e os fragmentos candidatos. Este modo é adequado para cenários em que os usuários fazem uma pergunta completa e esperam encontrar a resposta dentro de um fragmento.
- Modo Similaridade: Pontua com base na "similaridade semântica" entre a consulta e os fragmentos candidatos. Este modo é ideal para cenários em que a consulta e os fragmentos têm um estilo de expressão semelhante.
- Modo avançado personalizado: Permite inserir uma instrução em linguagem natural de até 200 caracteres para influenciar o processo de reranking. Este modo é projetado para cenários com requisitos especiais de classificação.
AvisoVocê pode selecionar um modo de modelo de reranking apenas ao criar uma base de conhecimento. Não é possível alterá-lo após a criação. Antes de configurar essa definição, observe as seguintes limitações:
- Limitação de tipo de base de conhecimento: Este recurso aplica-se apenas a bases de conhecimento de busca de documentos, Data Query e busca de áudio/vídeo. Não há suporte para bases de conhecimento de Image Q&A.
- Limitação de caso de uso: Este recurso é suportado apenas para os casos de uso Basic document Q&A e Rich-text Reply. Não há suporte para os casos de uso de compreensão visual (documentos rich-text) e Rapid Q&A.
Limiar de similaridade
Este limiar define a pontuação mínima de similaridade necessária para que um fragmento seja recuperado dos resultados do modelo de reranking.
ObservaçãoEste é o limiar de similaridade padrão para a base de conhecimento. Ao associar a base de conhecimento a um aplicativo específico do Alibaba Cloud Model Studio, você pode definir um limiar separado para esse aplicativo, que substitui o limiar padrão da base de conhecimento.
Reduzir este limiar recupera mais fragmentos, mas pode incluir conteúdo menos relevante. Por outro lado, aumentá-lo recupera menos fragmentos e pode causar o descarte de conteúdos relevantes se definido muito alto.
Use o teste de acerto para ajustar o limiar de similaridade e equilibrar recuperação e precisão.
Contagem máxima de recuperação
O sistema recupera fragmentos relacionados à entrada de todas as bases de conhecimento associadas, reclassifica-os usando um modelo de reranking e seleciona os K fragmentos mais relevantes para adicionar à entrada do LLM como contexto. Esse valor K é a contagem máxima de recuperação (até 20) e determina o número de fragmentos que o modelo de reranking fornece ao LLM para contexto.
Aumentar este valor pode melhorar a precisão da resposta do LLM, mas também aumenta o consumo de tokens de entrada do LLM.
Armazenamento vetorial
Selecione um banco de dados vetorial para armazenar vetores de texto. O banco de dados vetorial Built-in é suficiente para operações básicas da base de conhecimento. Para capacidades avançadas, como gerenciamento de banco de dados, auditoria ou monitoramento, recomendamos o AnalyticDB for PostgreSQL (ADB-PG).
Ao adquirir uma instância do AnalyticDB for PostgreSQL (ADB-PG), você deve ativar a Vector Engine Optimization . Caso contrário, o Alibaba Cloud Model Studio não poderá usar a instância.
Criação de compreensão visual
Ao selecionar o caso de uso visual understanding (rich-text documents), a base de conhecimento usa um modelo de embedding multimodal para compreender visualmente os documentos e preservar as informações originais de layout, em vez de usar métodos tradicionais de fragmentação.
Restrições de formato de arquivo
Na área de upload de arquivos da aba Select data, passe o mouse sobre View format requirements para visualizar os requisitos.
Diferenças na configuração de índice
A configuração de índice para o caso de uso de compreensão visual difere daquela para Basic document Q&A:
- Modelo de embedding: O modelo qwen3-vl-embedding é selecionado automaticamente e não pode ser alterado após a criação.
- Reescrita de conversa em múltiplas rodadas: Pode ser ativada ou desativada.
- Limiar de similaridade: O padrão é 0,20.
- Contagem máxima final de recuperação: O padrão é 5.
- Método de fragmentação: A compreensão visual não usa métodos tradicionais de fragmentação, como fragmentação inteligente ou personalizada. Em vez disso, ela compreende toda a página do documento com base na indexação visual.
Restrições de edição
- O modelo de embedding (qwen3-vl-embedding) e o tipo de armazenamento vetorial (built-in) não podem ser alterados após a criação.
- Você pode alterar a edição da base de conhecimento apenas uma vez por dia.
-
-
Casos de uso:
-
Data query
-
Casos de uso:
-
Ideal para construir sistemas de Q&A baseados em dados estruturados (dados organizados de acordo com um esquema de tabela predefinido), como assistentes para consultar FAQs, dados de produtos ou informações de pessoal.
-
Se seus dados consistem em pares completos de perguntas e respostas de FAQ, selecione Data Query. Por exemplo, se um arquivo Excel contiver duas colunas,
QuestioneAnswer, uma base de conhecimento Data Query pode usar a colunaQuestionpara recuperação e a colunaAnswercomo contexto para a resposta do LLM.Este processamento específico por coluna não está disponível no tipo de base de conhecimento de busca de documentos.
-
É possível importar vários arquivos Excel, mas seus esquemas de tabela devem ser idênticos.
-
-
Integração de fonte de dados: Faça upload de arquivos XLS ou XLSX locais .
Criação de Data query
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para a base de conhecimento. O sistema importa o conteúdo da fonte para a base de conhecimento para recuperação. Use upload local ou importação cloud.
ObservaçãoA fonte de dados não pode ser alterada após a criação da base de conhecimento. Uma única base de conhecimento suporta apenas uma fonte de dados.
- Upload local: Faça upload de tabelas de dados nos formatos XLS ou XLSX do seu computador. A primeira linha deve ser o cabeçalho da tabela.
- Importação cloud (selecionar tabela de dados): Selecione uma tabela de dados existente de um conector de dados do Alibaba Cloud Model Studio .
-
Configuração de índice: Define como os dados importados são processados e armazenados, o que afeta diretamente o desempenho da recuperação.
Entre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar taxas. Todas as outras configurações são gratuitas.
Configurações de recuperação e resposta
-
Used for Retrieval: Se ativado, a base de conhecimento executa a recuperação nesta coluna.
-
Used for Model Reply: Se ativado, os resultados da recuperação desta coluna são fornecidos ao LLM como contexto para geração de resposta. Por exemplo, se você ativar Used for Retrieval para as colunas "Nome", "Gênero", "Cargo" e "Idade", mas ativar Used for Model Reply apenas para as colunas "Nome" e "Cargo", a base de conhecimento recuperará dados de todas as quatro colunas. No entanto, apenas o conteúdo das colunas "Nome" e "Cargo" dos dados recuperados será fornecido ao LLM como contexto para sua resposta.
Como a coluna "Idade" não está ativada para respostas do modelo, o LLM associado a esta base de conhecimento não pode responder à pergunta "Qual é a idade de Zhang San?".
Reescrita de conversa em múltiplas rodadas
Quando ativado, este recurso usa um modelo dedicado para reescrever a consulta do usuário incorporando o histórico da conversa. Esse processo cria uma consulta completa e autônoma para recuperação na base de conhecimento.
Modelo de embedding
Um modelo de embedding converte o prompt de entrada original e o texto de conhecimento em vetores numéricos para que o sistema possa calcular a similaridade semântica. O modelo padrão Official Vector (text-embedding-v2) suporta vários idiomas além de chinês e inglês e normaliza os vetores resultantes. Essa configuração não pode ser alterada.
As dimensões de vetor para são fixas e não podem ser modificadas:
- Official Vector (text-embedding-v2): 1.536 dimensões
- qwen3-vl-embedding: Ativado automaticamente quando o caso de uso de compreensão visual é selecionado. Suporta a geração de vetores para imagens e documentos rich-text após a compreensão visual.
Modelo de reranking
Um modelo de reranking é externo à base de conhecimento. Ele reclassifica os fragmentos candidatos da recuperação vetorial inicial e retorna os K principais fragmentos com as maiores pontuações de similaridade. O reranker oficial recomendado, qwen3-rerank (hybrid), considera tanto a relevância semântica quanto os recursos de correspondência de texto (como pontuações BM25) para lidar melhor com consultas que exigem correspondências precisas de palavras-chave. Se você precisar apenas de classificação semântica, selecione qwen3-rerank.
Modo do modelo de rerankingAo criar uma base de conhecimento, você pode selecionar um dos três modos a seguir para o modelo de reranking:
- Modo Q&A (padrão): Pontua com base na "relevância de Q&A" entre a consulta e os fragmentos candidatos. Este modo é adequado para cenários em que os usuários fazem uma pergunta completa e esperam encontrar a resposta dentro de um fragmento.
- Modo Similaridade: Pontua com base na "similaridade semântica" entre a consulta e os fragmentos candidatos. Este modo é ideal para cenários em que a consulta e os fragmentos têm um estilo de expressão semelhante.
- Modo avançado personalizado: Permite inserir uma instrução em linguagem natural de até 200 caracteres para influenciar o processo de reranking. Este modo é projetado para cenários com requisitos especiais de classificação.
AvisoVocê pode selecionar um modo de modelo de reranking apenas ao criar uma base de conhecimento. Não é possível alterá-lo após a criação. Antes de configurar essa definição, observe as seguintes limitações:
- Limitação de tipo de base de conhecimento: Este recurso aplica-se apenas a bases de conhecimento de busca de documentos, Data Query e busca de áudio/vídeo. Não há suporte para bases de conhecimento de Image Q&A.
- Limitação de caso de uso: Este recurso é suportado apenas para os casos de uso Basic document Q&A e Rich-text Reply. Não há suporte para os casos de uso de compreensão visual (documentos rich-text) e Rapid Q&A.
Limiar de similaridade
Este limiar define a pontuação mínima de similaridade necessária para que um fragmento seja recuperado dos resultados do modelo de reranking.
ObservaçãoEste é o limiar de similaridade padrão para a base de conhecimento. Ao associar a base de conhecimento a um aplicativo específico do Alibaba Cloud Model Studio, você pode definir um limiar separado para esse aplicativo, que substitui o limiar padrão da base de conhecimento.
Reduzir este limiar recupera mais fragmentos, mas pode incluir conteúdo menos relevante. Por outro lado, aumentá-lo recupera menos fragmentos e pode causar o descarte de conteúdos relevantes se definido muito alto.
Use o teste de acerto para ajustar o limiar de similaridade e equilibrar recuperação e precisão.
Contagem máxima de recuperação
O sistema recupera fragmentos relacionados à entrada de todas as bases de conhecimento associadas, reclassifica-os usando um modelo de reranking e seleciona os K fragmentos mais relevantes para adicionar à entrada do LLM como contexto. Esse valor K é a contagem máxima de recuperação (até 20) e determina o número de fragmentos que o modelo de reranking fornece ao LLM para contexto.
Aumentar este valor pode melhorar a precisão da resposta do LLM, mas também aumenta o consumo de tokens de entrada do LLM.
Armazenamento vetorial
Selecione um banco de dados vetorial para armazenar vetores de texto. O banco de dados vetorial Built-in é suficiente para operações básicas da base de conhecimento. Para capacidades avançadas, como gerenciamento de banco de dados, auditoria ou monitoramento, recomendamos o AnalyticDB for PostgreSQL (ADB-PG).
Ao adquirir uma instância do AnalyticDB for PostgreSQL (ADB-PG), você deve ativar a Vector Engine Optimization . Caso contrário, o Alibaba Cloud Model Studio não poderá usar a instância.
-
-
-
Casos de uso:
-
Image Q&A
-
Casos de uso:
- Mais indicado para construir aplicações de recuperação multimodal que suportam busca por imagem e busca por imagem mais texto, como assistentes de descoberta de produtos ou assistentes visuais de Q&A.
-
Integração de fonte de dados: Faça upload de arquivos XLS ou XLSX locais .
Arquivos XLS e XLSX devem conter URLs de imagem publicamente acessíveis para criar índices de imagem. Para detalhes, consulte as instruções de criação abaixo.
Criação de Image Q&A
-
Selecionar dados: Especifique uma fonte de dados (arquivos ou conteúdo) para importar para a base de conhecimento para recuperação. Use upload local ou importação cloud (selecione uma tabela de dados existente de um conector de dados).
ObservaçãoA fonte de dados não pode ser alterada após a criação, e uma única base de conhecimento suporta apenas uma fonte de dados.
-
Upload local: Faça upload de tabelas de dados nos formatos XLS ou XLSX diretamente do seu computador.
Observação
- Requisito de campo: A tabela de dados deve conter pelo menos um campo do tipo
image_urlpara gerar o índice de imagem. - Processo de construção: A base de conhecimento acessa a URL da imagem no campo
image_url, extrai recursos visuais e os converte em vetores para armazenamento. - Processo de recuperação: A base de conhecimento compara o vetor gerado a partir da imagem carregada pelo usuário com os vetores de imagem armazenados e retorna os registros mais relevantes.
- Requisito de campo: A tabela de dados deve conter pelo menos um campo do tipo
-
Importação cloud (selecionar uma tabela de dados): Selecione uma tabela de dados existente dos dados do seu aplicativo no Alibaba Cloud Model Studio.
-
-
Configuração de índice: Define como os dados importados são processados e armazenados, o que afeta diretamente o desempenho da recuperação.
Entre as configurações a seguir, apenas o armazenamento vetorial com AnalyticDB for PostgreSQL (ADB-PG) pode gerar taxas. Todas as outras configurações são gratuitas.
Configurações de recuperação e resposta
-
Used for Retrieval: Se ativado, a base de conhecimento executa a recuperação nesta coluna.
-
Used for Model Reply: Se ativado, os resultados da recuperação desta coluna são fornecidos ao LLM como contexto para geração de resposta. Por exemplo, se você ativar Used for Retrieval para as colunas "Nome", "Gênero", "Cargo" e "Idade", mas ativar Used for Model Reply apenas para as colunas "Nome" e "Cargo", a base de conhecimento recuperará dados de todas as quatro colunas. No entanto, apenas o conteúdo das colunas "Nome" e "Cargo" dos dados recuperados será fornecido ao LLM como contexto para sua resposta.
Como a coluna "Idade" não está ativada para respostas do modelo, o LLM associado a esta base de conhecimento não pode responder à pergunta "Qual é a idade de Zhang San?".
Reescrita de conversa em múltiplas rodadas
Quando ativado, este recurso usa um modelo dedicado para reescrever a consulta do usuário incorporando o histórico da conversa. Esse processo cria uma consulta completa e autônoma para recuperação na base de conhecimento.
Modelo de embedding
Um modelo de embedding converte prompts de entrada originais, texto de conhecimento e imagens em vetores numéricos para permitir comparações de similaridade. Para mais informações, consulte Vetorização de texto e multimodal.
- qwen2.5-vl-embedding: Representa entradas unimodais ou de modo misto como um vetor unificado, adequado para recuperação cross-modal e busca de imagens. Por exemplo, se você inserir uma imagem de uma camisa com o texto "encontre um estilo semelhante que pareça mais jovem", o modelo pode fundir a imagem e as instruções de texto em um único vetor para compreensão.
- multimodal-embedding-v1: Gera vetores separados para cada parte da entrada (imagem e texto).
- qwen3-vl-embedding: Uma versão atualizada do qwen2.5-vl-embedding que melhora ainda mais a compreensão da fusão imagem-texto e a precisão da recuperação cross-modal.
Modelo de reranking
Um modelo de reranking é externo à base de conhecimento. Ele reclassifica os fragmentos candidatos da recuperação vetorial inicial e retorna os K principais fragmentos com as maiores pontuações de similaridade. O reranker oficial recomendado, qwen3-rerank (hybrid), considera tanto a relevância semântica quanto os recursos de correspondência de texto (como pontuações BM25) para lidar melhor com consultas que exigem correspondências precisas de palavras-chave. Se você precisar apenas de classificação semântica, selecione qwen3-rerank.
Modo do modelo de rerankingAo criar uma base de conhecimento, você pode selecionar um dos três modos a seguir para o modelo de reranking:
- Modo Q&A (padrão): Pontua com base na "relevância de Q&A" entre a consulta e os fragmentos candidatos. Este modo é adequado para cenários em que os usuários fazem uma pergunta completa e esperam encontrar a resposta dentro de um fragmento.
- Modo Similaridade: Pontua com base na "similaridade semântica" entre a consulta e os fragmentos candidatos. Este modo é ideal para cenários em que a consulta e os fragmentos têm um estilo de expressão semelhante.
- Modo avançado personalizado: Permite inserir uma instrução em linguagem natural de até 200 caracteres para influenciar o processo de reranking. Este modo é projetado para cenários com requisitos especiais de classificação.
AvisoVocê pode selecionar um modo de modelo de reranking apenas ao criar uma base de conhecimento. Não é possível alterá-lo após a criação. Antes de configurar essa definição, observe as seguintes limitações:
- Limitação de tipo de base de conhecimento: Este recurso aplica-se apenas a bases de conhecimento de busca de documentos, Data Query e busca de áudio/vídeo. Não há suporte para bases de conhecimento de Image Q&A.
- Limitação de caso de uso: Este recurso é suportado apenas para os casos de uso Basic document Q&A e Rich-text Reply. Não há suporte para os casos de uso de compreensão visual (documentos rich-text) e Rapid Q&A.
Limiar de similaridade
Este limiar define a pontuação mínima de similaridade necessária para que um fragmento seja recuperado dos resultados do modelo de reranking.
ObservaçãoEste é o limiar de similaridade padrão para a base de conhecimento. Ao associar a base de conhecimento a um aplicativo específico do Alibaba Cloud Model Studio, você pode definir um limiar separado para esse aplicativo, que substitui o limiar padrão da base de conhecimento.
Reduzir este limiar recupera mais fragmentos, mas pode incluir conteúdo menos relevante. Por outro lado, aumentá-lo recupera menos fragmentos e pode causar o descarte de conteúdos relevantes se definido muito alto.
Use o teste de acerto para ajustar o limiar de similaridade e equilibrar recuperação e precisão.
Contagem máxima de recuperação
O sistema recupera fragmentos relacionados à entrada de todas as bases de conhecimento associadas, reclassifica-os usando um modelo de reranking e seleciona os K fragmentos mais relevantes para adicionar à entrada do LLM como contexto. Esse valor K é a contagem máxima de recuperação (até 20) e determina o número de fragmentos que o modelo de reranking fornece ao LLM para contexto.
Aumentar este valor pode melhorar a precisão da resposta do LLM, mas também aumenta o consumo de tokens de entrada do LLM.
Armazenamento vetorial
Selecione um banco de dados vetorial para armazenar vetores de texto. O banco de dados vetorial Built-in é suficiente para operações básicas da base de conhecimento. Para capacidades avançadas, como gerenciamento de banco de dados, auditoria ou monitoramento, recomendamos o AnalyticDB for PostgreSQL (ADB-PG).
Ao adquirir uma instância do AnalyticDB for PostgreSQL (ADB-PG), você deve ativar a Vector Engine Optimization . Caso contrário, o Alibaba Cloud Model Studio não poderá usar a instância.
-
-
-
Casos de uso:
Selecione um caso de uso com base em seus requisitos, como Q&A básica de documentos, Resposta em rich-text.
Durante horários de pico, a criação da base de conhecimento pode levar várias horas, dependendo do volume de dados.
Atualizar uma base de conhecimento
As alterações em uma base de conhecimento são sincronizadas em tempo real com todas as aplicações que a referenciam.
Busca de documentos
-
Atualização automática (recomendado)
Configure atualizações automáticas integrando OSS, FC e as APIs da base de conhecimento do Model Studio. Siga estas etapas:
- Crie um bucket: Acesse o console do OSS e crie um bucket do OSS para armazenar seus arquivos source.
- Crie uma base de conhecimento: Crie uma base de conhecimento não estruturada para armazenar seu conteúdo privado.
- Crie uma função definida pelo usuário: Acesse o console do FC e crie uma função para lidar com eventos de alteração de arquivos, como criação e exclusão de arquivos. Para mais informações, consulte Criar uma função. A função chama as APIs relevantes do Guia da API da Base de Conhecimento para sincronizar sua base de conhecimento com as alterações de arquivos no OSS.
- Crie um gatilho do OSS: No FC, associe um gatilho do OSS à função definida pelo usuário criada na etapa anterior. Quando ocorrer um evento de alteração de arquivo, como o upload de um novo arquivo para o OSS, o gatilho executa a função no FC.
-
Atualização manual
Na página Base de Conhecimento, localize a base de conhecimento que deseja atualizar e clique em View Details em seu cartão.
-
Para adicionar novos arquivos: Clique em Upload Data e selecione os arquivos existentes no conector de dados.
-
Para excluir um arquivo: Localize o arquivo que deseja remover e clique em Delete à sua direita.
-
Para modificar o conteúdo do arquivo: Não há suporte para atualizações no local e uploads de substituição. Exclua primeiro a versão antiga do arquivo da base de conhecimento e, em seguida, importe a nova versão.
Observação: A falha em excluir a versão antiga pode fazer com que conteúdo desatualizado apareça nas respostas.
-
Consulta de dados e Q&A de imagens
Observação : A página de detalhes de uma base de conhecimento de Q&A de imagens não possui um botão direto de Upload Data . Clique no link View Data Source para abrir a página de detalhes do conector de dados e atualizar os dados.
-
Atualização automática
Não suportado.
-
Atualização manual
Se a fonte de dados da sua base de conhecimento for uma tabela de dados em Dados da Aplicação, atualize-a manualmente em duas etapas.
-
Etapa 1: Atualizar a tabela de dados
Acesse a aba Dados da Aplicação. No painel esquerdo, selecione a tabela de dados desejada e clique em Upload Data.
-
Para inserir novos dados: Selecione Incremental Upload como tipo de importação. Faça upload de um arquivo Excel que contenha apenas a linha de cabeçalho e as novas linhas de dados.
O cabeçalho do arquivo deve corresponder ao esquema atual da tabela. Clique em Download Template para obter um arquivo de modelo com o cabeçalho padrão e, em seguida, adicione seus novos dados a ele.
-
Para excluir dados: Selecione Upload and Overwrite como tipo de importação. Faça upload de um arquivo Excel que contenha a linha de cabeçalho e apenas os registros de dados que deseja manter.
Para obter o conjunto de dados completo, clique no ícone
 para baixar os dados no formato XLSX.
-
Para modificar dados: Selecione Upload and Overwrite como tipo de importação. Faça upload de um arquivo Excel que contenha a linha de cabeçalho e o conjunto de dados completo e modificado.
-
-
Etapa 2: Sincronizar as alterações com a base de conhecimento
Retorne à lista de Bases de Conhecimento, localize a base de conhecimento desejada e clique em View Details em seu cartão. Clique no ícone
 no canto superior esquerdo da tabela de dados e confirme o prompt para sincronizar o conteúdo mais recente da tabela de dados com a base de conhecimento.
Repita essas etapas para cada atualização manual.
-
Etapa 1: Atualizar a tabela de dados
Busca de áudio e vídeo
-
Atualização automática
Não suportado.
-
Atualização manual
Na página Base de Conhecimento, localize uma base de conhecimento que deseja atualizar e clique em View Details em seu cartão.
-
Para adicionar novos arquivos: Clique em Upload Data e selecione os arquivos existentes em Dados da Aplicação.
-
Para excluir um arquivo: Localize o arquivo que deseja remover e clique em Delete à sua direita.
Esta ação remove o arquivo apenas da base de conhecimento. Ela não exclui o arquivo source em Dados da Aplicação .
-
Para modificar o conteúdo do arquivo: Não há suporte para atualizações no local e uploads de substituição. Exclua primeiro a versão antiga do arquivo da base de conhecimento e, em seguida, importe a nova versão.
Observação: A falha em excluir a versão antiga pode fazer com que conteúdo desatualizado apareça nas respostas.
-
Editar base de conhecimento
Após criar uma base de conhecimento, modifique apenas seu nome da base de conhecimento, descrição da base de conhecimento e limiar de similaridade. Para alterar quaisquer outras configurações, exclua e recrie a base de conhecimento. Esta operação está disponível apenas no console e não possui uma API correspondente.
Procedimento: Na página Base de Conhecimento, localize a base de conhecimento desejada, clique no ícone  em seu cartão e, em seguida, clique em Edit. Observação: Modifique a configuração de uma base de conhecimento apenas uma vez por dia civil. Tentativas subsequentes serão rejeitadas silenciosamente.
Excluir uma base de conhecimento
AvisoEsta ação é irreversível.
Antes de excluir uma base de conhecimento, recomendamos desassociá-la de todas as aplicações do Model Studio publicadas.
Ainda é possível excluir uma base de conhecimento associada a aplicações não publicadas.
Procedimento
-
Para cada aplicação publicada associada à base de conhecimento:
- Na página App Center, localize a aplicação associada à base de conhecimento e clique em Configure.
- Na lista de bases de conhecimento, remova a base de conhecimento. Clique em Publish no canto superior direito da página e republicue a aplicação conforme solicitado.
-
Na página Base de Conhecimento, localize a base de conhecimento desejada, clique no ícone
em seu cartão e, em seguida, clique em Delete.
Alterar configuração
A Enterprise Edition usa RCUs para garantir alto desempenho de recuperação com QPS elevado e suporta maior capacidade de armazenamento. A Standard Edition é adequada para desenvolvimento, testes ou cenários de baixa concorrência.
ObservaçãoAlterne entre a Standard Edition e a Enterprise Edition e modifique a contagem de RCU para a Enterprise Edition.
Altere a configuração de uma base de conhecimento apenas uma vez por dia civil.
RCU: Uma Unidade de Computação de Recuperação (RCU) é uma medida da concorrência de recuperação para uma base de conhecimento. 1 RCU suporta até aproximadamente 50 QPS para recuperação online. Uma contagem maior de RCU suporta maior concorrência.
-
Observação:
-
Se uma base de conhecimento Enterprise Edition usar o armazenamento da plataforma, reduza seu espaço de armazenamento utilizado para menos de 80 GB antes de fazer o downgrade para a Standard Edition.
Libere espaço de armazenamento excluindo arquivos ou dados da base de conhecimento.
-
-
Procedimento:
-
Na página Base de Conhecimento, localize a base de conhecimento a ser reconfigurada. Clique no ícone
em seu cartão e, em seguida, clique em Edit. -
Na caixa de diálogo, selecione uma ação com base na edição atual:
- Standard Edition: Selecione Upgrade.
- Enterprise Edition: Selecione Downgrade ou Change RCU Count.
-
Siga as instruções na tela para concluir o processo. A nova configuração entra em vigor imediatamente após clicar em OK.
-
Teste de acerto
Use o teste de acerto para verificar se sua base de conhecimento fornece contexto preciso para sua aplicação de IA. Esse processo envolve simular consultas de usuários, avaliar resultados de recuperação e ajustar o limiar de similaridade.
O modelo de reranking no teste de acerto suporta três modos: Modo Q&A (padrão), projetado para consultas que não correspondem perfeitamente ao conteúdo do documento; modo de similaridade, ideal para consultas altamente semelhantes ao conteúdo do documento; e modo avançado personalizado. As pontuações de classificação para a mesma consulta podem variar significativamente dependendo do modo selecionado. Por exemplo, o mesmo segmento de texto pode pontuar 47% no modo Q&A, mas até 69% no modo de similaridade.
Com o teste de acerto, você pode:
- Verificar se a base de conhecimento fornece contexto eficaz para sua aplicação de IA
- Ajustar o limiar de similaridade para equilibrar taxa de recall e precisão
- Identificar lacunas de conteúdo ou problemas de qualidade na sua base de conhecimento
Casos de uso
- Cenário 1: Consultar preços de produtos
Test input: "How much does your Model Studio phone cost?"
Expected result: Retrieve relevant text segments that contain price information.
- Cenário 2: Solucionar um problema técnico
Test input: "What should I do if my device can't connect to Wi-Fi?"
Expected result: Retrieve relevant text segments about troubleshooting Wi-Fi connection issues.
- Cenário 3: Recuperação com compreensão visual
A visual understanding knowledge base supports three query modes: text-only, image-only, and image+text.
Mode 1 (text-only): Enter "Object Storage Service" to retrieve relevant segments from documents and images.
Mode 2 (image-only): Upload a product screenshot. The system uses visual understanding to match semantically similar segments.
Mode 3 (image+text): Upload an image and enter descriptive text. This combined query can improve retrieval relevance.
- Cenário 4: Q&A Expressa
An Express Q&A knowledge base supports text-only queries (image input is not supported) and is ideal for fast retrieval from structured documents:
Test input: "What is the price of the Qwen Pro 8?"
Expected result: Quickly retrieve relevant FAQ segments that include price information.
Procedimento
-
Na página de base de conhecimento, clique em Hit Test no cartão da base de conhecimento desejada.
-
Na interface de teste, insira uma pergunta — idealmente uma comum entre seus usuários — e revise os resultados da recuperação.
- Resultados da recuperação: Esta seção exibe os resultados da recuperação do teste atual, classificados por similaridade em ordem decrescente. Clique em qualquer segmento de texto para visualizar seu conteúdo.
 Ícone: Para uma base de conhecimento de Q&A de imagens, o sistema primeiro converte a imagem de entrada em um vetor e recupera segmentos relevantes. Em seguida, envia esses segmentos junto com a pergunta para um LLM gerar uma resposta. Para bases de conhecimento de busca de documentos, consulta de dados , o sistema não usa a imagem carregada para recuperação. No entanto, uma base de conhecimento de busca de documentos configurada para "compreensão visual" usa a imagem para recuperação, suportando modos de consulta apenas texto, apenas imagem e imagem+texto. Essa consulta combinada pode melhorar a relevância da recuperação.
-
Verifique se os segmentos de texto relevantes foram recuperados. Caso contrário, ajuste o limiar de similaridade e repita a etapa anterior.
-
Clique em View Recall History para comparar o desempenho de recuperação entre diferentes configurações de limiar.

Cotas e limites
-
Para informações sobre fontes de dados suportadas, capacidade e outros limites para uma base de conhecimento, consulte Cotas e limites da base de conhecimento.
-
Os seguintes limites se aplicam ao associar bases de conhecimento a uma aplicação do Model Studio:
- Busca de documentos: Até 5
- Consulta de dados: Até 5
- Q&A de Imagens: Até 1
O limite total entre vários tipos de base de conhecimento é 11.
Faturamento
O uso do recurso de base de conhecimento é gratuito, mas podem ser aplicadas cobranças ao chamar uma aplicação do Alibaba Cloud Model Studio que utilize esse recurso.
| Etapa | Faturamento | |
|---|---|---|
Gratuito. | ||
Ao chamar uma aplicação do Alibaba Cloud Model Studio, os trechos de texto recuperados da base de conhecimento aumentam a contagem de tokens de entrada do LLM, o que eleva as taxas de inferência do modelo. Para mais informações, consulte Itens faturáveis e preços.
| ||
Gratuito. | ||
Referência de API
- Consulte o diretório de APIs (Base de Conhecimento) para obter a lista completa de APIs de base de conhecimento e seus parâmetros.
- Consulte o guia da API de Base de Conhecimento para instruções detalhadas de uso e exemplos de código.
FAQ
Criação de base de conhecimento
P: Posso excluir um arquivo ou tabela de dados dos Dados da Aplicação após importá-lo para uma base de conhecimento?
- Para bases de conhecimento de busca de documentos: Sim. Os arquivos em uma base de conhecimento são independentes de sua origem nos Dados da Aplicação. Excluir o arquivo de origem não afeta os dados importados.
- Para bases de conhecimento de consulta de dados e Perguntas e Respostas com Imagens: Não. Excluir os dados de origem interrompe funcionalidades como sincronização de dados e visualização da base de conhecimento.
P: O que fazer se uma chamada de API de base de conhecimento retornar o código de erro BailianIndexServiceNotOpen?
O código de erro BailianIndexServiceNotOpen indica que o serviço de base de conhecimento do Model Studio não foi ativado. Faça login no console do Model Studio, acesse a página Data > Knowledge Base e clique em Activate Now para ativar o serviço. Em seguida, tente realizar a chamada de API novamente.
Tratamento de imagens e conteúdo multimodal
P: Meu arquivo contém ilustrações que desejo incluir nas respostas da aplicação do Model Studio. Como proceder?
Busca de documentos
Método 1 (Apenas para aplicações de agente)
-
Ao criar uma base de conhecimento, defina o Knowledge Base Type como document search e a opção With Illustrations como With Illustrations.
Ao selecionar With Illustrations, a base de conhecimento extrai resumos das ilustrações presentes no arquivo. O modelo de linguagem grande decide então se deve inserir uma imagem com base na relevância do resumo para a pergunta do usuário.
ImportanteNão selecione electronic document parsing ao fazer upload de documentos. Esse método de análise não reconhece imagens, o que impede o funcionamento correto do recurso With Illustrations.
-
Ao criar ou editar uma aplicação de agente, selecione o modelo Qwen-Plus ou Qwen-Plus-Latest (testes indicam que esses modelos oferecem o melhor desempenho). Clique no botão + à direita de Document Knowledge Base e adicione a base de conhecimento criada na etapa anterior.
ObservaçãoO comprimento de recall deve ser menor que o comprimento do documento. Caso contrário, o sistema retorna o documento inteiro e ignora a lógica de With Illustrations.
Nota: Os recursos "With Illustrations" e "Show Answer Source" não podem ser ativados simultaneamente.
-
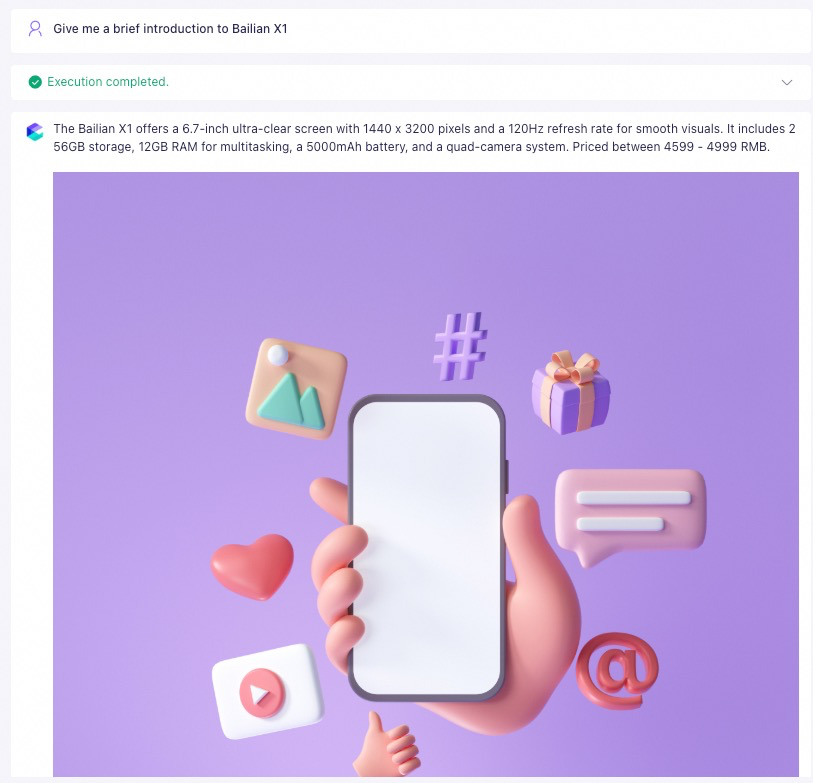
Resultado real de perguntas e respostas:
Método 2 (Para aplicações de agente e workflow)
-
Faça upload da imagem para um local publicamente acessível e obtenha sua URL completa. Recomendamos o uso do OSS. Para instruções, consulte Fazer upload de uma imagem para o OSS e usar sua URL de arquivo.
-
Insira a URL completa no arquivo. Caminhos relativos não são suportados. Não incorpore arquivos de imagem diretamente no documento (por exemplo, copiando e colando ou inserindo uma imagem local via menu). As imagens devem ser referenciadas por meio de suas URLs publicamente acessíveis.
Se uma imagem falhar ao ser exibida, verifique se a URL no trecho está completa. Remova espaços extras ou caracteres especiais que possam causar erros de análise. Edite o trecho diretamente para fazer essas correções.
Exemplo de referência correta de imagem em um arquivo Modelo de prompt de exemplo Resultado real de perguntas e respostas 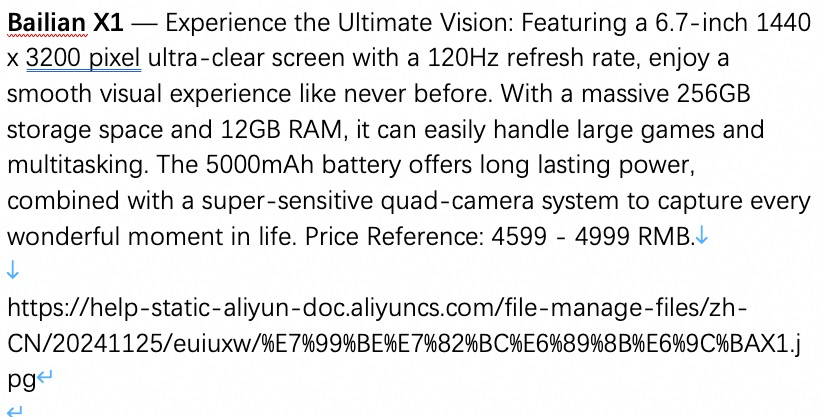
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are image links, display them in full using markdown format.
Exemplo de referência incorreta de imagem em um arquivo Modelo de prompt de exemplo Resultado real de perguntas e respostas 
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
Na interface de teste de chat, após inserir um prompt, a resposta da IA retorna apenas conteúdo de texto simples, sem imagens.
Explicação: Quando uma imagem é incorporada diretamente em um arquivo, a aplicação do Model Studio não a exibe na resposta.
Perguntas e Respostas com Imagens
-
Faça upload da imagem para um local publicamente acessível e obtenha sua URL completa. Recomendamos o uso do OSS. Para instruções, consulte Fazer upload de uma imagem para o OSS e usar sua URL de arquivo.
-
Na aba Table, crie uma nova tabela de dados e adicione um campo do tipo image_url para armazenar a URL completa da imagem.
Observação
- O campo image_url não suporta caminhos relativos.
- Um único campo image_url não pode armazenar múltiplas URLs de imagem. Para associar um registro a várias imagens, crie um campo
image_urlseparado para cada uma, comoimage_1eimage_2. - Cada imagem referenciada por um campo image_url deve ter no máximo 3 MB. Se uma imagem exceder esse limite, a criação da base de conhecimento falhará.
- Não é possível adicionar ou modificar campos do tipo image_url após a criação da tabela de dados. Portanto, inclua todos os campos de imagem necessários durante o design inicial do esquema da tabela.
O campo Type suporta string, double, long, datetime e image_url. Após a configuração, faça upload de arquivos nos formatos xlsx ou xls (com tamanho máximo de 20 MB) na área Import Data.
-
Ao criar uma base de conhecimento, defina o Knowledge Base Type como Image Q&A.
-
Ao criar ou editar uma aplicação de agente, clique no botão + à direita de Image (base de conhecimento de Perguntas e Respostas com Imagens), adicione a base de conhecimento criada e altere o modelo de prompt para:
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
-
Faça uma pergunta na caixa de entrada no lado direito da página.
Por exemplo: "Apresente brevemente o telefone Model Studio X1."
Exemplo de referência correta de imagem Modelo de prompt de exemplo Prompt do usuário e resposta da aplicação do Model Studio Na página de pré-visualização de dados da base de conhecimento do Alibaba Cloud Model Studio, os dados do Model Studio Phone mostram Import Successful. A tabela de dados estruturados contém três colunas: Model (string), Description (string) e Image (image_url). Na linha de dados de exemplo, o modelo é Model Studio X1, o campo de descrição contém tela (6,7 polegadas 1440x3200 pixels 120Hz), armazenamento (256GB+12GB RAM), bateria (5000mAh), câmera (câmera quádr Ultra-sensing) e preço de referência 4.599–4.999 yuan, sendo a coluna de imagem a URL do recurso de imagem correspondente.
# Knowledge Base
Please remember the following materials. They may be helpful for answering questions.
${documents}

# Requirements
If there are images, please display them.
Permissões e segurança
P: O que fazer se eu receber um erro de "Missing permissions for this module" ao gerenciar uma base de conhecimento?
Por padrão, usuários RAM não podem executar operações de escrita, como criar, atualizar ou excluir bases de conhecimento. Uma conta Alibaba Cloud deve conceder as permissões de página necessárias, que devem ser permissões de Administrator ou incluir pelo menos as permissões Application Data-Actions e Knowledge Base-Actions.
P: Uma base de conhecimento é privada? Outras organizações ou usuários podem acessá-la?
Uma base de conhecimento é privada para seu workspace e só pode ser acessada e gerenciada pelos membros desse workspace.
P: A Alibaba Cloud usará as bases de conhecimento da minha conta para responder a perguntas de outros usuários?
A Alibaba Cloud está comprometida com a privacidade de dados e não utilizará os dados da sua base de conhecimento para treinamento de modelos ou para responder a perguntas de outros usuários. Para mais informações, consulte a Declaração de Conformidade e Privacidade.
Migração e exportação
P: Como exportar uma base de conhecimento para minha máquina local?
A exportação com um clique não é suportada atualmente. Como alternativa, chame a API ListChunks e escreva um script para recuperar dados de documentos e trechos em lotes.