O MaxCompute permite usar o Apache Airflow para agendar jobs por meio de interfaces Python. Este tópico descreve como usar operadores Python do Apache Airflow para agendar jobs do MaxCompute.
Informações básicas
O Apache Airflow é uma ferramenta open source desenvolvida pela Airbnb. Escrito em Python, ele orquestra e agenda jobs. O Apache Airflow usa um grafo acíclico dirigido (DAG) para definir um conjunto de jobs com relações de dependência e executá-los conforme essas relações. Também é possível definir subjobs usando interfaces Python. Além disso, o Apache Airflow oferece diversos operadores para atender às necessidades do seu negócio. Para mais informações sobre o Apache Airflow, consulte Apache Airflow.
Pré-requisitos
Antes de usar o Apache Airflow para agendar jobs do MaxCompute, certifique-se de que as seguintes condições foram atendidas:
-
O Apache Airflow está instalado e iniciado.
Para mais detalhes, consulte Quick Start.
Este tópico usa a versão 1.10.7 do Apache Airflow.
Etapa 1: Escreva um script Python para agendamento de jobs e salve o arquivo no diretório inicial do Apache Airflow
Crie um script Python para agendamento de jobs e salve-o como um arquivo .py. O script deve conter a lógica completa de agendamento e o nome do job a ser agendado. Nesta etapa, crie um arquivo de script Python chamado Airflow_MC.py com o seguinte conteúdo:
# -*- coding: UTF-8 -*-
import sys
import os
from odps import ODPS
from odps import options
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime, timedelta
from configparser import ConfigParser
import time
reload(sys)
sys.setdefaultencoding('utf8')
# Change the default encoding format.
# MaxCompute parameter settings
options.sql.settings = {'options.tunnel.limit_instance_tunnel': False, 'odps.sql.allow.fullscan': True}
cfg = ConfigParser()
cfg.read("odps.ini")
print(cfg.items())
# Replace the ALIBABA_CLOUD_ACCESS_KEY_ID environment variable with the AccessKey ID of the user account.
# Replace the ALIBABA_CLOUD_ACCESS_KEY_SECRET environment variable with the AccessKey secret of the user account.
# We recommend that you do not directly use the strings of your AccessKey ID and AccessKey secret.
odps = ODPS(cfg.get("odps",os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID')),cfg.get("odps",os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET')),cfg.get("odps","project"),cfg.get("odps","endpoint"))
default_args = {
    'owner': 'airflow',
    'depends_on_past': False,
    'retry_delay': timedelta(minutes=5),
    'start_date':datetime(2020,1,15)
    # 'email': ['airflow@example.com'],
    # 'email_on_failure': False,
    # 'email_on_retry': False,
    # 'retries': 1,
    # 'queue': 'bash_queue',
    # 'pool': 'backfill',
    # 'priority_weight': 10,
    # 'end_date': datetime(2016, 1, 1),
}
# Scheduling workflow
dag = DAG(
    'Airflow_MC', default_args=default_args, schedule_interval=timedelta(seconds=30))
def read_sql(sqlfile):
    with io.open(sqlfile, encoding='utf-8', mode='r') as f:
        sql=f.read()
    f.closed
    return sql
# Job scheduling
def get_time():
    print 'Current time {}'.format(time.time())
    return time.time()
# Job scheduling
def mc_job ():

    project = odps.get_project()  # Obtain information of the default project.
    instance=odps.run_sql("select * from long_chinese;")
    print(instance.get_logview_address())
    instance.wait_for_success()
    with instance.open_reader() as reader:
        count = reader.count
    print("Number of data records in the table: {}".format(count))
    for record in reader:
        print record
    return count
t1 = PythonOperator (
    task_id = 'get_time' ,
    provide_context = False ,
    python_callable = get_time,
    dag = dag )

t2 = PythonOperator (
    task_id = 'mc_job' ,
    provide_context = False ,
    python_callable = mc_job ,
    dag = dag )
t2.set_upstream(t1)
Etapa 2: Envie o script para agendamento de jobs
-
Na janela da linha de comando, execute o comando abaixo para enviar o script Python criado na Etapa 1.
python Airflow_MC.py -
Ainda na janela da linha de comando, execute os comandos a seguir para gerar um fluxo de trabalho de agendamento e executar um job de teste.
# print the list of active DAGs
airflow list_dags

# prints the list of tasks the "tutorial" dag_id
airflow list_tasks Airflow_MC

# prints the hierarchy of tasks in the tutorial DAG
airflow list_tasks Airflow_MC --tree
# Run a test job.
airflow test Airflow_MC get_time 2010-01-16
airflow test Airflow_MC mc_job 2010-01-16
Etapa 3: Execute um job
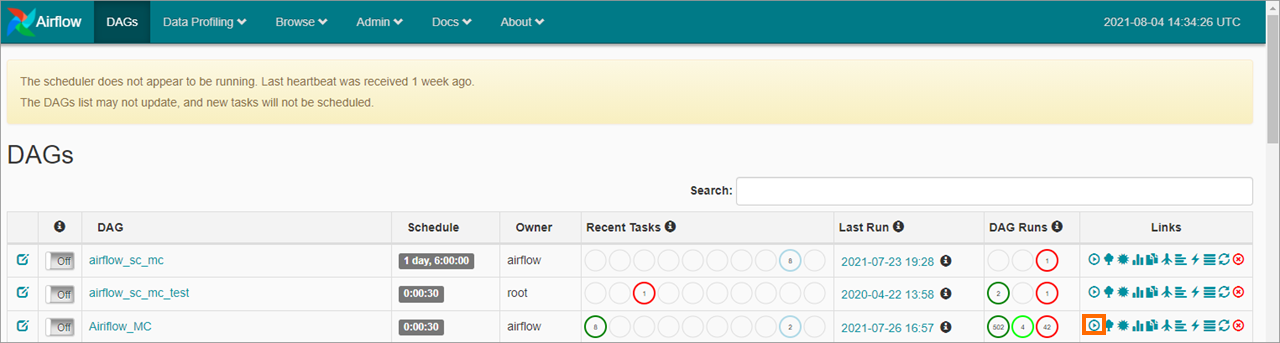
Faça login na interface web do Apache Airflow. Na página DAGs, localize o fluxo de trabalho enviado e clique em no ícone  na coluna Links para executar o job.
Etapa 4: Visualize o resultado da execução do job
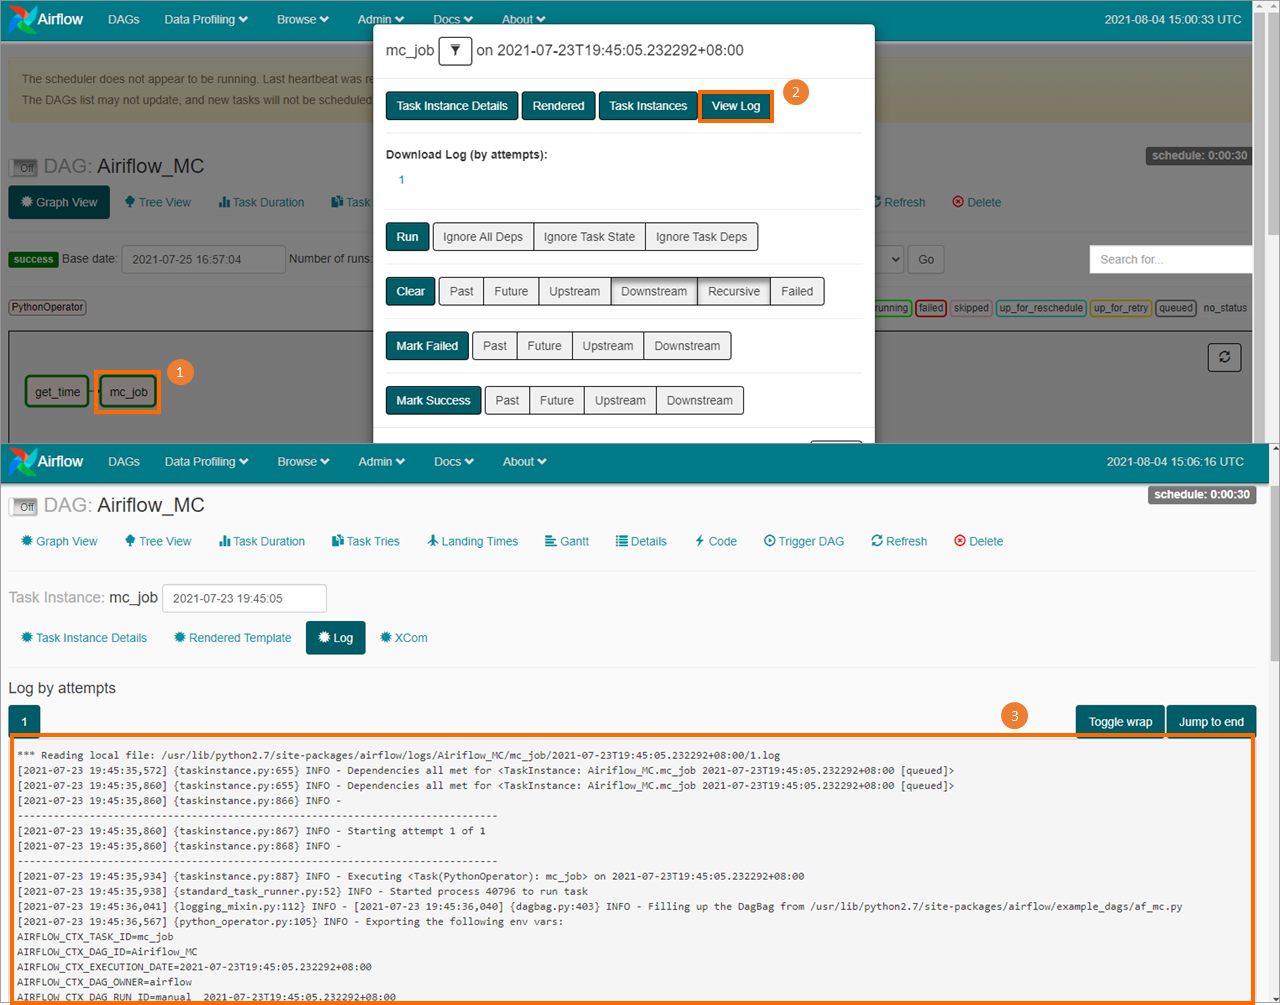
Clique em no nome do job para visualizar o fluxo de trabalho na guia Graph View. Em seguida, selecione um job no fluxo, como mc_job. Na caixa de diálogo exibida, clique em View Log para verificar o resultado da execução.