O Spark on MaxCompute oferece suporte aos modos de execução local, cluster e DataWorks.
Modo local
O Spark on MaxCompute permite depurar jobs no modo local, assim como no Spark nativo.
Esse modo é semelhante ao modo de cluster YARN. Para utilizá-lo, faça as seguintes preparações:
Crie um projeto do MaxCompute e obtenha o AccessKey ID e o AccessKey secret da conta com permissão para acessar esse projeto.
Baixe o cliente do Spark on MaxCompute.
Prepare as variáveis de ambiente.
Configure o arquivo spark-defaults.conf.
Baixe e compile um modelo de projeto de demonstração.
Para mais informações, consulte Configurar um ambiente de desenvolvimento Linux.
Envie um job executando o script spark-submit no cliente do Spark on MaxCompute. O código a seguir apresenta um exemplo:
## Java/Scala
cd $SPARK_HOME
./bin/spark-submit --master local[4] --class com.aliyun.odps.spark.examples.SparkPi \
/path/to/odps-spark-examples/spark-examples/target/spark-examples-2.0.0-SNAPSHOT-shaded.jar
## PySpark
cd $SPARK_HOME
./bin/spark-submit --master local[4] \
/path/to/odps-spark-examples/spark-examples/src/main/python/odps_table_rw.py
Precauções
No modo local, o Tunnel lê e grava dados em tabelas do MaxCompute. Consequentemente, as operações de leitura e gravação nesse modo são mais lentas do que no modo de cluster YARN.
-
Como o Spark on MaxCompute executa na máquina local no modo local, pode ocorrer uma situação específica de acesso via virtual private cloud (VPC). É possível acessar o Spark on MaxCompute em modo local pela VPC, mas falhar ao tentar acessá-lo em modo de cluster YARN pela mesma rede.
Isso acontece porque o modo local não possui isolamento de rede. Já o modo de cluster YARN opera com rede isolada e exige a configuração de parâmetros específicos para permitir o acesso via VPC.
Para acessar o Spark on MaxCompute via VPC no modo local, utilize um endpoint público. No modo de cluster YARN, o acesso via VPC requer um endpoint interno. Para detalhes sobre os endpoints do MaxCompute, consulte Endpoint.
Ao executar o Spark on MaxCompute no IntelliJ IDEA em modo local, especifique as configurações relacionadas diretamente no código. Contudo, remova essas configurações do código caso pretenda executar o Spark on MaxCompute no IntelliJ IDEA em modo de cluster YARN.
Executar o Spark on MaxCompute no IntelliJ IDEA em modo local
O Spark on MaxCompute permite executar código diretamente no IntelliJ IDEA em modo local usando N threads, eliminando a necessidade de enviar o código pelo cliente do Spark on MaxCompute. Observe os pontos abaixo durante a execução:
-
Especifique manualmente as configurações necessárias no arquivo
odps.conflocalizado no diretório main/resource ao executar o código no IntelliJ IDEA em modo local. Não é possível referenciar diretamente as configurações do arquivo spark-defaults.conf. Veja o exemplo de código a seguir:NotaA definição dos itens de configuração no arquivo
odps.confé obrigatória para o Spark 2.4.5 e versões posteriores.dops.access.id="" odps.access.key="" odps.end.point="" odps.project.name="" -
Adicione manualmente as dependências necessárias na pasta
jarsdo cliente Spark on MaxCompute no IntelliJ IDEA. Caso contrário, o seguinte erro será reportado:the value of spark.sql.catalogimplementation should be one of hive in-memory but was odpsSiga as etapas abaixo para configurar as dependências:
Na barra de menu principal do IntelliJ IDEA, escolha .
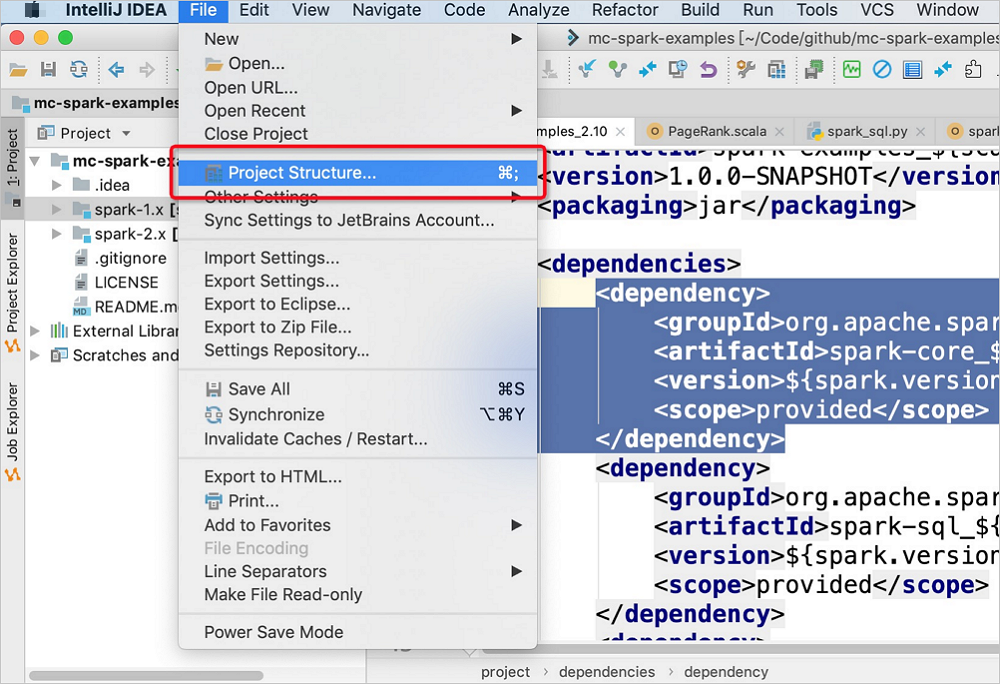
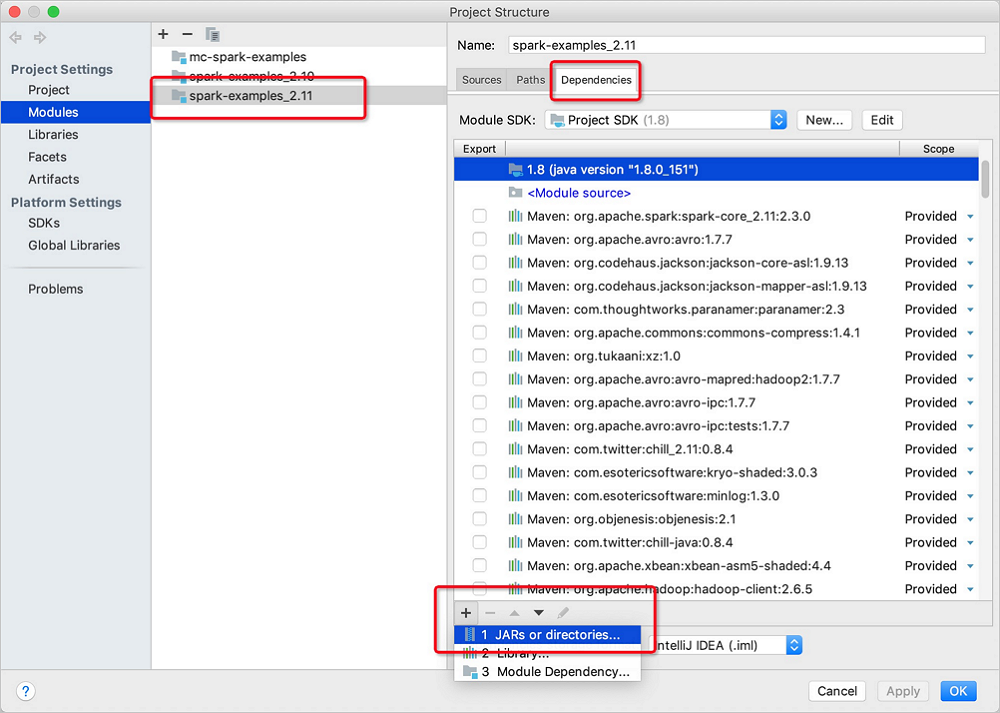
Na página Project Structure, clique em Modules no painel de navegação à esquerda. Na aba exibida, clique em spark-examples_2,11. No painel aberto, selecione a aba Dependencies. Em seguida, clique no ícone
 no canto inferior esquerdo e escolha JARS or directories.
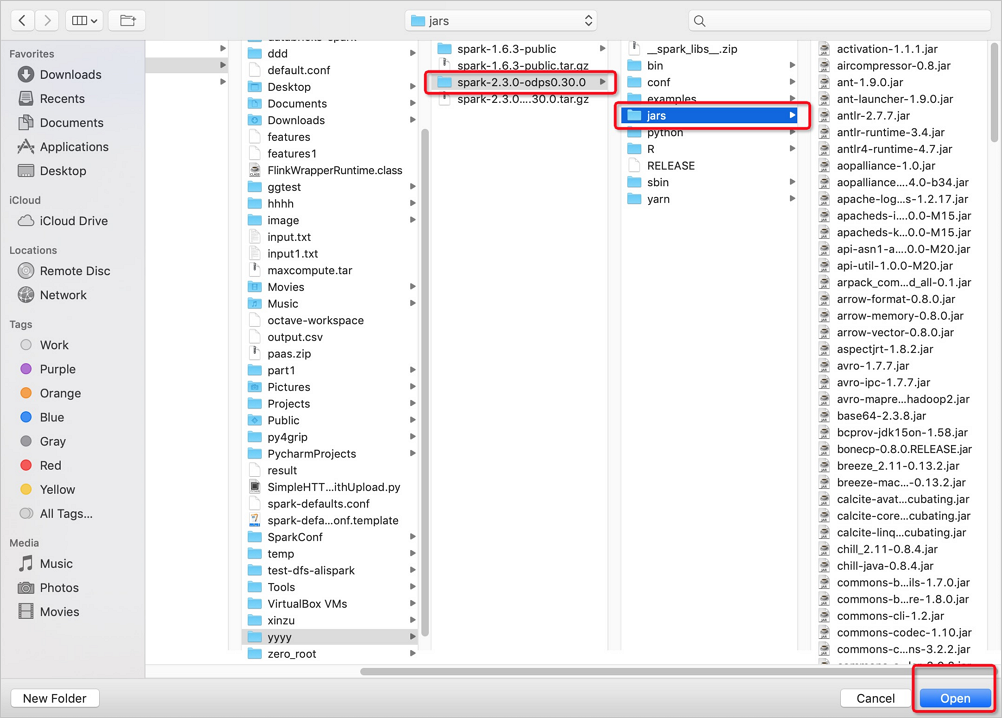
Na pasta jars, navegue até a versão desejada do pacote Spark on MaxCompute > jars > arquivo JAR necessário e clique em Open no canto inferior direito.
Clique em OK.
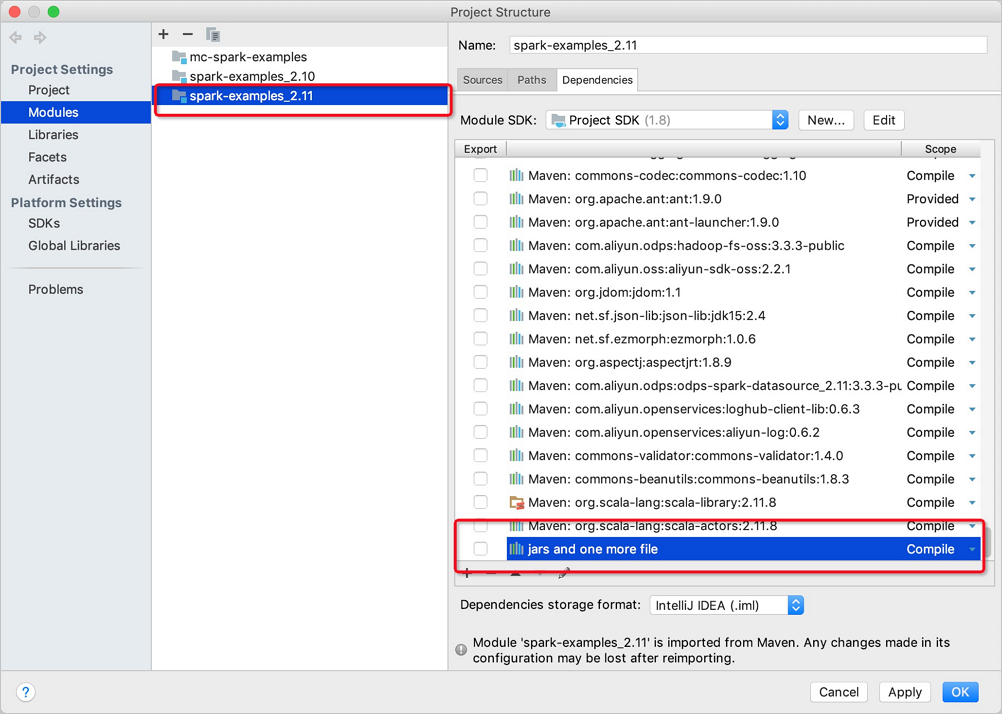
Envie as configurações no IntelliJ IDEA.
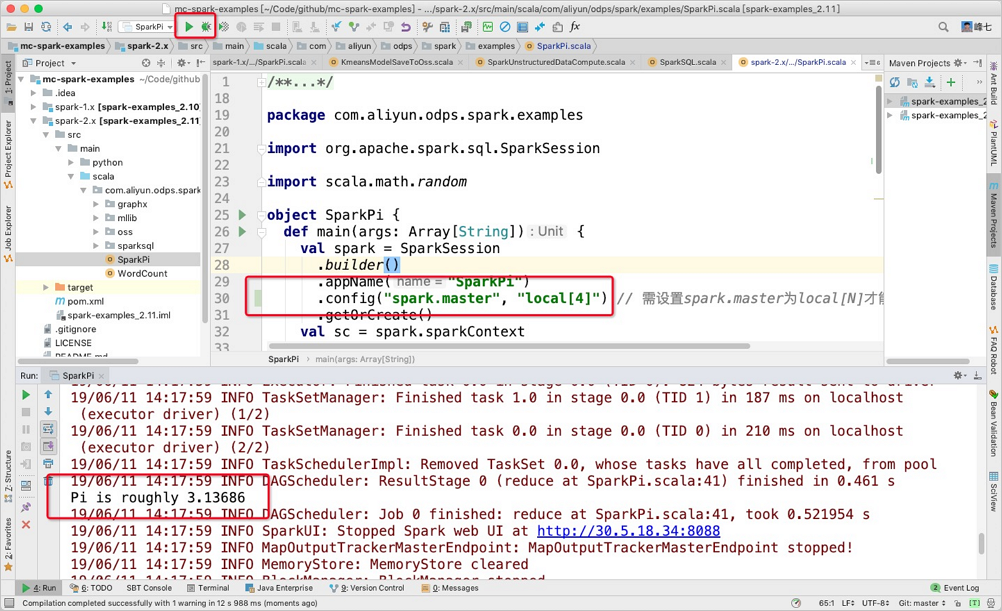
Modo cluster
No modo cluster, defina o método Main como ponto de entrada da aplicação personalizada. O job do Spark termina quando o método Main é concluído com sucesso ou falha. Este modo é ideal para jobs offline e pode ser integrado ao DataWorks para agendamento. O exemplo abaixo demonstra como usar linhas de comando para executar o Spark on MaxCompute neste modo:
# /path/to/MaxCompute-Spark: the path where the compiled application JAR package is saved.
cd $SPARK_HOME
bin/spark-submit --master yarn-cluster --class com.aliyun.odps.spark.examples.SparkPi \
/path/to/MaxCompute-Spark/spark-2.x/target/spark-examples_2.11-1.0.0-SNAPSHOT-shaded.jar
Modo DataWorks
Execute os jobs offline do Spark on MaxCompute em modo cluster no DataWorks para integrar e agendar outros tipos de nós.
Siga estas etapas:
-
Faça upload dos recursos necessários em um workflow do DataWorks e clique em Submit.
No workflow criado, selecione ODPS Spark em Data Analytics.
-
Dê um clique duplo no nó ODPS Spark no workflow e configure os parâmetros do job Spark. Para o nó ODPS Spark, o parâmetro Spark Version oferece três opções, enquanto o parâmetro Language apresenta duas. As demais configurações variam conforme a opção escolhida em Language. Siga as instruções na tela para configurar os parâmetros. Para mais detalhes, consulte Desenvolver uma tarefa Spark do MaxCompute. Onde:
Main JAR Resource: arquivo de recurso utilizado pelo job. Faça o upload deste arquivo no DataWorks antes de prosseguir.
-
Configuration Items: itens de configuração necessários para enviar o job.
Não é necessário configurar
spark.hadoop.odps.access.id,spark.hadoop.odps.access.keyespark.hadoop.odps.end.point. Por padrão, esses valores correspondem aos do projeto MaxCompute. Você também pode especificá-los explicitamente para substituir os valores padrão.Adicione individualmente as configurações do arquivo
spark-defaults.confaos itens de configuração do nó ODPS Spark. Isso inclui o número de executores, tamanho da memória espark.hadoop.odps.runtime.end.point.O arquivo de recurso e os itens de configuração do nó ODPS Spark correspondem aos parâmetros e itens do comando spark-submit, conforme descrito na tabela abaixo. Não há necessidade de fazer upload do arquivo spark-defaults.conf. Em vez disso, adicione as configurações contidas no arquivo spark-defaults.conf uma a uma nos itens de configuração do nó ODPS Spark.
Nó ODPS Spark
spark-submit
Main JAR Resource e Main Python Resource
app jar or python fileConfiguration Items
--conf PROP=VALUEMain Class
--class CLASS_NAMEArguments
[app arguments]JAR Resources
--jars JARSPython Resources
--py-files PY_FILESFile Resources
--files FILESArchive Resources
--archives ARCHIVES
-
Execute o nó ODPS Spark para visualizar os logs operacionais do job e obter as URLs do Logview e do Jobview para análise e diagnóstico adicionais.
Após definir o job Spark, orquestre e agende serviços de diferentes tipos no workflow.