A Python Software Foundation encerrará em breve a manutenção do Python 2. O MaxCompute já oferece suporte ao Python 3, especificamente o CPython-3.7.3. Este tópico descreve como escrever uma função de agregação definida pelo usuário (UDAF) em Python 3.
Estrutura do código UDAF
Use o Guia de introdução ao MaxCompute Studio para escrever o código da função de agregação definida pelo usuário (UDAF) em Python 3. O código deve conter as seguintes informações:
-
Importar módulos: Obrigatório.
Importe pelo menos
from odps.udf import annotateefrom odps.udf import BaseUDAF. A instruçãofrom odps.udf import annotateimporta o módulo de assinatura de função, que permite ao MaxCompute reconhecer a assinatura de função definida no código.from odps.udf import BaseUDAFimporta a classe base para UDAFs em Python. Implemente métodos comoiterate,mergeeterminatena classe derivada.Se o código da UDAF precisar referenciar recursos de arquivo ou tabela, inclua
from odps.distcache import get_cache_filepara recursos de arquivo oufrom odps.distcache import get_cache_tablepara recursos de tabela. -
Assinatura de função: Obrigatório.
O formato é
@annotate(<signature>). Asignaturedefine os tipos de dados dos parâmetros de entrada e do valor de retorno da função. Para mais informações sobre assinaturas de função, consulte Assinatura de função e tipos de dados. -
Classe Python personalizada (classe derivada): Obrigatório.
Essa classe é a unidade organizacional do código da UDAF. Ela define as variáveis e os métodos que implementam a lógica de negócio. Também é possível referenciar bibliotecas de terceiros integradas, arquivos ou recursos de tabela no código. Para mais informações, consulte Bibliotecas de terceiros ou Referenciar recursos.
-
Implementar métodos da classe Python: Obrigatório.
A implementação da classe Python inclui os seguintes métodos. Implemente os métodos conforme necessário.
Definição do método
Descrição
BaseUDAF.new_buffer()Retorna um buffer para o valor intermediário da função de agregação. O
bufferdeve ser um objeto Marshal, como LIST ou DICT. O tamanho dobuffernão deve aumentar com o volume de dados. Em casos extremos, o tamanho dobufferapós a serialização do objeto não deve exceder 2 MB.BaseUDAF.iterate(buffer[, args, ...])Agrega os
argsao valor intermediáriobuffer.BaseUDAF.merge(buffer, pbuffer)Mescla os valores intermediários
bufferepbuffere armazena o resultado embuffer.BaseUDAF.terminate(buffer)Converte o
bufferem um tipo de dados primitivo do MaxCompute SQL.
O código a seguir apresenta um exemplo de UDAF.
# Import the function signature module and the base class.
from odps.udf import annotate
from odps.udf import BaseUDAF
# Function signature.
@annotate('double->double')
# Custom Python class.
class Average(BaseUDAF):
# Implement the methods of the Python class.
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
        return buffer[0] / buffer[1]
A figura a seguir mostra a lógica de implementação e o fluxo de cálculo de uma UDAF do MaxCompute para calcular o valor médio (
avg
).
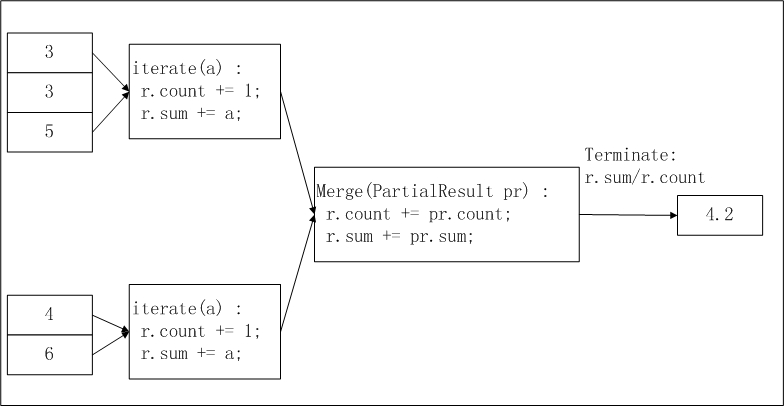
pbuffer
corresponde a
pr
na figura, e
buffer
corresponde a
r
.
A diferença entre UDAFs em Python 2 e UDAFs em Python 3 é a versão subjacente do Python. Escreva a UDAF com base nos recursos da versão correspondente do Python.
Notas de uso
O Python 3 não é compatível com o Python 2, e ambos não podem ser usados na mesma instrução SQL. Avalie a compatibilidade antes de fazer a migração.
O Python 2 atingiu o fim de vida (EOL) no início de 2020. Recomendamos migrar os projetos de acordo com o tipo de cada um.
Migração de UDAFs do Python 2
A Python Software Foundation encerrará em breve a manutenção do Python 2. Recomendamos migrar os projetos de acordo com o tipo:
Novos projetos: Aplica-se a novos projetos do MaxCompute ou projetos do MaxCompute nos quais você está escrevendo uma UDAF em Python pela primeira vez. Recomendamos escrever todas as UDAFs em Python 3.
-
Projetos existentes: Aplica-se a projetos do MaxCompute que possuem muitas UDAFs em Python 2. Ative o Python 3 com cautela. Se planeja migrar gradualmente todas as UDAFs do Python 2 para o Python 3, use os seguintes métodos:
Novos jobs e novas UDAFs: Escreva-os em Python 3 e ative o Python 3 no nível da sessão. Para mais informações sobre como ativar o Python 3, consulte Ativar o Python 3.
-
UDAFs em Python 2: Reescreva as UDAFs do Python 2 para que sejam compatíveis com Python 2 e Python 3. Para mais informações sobre como reescrever o código, consulte Porting Python 2 Code to Python 3.
NotaSe deseja escrever uma UDAF pública e conceder permissões para vários projetos do MaxCompute usá-la, recomendamos tornar a UDAF compatível com Python 2 e Python 3.
Ativar o Python 3
Por padrão, o MaxCompute usa o Python 2. Para usar o Python 3, inclua o seguinte sinalizador de sessão na instrução SQL.
set odps.sql.python.version=cp37;Bibliotecas de terceiros
O ambiente de execução Python 3 integrado no MaxCompute não possui a biblioteca de terceiros NumPy instalada. Para usar uma UDAF que requer o NumPy, faça o upload manual do pacote WHEEL do NumPy. Ao baixar o pacote NumPy do PyPI ou de um espelho, o nome do arquivo do pacote é numpy-<version_number>-cp37-cp37m-manylinux1_x86_64.whl. Para mais informações sobre como fazer upload de um pacote, consulte Operações de recursos ou Exemplo de UDF: Usar um pacote de terceiros em uma UDF Python.
Assinatura de função e tipos de dados
A assinatura de função tem o seguinte formato.
@annotate(<signature>)signature
é uma string que identifica os tipos de dados dos parâmetros de entrada e do valor de retorno. Ao executar uma UDAF, os tipos de dados dos parâmetros de entrada e do valor de retorno devem corresponder aos tipos especificados na assinatura da função. Durante a fase de análise da consulta, o sistema valida a chamada da função em relação à assinatura. Se houver incompatibilidade de tipo, um erro será reportado. O formato específico é o seguinte.
'arg_type_list -> type'onde:
-
arg_type_list: Representa os tipos de dados dos parâmetros de entrada. É possível especificar vários parâmetros de entrada, separados por vírgulas (,). Os tipos de dados suportados são BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, tipos de dados complexos (ARRAY, MAP, STRUCT) e tipos de dados complexos aninhados.arg_type_listtambém aceita um asterisco (*) ou uma string vazia ('').Se
arg_type_listfor um asterisco (*), indica que a função aceita qualquer número de parâmetros de entrada.Se
arg_type_listfor uma string vazia (''), indica que a função não possui parâmetros de entrada.
Para mais informações sobre a sintaxe estendida da anotação Resolve, consulte Parâmetros dinâmicos para UDAFs e UDTFs.
type: Representa o tipo de dado do valor de retorno. Uma UDAF retorna apenas uma coluna. Os tipos de dados suportados incluem BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), tipos de dados complexos (ARRAY, MAP, STRUCT) e tipos de dados complexos aninhados.
Ao escrever o código da UDAF, selecione os tipos de dados apropriados com base na edição de tipos de dados do seu projeto MaxCompute. Para mais informações sobre as edições de tipos de dados e os tipos suportados por cada edição, consulte
.
A seguir estão as assinaturas de função válidas.
|
Exemplo de assinatura de função |
Descrição |
|
|
Os tipos dos parâmetros de entrada são BIGINT e DOUBLE, e o tipo do valor de retorno é STRING. |
|
|
A função aceita qualquer número de parâmetros de entrada, e o tipo do valor de retorno é STRING. |
|
|
A função não possui parâmetros de entrada, e o tipo do valor de retorno é DOUBLE. |
|
|
O tipo do parâmetro de entrada é ARRAY |
Para garantir que os tipos de dados na UDAF Python sejam consistentes com os tipos de dados suportados pelo MaxCompute, use os mapeamentos de tipos de dados corretos. A tabela a seguir descreve esses mapeamentos.
|
Tipo do MaxCompute SQL |
Tipo do Python 3 |
|
BIGINT |
INT |
|
STRING |
UNICODE |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
DATETIME.DATETIME |
|
FLOAT |
FLOAT |
|
CHAR |
UNICODE |
|
VARCHAR |
UNICODE |
|
BINARY |
BYTES |
|
DATE |
DATETIME.DATE |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
Referenciar recursos
As UDAFs em Python podem referenciar recursos de arquivo e tabela por meio do módulo odps.distcache.
-
odps.distcache.get_cache_file(resource_name): Retorna um objeto semelhante a arquivo para o recurso de arquivo especificado.-
resource_nameé do tipo STRING e corresponde ao nome de um recurso de arquivo existente no projeto atual do MaxCompute. Se o nome do recurso de arquivo for inválido ou o recurso não existir, uma exceção será lançada.NotaPara acessar um recurso a partir de uma UDAF, declare o recurso referenciado ao criar a UDAF. Caso contrário, um erro será reportado.
O valor de retorno é um objeto semelhante a arquivo. Após concluir o uso desse objeto, chame o método
closepara liberar o arquivo de recurso aberto.
-
-
odps.distcache.get_cache_table(resource_name): Retorna um objeto gerador para o recurso de tabela especificado.resource_nameé do tipo STRING e corresponde ao nome de um recurso de tabela existente no projeto atual do MaxCompute. Se o nome do recurso de tabela for inválido ou o recurso não existir, uma exceção será lançada.O valor de retorno é do tipo GENERATOR. O chamador percorre o gerador para recuperar o conteúdo da tabela. Cada iteração retorna um registro da tabela como um array.
Para mais informações sobre o uso, consulte Referenciar recursos (UDF Python 3) e Referenciar recursos (UDTF Python 3).
Notas de uso
Após desenvolver uma UDAF em Python 3 seguindo o fluxo de desenvolvimento, chame-a em uma instrução SQL do MaxCompute. Os métodos de chamada são os seguintes:
Usar uma UDF em um projeto do MaxCompute: O método é semelhante ao uso de funções integradas. Use uma função definida pelo usuário da mesma forma que usa uma função integrada.
Usar uma UDF entre projetos: Use uma UDF do Projeto B no Projeto A. A instrução a seguir mostra um exemplo:
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Para mais informações sobre compartilhamento entre projetos, consulte Acesso a recursos entre projetos com base em pacotes.
Para o procedimento completo de desenvolvimento e chamada de uma UDAF em Python 3 usando o MaxCompute Studio, consulte Desenvolver uma UDF Python.
Parâmetros dinâmicos para UDAFs
Assinatura de função
Para mais informações sobre o formato da assinatura de função de uma UDAF Python, consulte Assinatura de função e tipos de dados.
-
Use um asterisco (
*) na lista de parâmetros para aceitar parâmetros de entrada de qualquer quantidade e qualquer tipo. Por exemplo,@annotate('double,*->string')indica que o primeiro parâmetro é do tipo DOUBLE, seguido por uma lista de parâmetros de qualquer quantidade e qualquer tipo. Nesse caso, escreva o código para determinar o número e os tipos dos parâmetros de entrada e, em seguida, execute as operações correspondentes sobre eles. Isso é semelhante à funçãoprintfna linguagem C.NotaUm asterisco (
*) tem um significado diferente quando usado na lista de valores de retorno. -
Use um asterisco (
*) no valor de retorno de uma UDTF para indicar qualquer quantidade de valores de retorno do tipo STRING. O número de valores de retorno depende do número de aliases definidos na chamada da função. Por exemplo, para@annotate("bigint,string->double,*"), o método de chamada éUDTF(x, y) as (a, b, c). Neste exemplo, três aliases são definidos apósas:a,bec. O editor consideraacomo sendo do tipo DOUBLE, porque o tipo da primeira coluna no valor de retorno é especificado na anotação, e considerabeccomo sendo do tipo STRING. Como três valores de retorno são especificados, quando a UDTF chamaforward,forwarddeve ser um array de comprimento 3. Caso contrário, ocorre um erro em tempo de execução.NotaEsse tipo de erro não pode ser reportado em tempo de compilação. Portanto, quando o chamador da UDTF define o número de aliases na instrução SQL, ele deve seguir as regras definidas pela UDTF. Como o número de valores de retorno para uma função de agregação é fixo em 1, esse recurso não se aplica a uma UDAF.
Exemplo de UDAF
from odps.udf import annotate
from odps.udf import BaseUDAF
@annotate('bigint,*->string')
class MultiColSum(BaseUDAF):
    def new_buffer(self):
        return [0]
    def iterate(self, buffer, *args):
        for arg in args:
            buffer[0] += int(arg)
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
    def terminate(self, buffer):
        return str(buffer[0])
Uma UDAF pode ter apenas um valor de retorno. No exemplo anterior de UDAF, o valor de retorno é a soma de vários parâmetros de entrada, que é agregada e somada em várias linhas. O código a seguir apresenta um exemplo de uso.
-- Sums multiple input parameters.
SELECT my_multi_col_sum(a,b,c,d,e) from values (1,"2","3","4","5"), (6,"7","8","9","10") t(a,b,c,d,e);
-- The return value is 55.