O MaxCompute usa o Python 2.7. Este tópico descreve como escrever uma função de agregação definida pelo usuário (UDAF) em Python 2.
Estrutura do código da UDAF
Use o
para desenvolver uma UDAF em Python 2. O código deve incluir os seguintes componentes:
-
Declaração de codificação: opcional.
O formato da declaração é
#coding:utf-8ou# -*- coding: utf-8 -*-. Ambos os formatos são equivalentes. Se o código Python 2 contiver caracteres chineses, ocorrerá um erro durante a execução. Adicione uma declaração de codificação no início do código para evitar esse problema. -
Importação de módulos: obrigatória.
Importe pelo menos
from odps.udf import annotateefrom odps.udf import BaseUDAF. A instruçãofrom odps.udf import annotateimporta o módulo de assinatura da função e permite que o MaxCompute reconheça a assinatura definida no código. A instruçãofrom odps.udf import BaseUDAFimporta a classe base para UDAFs em Python. Implemente métodos comoiterate,mergeeterminatena classe derivada.Se o código da UDAF precisar referenciar recursos de arquivo ou tabela, inclua
from odps.distcache import get_cache_filepara recursos de arquivo oufrom odps.distcache import get_cache_tablepara recursos de tabela. -
Assinatura da função: obrigatória.
O formato é
@annotate(<signature>). O parâmetrosignaturedefine os tipos de dados dos parâmetros de entrada e do valor de retorno. Para obter mais informações sobre assinaturas de função, consulte Function signature and data types. -
Classe Python personalizada (classe derivada): obrigatória.
Esta é a estrutura principal do código da UDAF. Ela define as variáveis e os métodos que implementam a lógica de negócios. Também é possível referenciar bibliotecas de terceiros integradas ou recursos, como arquivos e tabelas, diretamente no código. Para obter mais detalhes, consulte Third-party libraries ou Referencing resources.
-
Implementação dos métodos da classe Python: obrigatória.
A implementação da classe Python inclui os métodos listados abaixo. Implemente-os conforme a necessidade.
Definição do método
Descrição
BaseUDAF.new_buffer()Retorna um buffer para o valor intermediário da função de agregação. O
bufferdeve ser um objeto Marshal, como LIST ou DICT. O tamanho dobuffernão deve aumentar proporcionalmente ao volume de dados. Em casos extremos, o tamanho dobufferapós a serialização do objeto não pode exceder 2 MB.BaseUDAF.iterate(buffer[, args, ...])Agrega os argumentos
argsao valor intermediário armazenado embuffer.BaseUDAF.merge(buffer, pbuffer)Combina os valores intermediários
bufferepbuffere armazena o resultado embuffer.BaseUDAF.terminate(buffer)Converte o conteúdo do
bufferem um tipo de dados primitivo do MaxCompute SQL.
O exemplo a seguir ilustra o código de uma UDAF.
#coding:utf-8
# Import the function signature module and the base class.
from odps.udf import annotate
from odps.udf import BaseUDAF
# Function signature.
@annotate('double->double')
# Custom Python class.
class Average(BaseUDAF):
# Implement the methods of the Python class.
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
        return buffer[0] / buffer[1]
A figura a seguir apresenta a lógica de implementação e o fluxo de cálculo de uma UDAF do MaxCompute usada para calcular a média (
avg
).
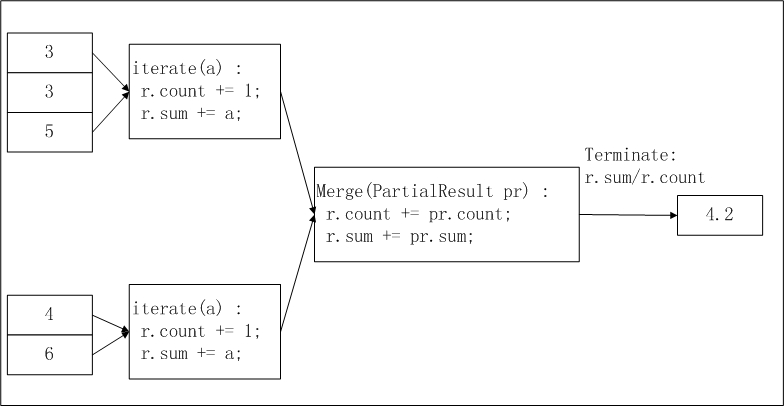
O termo
pbuffer
corresponde a
pr
na figura, enquanto
buffer
corresponde a
r
.
Limitações
As UDAFs em Python 2 do MaxCompute usam o Python 2.7 e executam o código do usuário em um ambiente sandbox restrito. As seguintes ações são proibidas:
Ler e gravar dados em arquivos locais.
Iniciar subprocessos.
Iniciar threads.
Estabelecer comunicação via socket.
Chamar UDFs Python 2 por outros sistemas.
Devido a essas limitações, o código enviado deve usar exclusivamente bibliotecas padrão do Python. Módulos ou extensões em C que realizem as operações proibidas acima não podem ser usados. Observe os pontos seguintes sobre os módulos das bibliotecas padrão:
Todos os módulos implementados com base nas bibliotecas padrão do Python, sem dependência de módulos de extensão, estão disponíveis.
-
Os seguintes módulos de extensão em C estão disponíveis:
array e audioop
binascii e bisect
cmath, _codecs_cn, _codecs_hk, _codecs_iso2022, _codecs_jp, _codecs_kr, _codecs_tw, _collections e cStringIO
datetime
_functools e future_builtins
_heapq e _hashlib
itertools
_json
_locale e _lsprof
math, _md5 e _multibytecodec
operator
_random
_sha256, _sha512, _sha, _struct e strop
time
unicodedata
_weakref
cPickle
Ao executar o código da UDF no ambiente sandbox, o tamanho máximo dos dados gravados na saída padrão (sys.stdout) ou na saída de erro padrão (
sys.stderr) é de 20 KB. Qualquer conteúdo que exceda esse limite será ignorado.
Bibliotecas de terceiros
Bibliotecas de terceiros, como NumPy, já vêm instaladas no ambiente Python 2 do MaxCompute para complementar as bibliotecas padrão.
O uso de bibliotecas de terceiros está sujeito a certas limitações. Por exemplo, ao usar essas bibliotecas, não é permitido acessar dados locais, e os recursos de I/O de rede são restritos. As APIs relacionadas nessas bibliotecas ficam desativadas.
Assinatura da função e tipos de dados
A assinatura da função segue o formato abaixo.
@annotate(<signature>)O parâmetro
signature
é uma string que identifica os tipos de dados dos parâmetros de entrada e do valor de retorno. Ao executar uma UDAF, os tipos de dados de entrada e saída devem corresponder exatamente aos especificados na assinatura. Durante a fase de análise da consulta, o sistema valida a chamada da função contra essa assinatura e reporta um erro caso haja incompatibilidade de tipos. O formato específico é:
'arg_type_list -> type'onde:
-
arg_type_list: representa os tipos de dados dos parâmetros de entrada. É possível especificar múltiplos parâmetros separados por vírgula (,). Os tipos suportados incluem BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, tipos complexos (ARRAY, MAP, STRUCT) e tipos complexos aninhados.O campo
arg_type_listtambém aceita um asterisco (*) ou uma string vazia ('').Quando
arg_type_listfor um asterisco (*), indica que a função aceita qualquer quantidade de parâmetros de entrada.Quando
arg_type_listfor uma string vazia (''), indica que a função não possui parâmetros de entrada.
Para obter mais detalhes sobre a sintaxe estendida da anotação Resolve, consulte Dynamic parameters for UDAFs and UDTFs.
type: define o tipo de dado do valor de retorno. Uma UDAF retorna apenas uma coluna. Os tipos suportados são BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), tipos complexos (ARRAY, MAP, STRUCT) e tipos complexos aninhados.
Ao escrever o código da UDAF, escolha os tipos de dados adequados à edição de tipos de dados do seu projeto MaxCompute. Para saber mais sobre as edições e os tipos suportados em cada uma, consulte
.
Veja a seguir exemplos válidos de assinaturas de função.
|
Exemplo de assinatura |
Descrição |
|
|
Os parâmetros de entrada são BIGINT e DOUBLE; o retorno é STRING. |
|
|
Aceita número variável de parâmetros de entrada; o retorno é STRING. |
|
|
Não há parâmetros de entrada; o retorno é DOUBLE. |
|
|
Entrada do tipo ARRAY |
Para garantir a consistência entre os tipos de dados da sua UDAF Python e os tipos suportados pelo MaxCompute, use os mapeamentos corretos descritos na tabela a seguir.
|
Tipo de dado MaxCompute SQL |
Tipo de dado Python 2 |
|
BIGINT |
INT |
|
STRING |
STR |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
INT |
|
FLOAT |
FLOAT |
|
CHAR |
STR |
|
VARCHAR |
STR |
|
BINARY |
BYTEARRAY |
|
DATE |
INT |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
O tipo DATETIME do MaxCompute SQL é mapeado para INT em Python. O valor INT segue o padrão UNIX, representando o número de milissegundos decorridos desde 00:00:00 de quinta-feira, 1º de janeiro de 1970. Use o módulo DATETIME das bibliotecas padrão do Python para processar esses dados.
O parâmetro
silentfoi adicionado à funçãoodps.udf.int(value). Se o parâmetrosilentestiver definido como True e o tipo de dado devaluenão puder ser convertido para INT, a função retornará None sem gerar erro.Valores NULL no MaxCompute SQL correspondem a None em Python 2.
Referência a recursos
UDAFs em Python podem referenciar recursos de arquivo e tabela por meio do módulo odps.distcache.
-
odps.distcache.get_cache_file(resource_name): retorna um objeto semelhante a arquivo para o recurso de arquivo especificado.-
O parâmetro
resource_nameé do tipo STRING e corresponde ao nome de um recurso de arquivo existente no projeto MaxCompute atual. Se o nome for inválido ou o recurso não existir, uma exceção será lançada.NotaPara acessar um recurso a partir de uma UDAF, declare-o explicitamente durante a criação da função. Caso contrário, ocorrerá um erro.
O valor retornado é um objeto semelhante a arquivo. Após concluir o uso, chame o método
closepara liberar o arquivo de recurso aberto.
-
-
odps.distcache.get_cache_table(resource_name): retorna um objeto gerador para o recurso de tabela especificado.O parâmetro
resource_nameé do tipo STRING e corresponde ao nome de um recurso de tabela existente no projeto MaxCompute atual. Nomes inválidos ou recursos inexistentes resultam em exceção.O retorno é do tipo GENERATOR. O chamador percorre o gerador para obter o conteúdo da tabela e recebe um registro por iteração na forma de array.
Para obter mais informações sobre o uso de recursos, consulte Reference resources (Python 2 UDFs) e Reference resources (Python 2 UDTFs).
Observações de uso
Após desenvolver uma UDAF em Python 2 seguindo as orientações de
, chame-a diretamente no MaxCompute SQL. Existem duas formas principais de invocação:
Uso dentro do mesmo projeto MaxCompute: o procedimento é semelhante ao descrito em built-in functions. Use a função definida pelo usuário da mesma forma que uma função nativa.
Uso entre projetos diferentes: permite chamar uma UDF do Projeto B estando no Projeto A. Exemplo de comando:
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Para obter detalhes sobre compartilhamento entre projetos, consulte Cross-project resource access based on packages.
Para obter instruções completas sobre desenvolvimento e chamada de UDAFs Python 2 no MaxCompute Studio, consulte Develop a Python UDF.