Se seus dados no MaxCompute ultrapassarem 200 GB e você precisar de tempos de resposta de consulta em segundos, importe os dados para tabelas internas do Hologres. Diferentemente da consulta por meio de tabelas externas, as tabelas internas suportam índices, o que proporciona um desempenho de consulta significativamente mais rápido. Este tópico descreve como importar dados do MaxCompute usando SQL em diferentes cenários e como solucionar erros de falta de memória (OOM).
Pré-requisitos
Antes de começar, verifique se você tem:
Uma tabela do MaxCompute com dados para importar
Uma instância ativa do Hologres conectada ao seu projeto do MaxCompute
(Opcional) Familiaridade com Data type mapping between MaxCompute and Hologres
Observações de uso
Não há mapeamento direto entre partições do MaxCompute e do Hologres. Um campo de partição do MaxCompute corresponde a um campo comum no Hologres. Você pode importar de uma tabela particionada do MaxCompute tanto para uma tabela não particionada quanto para uma tabela particionada do Hologres.
O Hologres suporta apenas particionamento de nível único. Ao importar de uma tabela do MaxCompute com múltiplos níveis de partição, mapeie apenas um campo de partição. Os demais campos de partição tornam-se campos comuns no Hologres.
Para atualizar ou sobrescrever dados existentes durante a importação, use a sintaxe INSERT ON CONFLICT (UPSERT).
Após a atualização dos dados em uma tabela do MaxCompute, o Hologres apresenta uma latência de cache de até 10 minutos. Antes de importar, execute o comando IMPORT FOREIGN SCHEMA para atualizar os metadados da tabela externa e obter os dados mais recentes.
Ao importar dados do MaxCompute para o Hologres, prefira usar SQL em vez de integração de dados. A importação via SQL oferece melhor desempenho.
Importar dados de uma tabela não particionada do MaxCompute
Etapa 1: Preparar os dados de source
Use uma tabela existente do MaxCompute ou crie uma nova. Este exemplo usa a tabela customer do conjunto de dados público public_data no MaxCompute. Para informações sobre como acessar conjuntos de dados públicos, consulte Use public datasets.
Abaixo estão a DDL da tabela customer e uma consulta de exemplo:
-- DDL of the table in the MaxCompute public dataset
CREATE TABLE IF NOT EXISTS public_data.customer(
  c_customer_sk BIGINT,
  c_customer_id STRING,
  c_current_cdemo_sk BIGINT,
  c_current_hdemo_sk BIGINT,
  c_current_addr_sk BIGINT,
  c_first_shipto_date_sk BIGINT,
  c_first_sales_date_sk BIGINT,
  c_salutation STRING,
  c_first_name STRING,
  c_last_name STRING,
  c_preferred_cust_flag STRING,
  c_birth_day BIGINT,
  c_birth_month BIGINT,
  c_birth_year BIGINT,
  c_birth_country STRING,
  c_login STRING,
  c_email_address STRING,
  c_last_review_date STRING,
  useless STRING);

-- Query the table to verify data
SELECT * FROM public_data.customer;
A figura a seguir mostra uma amostra dos dados.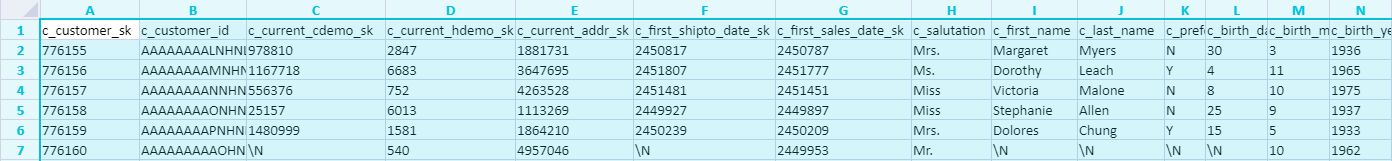
Etapa 2: Criar uma tabela externa no Hologres
Crie uma tabela externa para mapear a tabela de source do MaxCompute:
CREATE FOREIGN TABLE foreign_customer (
    "c_customer_sk" int8,
    "c_customer_id" text,
    "c_current_cdemo_sk" int8,
    "c_current_hdemo_sk" int8,
    "c_current_addr_sk" int8,
    "c_first_shipto_date_sk" int8,
    "c_first_sales_date_sk" int8,
    "c_salutation" text,
    "c_first_name" text,
    "c_last_name" text,
    "c_preferred_cust_flag" text,
    "c_birth_day" int8,
    "c_birth_month" int8,
    "c_birth_year" int8,
    "c_birth_country" text,
    "c_login" text,
    "c_email_address" text,
    "c_last_review_date" text,
    "useless" text
)
SERVER odps_server
OPTIONS (project_name 'public_data', table_name 'customer');|
Parâmetro |
Descrição |
|
|
Servidor da tabela externa. Use o servidor integrado |
|
|
Nome do projeto do MaxCompute onde a tabela de source está localizada. |
|
|
Nome da tabela do MaxCompute a ser importada. |
Os tipos de dados dos campos na tabela externa devem corresponder aos tipos de dados da tabela do MaxCompute. Para referência de mapeamento, consulte Data type mapping between MaxCompute and Hologres.
Etapa 3: Criar uma tabela interna no Hologres
Crie uma tabela interna para receber os dados importados. Defina índices adequados para otimizar o desempenho das consultas. Para detalhes sobre propriedades de tabela, consulte CREATE TABLE.
-- Create a column-oriented internal table
BEGIN;
CREATE TABLE public.holo_customer (
 "c_customer_sk" int8,
 "c_customer_id" text,
 "c_current_cdemo_sk" int8,
 "c_current_hdemo_sk" int8,
 "c_current_addr_sk" int8,
 "c_first_shipto_date_sk" int8,
 "c_first_sales_date_sk" int8,
 "c_salutation" text,
 "c_first_name" text,
 "c_last_name" text,
 "c_preferred_cust_flag" text,
 "c_birth_day" int8,
 "c_birth_month" int8,
 "c_birth_year" int8,
 "c_birth_country" text,
 "c_login" text,
 "c_email_address" text,
 "c_last_review_date" text,
 "useless" text
);
CALL SET_TABLE_PROPERTY('public.holo_customer', 'orientation', 'column');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'bitmap_columns', 'c_customer_id,c_salutation,c_first_name,c_last_name,c_preferred_cust_flag,c_birth_country,c_login,c_email_address,c_last_review_date,useless');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'dictionary_encoding_columns', 'c_customer_id:auto,c_salutation:auto,c_first_name:auto,c_last_name:auto,c_preferred_cust_flag:auto,c_birth_country:auto,c_login:auto,c_email_address:auto,c_last_review_date:auto,useless:auto');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'time_to_live_in_seconds', '3153600000');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'storage_format', 'segment');
COMMIT;
Etapa 4: Executar a instrução INSERT
Use INSERT INTO ... SELECT para copiar dados da tabela externa para a tabela interna. É possível importar todos os campos ou apenas um subconjunto.
A partir do Hologres V2.1.17, você pode utilizar o Serverless Computing para importações offline em grande escala, grandes tarefas de extração, transformação e carga (ETL) e consultas de alto volume em tabelas externas. O Serverless Computing utiliza recursos serverless dedicados em vez dos recursos da sua instância, o que melhora a estabilidade e reduz erros de OOM. Você paga apenas pelas tarefas executadas. Para mais detalhes, consulte Serverless Computing e o Serverless Computing user guide .
-- (Optional) Use Serverless Computing for large-scale import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Import a subset of fields
INSERT INTO holo_customer (c_customer_sk, c_customer_id, c_email_address, c_last_review_date, useless)
SELECT
    c_customer_sk,
    c_customer_id,
    c_email_address,
    c_last_review_date,
    useless
FROM foreign_customer;

-- Import all fields
INSERT INTO holo_customer
SELECT * FROM foreign_customer;

-- Reset the resource setting so subsequent SQL statements do not use serverless resources.
RESET hg_computing_resource;
Etapa 5: Consultar os dados importados
Após a conclusão da importação, consulte a tabela interna para verificar os dados:
SELECT * FROM holo_customer;Importar dados de uma tabela particionada do MaxCompute
Para instruções passo a passo, consulte Import data from a partitioned MaxCompute table.
Melhores práticas para INSERT OVERWRITE
Para padrões e recomendações sobre INSERT OVERWRITE, consulte INSERT OVERWRITE.
Sincronizar dados com ferramenta de visualização ou tarefas agendadas
Para importações únicas de grande volume ou sincronização recorrente de dados, use o HoloWeb ou o DataWorks em vez de escrever SQL manualmente.
Usar o HoloWeb para sincronização com um clique
O HoloWeb oferece uma interface guiada que gera e executa o SQL de importação automaticamente.
Abra a página do HoloWeb. Para instruções de acesso, consulte Connect to HoloWeb and execute a query.
Na barra de menu superior, escolha Metadata Management > MaxCompute Query Acceleration e clique em Import MaxCompute Data.
-
Configure os parâmetros na página Create MaxCompute Data Import Task.
O campo SQL Script exibe a instrução SQL gerada automaticamente a partir da sua configuração. Não é possível editar a instrução diretamente no SQL Script . Para personalizá-la, copie a instrução, modifique-a manualmente e execute-a como SQL.
Categoria
Parâmetro
Descrição
Selecionar instância
Instance name
Nome da instância do Hologres onde o login foi realizado.
Tabela de source do MaxCompute
Project name
Nome do projeto do MaxCompute.
Schema name
Nome do esquema do MaxCompute. Oculto para projetos de modelo de duas camadas. Em projetos de modelo de três camadas, selecione entre os esquemas autorizados.
Table name
Tabela do MaxCompute a ser importada. Suporta busca aproximada baseada em prefixo.
Tabela de destino no Hologres
Database name
Banco de dados do Hologres onde a tabela interna será criada.
Schema name
Esquema do Hologres. O padrão é public.
Table name
Nome da nova tabela interna. Por padrão, assume o nome da tabela do MaxCompute, mas pode ser renomeado.
Target table description
Descrição opcional para a nova tabela interna.
Configurações de parâmetros
GUC parameters
Parâmetros GUC (Grand Unified Configuration) a serem aplicados. Para detalhes, consulte GUC parameters.
Configurações de importação
Fields
Campos a serem importados. Selecione todos ou um subconjunto.
Configuração de partição
Partition field
Selecione um campo de partição. O Hologres suporta apenas partições de primeiro nível. Para partições multinível do MaxCompute, configure um campo de partição; os demais serão mapeados como campos comuns.
Data timestamp
Para tabelas do MaxCompute particionadas por data, selecione a data da partição a ser importada.
Configuração de índice
Storage mode
Column-oriented storage (padrão): otimizado para consultas complexas. Row-oriented storage: otimizado para consultas pontuais por chave primária e varreduras. Row-column storage: suporta todos os cenários de armazenamento em linha e coluna, incluindo consultas pontuais sem chave primária.
Table data lifecycle
Período de retenção de dados. O padrão é Permanent. Dados não modificados dentro do período especificado são excluídos automaticamente após o vencimento.
Binlog
Indica se o Binlog deve ser ativado. Para detalhes, consulte Subscribe to Hologres Binlog.
Binlog lifecycle
TTL (tempo de vida) do Binlog. O padrão é 30 dias (2.592.000 segundos).
Distribution columns
Colunas usadas pelo Hologres para distribuir dados entre shards. Linhas com os mesmos valores são colocadas no mesmo shard. Usar colunas de distribuição como condições de filtro melhora a eficiência da consulta.
Segment columns
Colunas usadas como chaves de segmento. Consultas que incluem colunas de segmento localizam rapidamente as posições de armazenamento dos dados.
Clustering columns
Colunas usadas como chaves de clustering. Índices de clustering aceleram consultas de intervalo e filtro nessas colunas.
Dictionary encoding columns
Colunas para as quais o Hologres cria mapeamentos de dicionário. A codificação por dicionário converte comparações de strings em comparações numéricas, acelerando consultas GROUP BY e filtros. Todas as colunas text são definidas como colunas de codificação por dicionário por padrão.
Bitmap columns
Colunas para as quais o Hologres cria índices bitmap. Colunas bitmap filtram dados rapidamente com base em condições especificadas. Todas as colunas text são definidas como colunas bitmap por padrão.
Clique em Submit. Após a conclusão da importação, consulte a tabela interna para verificar os dados.
Usar o DataWorks para agendamento periódico
A sincronização com um clique do HoloWeb não suporta agendamentos recorrentes. Para importações históricas de grande volume ou sincronização periódica, use o DataStudio no DataWorks. Para detalhes, consulte Best practices for periodically importing MaxCompute data using DataWorks.
Solucionar erros de OOM
Sintoma: Ocorre um erro de OOM durante a importação com a mensagem: Query executor exceeded total memory limitation xxxxx: yyyy bytes used.
Siga as etapas abaixo em ordem até que o erro seja resolvido.
Etapa 1: Atualizar estatísticas da tabela
Estatísticas desatualizadas ou ausentes fazem com que o otimizador de consultas escolha uma ordem de junção subótima, levando ao uso excessivo de memória. Isso é especialmente comum quando a consulta de importação contém subconsultas.
Execute o comando ANALYZE em todas as tabelas internas e externas envolvidas na importação:
ANALYZE foreign_customer;
ANALYZE holo_customer;
Isso atualiza os metadados estatísticos e ajuda o otimizador de consultas a gerar um plano de execução melhor.
Etapa 2: Reduzir o tamanho do lote de leitura
Tabelas largas com muitas colunas resultam em grandes volumes de dados por lote de leitura, o que pode exceder os limites de memória.
Defina hg_experimental_query_batch_size com um valor menor antes da instrução INSERT (o padrão é 8192):
SET hg_experimental_query_batch_size = 1024;
INSERT INTO holo_table SELECT * FROM mc_table;
Etapa 3: Reduzir a concorrência de importação (Hologres anterior à V1.1)
Alta concorrência de importação consome mais CPU e memória, o que pode afetar outras consultas em tabelas internas.
Defina hg_experimental_foreign_table_executor_max_dop com um valor menor (o padrão é o número de núcleos da instância). Este parâmetro é válido para todas as tarefas executadas em tabelas externas.
SET hg_experimental_foreign_table_executor_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;
Etapa 4: Reduzir a concorrência de DML (Hologres V1.1 e posterior)
No Hologres V1.1 e versões posteriores, use hg_foreign_table_executor_dml_max_dop para controlar a concorrência de instruções DML, incluindo importações (o padrão é 32). Definir este parâmetro com um valor menor reduz a concorrência para instruções DML, especialmente em cenários de importação e exportação de dados, evitando que instruções DML consumam recursos excessivos.
SET hg_foreign_table_executor_dml_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;