O Flink Advisor diagnostica seus deployments do Realtime Compute for Apache Flink ao analisar logs, eventos, métricas e configurações em tempo real. Ele monitora a integridade do deployment durante todo o ciclo de vida, detecta exceções e riscos e fornece sugestões práticas de otimização para reduzir o tempo de solução de problemas e o tempo médio de reparo (MTTR).
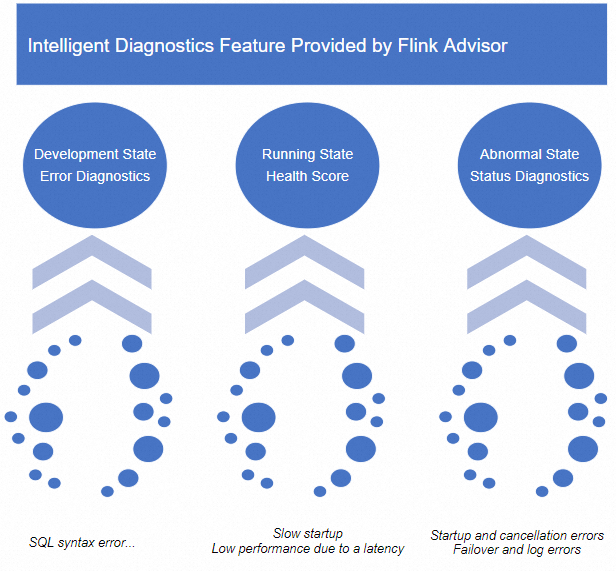
Limitações
Somente deployments de streaming oferecem suporte ao diagnóstico inteligente. Não há suporte para deployments em lote.
Como funciona
O Flink Advisor avalia continuamente a integridade do seu deployment. A pontuação de integridade começa em 100 e diminui conforme a quantidade e a gravidade dos riscos detectados nos últimos 30 minutos.
Essa pontuação aparece como um selo colorido na lista de deployments:
|
Cor |
Faixa de pontuação |
Significado |
|
Verde |
Acima de 80 |
Sem riscos potenciais. O sistema pode fornecer sugestões de configuração. |
|
Amarelo |
60–80 |
Problemas ou riscos potenciais detectados. Revise o deployment. |
|
Vermelho |
Abaixo de 60 |
Problemas graves detectados. Aja imediatamente para evitar o cancelamento do deployment. |
Diagnosticar logs de exceção de um rascunho
Use este fluxo de trabalho para diagnosticar erros de SQL antes de publicar um deployment.
Faça login no console do Realtime Compute for Apache Flink. Localize o workspace que deseja gerenciar e clique em Console na coluna Actions.
No painel de navegação à esquerda, escolha Development > ETL. Crie um rascunho, escreva suas instruções SQL e clique em Validate.
-
Na parte inferior da página do SQL Editor, revise os detalhes do erro, as possíveis causas e as sugestões de otimização.
Por exemplo, a seção Deep Check exibe um ícone de erro vermelho com um status de verificação (como "SQL syntax and network connectivity check failed") e mensagens de erro detalhadas. A seção Analysis Result lista possíveis causas (como "The table or view referenced in the SQL statement does not exist") e soluções sugeridas (como "Verifique se o nome da tabela ou visualização foi criado"). Uma seção recolhível de SQL Optimization aparece na parte inferior da página.
Caso não consiga identificar a causa pelos resultados da verificação de sintaxe, selecione os logs relacionados e clique em Search in Documentation para encontrar informações relevantes.
Diagnosticar logs de exceção de um deployment
Siga este fluxo para investigar exceções no nível de log em um deployment em execução ou com falha.
Faça login no console do Realtime Compute for Apache Flink. Encontre o workspace que deseja gerenciar e clique em Console na coluna Actions.
No painel de navegação à esquerda, escolha O&M > Deployments. Clique no nome do deployment que deseja investigar.
-
Clique na aba Logs. No painel à esquerda, clique em Logs, Startup Logs ou JM Exceptions para visualizar os logs relevantes.
A área principal exibe o rastreamento de pilha da exceção. Abaixo dela, a seção Analysis based on current logs lista possíveis causas e soluções sugeridas. Na parte inferior, uma tabela de Exception History mostra exceções históricas com horário da primeira ocorrência, nome, tipo de exceção e contagem de ocorrências.
Para obter mais informações sobre tipos de log, consulte Visualize os logs de inicialização e operacionais de um deployment. Para investigar logs de exceção, consulte Visualize os logs de exceção de um deployment. Para acessar registros históricos, consulte Visualize os logs de um deployment histórico.
Executar diagnóstico inteligente em um deployment anormal
Use este fluxo quando um deployment estiver em estado anormal e você precisar identificar a causa raiz.
-
Acesse a aba Diagnosis usando um destes métodos:
Na lista de deployments, localize o deployment desejado e clique na pontuação dele na coluna Health.
Clique no nome do deployment e, em seguida, clique na aba Diagnosis.
Na página Diagnosis, visualize a Health Score (por exemplo, 99) e o horário do diagnóstico. Clique em Diagnose para executar uma verificação diagnóstica. Os resultados mostram o número total de itens verificados (por exemplo, 5), com categorias como Resource Analysis exigindo atenção, enquanto Startup Analysis, Deployment Analysis, State Analysis e Exception Analysis passaram na verificação.
Clique em Diagnose. O Flink Advisor oferece diversos repositórios de logs para exceções do Flink. Para visualizar a lista completa de itens de diagnóstico e etapas de correção, consulte Flink Advisor diagnostic items.
Revise os resultados do diagnóstico e as sugestões de otimização. Para aplicar uma sugestão, clique em Apply ao lado dela.
Itens de diagnóstico do Flink Advisor
Os itens de diagnóstico dividem-se em duas categorias:
Exception: A execução do deployment está afetada. Ação imediata necessária.
Risk: O deployment está em execução, mas um problema potencial foi detectado. Resolva proativamente para evitar falhas futuras.
|
Tipo |
Fase |
Item de diagnóstico |
Descrição |
|
Exception (execução do deployment afetada) |
Startup |
Análise de arquivo de inicialização |
O pacote JAR necessário está ausente no diretório do Object Storage Service (OSS). Carregue novamente o pacote JAR antes de iniciar o deployment. |
|
Startup |
Análise de recursos |
Recursos disponíveis restantes insuficientes. Reduza os valores de configuração de recursos do deployment ou escale horizontalmente o cluster. |
|
|
Startup |
Análise de recursos |
Falha ao vincular a Container Network Interface (CNI) ao deployment. Verifique se o número de endereços IP do vSwitch relacionado atingiu o limite máximo. |
|
|
Startup |
Análise de recursos |
O número de endereços IP da Elastic Network Interface (ENI) excede o limite superior. Aumente a quantidade de ENIs e tente novamente. |
|
|
Startup |
Análise de rede da topologia |
Nenhuma conexão de rede estabelecida entre TaskManager e JobManager. O deployment apresenta anomalia. |
|
|
Startup |
Análise de rede da topologia |
Tempo esgotado na vinculação de ENI a instâncias do Elastic Compute Service (ECS) nos últimos 10 minutos. O deployment está iniciando lentamente. Aguarde a conclusão da operação. |
|
|
Startup |
Análise de rede de serviços upstream e downstream |
Detecção de porta TCP normal, mas o conector upstream ou downstream não está conectado. Verifique as configurações de rede dos serviços upstream e downstream. |
|
|
Startup |
Detecção de permissões de serviços upstream e downstream |
Fonte de dados upstream desconectada. Verifique a configuração de permissões do serviço upstream. |
|
|
Startup |
Detecção de permissões de serviços upstream e downstream |
Fonte de dados downstream desconectada. Verifique a configuração de permissões do serviço downstream. |
|
|
Startup |
Análise de velocidade de inicialização |
Pacote JAR excessivamente grande causando inicialização lenta. Compacte o pacote JAR e carregue-o novamente, ou aguarde a conclusão da inicialização. |
|
|
Startup |
Verificação do JobGraph |
Possível ausência de arquivo de configuração de versão anterior do Realtime Compute for Apache Flink. O deployment pode não se recuperar após um failover. Cancele e reinicie o deployment manualmente. |
|
|
Startup |
Verificação de cluster de sessão |
Cluster de sessão de versão anterior do Realtime Compute for Apache Flink pode estar anormal, causando anomalia no deployment. |
|
|
Run icon |
Verificação de status de alta disponibilidade (HA) |
HA não ativado. O deployment não consegue se recuperar após falha. Publique o rascunho novamente e, em seguida, cancele e reinicie o deployment manualmente. |
|
|
Run icon |
Verificação de checkpoint |
Recurso de checkpoint de versão anterior do Realtime Compute for Apache Flink pode estar anormal, causando falha na criação de checkpoints. |
|
|
Run icon |
Detecção de permissões de serviços upstream e downstream |
Detecção de porta TCP normal, mas conector upstream ou downstream desconectado. Verifique as configurações de permissão dos serviços upstream e downstream. |
|
|
Run icon |
Verificação de status de execução |
Erro de falta de memória (OOM) em um TaskManager. Verifique a configuração do deployment e aumente a memória do TaskManager. |
|
|
Cancellation |
Análise de velocidade de cancelamento |
Cancelamento lento em versão anterior do Realtime Compute for Apache Flink. Cancele e reinicie o deployment manualmente. |
|
|
Risk (execução do deployment não afetada) |
Configurations |
Verificação do JobGraph |
Deployment em execução normal. Contudo, arquivo de configuração de versão anterior pode estar ausente. O deployment pode não se recuperar após falha. Cancele e reinicie o deployment manualmente. |
|
Configurations |
Verificação de status de HA |
Deployment em execução normal. Porém, HA não está ativado. O deployment pode não se recuperar após falha. Publique o rascunho novamente e, depois, cancele e reinicie o deployment manualmente. |
|
|
Configurations |
Verificação de versão |
Deployment em execução normal. No entanto, defeito grave detectado na versão atual do Realtime Compute for Apache Flink. |
|
|
Run icon |
Verificação de checkpoint |
Deployment em execução normal. Entretanto, exceção de checkpoint em versão anterior do Realtime Compute for Apache Flink pode causar problema potencial de estabilidade. |
|
|
Run icon |
Verificação de checkpoint |
Deployment em execução normal. Mas nenhum checkpoint criado por período prolongado. |
|
|
Run icon |
Análise de velocidade de cancelamento |
Deployment em execução normal. Porém, risco detectado que pode causar cancelamento lento em versão anterior do Realtime Compute for Apache Flink. Cancele e reinicie o deployment manualmente. |
|
|
Run icon |
Análise de ambiente de execução |
Failover ocorrido devido a exceção na máquina host. Restauração automática possível após o failover. Nenhuma ação necessária. |
|
|
Run icon |
Análise de ambiente de execução |
Atualização de máquina pode causar failover do deployment em alguns minutos. Restauração automática possível após o failover. Para prevenir, cancele e reinicie o deployment manualmente antes da atualização da máquina. |
|
|
Run icon |
Análise de ambiente de execução |
Falha de hardware na máquina host. A falha se autocorrige após algum tempo, e seu deployment sofrerá um failover durante a correção. Reinicie manualmente (pare e inicie) o deployment para evitar o failover causado pela autocorreção. |
|
|
Run icon |
Verificação de versão |
Versão em fim de suporte (EOS). Problemas de estabilidade podem ocorrer ou o suporte ao produto pode não estar mais disponível. Para mais informações, consulte Console operations. |
Próximos passos
Monitore métricas de desempenho do JobManager e TaskManager para deployments em execução. Para mais informações, consulte Monitor deployment performance.
Configure o ajuste automático para permitir que o sistema reconfigure recursos automaticamente ou conforme agendamento. Para mais informações, consulte Ative ajuste automático de desempenho.
Otimize deployments Flink SQL ajustando configurações de deployment e lógica SQL. Para mais informações, consulte Otimizar Flink SQL.