O conector MongoDB integra o ApsaraDB for MongoDB e o MongoDB autogerenciado ao Realtime Compute for Apache Flink como tabelas de source, dimensão e sink. Ele usa a Change Stream API para capturar eventos de inserção, atualização, substituição e exclusão em tempo real.
Funcionalidades
|
Categoria |
Descrição |
|
Tipos de tabela |
SQL source, lookup (dimensão) e sink Flink CDC source DataStream source |
|
Modo de execução |
Streaming |
|
Tipos de API |
DataStream API, SQL, Flink CDC |
|
Semântica de escrita do sink |
Inserção, atualização e exclusão (com chave primária declarada) |
Métricas de monitoramento
Tabelas de source:
numBytesIn, numBytesInPerSecond, numRecordsIn, numRecordsInPerSecond, numRecordsInErrors, currentFetchEventTimeLag, currentEmitEventTimeLag, watermarkLag, sourceIdleTime
As tabelas de dimensão e sink não expõem métricas de monitoramento.
Para as definições das métricas, consulte Metrics.
Como funciona
O conector MongoDB lê os dados em duas fases:
Snapshot completo — lê todos os documentos existentes das coleções alvo em paralelo.
Leitura incremental — após a conclusão do snapshot, alterna automaticamente para o consumo do oplog por meio da Change Stream API.
Esse processo garante semântica de exatamente uma vez (exactly-once), assegurando que nenhum registro seja duplicado ou perdido durante a recuperação de falhas.
Conceitos principais
Modos de inicialização
Escolha um modo de inicialização com base no momento em que seu pipeline precisa começar a consumir dados:
|
Modo |
Comportamento |
Quando usar |
|
|
Lê um snapshot na primeira inicialização e, em seguida, alterna para leitura incremental |
Quando você precisa de uma cópia completa dos dados existentes |
|
|
Inicia a partir da posição atual do oplog, sem dados históricos |
Indicado quando apenas as alterações a partir deste momento são necessárias |
|
|
Lê eventos do oplog a partir de um timestamp especificado, ignorando o snapshot |
Útil quando as alterações devem partir de um ponto específico no tempo (requer MongoDB 4.0+) |
Suporte a changelog completo
Por padrão, o MongoDB não armazena o estado anterior dos documentos (versões anteriores ao MongoDB 6.0). Sem essa informação, o conector consegue produzir apenas eventos UPSERT — os registros UPDATE_BEFORE ficam ausentes.
Para contornar essa limitação, o planner do Flink SQL insere um operador ChangelogNormalize que armazena em cache o estado dos documentos no backend de estado do Flink. Embora funcional, essa abordagem consome um volume significativo de armazenamento de estado.
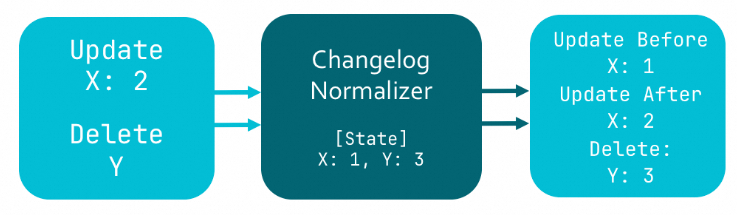
O MongoDB 6.0+ oferece suporte ao registro de preimage e postimage. Quando ativado, o MongoDB registra o estado completo do documento antes e depois de cada alteração. Definir scan.full-changelog como true instrui o conector a usar esses registros para produzir streams de changelog completos — eliminando o operador ChangelogNormalize e o overhead de estado associado.
Pré-requisitos
Antes de começar, verifique se você dispõe de:
Uma instância do ApsaraDB for MongoDB (replica set ou sharded cluster), ou um cluster MongoDB 3.6+ autogerenciado, com o modo de replica set ativado. Consulte Replication.
Se a autenticação estiver ativada, um usuário MongoDB com as seguintes permissões:
splitVector,listDatabases,listCollections,collStats,find,changeStream, e acesso de leitura aconfig.collectionseconfig.chunks.Os endereços IP do cluster Flink adicionados à lista de permissões de IP do MongoDB.
O banco de dados e a coleção alvo criados antes de executar o job.
Limitações
SQL source
A leitura de snapshot em paralelo requer MongoDB 4.0 ou superior. Ative-a definindo
scan.incremental.snapshot.enabledcomotrue.Os bancos de dados
admin,localeconfig, bem como todas as coleções do sistema, não podem ser monitorados. Essa é uma restrição do MongoDB Change Stream. Consulte Change Streams na documentação do MongoDB.Ao criar uma tabela SQL de source, declare a coluna
_id STRINGe defina-a como chave primária.
SQL sink
VVR 8.0.4 e anteriores: somente inserção.
VVR 8.0.5 e posteriores com chave primária declarada: inserção, atualização e exclusão.
VVR 8.0.5 e posteriores sem chave primária: somente inserção.
A entrega exactly-once não é suportada. A opção
sink.delivery-guaranteeaceitanoneouat-least-once.
SQL lookup (dimensão)
Disponível no VVR 8.0.5 e posteriores.
VVR 8.0.9 e posteriores: os lookup joins suportam leitura do campo nativo
_iddo tipo ObjectId.
SQL
Sintaxe
CREATE TABLE tableName(
  _id STRING,
  [columnName dataType,]*
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'localhost:27017',
  'username' = 'mongouser',
  'password' = '${secret_values.password}',
  'database' = 'testdb',
  'collection' = 'testcoll'
)
Declare a coluna _id STRING e especifique-a como chave primária ao criar uma tabela source CDC.
Opções do conector
General
|
Option |
Type |
Required |
Default |
Description |
|
|
String |
Yes |
— |
Identificador do conector. Tabelas source: |
|
|
String |
No |
— |
URI de conexão do MongoDB. Especifique |
|
|
String |
No |
— |
Nome do host do servidor MongoDB. Para múltiplos hosts, separe-os com vírgulas ( |
|
|
String |
No |
|
Protocolo de conexão. Valores válidos: |
|
|
String |
No |
— |
Nome de usuário do MongoDB. Obrigatório quando a autenticação está ativada. |
|
|
String |
No |
— |
Senha do MongoDB. Obrigatória quando a autenticação está ativada. Use variables em vez de inserir as credenciais diretamente no código. |
|
|
String |
No |
— |
Nome do banco de dados MongoDB. Aceita expressões regulares em tabelas source. Se não for definido, todos os bancos de dados são monitorados. Não é possível monitorar os bancos de dados |
|
|
String |
No |
— |
Nome da coleção MongoDB. Aceita expressões regulares em tabelas source. Observações:
|
|
|
String |
No |
— |
Opções de conexão adicionais como pares Por padrão, o conector não define um timeout de conexão de socket, o que pode causar interrupções prolongadas em situações de instabilidade de rede. Defina |
Source
|
Option |
Type |
Required |
Default |
Description |
|
|
String |
No |
|
Modo de inicialização. Valores válidos: |
|
|
Long |
Condicional |
— |
Timestamp de início em milissegundos desde a época UNIX. Obrigatório quando |
|
|
Integer |
No |
|
Tamanho máximo da fila durante a fase de snapshot inicial. Aplicável somente quando |
|
|
Integer |
No |
|
Tamanho do lote do cursor. |
|
|
Integer |
No |
|
Número máximo de documentos de alteração obtidos por lote durante a leitura de stream. Valores maiores alocam um buffer interno maior. |
|
|
Integer |
No |
|
Intervalo entre requisições de leitura de dados, em milissegundos. |
|
|
Integer |
No |
|
Intervalo de heartbeat em milissegundos. O conector envia heartbeats para rastrear a posição mais recente do oplog. Defina como |
|
|
Boolean |
No |
|
Ativa a leitura de snapshot em paralelo. Recurso experimental. Requer MongoDB 4.0 ou superior. |
|
|
Integer |
No |
|
Tamanho do chunk para leitura de snapshot em paralelo, em MB. Recurso experimental. Aplicável somente quando a leitura de snapshot em paralelo está ativada. |
|
|
Boolean |
No |
|
Gera um stream de changelog completo usando registros de preimage e postimage do MongoDB. Recurso experimental. Requer MongoDB 6.0 ou superior com os recursos de preimage e postimage habilitados. |
|
|
Boolean |
No |
|
Interpreta campos separados por |
|
|
Boolean |
No |
|
Interpreta todos os tipos BSON primitivos como STRING. Disponível no VVR 8.0.5 e superior. |
|
|
Boolean |
No |
|
Ignora todos os eventos DELETE (-D), incluindo os gerados durante o arquivamento de dados do MongoDB. Disponível no VVR 11.1 e superior. |
|
|
Boolean |
No |
|
Valores válidos:
O backfill se aplica apenas durante a consulta de snapshot de um único chunk e não abrange toda a fase de leitura completa. Quando o backfill é ignorado, a consulta de snapshot de cada chunk lê os dados mais recentes naquele instante; atualizações que ocorrem em um chunk após sua leitura não são mescladas durante a fase de leitura completa e são lidas a partir do OpLog ao entrar na fase incremental. Por exemplo, uma atualização no chunk5 que ocorre enquanto ele está sendo snapshotted é refletida diretamente no snapshot do chunk5; se o chunk5 for atualizado após o leitor ter avançado para o chunk80, a atualização será aplicada posteriormente a partir do OpLog durante a fase incremental. Importante
Quando ativado, alterações que ocorrem durante ou após a varredura de um chunk ainda são entregues pelo OpLog na fase incremental e podem ser duplicadas. Somente a semântica de entrega "pelo menos uma vez" é garantida. Ative esta opção somente quando o destino downstream suportar gravações idempotentes por chave primária. Nota
Disponível apenas no VVR 11.1 e superior. |
|
|
String |
No |
— |
Operações de pipeline de agregação do MongoDB aplicadas durante a leitura de snapshot para filtrar dados. Especifique como um array JSON, por exemplo: |
|
|
Integer |
No |
— |
Número de threads para replicação de snapshot. Aplicável somente quando |
|
|
Integer |
No |
|
Tamanho da fila para o snapshot inicial. Aplicável somente quando |
|
|
Integer |
No |
|
Número de leitores simultâneos para o Change Stream. Aplicável somente quando |
|
|
Integer |
No |
|
Tamanho da fila de mensagens para assinaturas simultâneas de change stream. Aplicável somente quando |
Lookup (dimension)
|
Option |
Type |
Required |
Default |
Description |
|
|
String |
No |
|
Política de cache. Valores válidos: |
|
|
Integer |
No |
|
Número máximo de tentativas em caso de falha no lookup. |
|
|
Duration |
No |
|
Intervalo entre tentativas em caso de falha no lookup. |
|
|
Duration |
No |
— |
Tempo máximo de vida de uma entrada em cache após o último acesso. Unidades suportadas: |
|
|
Duration |
No |
— |
Tempo máximo de vida de uma entrada em cache após a escrita. Requer |
|
|
Long |
No |
— |
Número máximo de linhas no cache. As entradas mais antigas são removidas quando o limite é atingido. Requer |
|
|
Boolean |
No |
|
Armazena em cache uma entrada nula quando uma chave de lookup não possui registro correspondente. Requer |
|
String |
No |
|
Estratégia de conversão aplicada quando valores string do Flink são comparados com a tabela de dimensão do MongoDB. Valores válidos:
Nota Este parâmetro é suportado apenas no VVR 11.9 e versões posteriores. |
Sink
|
Option |
Type |
Required |
Default |
Description |
|
|
Integer |
No |
|
Número máximo de registros gravados por lote. |
|
|
Duration |
No |
|
Intervalo de flush. |
|
|
String |
No |
|
Semântica de entrega na escrita. Valores válidos: |
|
|
Integer |
No |
|
Número máximo de tentativas em caso de falha na escrita. |
|
|
Duration |
No |
|
Intervalo entre tentativas em caso de falha na escrita. |
|
|
Integer |
No |
— |
Paralelismo personalizado do sink. |
|
|
String |
No |
|
Estratégia para tratamento dos eventos -D e -U. Valores válidos: |
Mapeamentos de tipos de dados
Source
|
Tipo BSON |
Flink SQL |
|
Int32 |
INT |
|
Int64 |
BIGINT |
|
Double |
DOUBLE |
|
Decimal128 |
DECIMAL(p, s) |
|
Boolean |
BOOLEAN |
|
Date Timestamp |
DATE |
|
Date Timestamp |
TIME |
|
DateTime |
TIMESTAMP(3), TIMESTAMP_LTZ(3) |
|
Timestamp |
TIMESTAMP(0), TIMESTAMP_LTZ(0) |
|
String, ObjectId, UUID, Symbol, MD5, JavaScript, Regex |
STRING |
|
Binary |
BYTES |
|
Object |
ROW |
|
Array |
ARRAY |
|
DBPointer |
ROW\<$ref STRING, $id STRING\> |
|
GeoJSON Point |
ROW\<type STRING, coordinates ARRAY\<DOUBLE\>\> |
|
GeoJSON Line |
ROW\<type STRING, coordinates ARRAY\<ARRAY\<DOUBLE\>\>\> |
Lookup (dimension) e sink
|
Tipo BSON |
Tipo Flink SQL |
|
Int32 |
INT |
|
Int64 |
BIGINT |
|
Double |
DOUBLE |
|
Decimal128 |
DECIMAL |
|
Boolean |
BOOLEAN |
|
DateTime |
TIMESTAMP_LTZ(3) |
|
Timestamp |
TIMESTAMP_LTZ(0) |
|
String, ObjectId |
STRING |
|
Binary |
BYTES |
|
Object |
ROW |
|
Array |
ARRAY |
Colunas de metadados
O source SQL suporta as seguintes colunas de metadados:
|
Coluna de metadados |
Tipo |
Descrição |
|
|
STRING NOT NULL |
O banco de dados que contém o documento. |
|
|
STRING NOT NULL |
A coleção que contém o documento. |
|
|
TIMESTAMP_LTZ(3) NOT NULL |
Momento em que o documento foi alterado. Retorna |
|
|
STRING NOT NULL |
Tipo de evento de alteração: |
Exemplos
Source
O exemplo a seguir lê dados de uma tabela source MongoDB com leitura de snapshot paralelo e changelog completo habilitados, e em seguida grava os campos selecionados em um sink do tipo print.
-- CDC source table: reads product data from MongoDB
-- _id must be declared and set as the primary key
CREATE TEMPORARY TABLE mongo_source (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  db_name STRING METADATA FROM 'database_name' VIRTUAL,
  collection_name STRING METADATA VIRTUAL,
  op_ts TIMESTAMP_LTZ(3) METADATA VIRTUAL,
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection',
  'scan.incremental.snapshot.enabled' = 'true', -- Enable parallel snapshot reading (requires MongoDB 4.0+)
  'scan.full-changelog' = 'true'                -- Enable full changelog (requires MongoDB 6.0+ with preimage/postimage)
);

CREATE TEMPORARY TABLE productssink (
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price_amount DECIMAL,
  suppliers_name STRING,
  db_name STRING,
  collection_name STRING,
  op_ts TIMESTAMP_LTZ(3)
) WITH (
  'connector' = 'print',
  'logger' = 'true'
);

INSERT INTO productssink
SELECT
  name,
  weight,
  tags,
  price.amount,
  suppliers[1].name,
  db_name,
  collection_name,
  op_ts
FROM mongo_source;
Lookup (dimension)
O exemplo a seguir une um stream gerado por um data generator com uma tabela de dimensão MongoDB por meio de um temporal join.
CREATE TEMPORARY TABLE datagen_source (
  id STRING,
  a INT,
  b BIGINT,
  `proctime` AS PROCTIME()
) WITH (
  'connector' = 'datagen'
);

CREATE TEMPORARY TABLE mongo_dim (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection',
  'lookup.cache' = 'PARTIAL',                           -- Cache lookup results for better performance
  'lookup.partial-cache.expire-after-access' = '10min', -- Evict cached entries after 10 minutes of inactivity
  'lookup.partial-cache.expire-after-write' = '10min',  -- Evict cached entries 10 minutes after write
  'lookup.partial-cache.max-rows' = '100'               -- Maximum 100 rows in the cache
);

CREATE TEMPORARY TABLE print_sink (
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price_amount DECIMAL,
  suppliers_name STRING
) WITH (
  'connector' = 'print',
  'logger' = 'true'
);

INSERT INTO print_sink
SELECT
  T.id,
  T.a,
  T.b,
  H.name
FROM datagen_source AS T
JOIN mongo_dim FOR SYSTEM_TIME AS OF T.`proctime` AS H ON T.id = H._id;
Sink
O exemplo a seguir grava dados de um data generator em uma tabela sink MongoDB. Uma chave primária é declarada para suportar operações de inserção, atualização e exclusão.
CREATE TEMPORARY TABLE datagen_source (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>
) WITH (
  'connector' = 'datagen'
);

CREATE TEMPORARY TABLE mongo_sink (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  PRIMARY KEY(_id) NOT ENFORCED -- Declare primary key to enable update and delete
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection'
);

INSERT INTO mongo_sink SELECT * FROM datagen_source;
Flink CDC (prévia pública)
O Flink CDC permite sincronizar dados do MongoDB para um repositório downstream por meio de um pipeline baseado em scripts YAML, sem necessidade de escrever SQL DDL. Este recurso exige VVR 11.1 ou posterior.
Sintaxe
source:
   type: mongodb
   name: MongoDB Source
   hosts: localhost:33076
   username: ${mongo.username}
   password: ${mongo.password}
   database: foo_db
   collection: foo_col_.*

sink:
  type: ...
Opções de configuração
|
Option |
Required |
Type |
Default |
Description |
|
|
Yes |
STRING |
— |
O conector. Defina como |
|
|
No |
STRING |
|
Protocolo de conexão. Valores válidos: |
|
|
Yes |
STRING |
— |
Nome(s) do host do servidor MongoDB. Separe múltiplos hosts com vírgulas. |
|
|
No |
STRING |
— |
Nome de usuário do MongoDB. |
|
|
No |
STRING |
— |
Senha do MongoDB. |
|
|
Yes |
STRING |
— |
Nome do banco de dados MongoDB a ser capturado. Expressões regulares são suportadas. |
|
|
Yes |
STRING |
— |
Nome da coleção MongoDB a ser capturada. Expressões regulares são suportadas. Utilize o namespace completo |
|
|
No |
STRING |
— |
Opções de conexão adicionais em pares |
|
|
No |
STRING |
|
Estratégia de inferência de schema. |
|
|
No |
INT |
|
Número máximo de registros a amostrar por coleção durante a inferência inicial de schema. |
|
|
No |
STRING |
|
Modo de inicialização. Valores válidos: |
|
|
No |
LONG |
— |
Timestamp de início em milissegundos. Obrigatório quando |
|
|
No |
INT |
|
Tamanho máximo do chunk de metadados. |
|
|
No |
BOOLEAN |
|
Fecha leitores de source ociosos após a transição para leitura incremental. |
|
|
No |
BOOLEAN |
|
Valores válidos:
O backfill se aplica apenas durante a consulta de snapshot de um único chunk e não abrange toda a fase de leitura completa. Quando o backfill é ignorado, a consulta de snapshot de cada chunk lê os dados mais recentes naquele instante; atualizações que ocorrem em um chunk após sua leitura não são mescladas durante a fase de leitura completa e são lidas do OpLog ao entrar na fase incremental. Por exemplo, uma atualização no chunk5 que ocorre enquanto ele está sendo snapshotado é refletida diretamente no snapshot do chunk5; se o chunk5 for atualizado após o leitor ter avançado para o chunk80, a atualização será aplicada posteriormente a partir do OpLog durante a fase incremental. Importante
Quando ativado, alterações que ocorrem durante ou após a varredura de um chunk ainda são entregues pelo OpLog na fase incremental e podem ser duplicadas. Apenas a semântica de entrega at-least-once é garantida. Ative esta opção somente quando o sink downstream suportar gravações idempotentes por chave primária. |
|
|
No |
BOOLEAN |
|
Processa chunks ilimitados primeiro. Reduz o risco de erros de memória insuficiente em coleções com atualizações frequentes. |
|
|
No |
INT |
|
Tamanho do lote do cursor. |
|
|
No |
INT |
|
Número máximo de entradas por requisição de pull do Change Stream. |
|
|
No |
INT |
|
Tempo mínimo de espera entre requisições de pull do Change Stream, em milissegundos. |
|
|
No |
INT |
|
Intervalo de heartbeat em milissegundos. Configure para coleções com atualizações pouco frequentes. Definir como |
|
|
No |
INT |
|
Tamanho do chunk durante o snapshotting, em MB. |
|
|
No |
INT |
|
Número de amostras usadas para estimar o tamanho da coleção durante o snapshotting. |
|
|
No |
BOOLEAN |
|
Gera eventos de changelog completos usando registros de preimage e postimage. Requer MongoDB 6.0 ou posterior com preimage e postimage habilitados. |
|
|
No |
BOOLEAN |
|
Desativa o timeout do cursor. Por padrão, o MongoDB fecha cursores ociosos após 10 minutos. |
|
|
No |
BOOLEAN |
|
Ignora eventos de exclusão do MongoDB. |
|
|
No |
BOOLEAN |
|
Nivela documentos BSON aninhados. Por exemplo, |
|
|
No |
BOOLEAN |
|
Infere todos os tipos primitivos como STRING. Reduz eventos de alteração de schema quando os tipos upstream são inconsistentes. |
|
|
No |
STRING |
— |
Lista de campos de metadados separados por vírgula a serem encaminhados downstream. Valores suportados: |
Mapeamentos de tipos de dados
|
MongoDB BSON |
Flink CDC |
Notes |
|
STRING |
VARCHAR |
— |
|
INT32 |
INT |
— |
|
INT64 |
BIGINT |
— |
|
DECIMAL128 |
DECIMAL |
— |
|
DOUBLE |
DOUBLE |
— |
|
BOOLEAN |
BOOLEAN |
— |
|
TIMESTAMP |
TIMESTAMP |
— |
|
DATETIME |
LOCALZONEDTIMESTAMP |
— |
|
BINARY |
VARBINARY |
— |
|
DOCUMENT |
MAP |
Tipos de chave e valor são inferidos. |
|
ARRAY |
ARRAY |
Tipos de elemento são inferidos. |
|
OBJECTID |
VARCHAR |
Representado como string hexadecimal. |
|
SYMBOL, REGULAREXPRESSION, JAVASCRIPT, JAVASCRIPTWITHSCOPE |
VARCHAR |
Representado como string. |
Colunas de metadados
O Flink CDC suporta a seguinte coluna de metadados para o conector MongoDB:
|
Metadata column |
Type |
Description |
|
|
BIGINT NOT NULL |
Momento em que o documento foi alterado (timestamp do OpLog). Retorna |
Use as colunas de metadados genéricas do módulo Transform para acessar database_name, collection_name e row_kind.
DataStream API
Para usar a DataStream API, configure o conector DataStream para seu job. Consulte DataStream connector usage.
Adicionar a dependência Maven
O Maven Central Repository hospeda conectores VVR MongoDB.
<dependency>
    <groupId>com.alibaba.ververica</groupId>
    <artifactId>flink-connector-mongodb</artifactId>
    <version>${vvr.version}</version>
</dependency>
Criar um MongoDBSource
Use MongoDBSource.builder() para construir um source:
Para ativar a leitura incremental de snapshot, use o builder de
com.ververica.cdc.connectors.mongodb.source.Caso contrário, use o builder de
com.ververica.cdc.connectors.mongodb.
MongoDBSource.builder()
  .hosts("mongo.example.com:27017")
  .username("mongouser")
  .password("mongopasswd")
  .databaseList("testdb")          // Supports regular expressions; use .* to match all databases
  .collectionList("testcoll")      // Supports regular expressions; use .* to match all collections
  .startupOptions(StartupOptions.initial()) // StartupOptions.latest-offset(), StartupOptions.timestamp()
  .deserializer(new JsonDebeziumDeserializationSchema())
  .build();
Parâmetros do MongoDBSource
|
Parâmetro |
Descrição |
|
|
Hostname do servidor MongoDB. |
|
|
Nome de usuário do MongoDB. Omita se a autenticação não estiver habilitada. |
|
|
Senha do MongoDB. Omita se a autenticação não estiver habilitada. |
|
|
Nome do banco de dados a ser monitorado. Aceita expressões regulares. Use |
|
|
Nome da coleção a ser monitorada. Aceita expressões regulares. Use |
|
|
Modo de inicialização. Valores válidos: |
|
|
Desserializador para converter objetos |
Referências
Flink CDC (public preview) — Sincronize dados do MongoDB e alterações de schema com tabelas downstream (VVR 11.1 e versões posteriores).
Metrics — Monitore o desempenho da tabela de source.