Para sincronizar dados de uma instância do ApsaraDB RDS for MySQL com um cluster do Alibaba Cloud Elasticsearch, use o plug-in logstash-input-jdbc do Alibaba Cloud Logstash. Esse plug-in vem instalado por padrão e não pode ser desinstalado. Por meio de uma configuração de pipeline, ele sincroniza dados completos ou incrementais com o cluster do Alibaba Cloud Elasticsearch em tempo real. Este tópico descreve como implementar essa sincronização.
Limites
Certifique-se de que a instância do ApsaraDB RDS for MySQL, o cluster do Alibaba Cloud Logstash e o cluster do Alibaba Cloud Elasticsearch estejam no mesmo fuso horário. Caso contrário, ao sincronizar dados relacionados a tempo, poderá haver diferença de fuso horário entre os dados antes e depois da sincronização.
-
O campo
_idno Elasticsearch deve ser idêntico ao campoidno MySQL.Essa condição garante que, quando um registro do MySQL for gravado no Elasticsearch, a tarefa de sincronização estabeleça um mapeamento direto entre o registro do MySQL e o documento do Elasticsearch. Por exemplo, ao atualizar um registro no MySQL, a tarefa de sincronização substitui o documento do Elasticsearch que possui o mesmo ID do registro atualizado.
NotaDevido ao funcionamento interno do Elasticsearch, uma atualização consiste essencialmente na exclusão do documento antigo seguida pela indexação do novo documento. Portanto, substituir um documento no Elasticsearch tem a mesma eficiência de uma operação de atualização.
-
Ao inserir ou atualizar dados no MySQL, o registro correspondente deve conter um campo que armazene o horário de atualização ou de inserção.
Sempre que o Logstash consulta o MySQL, ele salva o horário de atualização ou inserção do último registro lido. Na leitura seguinte, o Logstash processa apenas os registros que atendem à condição, ou seja, aqueles cujo horário de atualização ou inserção é posterior ao do último registro da consulta anterior.
ImportanteO plug-in
logstash-input-jdbcnão sincroniza exclusões. Execute o comando correspondente no Elasticsearch para excluir os documentos manualmente.
Pré-requisitos
Recomendamos criar as seguintes instâncias na mesma virtual private cloud (VPC):
Também é possível utilizar serviços implantados na Internet. Nesse caso, configure o SNAT, ative o endpoint público da instância do ApsaraDB RDS for MySQL e remova a restrição da lista de permissões. Para mais informações sobre como configurar o SNAT, consulte Configure a NAT gateway for public data transfer. Para detalhes sobre a configuração da lista de permissões, consulte Configure an IP address whitelist.
Crie uma instância do ApsaraDB RDS for MySQL. Para mais informações, consulte Create an ApsaraDB RDS for MySQL instance. Neste tópico, usa-se o MySQL 5.7.
Crie um cluster do Alibaba Cloud Elasticsearch. Para mais informações, consulte Create an Alibaba Cloud Elasticsearch cluster. Neste tópico, usa-se um cluster do Elasticsearch V8.17.
Crie um cluster do Alibaba Cloud Logstash. Para mais informações, consulte Create an Alibaba Cloud Logstash instance. Neste tópico, usa-se um cluster do Logstash V8.11.4.
Informações básicas
O Alibaba Cloud Logstash é uma ferramenta de coleta e processamento de dados que oferece recursos de coleta, transformação, otimização e saída. O plug-in logstash-input-jdbc do Logstash vem instalado por padrão e não pode ser desinstalado. Com esse plug-in, você consulta dados em lotes numa instância do ApsaraDB RDS for MySQL e os sincroniza com o Elasticsearch. Ele também consulta periodicamente os dados da instância do ApsaraDB RDS for MySQL e sincroniza com o Elasticsearch os registros inseridos ou alterados desde a última consulta. Para mais informações, consulte "How to keep Elasticsearch synchronized with a relational database using Logstash" na documentação oficial. Essa solução é adequada para cenários em que se aceita uma latência de segundos na sincronização completa dos dados ou para consultas em lote de dados que atendem a condições específicas antes da sincronização.
Sincronizar dados
Etapa 1: Preparar o ambiente
Ative o recurso Auto Indexing no seu cluster do Elasticsearch para permitir que o Logstash crie índices automaticamente. Para mais detalhes, consulte Access and configure an Elasticsearch cluster.
Faça upload de um driver JDBC compatível com a sua versão do MySQL para o cluster do Logstash. Este exemplo usa o
mysql-connector-java-5.1.48.jar. Para mais detalhes, consulte Configure third-party libraries.-
Prepare os dados de teste. Use a seguinte instrução para criar uma tabela:
CREATE table food (
  id int PRIMARY key AUTO_INCREMENT,
  name VARCHAR (32),
  insert_time DATETIME,
  update_time DATETIME
);
Use a seguinte instrução para inserir dados:
INSERT INTO food values(null,'Chocolates',now(),now());
INSERT INTO food values(null,'Yogurt',now(),now());
INSERT INTO food values(null,'Ham sausage',now(),now());
Adicione os endereços IP dos nós do Alibaba Cloud Logstash à lista de permissões da instância do ApsaraDB RDS for MySQL. Obtenha esses endereços IP na página Basic Information do cluster do Logstash.
Etapa 2: Configurar um pipeline do Logstash
Acesse a página Logstash Clusters.
-
Acesse o cluster desejado.
Na barra de navegação superior, selecione a região onde o cluster está localizado.
Na página Logstash Clusters, localize o cluster e clique em seu ID.
No painel de navegação à esquerda, clique em Pipelines.
Clique em Create Pipeline.
-
Na página Create Pipeline, insira um Pipeline ID e configure o Config.
Este tópico usa a seguinte configuração de Config.
input { jdbc { jdbc_driver_class => "com.mysql.jdbc.Driver" jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar" jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false" jdbc_user => "xxxxx" jdbc_password => "xxxx" jdbc_paging_enabled => "true" jdbc_page_size => "50000" statement => "select * from food where update_time >= :sql_last_value" schedule => "* * * * *" record_last_run => true last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt" clean_run => false tracking_column_type => "timestamp" use_column_value => true tracking_column => "update_time" } } filter { } output { elasticsearch { hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200" index => "rds_es_dxhtest_datetime" user => "elastic" password => "xxxxxxx" document_id => "%{id}" } }NotaSubstitua o placeholder
<Logstash cluster ID>no código pelo ID do cluster do Logstash criado. Para mais informações sobre como obter o ID, consulte View the basic information of a cluster.Configuração
Descrição
inputDefine a fonte de dados de entrada. Para ver os tipos de fontes de dados suportados, consulte Input plugins. Este tópico usa uma fonte de dados JDBC. Para a descrição dos parâmetros, consulte input parameters.
filterEspecifica o plug-in usado para filtrar os dados de entrada. Para ver os tipos de plug-ins suportados, consulte Filter plugins.
outputDefine o tipo da fonte de dados de destino. Para ver os tipos de fontes de dados suportados, consulte Output plugins. Como este tópico aborda a sincronização de dados do MySQL para o Elasticsearch, especifique as informações do cluster do Elasticsearch de destino em
output. Para a descrição dos parâmetros, consulte Step 3: Create and run a pipeline.ImportanteSe o parâmetro
file_extendfor utilizado emoutput, instale previamente o plug-inlogstash-output-file_extend. Para mais informações, consulte Install or remove plugins.Parâmetro
Descrição
jdbc_driver_classConfiguração da classe JDBC.
jdbc_driver_libraryEspecifica o arquivo do driver JDBC usado para conectar ao MySQL. O formato é
/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/<driver file name>. Faça o upload do arquivo do driver no console antecipadamente. Para saber quais drivers o Alibaba Cloud Logstash suporta e como fazer o upload, consulte Configure third-party libraries.jdbc_connection_stringDefine o nome de domínio, a porta e o banco de dados da conexão. O formato é
jdbc:mysql://<MySQL endpoint>:<Port>/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false.<MySQL endpoint>: especifique o endpoint interno do MySQL. Se utilizar o endpoint público, configure um gateway NAT para o Logstash e definajdbc:mysql://<MySQL endpoint>:<Port>como o nome de domínio público para transmitir dados pela Internet. Para mais informações, consulte Configure a NAT gateway for public data transfer.<Port>: a porta deve corresponder à porta de saída do MySQL. Geralmente, a porta é 3306.
jdbc_userNome de usuário do banco de dados.
jdbc_passwordSenha do banco de dados.
jdbc_paging_enabledIndica se a paginação deve ser ativada. Valor padrão:
false.jdbc_page_sizeTamanho da página.
statementDefine a instrução SQL. Para consultas em várias tabelas, use uma instrução join.
NotaO parâmetro
sql_last_valuedetermina qual linha consultar. Antes da execução de qualquer consulta, esse valor é definido como quinta-feira, 1º de janeiro de 1970. Para mais informações, consulte Jdbc input plugin.scheduleDefine a operação agendada. O valor
*indica sincronização a cada minuto. Este parâmetro usa uma expressão cron no estilo Rufus.record_last_runIndica se o resultado da execução anterior deve ser registrado. Se definido como
true, o valor do campotracking_columnda execução anterior será gravado e salvo no arquivo especificado porlast_run_metadata_path.last_run_metadata_pathEspecifica o caminho do arquivo que armazena o horário da última execução. Atualmente, o backend disponibiliza o caminho
/ssd/1/<Logstash cluster ID>/logstash/data/para armazenar o arquivo. Após definir o caminho, o Logstash gera automaticamente um arquivo nesse local, mas o conteúdo não pode ser visualizado.NotaAo configurar um pipeline do Logstash, recomendamos basear este parâmetro no caminho
/ssd/1/<Logstash cluster ID>/logstash/data/. Se outro caminho for utilizado, os registros condicionais sincronizados não poderão ser armazenados no arquivo de configuração sob o caminholast_run_metadata_pathdevido a permissões insuficientes.clean_runIndica se os registros de
last_run_metadata_pathdevem ser limpos. Valor padrão:false. Se definido comotrue, todos os registros do banco de dados serão consultados desde o início a cada execução.use_column_valueIndica se o valor de uma coluna deve ser registrado. Se definido como
true, o sistema registra o valor mais recente da coluna especificada portracking_columne usa esse valor na próxima execução do pipeline para determinar quais registros precisam ser atualizados.tracking_column_typeTipo da coluna de rastreamento. Valor padrão:
numeric.tracking_columnEspecifica a coluna de rastreamento. A coluna deve ser incremental. Na maioria dos casos, trata-se da chave primária do MySQL.
ImportanteA configuração acima baseia-se em dados de teste. Em cenários reais de negócios, configure os parâmetros conforme suas necessidades específicas. Para outras opções de configuração suportadas pelo plug-in de entrada, consulte o tópico oficial Logstash Jdbc input plugin.
Se a configuração incluir um parâmetro como
last_run_metadata_path, o Alibaba Cloud Logstash precisará fornecer o caminho do arquivo. Atualmente, o backend disponibiliza o caminho/ssd/1/<Logstash cluster ID>/logstash/data/para testes, e os dados nesse diretório não são excluídos. Portanto, certifique-se de que há espaço disponível suficiente em disco. Após especificar o caminho, o Logstash gera automaticamente um arquivo no local, mas o conteúdo não pode ser visualizado.Para aumentar a segurança, caso use um driver JDBC na configuração do pipeline, anexe
allowLoadLocalInfile=false&autoDeserialize=falseao parâmetrojdbc_connection_string. Caso contrário, o sistema de agendamento reportará uma falha de verificação ao adicionar o arquivo de configuração do Logstash. Exemplo:jdbc_connection_string => "jdbc:mysql://xxx.drds.aliyuncs.com:3306/<Database name>?allowLoadLocalInfile=false&autoDeserialize=false".
Para mais configurações de Config, consulte Logstash configuration files.
-
Clique em Next para configurar os parâmetros do pipeline.
AvisoSalvar e implantar o pipeline aciona uma reinicialização do cluster do Logstash. Confirme que a reinicialização não afetará suas cargas de trabalho antes de prosseguir.
Parâmetro
Descrição
Padrão
Pipeline Workers
Número de threads executando plug-ins de filtro e saída em paralelo. Aumente este valor quando os recursos de CPU estiverem subutilizados ou houver acúmulo de eventos.
Número de vCPUs
Pipeline Batch Size
Máximo de eventos que um único worker coleta das entradas antes de executar filtros e saídas. Valores maiores aumentam o throughput, mas exigem mais memória heap da JVM.
125
Pipeline Batch Delay
Tempo de espera do worker por eventos adicionais antes de iniciar um pequeno lote, em milissegundos.
50
Queue Type
Modelo de fila interna para buffer de eventos. MEMORY: fila em memória. PERSISTED: fila baseada em disco com ACK para durabilidade.
MEMORY
Queue Max Bytes
Tamanho máximo da fila em disco. Deve ser menor que a capacidade de disco disponível.
1024 MB
Queue Checkpoint Writes
Máximo de eventos gravados antes de forçar um checkpoint (apenas filas persistentes). Defina como 0 para ilimitado.
1024
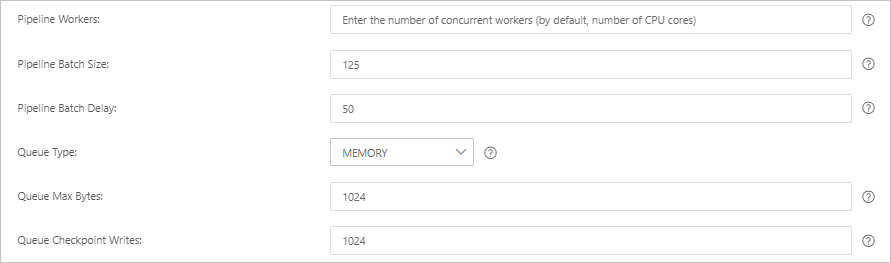
Clique em Save and Deploy para reiniciar o cluster do Logstash e aplicar a configuração imediatamente. Alternativamente, clique em Save para armazenar a configuração e acionar uma alteração no cluster, mas as configurações ainda não entrarão em vigor. Para implantar posteriormente, acesse a página Pipelines, localize o pipeline e clique em Deploy Now na coluna Actions.
Etapa 3: Verificar o resultado
Faça login no console Kibana do seu cluster do Elasticsearch. Para mais detalhes, consulte Log on to the Kibana console.
No canto superior esquerdo, clique no ícone
 e escolha .
-
Na aba Console, execute o seguinte comando para confirmar que as três linhas foram sincronizadas:
GET rds_es_dxhtest_datetime/_count
{
  "query": {"match_all": {}}
}
Resposta esperada:
{ "count" : 3, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 } } -
Atualize e insira linhas no MySQL para testar a sincronização incremental:
UPDATE food SET name='Chocolates',update_time=now() where id = 1; INSERT INTO food values(null,'Egg',now(),now()); -
No console Kibana, visualize os dados atualizados.
-
Pesquise pela linha atualizada:
GET rds_es_dxhtest_datetime/_search
{
  "query": {
    "match": {
      "name": "Chocolates"
    }
  }
}
{ "took" : 2, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 1, "relation" : "eq" }, "max_score" : 1.5580825, "hits" : [ { "_index" : "rds_es_dxhtest_datetime", "_type" : "_doc", "_id" : "1", "_score" : 1.5580825, "_source" : { "update_time" : "2020-03-23T03:43:19.000Z", "@version" : "1", "name" : "Chocolates", "insert_time" : "2020-03-23T03:00:36.000Z", "@timestamp" : "2020-03-23T03:44:00.1857", "id" : 1 } } ] } } -
Consulte todos os documentos:
GET rds_es_dxhtest_datetime/_search
{
  "query": {
    "match_all": {}
  }
}
A resposta inclui o documento recém-adicionado com id=4 e name=Egg, confirmando que a sincronização de dados foi bem-sucedida.
{
  "_index" : "rds_es_dxhtest_datetime",
  "_type" : "_doc",
  "_id" : "1",
  "_score" : 1.0,
  "_source" : {
    "update_time" : "2020-03-23T03:43:19.000Z",
    "@version" : "1",
    "name" : "Chocolates",
    "insert_time" : "2020-03-23T03:00:36.000Z",
    "@timestamp" : "2020-03-23T03:44:00.185Z",
    "id" : 1
  }
},
{
  "_index" : "rds_es_dxhtest_datetime",
  "_type" : "_doc",
  "_id" : "4",
  "_score" : 1.0,
  "_source" : {
    "update_time" : "2020-03-23T04:05:01.000Z",
    "@version" : "1",
    "name" : "Egg",
    "insert_time" : "2020-03-23T04:05:01.000Z",
    "@timestamp" : "2020-03-23T04:06:00.192Z",
    "id" : 4
  }
}
-
Perguntas frequentes
Meu pipeline está travado no estado de inicialização, os dados estão inconsistentes após a sincronização ou a conexão com o banco de dados falhou. O que devo fazer?
Verifique primeiro os logs do cluster do Logstash. Acesse o console do Logstash e use o recurso Query logs para visualizar os detalhes do erro. Para mais informações, consulte Query logs.
Se uma atualização do cluster estiver em andamento quando você aplicar uma correção, pause a atualização primeiro. Consulte View the progress of a cluster task . Após a correção, o sistema reiniciará o cluster e retomará a atualização automaticamente.
A tabela a seguir lista causas comuns e soluções:
Causa | Solução |
Os endereços IP dos nós do Logstash não foram adicionados à lista de permissões do MySQL. | Adicione os endereços IP dos nós do Logstash à lista de permissões do MySQL seguindo as instruções em Use a database client or the CLI to connect to an ApsaraDB RDS for MySQL instance. Nota Para mais informações sobre como obter os endereços IP dos nós do Logstash, consulte View the basic information of a cluster. |
Sincronização a partir de um MySQL autogerenciado no ECS: IPs privados e portas dos nós não constam no grupo de segurança do ECS. | Adicione os endereços IP privados e as portas internas dos nós do Logstash ao grupo de segurança do ECS. Consulte Add a security group rule. |
O cluster do Elasticsearch não está na mesma VPC que o cluster do Logstash. | Adquira um cluster do Elasticsearch na mesma VPC ou configure um gateway NAT para acesso via Internet. Consulte Create an Alibaba Cloud Elasticsearch cluster e Configure a NAT gateway for data transmission over the Internet. |
O endpoint do MySQL está incorreto ou a porta não é 3306. | Obtenha o endpoint e a porta corretos seguindo as instruções em View and manage instance endpoints and ports. Em seguida, substitua o valor do parâmetro Importante
|
Auto Indexing desativado no cluster do Elasticsearch. | Ative o Auto Indexing. Consulte Configure the YML file. |
A carga no cluster do Elasticsearch ou do Logstash está muito alta. | Atualize a configuração do cluster seguindo as instruções em Upgrade cluster configuration. Nota Visualize a carga no Elasticsearch através das métricas de monitoramento no console. Para mais informações, consulte Monitoring metrics and exception handling. Visualize a carga no Logstash através do monitoramento X-Pack no Kibana. Para mais informações, consulte Configure X-Pack monitoring. |
Driver JDBC não enviado. | Faça o upload do arquivo do driver. Consulte Configure third-party libraries. |
| Instale o plug-in ou remova o parâmetro |
Para mais orientações sobre solução de problemas, consulte FAQ about data transfer by using Logstash.
Como sincronizo dados de várias tabelas do MySQL para índices separados do Elasticsearch?
Defina múltiplos blocos jdbc na seção input, atribua um valor type a cada um e use condições if[type] na seção output para rotear os dados de cada tabela para um índice diferente:
input {
    jdbc {
      jdbc_driver_class => "com.mysql.jdbc.Driver"
      jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar"
      jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false"
      jdbc_user => "xxxxx"
      jdbc_password => "xxxx"
      jdbc_paging_enabled => "true"
      jdbc_page_size => "50000"
      statement => "select * from tableA where update_time >= :sql_last_value"
      schedule => "* * * * *"
      record_last_run => true
      last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt"
      clean_run => false
      tracking_column_type => "timestamp"
      use_column_value => true
      tracking_column => "update_time"
      type => "A"
    }
    jdbc {
      jdbc_driver_class => "com.mysql.jdbc.Driver"
      jdbc_driver_library => "/ssd/1/share/<Logstash cluster ID>/logstash/current/config/custom/mysql-connector-java-5.1.48.jar"
      jdbc_connection_string => "jdbc:mysql://rm-bp1xxxxx.mysql.rds.aliyuncs.com:3306/<Database name>?useUnicode=true&characterEncoding=utf-8&useSSL=false&allowLoadLocalInfile=false&autoDeserialize=false"
      jdbc_user => "xxxxx"
      jdbc_password => "xxxx"
      jdbc_paging_enabled => "true"
      jdbc_page_size => "50000"
      statement => "select * from tableB where update_time >= :sql_last_value"
      schedule => "* * * * *"
      record_last_run => true
      last_run_metadata_path => "/ssd/1/<Logstash cluster ID>/logstash/data/last_run_metadata_update_time.txt"
      clean_run => false
      tracking_column_type => "timestamp"
      use_column_value => true
      tracking_column => "update_time"
      type => "B"
    }
}
output {
    if[type] == "A" {
        elasticsearch {
            hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200"
            index => "rds_es_dxhtest_datetime_A"
            user => "elastic"
            password => "xxxxxxx"
            document_id => "%{id}"
        }
    }
    if[type] == "B" {
        elasticsearch {
            hosts => "http://es-cn-0h****dd0hcbnl.elasticsearch.aliyuncs.com:9200"
            index => "rds_es_dxhtest_datetime_B"
            user => "elastic"
            password => "xxxxxxx"
            document_id => "%{id}"
        }
    }
}