O MaxCompute, anteriormente conhecido como ODPS, é uma solução de data warehouse rápida e totalmente gerenciada, capaz de processar exabytes de dados. Use o Data Transmission Service (DTS) para sincronizar dados de uma instância ApsaraDB RDS for MySQL ou Serverless ApsaraDB RDS for MySQL para o MaxCompute. Essa abordagem permite construir rapidamente um sistema de análise de dados em tempo real.
Serverless ApsaraDB RDS for MySQL
Pré-requisitos
Conclua as seguintes operações antes de iniciar:
Precauções
Durante a inicialização completa dos dados, o DTS consome recursos de leitura e gravação dos bancos de dados de origem e destino, o que pode aumentar a carga do banco de dados. Se os bancos tiverem baixo desempenho, especificações reduzidas ou cargas de trabalho intensas (por exemplo, muitas instruções SQL lentas, tabelas sem chaves primárias ou deadlocks no banco de destino), a pressão sobre o banco pode aumentar ainda mais e tornar os services indisponíveis. Por isso, avalie o desempenho dos bancos de origem e destino antes de iniciar a sincronização. Recomendamos executar a sincronização em horários de baixa demanda (por exemplo, quando a carga da CPU de ambos os bancos estiver abaixo de 30%).
Há suporte apenas para sincronização de dados no nível de tabela.
Não use ferramentas como gh-ost ou pt-online-schema-change para executar operações DDL online nos objetos de sincronização do banco de dados de origem durante a sincronização. Caso contrário, a tarefa falhará.
O MaxCompute não oferece suporte a restrições PRIMARY KEY. Se o DTS retransmitir dados devido a problemas de rede, registros duplicados poderão aparecer no MaxCompute.
Faturamento
|
Tipo de sincronização |
Preço |
|
Sincronização de esquema e sincronização completa de dados |
Gratuito. |
|
Sincronização incremental de dados |
Pago. Para mais informações, consulte Billing overview. |
Tipos de instância de origem com suporte
Há suporte para sincronização de dados nos seguintes tipos de bancos de dados MySQL:
Banco de dados autogerenciado em uma instância ECS
Banco de dados autogerenciado conectado via linha dedicada, VPN Gateway ou Smart Access Gateway
Banco de dados autogerenciado conectado via Database Gateway
Instância ApsaraDB RDS for MySQL pertencente à mesma conta Alibaba Cloud ou a uma conta diferente
Este tópico usa uma RDS Instance como exemplo para descrever o procedimento de configuração. O processo é semelhante para outros tipos de instância de banco de dados de origem.
Se o banco de dados de origem for um MySQL autogerenciado, etapas adicionais de preparação são necessárias. Para mais informações, consulte Preparation overview.
Operações SQL com suporte
Operações DDL: ALTER TABLE, ADD COLUMN
Operações DML: INSERT, UPDATE, DELETE
Processo de sincronização
-
Sincronização inicial de esquema.
O DTS sincroniza as definições de esquema das tabelas selecionadas do banco de dados de origem para o MaxCompute. Durante a inicialização, o DTS adiciona o sufixo
_baseaos nomes das tabelas. Por exemplo, se a tabela de origem forcustomer, a tabela no MaxCompute será nomeadacustomer_base. -
Sincronização inicial completa de dados.
O DTS sincroniza todos os dados históricos das tabelas do banco de origem para as tabelas
_baseno MaxCompute. Por exemplo, os dados da tabelacustomerno banco de origem são transferidos para a tabelacustomer_baseno MaxCompute. Esses dados servem como base para a subsequente sincronização incremental.NotaEssa tabela também é conhecida como tabela de linha de base completa.
-
Sincronização incremental de dados.
O DTS cria uma tabela de log incremental no MaxCompute. O nome dessa tabela corresponde ao nome da tabela de destino com o sufixo
_log, comocustomer_log. Em seguida, o DTS sincroniza os dados incrementais do banco de origem para essa tabela em tempo real.NotaPara mais detalhes sobre a estrutura da tabela de log incremental, consulte Incremental log table schema.
Procedimento
Para garantir a autorização da conta de sincronização do DTS, execute as etapas a seguir usando sua conta raiz.
-
Adquira uma instância de sincronização de dados. Para mais informações, consulte Purchase a DTS instance.
NotaAo adquirir a instância, defina a instância de origem como MySQL, a instância de destino como MaxCompute e a topologia de sincronização como One-way Synchronization.
-
Acesse o Data Transmission Service console.
NotaCaso seja redirecionado automaticamente para o console do Data Management (DMS), clique em no ícone
 no canto inferior direito e selecione
 para retornar ao console clássico do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
-
Na barra de navegação superior da página Data Synchronization, selecione a região onde a instância de destino está localizada.
Localize a instância de sincronização de dados adquirida e clique em Configure Synchronization Channel.
-
Configure as instâncias de origem e destino.
Categoria
Configuração
Descrição
Nenhuma
Synchronization Job Name
O DTS gera automaticamente um nome para o trabalho de sincronização. Recomendamos especifique um nome descritivo para facilitar a identificação. O nome não precisa ser único.
Source Instance Information
Instance Type
Selecione RDS Instance.
Instance Region
Região da instância de origem selecionada durante a aquisição da instância de sincronização de dados. Este campo não pode ser alterado.
Instance ID
Selecione o ID da instância RDS que servirá como fonte de dados.
Database Account
Insira a conta do banco de dados da instância RDS de origem.
NotaQuando o tipo de banco de dados da instância RDS de origem for MySQL 5.5 ou MySQL 5.6, não é necessário configure Database Account ou Database Password.
Database Password
Insira a senha correspondente à conta do banco de dados.
Connection Method
Escolha Unencrypted Connection ou Secure SSL Connection conforme necessário. Se optar por Secure SSL Connection, ative primeiro o recurso de criptografia SSL na instância RDS. Para mais informações, consulte Set SSL encryption.
ImportanteAtualmente, a opção Encryption só pode ser configurada nas regiões da China continental e China (Hong Kong).
Destination Instance Information
Instance Type
Definido como MaxCompute e não pode ser alterado.
Instance Region
Região da instância de destino selecionada durante a aquisição da instância de sincronização de dados. Este campo não pode ser alterado.
Project
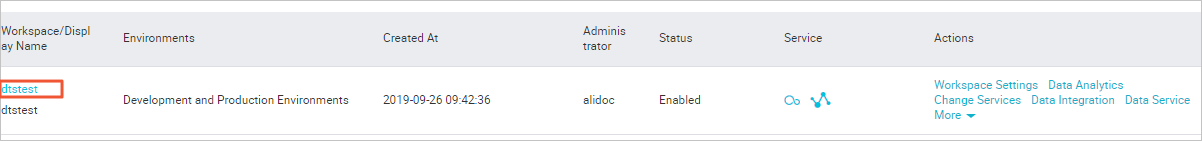
Insira o Project da instância MaxCompute. Você pode encontrá-lo na página MaxCompute Workspace List.
-
No canto inferior direito da página, clique em Authorize Whitelist And Go To Next Step.
NotaSe o banco de dados de origem ou destino for uma instância de banco de dados Alibaba Cloud, como uma instância ApsaraDB RDS for MySQL, uma instância ApsaraDB for MongoDB ou um banco de dados autogerenciado em uma instância ECS, o DTS adiciona automaticamente o endereço IP do service DTS na região correspondente à lista de permissões da instância de banco de dados Alibaba Cloud ou às regras de segurança da instância ECS. Não é necessário adicionar o endereço IP manualmente. Para mais informações, consulte IP address blocks of DTS servers.
-
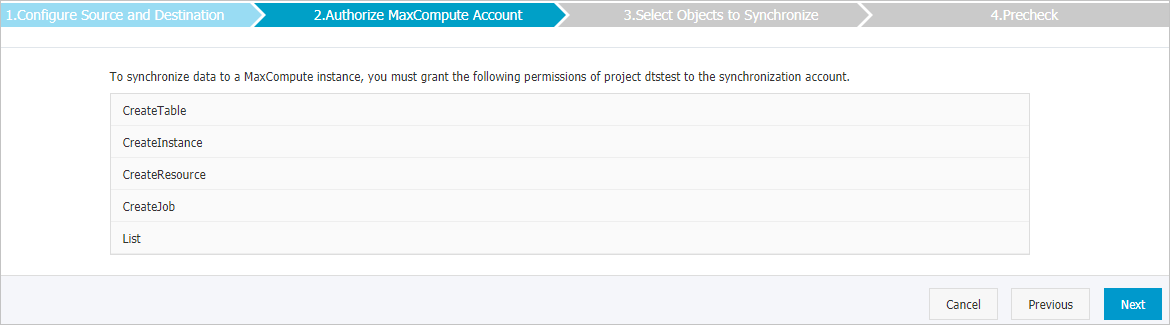
No canto inferior direito da página, clique em Next. Em seguida, conceda as permissões necessárias à conta de sincronização do DTS no projeto MaxCompute, conforme ilustrado na figura a seguir.
-
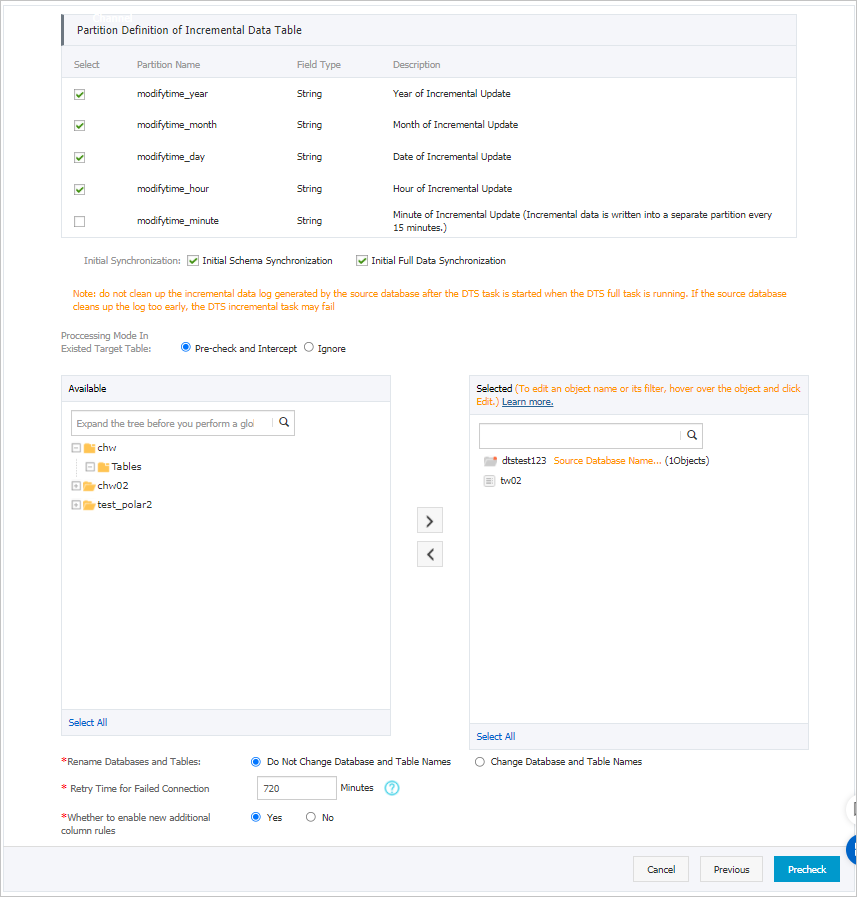
Configure a política e os objetos de sincronização.
Configuração
Descrição
Incremental Log Table Partition Definition
Selecione os nomes das partições conforme necessário. Para mais informações sobre partições, consulte Partition.
Synchronization Initialization
A inicialização da sincronização inclui a sincronização inicial de esquema e a sincronização inicial completa de dados.
Selecione tanto Initial Schema Synchronization quanto Initial Full Data Synchronization. Assim, o DTS sincronizará os esquemas e os dados históricos dos objetos selecionados antes de iniciar a sincronização incremental.
Processing Mode for Existing Tables in the Destination
-
Precheck And Block On Error: A pré-verificação é aprovada se o banco de dados de destino não contiver tabelas com os mesmos nomes das tabelas do banco de origem. Caso contrário, um erro é retornado durante a pré-verificação e a tarefa de sincronização não pode ser iniciada.
NotaSe não for possível exclua ou renomear a tabela com o mesmo nome no banco de destino, utilize set the name of the synchronization object in the destination instance para evitar conflitos de nomes.
-
Ignore Errors And Continue Execution: Ignora a verificação de tabelas com os mesmos nomes no banco de dados de destino.
AvisoSelecionar Ignore Errors And Continue Execution pode causar inconsistência de dados e apresentar riscos ao seu negócio:
-
Se as estruturas das tabelas forem consistentes e um registro no banco de destino tiver o mesmo valor de chave primária que um registro no banco de origem, o registro no banco de destino será mantido durante a inicialização. Durante a sincronização incremental, esse registro no banco de destino será sobrescrito.
-
Se as estruturas das tabelas forem inconsistentes, a inicialização dos dados poderá falhar. Isso pode resultar em sincronização parcial ou falha total da sincronização.
-
Select Synchronization Objects
Na caixa Source Objects, selecione uma ou mais tabelas para sincronizar e clique em no ícone
 para movê-las para a caixa Selected Objects.Nota
-
Apenas tabelas podem ser selecionadas como objetos de sincronização. É possível selecione tabelas de vários bancos de dados.
-
Por padrão, os nomes dos objetos de sincronização permanecem inalterados. Se desejar nomes diferentes na instância de destino, use o recurso de mapeamento de nomes de objetos. Para mais informações, consulte Set the name of the synchronization object in the destination instance.
Select Additional Column Rule
Ao sincronizar dados para o MaxCompute, o DTS adiciona colunas à tabela de destino. Se os nomes dessas colunas adicionais entrarem em conflito com nomes de colunas existentes, a tarefa de sincronização falhará. De acordo com seus requisitos de negócio, defina Enable New Additional Column Rule como Yes ou No.
AvisoAntes de escolha uma regra de coluna adicional, avalie se os nomes dessas colunas entrarão em conflito com os nomes das colunas existentes na tabela de destino. Caso contrário, a tarefa poderá falhar ou haver perda de dados. Para mais detalhes sobre as regras e definições de colunas adicionais, consulte Additional column names and definitions.
Change mapping name
Altere os nomes dos objetos sincronizados na instância de destino. Para mais informações, consulte Map databases, tables, and columns.
Whether to copy temporary tables to the destination database during an online DDL operation on the source table using DMS
Se você usar o Data Management (DMS) para realizar alterações DDL online no banco de dados de origem, poderá escolha se deseja sincronizar as tabelas temporárias geradas por essas alterações.
-
Yes: Sincroniza as tabelas temporárias geradas pelas alterações DDL online.
NotaSe as alterações DDL online gerarem um grande volume de dados em tabelas temporárias, a tarefa de sincronização poderá sofrer atrasos.
-
No: Não sincroniza as tabelas temporárias geradas pelas alterações DDL online. Apenas as operações DDL originais do banco de dados de origem são sincronizadas.
NotaEsta opção causa o bloqueio das tabelas no banco de dados de destino.
Retry Time for Failed Connections to Source and Destination Databases
Se o DTS não conseguir se conectar à instância de origem ou destino, ele tentará novamente por 720 minutos (12 horas) por padrão. Também é possível especifique uma duração personalizada de nova tentativa. Se o DTS reconectar à instância dentro do período especificado, a tarefa de sincronização será retomada automaticamente. Caso contrário, a tarefa falhará.
NotaO tempo de execução da tarefa durante as novas tentativas de conexão é faturado. Personalize a duração das tentativas conforme suas necessidades de negócio ou libere a instância DTS assim que as instâncias de origem e destino forem liberadas.
-
-
Após concluir as configurações anteriores, clique em Precheck and Start no canto inferior direito da página.
NotaAntes do início oficial da tarefa de sincronização, uma pré-verificação é executada. A tarefa só pode ser iniciada após a aprovação nessa etapa.
-
Se a pré-verificação falhar, clique em no ícone
 ao lado do item específico para visualize os detalhes da falha.
Siga as instruções para corrigir o problema e execute a pré-verificação novamente.
Caso não seja necessário corrigir os itens de aviso, selecione Ignore, Ignore Warning Items and Rerun Precheck para ignorar esses avisos e execute a pré-verificação novamente.
Quando Precheck Passed for exibido na caixa de diálogo Precheck, feche a caixa. A tarefa de sincronização será iniciada automaticamente.
-
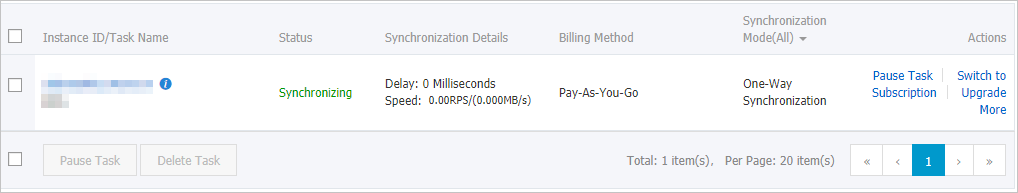
Aguarde até que o canal de sincronização seja inicializado e a tarefa entre no estado Synchronizing.
A página
Data Synchronization
exibe o status dos trabalhos de sincronização de dados.
Esquema da tabela de log incremental
Execute set odps.sql.allow.fullscan=true; no MaxCompute para defina as propriedades do projeto e permitir varreduras completas de tabela.
Ao sincronizar dados incrementais do MySQL para a tabela de log incremental no MaxCompute, o DTS armazena metadados além dos dados incrementais, conforme mostrado no exemplo a seguir.
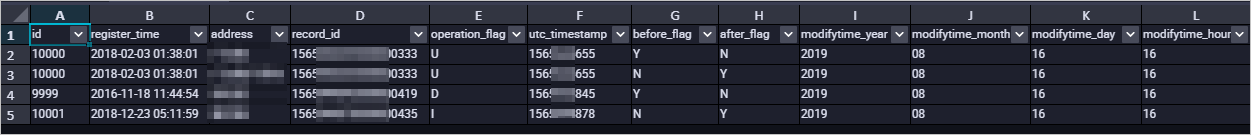
No exemplo, modifytime_year, modifytime_month, modifytime_day, modifytime_hour e modifytime_minute são campos de partição especificados na etapa Configure the synchronization policy and objects.
Definição do esquema
|
Campo |
Descrição |
|
record_id |
ID do registro do log incremental, que serve como identificador exclusivo do log. Nota
|
|
operation_flag |
Tipo de operação. Valores válidos:
|
|
utc_timestamp |
Timestamp da operação, correspondente ao timestamp do log binário (em UTC). |
|
before_flag |
Indica se todos os valores das colunas correspondem aos valores antes da atualização. Valores válidos: Y ou N. |
|
after_flag |
Indica se todos os valores das colunas correspondem aos valores após a atualização. Valores válidos: Y ou N. |
Informações adicionais sobre os campos before_flag e after_flag
Para diferentes tipos de operação, os campos before_flag e after_flag em um log incremental são definidos da seguinte forma:
-
INSERT
Quando o tipo de operação é INSERT, todos os valores das colunas correspondem aos valores do novo registro inserido. Estes são os valores após a atualização. Portanto, o valor de
before_flagé N e o valor deafter_flagé Y, conforme ilustrado no exemplo a seguir.
-
UPDATE
Quando o tipo de operação é UPDATE, o DTS divide a operação em dois registros de log incremental. Esses dois registros possuem os mesmos valores para
record_id,operation_flageutc_timestamp.O primeiro registro contém os valores anteriores à atualização, portanto
before_flagé Y eafter_flagé N. O segundo registro contém os valores posteriores à atualização, logobefore_flagé N eafter_flagé Y, como mostra o exemplo abaixo.
-
DELETE
Quando o tipo de operação é DELETE, todos os valores das colunas no registro de log incremental correspondem aos valores excluídos. Isso significa que os valores das colunas não mudam. Consequentemente, o valor de
before_flagé Y e o valor deafter_flagé N, conforme demonstrado no exemplo a seguir.
Exemplo de mesclagem de dados completos
Após a operação de sincronização de dados, o DTS crie uma tabela de linha de base completa e uma tabela de log incremental para cada tabela no MaxCompute. Use comandos SQL do MaxCompute para mesclar essas duas tabelas e obter os dados completos em um ponto específico no tempo.
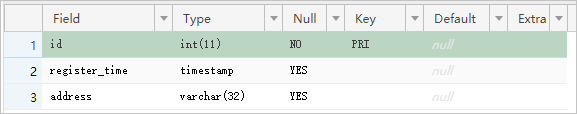
Este exemplo usa a tabela customer (com a estrutura a seguir) para descrever o procedimento.
-
Com base na estrutura da tabela a ser sincronizada no banco de dados de origem, crie uma tabela no MaxCompute para armazenar os resultados mesclados.
Por exemplo, para obter os dados completos da tabela
customerno timestamp1565944878, crie a seguinte tabela de dados para facilitar a identificação pelo negócio:CREATE TABLE `customer_1565944878` ( `id` bigint NULL, `register_time` datetime NULL, `address` string);NotaExecute comandos SQL no editor de consultas ad-hoc do MaxCompute.
Para mais informações sobre os tipos de dados com suporte no MaxCompute, consulte Data types.
-
Execute o seguinte comando SQL no MaxCompute para mesclar a tabela de linha de base completa e a tabela de log incremental, obtendo assim os dados completos da tabela em um ponto específico no tempo.
set odps.sql.allow.fullscan=true; insert overwrite table <result_storage_table> select <col1>, <col2>, <colN> from( select row_number() over(partition by t.<primary_key_column> order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, <col1>, <col2>, <colN> from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.<col1>, incr.<col2>,incr.<colN> from <table_log> incr where utc_timestamp< <timestamp> union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.<col1>, base.<col2>,base.<colN> from <table_base> base) t) gt where row_number=1 and after_flag='Y'Nota<result_storage_table>: Nome da tabela que armazena o conjunto de resultados completo mesclado.
<col1>/<col2>/<colN>: Nomes das colunas na tabela sincronizada.
<primary_key_column>: Nome da coluna de chave primária na tabela sincronizada.
<table_log>: Nome da tabela de log incremental.
<table_base>: Nome da tabela de linha de base completa.
<timestamp>: Ponto no tempo para o qual se deseja obter os dados completos.
Para mesclar as tabelas de dados e obter os dados completos da tabela
customerno timestamp1565944878, use o seguinte exemplo:set odps.sql.allow.fullscan=true; insert overwrite table customer_1565944878 select id, register_time, address from( select row_number() over(partition by t.id order by record_id desc, after_flag desc) as row_number, record_id, operation_flag, after_flag, id, register_time, address from( select incr.record_id, incr.operation_flag, incr.after_flag, incr.id, incr.register_time, incr.address from customer_log incr where utc_timestamp< 1565944878 union all select 0 as record_id, 'I' as operation_flag, 'Y' as after_flag, base.id, base.register_time, base.address from customer_base base) t) gt where gt.row_number= 1 and gt.after_flag= 'Y'; -
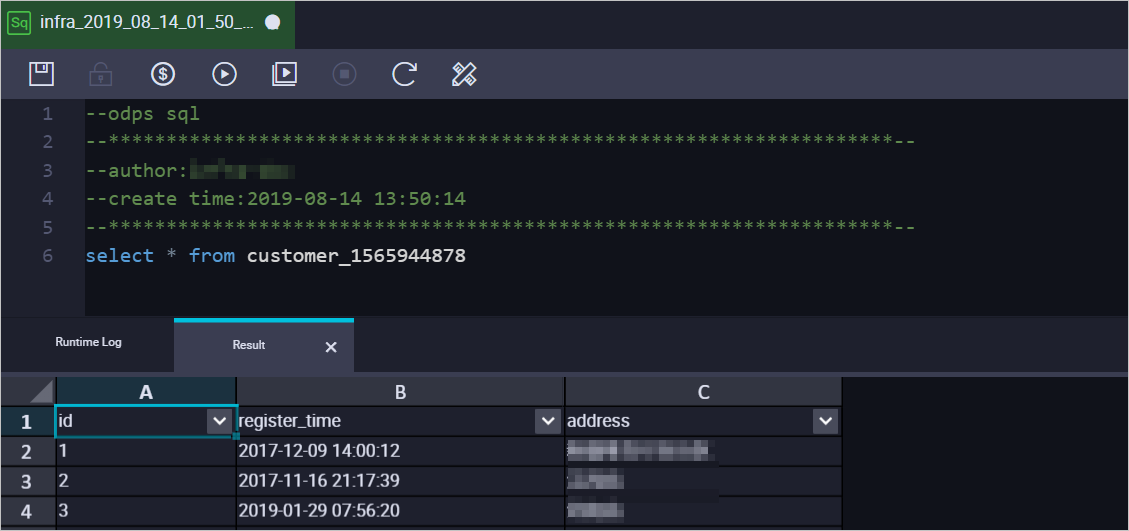
Após a execução do comando acima, visualize os dados mesclados na tabela
customer_1565944878.