Use o Data Transmission service (DTS) para sincronizar dados de um cluster do PolarDB for PostgreSQL para uma instância do ApsaraDB for SelectDB, voltada para análise de dados em grande escala. O DTS oferece suporte à sincronização de schema, sincronização completa de dados e sincronização incremental contínua de dados.
Pré-requisitos
Antes de começar, verifique se você tem:
Uma instância de destino do ApsaraDB for SelectDB com mais espaço em disco do que o espaço usado pelo cluster de origem do PolarDB for PostgreSQL. Para mais informações, consulte Create an instance.
O parâmetro
wal_leveldo cluster de origem do PolarDB for PostgreSQL definido comological. Para mais informações, consulte Set cluster parameters.
Faturamento
|
Tipo de sincronização |
Custo |
|
Sincronização de schema e sincronização completa de dados |
Gratuito |
|
Sincronização incremental de dados |
Cobrança aplicável. Para mais informações, consulte Visão geral do faturamento. |
Operações SQL compatíveis
|
Tipo de operação |
Instrução SQL |
|
DML |
INSERT, UPDATE, DELETE |
|
DDL |
ADD COLUMN, DROP COLUMN |
Permissões necessárias
|
Banco de dados |
Permissões necessárias |
Como conceder |
|
Cluster de origem do PolarDB for PostgreSQL |
Uma conta com privilégios de proprietário do banco de dados a ser sincronizado |
|
|
Instância de destino do ApsaraDB for SelectDB |
Permissões de acesso ao cluster (Usage_priv) e ao banco de dados (Select_priv, Load_priv, Alter_priv, Create_priv e Drop_priv) |
Limitações
Banco de dados de origem
Todas as tabelas a serem sincronizadas devem ter uma chave primária ou um índice único não nulo. Se os campos da tabela não forem únicos, poderão surgir dados duplicados no banco de dados de destino.
Para tabelas sem chave primária ou índice único não nulo: selecione Schema Synchronization para Synchronization Types e duplicate para Engine na etapa Configurations for Databases, Tables, and Columns.
Transações de longa duração no banco de dados de origem podem acumular logs de write-ahead logging (WAL) antes da confirmação, o que pode esgotar o espaço em disco do banco de dados de origem.
O cluster do PolarDB for PostgreSQL deve ser compatível com o Logical Replication Slot Failover e tê-lo habilitado. Se o cluster usar o PostgreSQL 14, que não oferece suporte ao Logical Replication Slot Failover, um failover de alta disponibilidade (HA) pode fazer com que a instância de sincronização falhe permanentemente e exija uma reconfiguração completa.
Se uma única alteração incremental exceder 256 MB, a instância de sincronização poderá falhar permanentemente. Reconfigure a instância de sincronização para recuperá-la.
Não execute operações DDL que alterem schemas durante a sincronização inicial de schema ou de dados completa. O DTS consulta o banco de dados de origem durante a sincronização inicial de dados completa. Essa consulta cria bloqueios de metadados que podem impedir as operações DDL.
Banco de dados de destino
Requisitos do modelo de dados do SelectDB
O DTS sincroniza dados apenas para tabelas que usam o modelo Unique Key ou Duplicate key no ApsaraDB for SelectDB. Portanto, escolha o modelo conforme os seus requisitos:
|
Requisito |
Modelo recomendado |
Observações |
|
Registros consistentes e deduplicados |
Modelo Unique Key |
Todas as chaves únicas da tabela de destino devem existir na tabela de origem e no objeto de sincronização. A falta de chaves causa inconsistência de dados. |
|
Ingestão apenas de anexação (append-only) ou de alta taxa de transferência |
Modelo Duplicate key |
Dados duplicados podem surgir em caso de nova tentativa ou se duas ou mais operações DML forem executadas na mesma linha após o início da instância de sincronização. Use as colunas |
Restrições de objetos e nomenclatura
Você pode especificar apenas o parâmetro
bucket_countna seção Selected Objects. O valor deve ser um número inteiro positivo. Valor padrão: auto.O ApsaraDB for SelectDB é compatível apenas com nomes de bancos de dados e tabelas que começam com uma letra. Use o mapeamento de nomes de objetos para renomear os que não começam com letra.
Renomeie nomes de objetos (bancos de dados, tabelas ou colunas) que contenham caracteres chineses por meio do mapeamento de nomes de objetos.
Cada instância de sincronização pode sincronizar apenas um banco de dados. Para sincronizar vários, configure uma instância separada para cada um.
Escopo de sincronização e limites de DDL
O DTS não oferece suporte à sincronização de tabelas de extensão do TimescaleDB nem de tabelas com herança entre schemas.
Não modifique operações DDL em várias colunas ao mesmo tempo nem na mesma tabela de forma consecutiva.
Em cenários de mesclagem de várias tabelas (várias tabelas de origem para uma única de destino), os schemas de todas as tabelas de origem devem ser idênticos. Caso contrário, podem ocorrer inconsistências de dados ou falha na tarefa.
Tabelas particionadas
Ao sincronizar tabelas particionadas, inclua a tabela pai e todas as suas partições filhas como objetos de sincronização. A tabela pai de uma tabela particionada do PostgreSQL não armazena dados diretamente; todos os dados estão nas partições filhas. Omitir partições causa inconsistência de dados.
Requisito de REPLICA IDENTITY
Execute o seguinte comando nas tabelas antes de gravar dados nestes três cenários: na primeira execução da instância; ao selecionar objetos no nível de schema e criar ou reconstruir uma nova tabela com RENAME; e ao usar o recurso para modificar objetos de sincronização.
ALTER TABLE schema.table REPLICA IDENTITY FULL;Substitua schema e table pelos nomes reais do schema e da tabela. Execute este comando fora dos horários de pico e não realize operações de bloqueio de tabela durante a execução. Se você ignorar a pré-verificação relacionada, o DTS executará o comando automaticamente durante a inicialização da instância.
Operações que causam falha na tarefa
As operações a seguir causam falha na tarefa de sincronização. Reinicie a instância para retomar:
Adicionar nós de back-end ao banco de dados de destino do ApsaraDB for SelectDB durante a sincronização
Criar clusters na instância de destino do ApsaraDB for SelectDB durante a sincronização
Tabelas temporárias
O DTS cria as seguintes tabelas temporárias no banco de dados de origem para dar suporte à sincronização incremental. Não as exclua durante a sincronização, pois são removidas automaticamente após a liberação da instância do DTS:
public.dts_pg_class, public.dts_pg_attribute, public.dts_pg_type, public.dts_pg_enum, public.dts_postgres_heartbeat, public.dts_ddl_command, public.dts_args_session e public.aliyun_dts_instance.
Slot de replicação
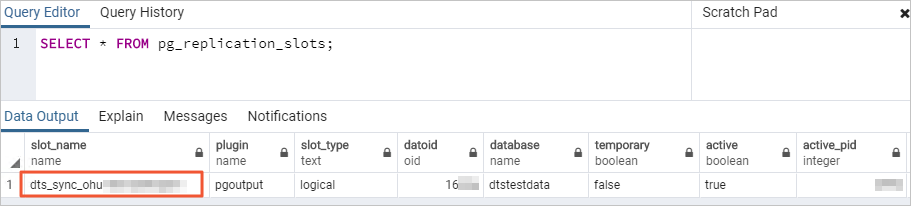
O DTS cria um slot de replicação com o prefixo dts_sync_ no banco de dados de origem. Esse slot retém logs incrementais dos últimos 15 minutos. Quando a tarefa de sincronização falha ou a instância é liberada, o DTS tenta limpar o slot automaticamente.
Se você alterar a senha da conta do banco de dados de origem ou remover a lista de permissões de IP do DTS durante a sincronização, o slot de replicação não será limpo automaticamente. Limpe-o manualmente para evitar que o espaço em disco se esgote. Se ocorrer um failover primário/secundário, acesse o banco de dados secundário para fazer a limpeza.
Incremental synchronization latency
O DTS usa uma política de sincronização em lote para reduzir a carga no destino. Por padrão, o DTS grava dados no máximo uma vez a cada 5 segundos por objeto de sincronização, resultando em uma latência normal de até 10 segundos. Para reduzir essa latência, atualize o parâmetro selectdb.reservoir.timeout.milliseconds da instância do DTS no console. O intervalo válido é de 1.000 a 10.000 milissegundos.
Um tempo de lote menor aumenta a frequência de gravação, o que pode elevar a carga e o tempo de resposta de gravação do destino e, consequentemente, aumentar a latência de sincronização do DTS. Ajuste o tempo de lote com base na carga do destino.
Outras observações
O DTS não verifica a validade de metadados, como sequências. Verifique a validade dos metadados manualmente antes e depois da sincronização.
Execute a sincronização completa de dados quando a carga de CPU dos bancos de dados de origem e de destino estiver abaixo de 30%.
Se uma instância falhar, a equipe de suporte do DTS tentará recuperá-la em até 8 horas. Durante a recuperação, apenas os parâmetros da instância do DTS podem ser modificados; os parâmetros do banco de dados não são alterados. Para visualize os parâmetros modificáveis consultando Modify instance parameters.
Criar uma tarefa de sincronização
Etapa 1: Acessar a página Data Synchronization
Use um dos consoles a seguir.
Console do DTS
Faça login no console do DTS.
No painel de navegação à esquerda, clique em Data Synchronization.
No canto superior esquerdo da página, selecione a região onde a tarefa de sincronização está localizada.
Console do DMS
Nota
As operações reais podem variar conforme o modo e o layout do console do DMS. Para mais informações, consulte Modo simples e Personalizar o layout e o estilo do console do DMS.
Faça login no console do DMS.
Na barra de navegação superior, passe o ponteiro sobre Data + AI e escolha DTS (DTS) > Data Synchronization.
Na lista suspensa à direita de Data Synchronization Tasks, selecione a região onde a instância de sincronização está localizada.
Etapa 2: Configurar os bancos de dados de origem e de destino
Clique em Create Task para acessar a página de configuração da tarefa.
-
Configure os bancos de dados de origem e de destino com os seguintes parâmetros.
Categoria
Parâmetro
Descrição
Nenhuma
Task Name
O nome da tarefa. O DTS gera um nome automaticamente. Para facilitar a identificação, especifique um nome descritivo. Não é necessário que seja exclusivo.
Source Database
Select Existing Connection
Se você registrou a instância do banco de dados no DTS, selecione-a na lista suspensa. O DTS preenche os parâmetros automaticamente. Caso contrário, configure os parâmetros a seguir manualmente.
Database Type
Selecione PolarDB for PostgreSQL.
Access Method
Selecione Alibaba Cloud Instance.
Instance Region
Selecione a região onde o cluster de origem do PolarDB for PostgreSQL está localizado.
Replicate Data Across Alibaba Cloud Accounts
Selecione No se os bancos de dados de origem e de destino pertencerem à mesma conta da Alibaba Cloud.
Instance ID
Selecione o ID do cluster de origem do PolarDB for PostgreSQL.
Database Name
Insira o nome do banco de dados que contém os objetos a serem sincronizados.
Database Account
Insira a conta do banco de dados. Para ver os requisitos de permissão, consulte Required permissions.
Database Password
Insira a senha da conta do banco de dados.
Destination Database
Select Existing Connection
Se você registrou a instância do banco de dados no DTS, selecione-a na lista suspensa. O DTS preenche os parâmetros automaticamente. Caso contrário, configure os parâmetros a seguir manualmente.
Database Type
Selecione SelectDB.
Access Method
Selecione Alibaba Cloud Instance.
Instance Region
Selecione a região onde a instância de destino do SelectDB está localizada.
Replicate Data Across Alibaba Cloud Accounts
Selecione No se os bancos de dados de origem e de destino pertencerem à mesma conta da Alibaba Cloud.
Instance ID
Selecione o ID da instância de destino do SelectDB.
Database Account
Insira a conta do banco de dados. Para ver os requisitos de permissão, consulte Required permissions.
Database Password
Insira a senha da conta do banco de dados.
-
Clique em Test Connectivity and Proceed.
Certifique-se de que os blocos CIDR dos servidores do DTS estejam adicionados às configurações de segurança dos bancos de dados de origem e de destino. Para mais informações, consulte Adicionar endereços IP do servidor DTS a uma lista de permissões .
Etapa 3: Configurar objetos de sincronização
-
Na etapa Configure Objects, configure os parâmetros de sincronização.
Parâmetro Descrição Synchronization Types Por padrão, Incremental Data Synchronization vem selecionado. Selecione também Schema Synchronization e Full Data Synchronization. Após a conclusão da pré-verificação, o DTS sincroniza os dados históricos como base para a sincronização incremental contínua. ImportanteAo sincronizar do PolarDB for PostgreSQL para o SelectDB, há conversão de tipos de dados. Se você não selecionar Schema Synchronization, crie as tabelas de destino manualmente com o modelo Unique ou Duplicate correspondente. Para mais informações, consulte Data type mapping, Additional column information e Data model.
Processing Mode of Conflicting Tables Precheck and Report Errors: O DTS verifica se há tabelas com o mesmo nome no banco de dados de destino. Se houver uma tabela duplicada, a pré-verificação falha e a tarefa não inicia. NotaSe não for possível excluir ou renomear a tabela duplicada, use o mapeamento de nomes de objetos. Para mais informações, consulte Mapear nomes de schema, tabela e coluna. Ignore Errors and Proceed: O DTS ignora a verificação de nomes de tabelas duplicadas.
AvisoEsta opção pode causar inconsistência de dados. Se os schemas das tabelas forem iguais e um registro tiver uma chave primária ou única correspondente, o registro de origem sobrescreverá o de destino. Se os schemas forem diferentes, a inicialização poderá falhar ou apenas algumas colunas serão sincronizadas.
Capitalization of Object Names in Destination Instance A política de uso de maiúsculas e minúsculas para nomes de bancos de dados, tabelas e colunas na instância de destino. Padrão: DTS default policy. Para mais informações, consulte Especificar o uso de maiúsculas e minúsculas em nomes de objetos na instância de destino. Source Objects Selecione um ou mais objetos e clique no ícone  para movê-los para Selected Objects. É possível selecionar objetos no nível de schema, tabela ou coluna.
Selected Objects - Para renomear um objeto de destino ou especificar um objeto receptor, clique com o botão direito nele na seção Selected Objects. Para mais informações, consulte Mapear nomes de objetos. - Para remover um objeto selecionado, clique nele e, em seguida, no ícone  . - Para definir o parâmetro
bucket_countde uma tabela (disponível apenas quando Schema Synchronization estiver selecionado e os objetos forem selecionados no nível de tabela): clique com o botão direito na tabela, defina Enable Parameter Settings como Yesconfigurações de notificação de alerta, insira o valor e clique em OK.NotaRenomear um objeto com o mapeamento de nomes de objetos pode causar falha na sincronização de objetos dependentes. Para filtrar dados com condições WHERE, clique com o botão direito em uma tabela e especifique as condições. Para mais informações, consulte Especificar condições de filtro. Para selecionar operações SQL para sincronização incremental, clique com o botão direito em um objeto e selecione as operações.
-
Clique em Next: Advanced Settings e configure os parâmetros a seguir.
Parâmetro Descrição Dedicated Cluster for Task Scheduling Por padrão, o DTS agenda a tarefa no cluster compartilhado. Para melhorar a estabilidade, adquira um cluster dedicado. Para mais informações, consulte O que é um cluster dedicado do DTS. Retry Time for Failed Connections O intervalo de tempo para tentar novamente conexões com falha. Valores válidos: 10 a 1440 minutos. Padrão: 720 minutos. Defina como mais de 30 minutos. Se o DTS se reconectar dentro dessa janela, a tarefa será retomada. Caso contrário, a tarefa falhará. NotaSe várias tarefas compartilharem o mesmo banco de dados de origem ou de destino e tiverem janelas de nova tentativa diferentes, a janela mais curta terá precedência. O DTS cobra pela instância durante as novas tentativas.
Retry Time for Other Issues O intervalo de tempo para tentar novamente operações DDL ou DML com falha. Valores válidos: 1 a 1440 minutos. Padrão: 10 minutos. Defina como mais de 10 minutos. Este valor deve ser menor que Retry Time for Failed Connections. Enable Throttling for Full Data Synchronization Limite a sincronização completa de dados para reduzir a carga na origem e no destino. Configure Queries per second (QPS) to the source database, RPS of Full Data Migration e Data migration speed for full migration (MB/s). Disponível apenas quando Full Data Synchronization estiver selecionado. Enable Throttling for Incremental Data Synchronization Limite a sincronização incremental de dados ao configurar RPS of Incremental Data Synchronization e Data synchronization speed for incremental synchronization (MB/s). Environment Tag Uma tag opcional para identificar a instância. Configure ETL Especifique se deseja ativar o recurso de extração, transformação e carga (ETL). Selecione Yes para inserir instruções de processamento de dados no editor de código. Para mais informações, consulte Configurar ETL em uma tarefa de migração ou sincronização de dados. Selecione No para ignorar a configuração de ETL. Monitoring and Alerting Especifique se deseja configurar alertas. Selecione Yes para configurar o limiar de alerta e as notificações. Para mais informações, consulte a seção Configurar monitoramento e alertas ao criar uma tarefa do DTS. -
(Opcional) Clique em Next: Configure Database and Table Fields para definir a Primary Key Column, a Distribution Key e o Engine das tabelas de destino.
- Esta etapa fica disponível apenas quando Schema Synchronization está selecionado para Synchronization Types . Defina Definition Status como All para fazer modificações. - É possível selecionar várias colunas como chave primária composta. Pelo menos uma coluna em Primary Key Column também deve ser selecionada como Distribution Key . - Para tabelas sem chave primária ou restrição UNIQUE, defina Engine como duplicate . Caso contrário, a sincronização poderá falhar ou haver perda de dados.
Etapa 4: Executar a pré-verificação
-
Clique em Next: Save Task Settings and Precheck para que o sistema salve as configurações. O DTS executa uma pré-verificação antes de iniciar a tarefa de sincronização. A tarefa só inicia após a aprovação na pré-verificação.
visualize os parâmetros da API desta configuração passando o ponteiro sobre Next: Save Task Settings and Precheck e clique em Preview OpenAPI parameters .
Se a pré-verificação falhar, clique em View Details ao lado de cada item com falha, solucione o problema e execute a pré-verificação novamente.
-
Se um alerta for acionado:
Se o alerta não puder ser ignorado, clique em View Details, corrija o problema e execute a pré-verificação novamente.
Se for possível ignorar o alerta, clique em Confirm Alert Details, confirme os detalhes do alerta e clique em Ignore na caixa de diálogo View Details, clique em OK e, em seguida, em Precheck Again.
Ignorar alertas pode causar inconsistência de dados e expor o seu negócio a riscos.
Etapa 5: Adquirir a instância
Aguarde até que a Success Rate atinja 100% e, em seguida, clique em Next: Purchase Instance.
-
Na página buy, configure os parâmetros a seguir.
Parâmetro
Descrição
Billing Method
Subscription: Pagamento antecipado por uma duração fixa. Mais econômico para uso a longo prazo. Pay-as-you-go: Faturamento por hora. Adequado para uso a curto prazo. Libere a instância quando não for mais necessária para reduzir custos.
Resource Group Settings
O grupo de recursos da instância de sincronização. Padrão: default resource group. Para mais informações, consulte What is Resource Management?
Instance Class
A camada de velocidade de sincronização. Selecione com base nos requisitos do seu negócio. Para mais informações, consulte Classes de instâncias de sincronização de dados.
Subscription Duration
Disponível apenas para o método de faturamento por assinatura. Opções: 1 a 9 meses, 1 ano, 2 anos, 3 anos ou 5 anos.
Leia e selecione Data Transmission Service (Pay-as-you-go) Service Terms.
Clique em Buy and Start. Na caixa de diálogo que aparece, clique em OK.
A tarefa aparece na lista de tarefas. Monitore o progresso por lá.
Mapeamento de tipos de dados
A tabela a seguir mostra o mapeamento dos tipos de dados do PolarDB for PostgreSQL para os tipos de dados do SelectDB.
| Categoria | Tipo de dados do PolarDB for PostgreSQL | Tipo de dados do SelectDB |
|---|---|---|
| Numérico | SMALLINT | SMALLINT |
| INTEGER | INT | |
| BIGINT | BIGINT | |
| DECIMAL | DECIMAL | |
| NUMERIC | DECIMAL | |
| REAL | DOUBLE | |
| DOUBLE | DOUBLE | |
| SMALLSERIAL | SMALLINT | |
| SERIAL | INT | |
| BIGSERIAL | BIGINT | |
| Monetário | MONEY | STRING |
| Caractere | CHAR(n), VARCHAR(n) | VARCHAR. Importante
Para evitar perda de dados, CHAR(n) e VARCHAR(n) são convertidos para VARCHAR(4\*n). Se nenhum comprimento for especificado, será usado o padrão do SelectDB VARCHAR(65533). Se o comprimento exceder 65533, os dados serão convertidos para STRING. |
| TEXT | STRING | |
| Binário | BYTEA | STRING |
| Data e hora | TIMESTAMP [(P)] [WITHOUT TIME ZONE] | DATETIMEV2 |
| TIMESTAMP [(P)] WITH TIME ZONE | DATETIMEV2 | |
| DATE | DATEV2 | |
| TIME [(P)] [WITHOUT TIME ZONE] | VARCHAR(50) | |
| TIME [(P)] WITH TIME ZONE | VARCHAR(50) | |
| INTERVAL [FIELDS] [(P)] | STRING | |
| Booleano | BOOLEAN | BOOLEAN |
| Geométrico | POINT, LINE, LSEG, BOX, PATH, POLYGON, CIRCLE | STRING |
| Endereço de rede | CIDR, INET, MACADDR, MACADDR8 | STRING |
| Pesquisa de texto | TSVECTOR | STRING |
| XML | XML | STRING |
| JSON | JSON | JSON |
Informações adicionais da coluna
Para tabelas que usam o modelo Duplicate key, o DTS adiciona automaticamente ou exige as colunas a seguir na tabela de destino.
|
Nome da coluna |
Tipo de dados |
Valor padrão |
Descrição |
|
|
Int |
0 |
Sinalizador de exclusão. Insert: 0. Update: 0. Delete: 1. |
|
|
Bigint |
0 |
Sincronização completa de dados: 0. Sincronização incremental de dados: o carimbo de data e hora correspondente em segundos do log binário do banco de dados de origem. |
|
|
Bigint |
0 |
Sincronização completa de dados: 0. Sincronização incremental de dados: o ID do registro do log incremental, que identifica a entrada de log de forma exclusiva. O valor é único e incremental. |