Este tópico resume problemas comuns de monitoramento no AnalyticDB for MySQL e apresenta as respectivas soluções.
Salvo indicação em contrário, as soluções descritas neste tópico aplicam-se apenas às edições AnalyticDB for MySQL Data Warehouse Edition e Enterprise Edition.
Visão geral das perguntas frequentes
Monitorar o uso de disco no modo reservado
Configure o monitoramento e os alertas para evitar que o uso de disco ultrapasse o limiar de segurança. Essa configuração garante notificações tempestivas para gerenciar o espaço em disco e manter a estabilidade do serviço.
Não é necessário configurar alertas de monitoramento de disco para clusters das edições Enterprise Edition, Basic Edition ou Data Lakehouse Edition.
Faça login no console do AnalyticDB for MySQL. No canto superior esquerdo do console, selecione uma região. No painel de navegação à esquerda, clique em Clusters. Localize o cluster desejado e clique no ID do cluster.
No painel de navegação à esquerda, clique em Monitoring and Alerting.
-
Na página Monitoring Information, clique na aba Query and Write para visualizar o uso de disco.
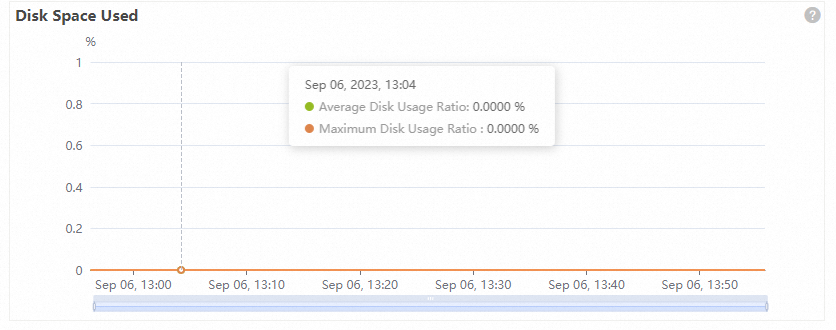
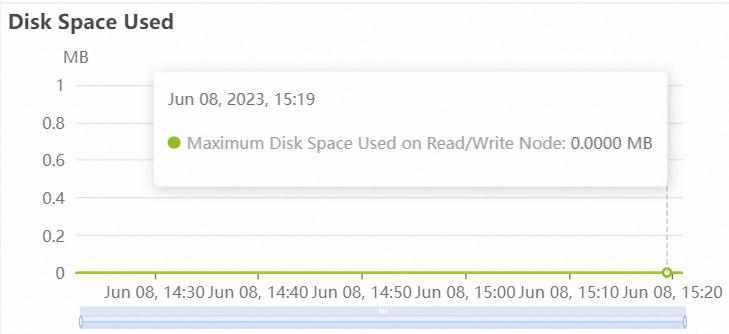
No modo reservado, o uso de disco é exibido como porcentagem. Já no modo elástico, o sistema mostra o uso absoluto de disco dos nós de leitura e gravação.
-
Modo reservado
 Nota
O uso máximo de disco corresponde ao maior valor entre todos os nós do cluster. Se esse índice atingir 90% ou mais, as operações de gravação serão bloqueadas. Monitore essa métrica com atenção.
-
Modo elástico
 Nota
O uso de disco refere-se ao consumo máximo de um único nó de leitura e gravação. Caso esse valor atinja 8 TB ou mais, não será possível gravar dados no cluster. Acompanhe essa métrica de perto.
-
Na página Monitoring Information, clique em Alert Rule Settings.
Na página Alert Rules, clique em Create Alert Rules.
-
Na página Create Alert Rule, configure os parâmetros.
Parâmetro
Descrição
Resource Range
Escopo da regra de alerta. Valores válidos:
-
All Resources: Aplica a regra a todas as instâncias de um product na sua conta. Por exemplo, ao definir um alerta para disparar quando o uso de disco do AnalyticDB for MySQL for maior ou igual a 80%, a regra abrangerá todas as instâncias do AnalyticDB for MySQL. Quando o Resource Range está definido como All Resources, os alertas podem ser acionados para no máximo 1.000 recursos. Se a quantidade exceder esse limite, os alertas poderão não disparar mesmo que o limiar seja atingido. Recomendamos usar grupos de aplicativos para organizar os recursos por negócio antes de configurar os alertas.
-
Application Group: A regra de alerta aplica-se a todos os recursos dentro de um grupo de aplicativos especificado para o product.
-
Instance: A regra restringe-se a instâncias específicas do product. Por exemplo, se você definir um alerta no nível da instância para uso de disco maior ou igual a 80%, uma notificação será enviada somente quando o uso de disco daquela instância específica atingir ou superar o limiar.
Rule Description
Condições que disparam o alerta. Para configurar a descrição da regra:
-
Clique em Add Rule.
-
No painel Add Rule Description, defina parâmetros como Rule Name, Metric Type, Monitoring Metric, Threshold and Alert Level e Chart Preview.
-
Clique em OK.
Mute Period
Intervalo entre notificações repetidas para um alerta não resolvido. Valores válidos: 5 minutos, 15 minutos, 30 minutos, 60 minutos, 3 horas, 6 horas, 12 horas e 24 horas. Quando uma métrica atinge o limiar de alerta, o sistema envia uma notificação. Se a métrica continuar acima do limiar durante o período de silêncio, nenhuma notificação repetida será enviada. Caso a condição persista após o término desse período, o CloudMonitor enviará outra notificação de alerta.
Effective Time
Período em que a regra de alerta permanece ativa.
ImportantePara alertas de uso de disco, cada contato de alerta recebe no máximo quatro notificações por dia. Alertas subsequentes são silenciados.
Alert Contact Group
Grupo de contatos que recebe as notificações de alerta.
As notificações para grupos de aplicativos são enviadas aos contatos deste grupo de alertas. Um grupo pode conter um ou mais contatos de alerta. Para saber como criar contatos e grupos de contatos de alerta, consulte Criar um contato de alerta ou um grupo de contatos de alerta.
Alert Callback
URL acessível publicamente. O CloudMonitor envia informações de alerta para essa URL por meio de requisições POST. Apenas o protocolo HTTP é suportado. Para obter detalhes sobre como configurar um callback de alerta, consulte Usar callbacks de alerta baseados em limiar.
NotaClique em Advanced Settings para configurar este parâmetro.
Auto Scaling
Ao ativar o Auto Scaling, a regra de dimensionamento correspondente é acionada quando ocorre um alerta. É necessário especificar a Region, o ESS Group e a ESS Rule para o Auto Scaling.
-
Para saber como criar um grupo de dimensionamento, consulte Configurar um grupo de dimensionamento.
-
Para saber como criar uma regra de dimensionamento, consulte Configurar uma regra de dimensionamento.
NotaClique em Advanced Settings para configurar este parâmetro.
Simple Log Service
Se você ativar o Simple Log Service, as informações de alerta serão gravadas no Log Service quando um alerta ocorrer. É preciso especificar a Region, o Project e o Logstore para o Log Service.
Para obter informações sobre como criar um Project e um Logstore, consulte Coletar e analisar logs de texto do ECS usando o LoongCollector.
NotaClique em Advanced Settings para configurar este parâmetro.
Simple Message Queue (formerly MNS) - Topic
Ao ativar o Simple Message Queue (formerly MNS) - Topic, as informações de alerta são enviadas para um tópico especificado no Message Service. Você deve definir a região e o tópico para o Message Service.
Para saber como criar um tópico, consulte Criar um tópico.
Method for handling alerts when no monitoring data is available
Ação a ser executada quando não houver dados de monitoramento disponíveis para uma regra de alerta. Valores válidos:
-
Do not do anything (padrão)
-
Send alert notifications
-
Consider as recovered
NotaClique em Advanced Settings para configurar este parâmetro.
Tag
Adiciona pares chave-valor personalizados como tags ao conteúdo do alerta.
-
Após configurar os parâmetros, clique em OK.
Visualizar armazenamento de dados quentes e frios
Faça login no console do AnalyticDB for MySQL. Na página Monitoring Information, visualize o Hot Data Space Used e o Cold Data Space Used.
Verificar o tamanho da tabela
Acesse o console do AnalyticDB for MySQL. Na página Monitoring Information do seu cluster, clique na aba Table Information Statistics para consultar informações como o tamanho da tabela.
Uso de dados quentes versus uso total de disco
Um cluster AnalyticDB for MySQL contém vários nós de armazenamento. O uso de disco representa o consumo máximo de um único nó de leitura e gravação, enquanto o uso de dados quentes corresponde à soma do uso de disco em todos os nós de leitura e gravação.
Aumento da utilização da CPU no modo elástico
Ao alterar um cluster C32 do modo reservado para o modo elástico, a contagem de núcleos de um único nó é reduzida para 8. Por padrão, uma tarefa BUILD ocupa 3 núcleos, o que eleva a utilização média da CPU. Se esse aumento não afetar seus serviços, nenhuma ação é necessária. Caso seus serviços sejam impactados, aumente a escala do cluster ou Envie um ticket para entrar em contato com o suporte técnico. Para mais informações sobre tarefas BUILD, consulte BUILD.
Discrepância no tempo de resposta da consulta
O tempo de resposta da consulta na página Monitoring Information e a duração total na página Diagnostics and Optimization são calculados de formas diferentes. O tempo de resposta na página Monitoring Information inclui também o tempo de cache do conjunto de resultados. Portanto, se uma consulta retornar um grande volume de dados que exija armazenamento em cache, o tempo de resposta exibido em Monitoring Information será maior que a duração total mostrada em Diagnostics and Optimization. Utilize a página SQL Audit para identificar instruções SQL com tempos de resposta longos.
As informações a seguir descrevem como o tempo consumido por uma instrução SQL é calculado:
Depois que uma instrução SQL é enviada ao AnalyticDB for MySQL, ela é colocada em uma fila. Se a concorrência de consultas for alta, isso pode resultar em um longo tempo de espera. Após sair da fila, a instrução entra no mecanismo de execução, que analisa a consulta e gera um plano de execução; esse processo constitui o tempo do plano de execução. Uma vez gerado o plano, as subtarefas são executadas nos nós de armazenamento e computação, o que compõe o tempo de execução. Ao final da consulta, se o conjunto de resultados for grande, o nó de frontend armazena os resultados em cache, caracterizando o tempo de cache do conjunto de resultados. A figura a seguir ilustra a divisão do tempo de uma instrução SQL: