Todo service e experimento no PAI-Rec deve estar associado a um cenário de recomendação. Os cenários mapeiam posições na sua plataforma a um conjunto de labs, camadas de experimento, grupos de experimento e experimentos.
Cenário de recomendação
Um cenário de recomendação vincula uma posição específica na sua plataforma — como recomendações em cascata na home, sugestões "você também pode gostar" no carrinho ou itens relacionados na página de detalhes de um product — a um conjunto de services e experimentos de recomendação.
Nomeie cada cenário conforme sua localização na página para facilitar a identificação visual. Por exemplo, o nome "recomendações em cascata na home" indica tanto o padrão de UI ("cascata") quanto a posição ("home").
Traffic Code
O campo Traffic Code controla a divisão das solicitações de recomendação entre os sistemas. Utilize-o ao executar o PAI-Rec com um sistema de recomendação autogerenciado ou de terceiros.
|
Valor do Traffic Code |
Destino do tráfego |
|
|
Sistema PAI-Rec |
|
|
Seu sistema de recomendação autogerenciado |
|
|
Um sistema de recomendação de terceiros |
No cenário HomePageRec, por exemplo, o tráfego é direcionado ao PAI-Rec por padrão. Para migrar o tráfego gradualmente, comece direcionando de 10% a 20% do tráfego do cenário para o PAI-Rec. Após o PAI-Rec atingir os resultados esperados, aumente essa proporção.
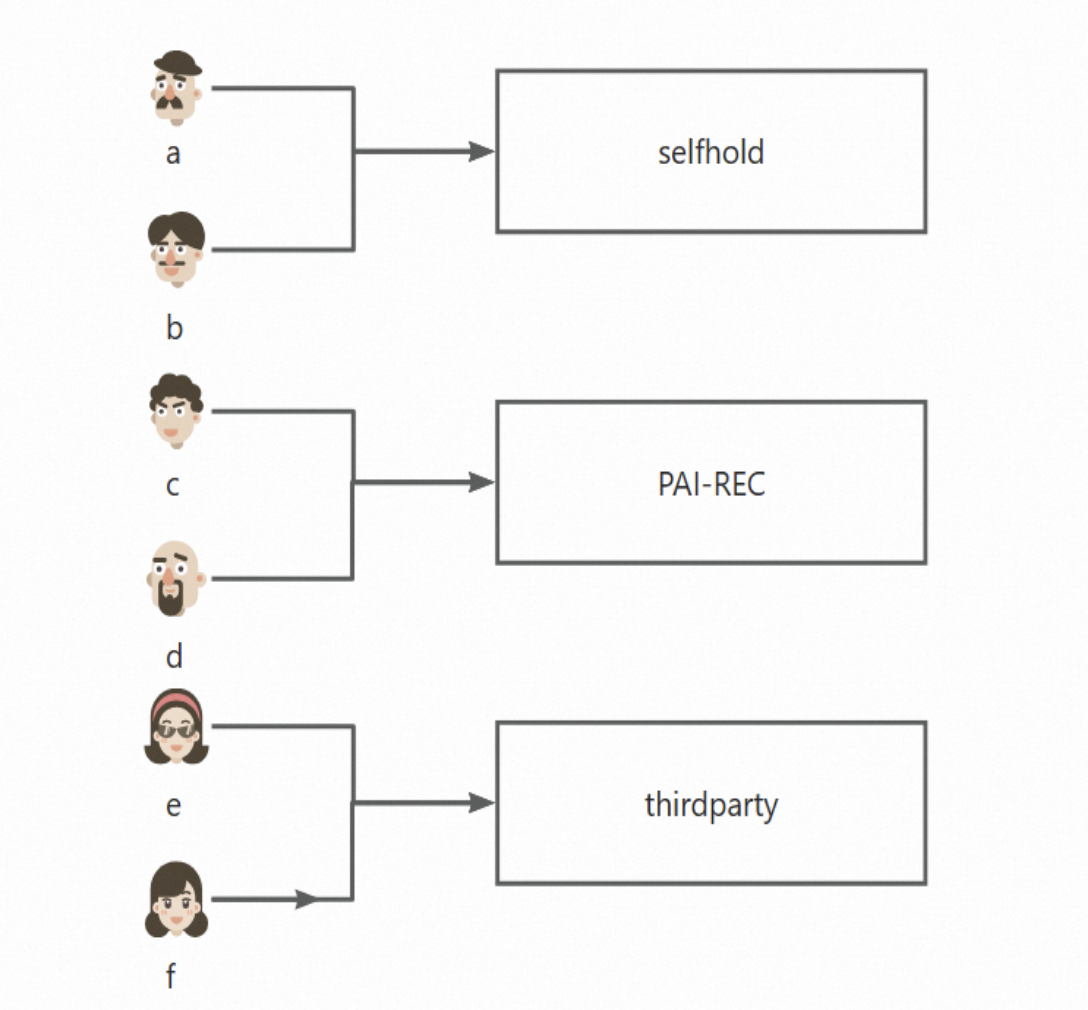
A figura a seguir ilustra a alocação de tráfego para seis usuários. Os usuários a e b recebem resultados do sistema autogerenciado (selfhold), os usuários c e d do PAI-Rec (PAI-REC) e os usuários e e f de um sistema de terceiros (thirdparty).
Lab e camada de experimento
O PAI-Rec organiza os testes A/B em uma hierarquia de quatro níveis:
Lab
└── Experiment layer
    └── Experiment group
        └── Experiment
Lab
Um lab é uma coleção de tráfego. O PAI-Rec encaminha as solicitações de recomendação recebidas para os labs antes de corresponder a qualquer experimento.
Todo cenário exige pelo menos um lab base. O tráfego corresponde primeiro aos labs não base; caso nenhum lab não base corresponda, a solicitação retorna ao lab base. Se você criar apenas um lab, use-o como lab base para fallback. Configure o lab base com lógica simples de recall e ranking para garantir estabilidade durante picos de tráfego. Também é possível implementar o lab base com lógica de fallback popular e aleatória.
Os labs não base contêm sua lógica principal e mais complexa de recall e ranking. Crie vários labs não base quando precisar testar diferentes estratégias de algoritmo em paralelo.
A tabela a seguir apresenta os campos de configuração de um lab base.
|
Campo |
Descrição |
|
Lab Name |
Nome personalizado para o lab. |
|
Description |
Descrição detalhada do lab. |
|
Lab Type |
Base Lab (obrigatório) ou Non-base Lab (opcional). |
|
Runtime Environment |
Ambiente de execução do mecanismo de recomendação. Valores válidos: |
|
Bucketing Method |
Forma como o PAI-Rec atribui usuários aos buckets. Consulte Método de bucketing abaixo. |
|
Buckets |
Número total de buckets neste lab (por exemplo, 100). |
|
Traffic Allocation |
Números dos buckets atribuídos a este lab. Intervalo válido: 0–99. |
|
Layering |
Camada de experimento dentro deste lab. Valores comuns: |
|
Test Users |
Usuários cujo tráfego é roteado diretamente para este lab, ignorando a correspondência de buckets. |
O campo Test Users aceita dois métodos de entrada:
Manually Enter: Insira um ou mais IDs de usuário separados por vírgulas.
User Group ID: Selecione um grupo de usuários criado na página User Group Management.
Método de bucketing
O PAI-Rec oferece três formas de atribuir usuários aos buckets:
|
Método |
Funcionamento |
|
UID-based Bucketing |
Atribui usuários com base nos últimos dígitos de seus UIDs. |
|
Hashed UID-based Bucketing |
Utiliza os valores de hash dos UIDs dos usuários para a atribuição. |
|
Condition-based Bucketing |
Baseia-se em uma expressão chave-valor, como |
Camada de experimento
Uma camada de experimento é um agrupamento lógico dentro de um lab. Cada lab pode conter várias camadas de experimento. Nomes comuns de camada incluem recall, filter, coarse_rank e rank.
Grupo de experimento e experimento
Grupo de experimento
Um grupo de experimento é uma subdivisão de uma camada de experimento. Crie vários grupos de experimento dentro de uma camada quando múltiplos engenheiros de algoritmo precisarem executar experimentos de recall ou ranking de forma independente.
Experimento
Um experimento representa uma única variação de algoritmo ou configuração dentro de um grupo de experimento.
Geralmente, um grupo de experimento contém vários experimentos executados simultaneamente. Na configuração abaixo, por exemplo, dssm está em teste com proporção de tráfego defina como 0% e estado defina como online, o que ajuda a obter efeitos de recomendação usando a lista de permissões configurada.
O grupo de experimento chama-se Recall Group, onde swing e etrec possuem 50% de alocação de tráfego cada, etrec é o experimento base e swing e dssm são experimentos regulares.