Configure um sistema de arquivos NAS como PV e PVC compartilhados no cluster ACK para armazenar dados de treinamento do Arena.
Antes de começar
Verifique se você tem:
Um cluster ACK em execução
Permissões para criar sistemas de arquivos NAS e gerenciar recursos de armazenamento do ACK
Uma instância do Elastic Compute Service (ECS) na mesma Virtual Private Cloud (VPC) do cluster ACK, para montar e popular o sistema de arquivos NAS
Observações de uso
Observe as seguintes restrições:
Cobertura VPC obrigatória. O sistema de arquivos NAS, seu ponto de montagem e o cluster ACK devem residir na mesma VPC.
O tipo de protocolo afeta o desempenho de múltiplas escritas. O NFSv3 apresenta melhor desempenho quando várias instâncias ECS não escrevem no mesmo arquivo simultaneamente. O Extreme NAS suporta apenas NFSv3.
A capacidade do PV serve apenas para correspondência. Os valores de capacidade não limitam o armazenamento real. Os limites reais dependem das especificações do sistema de arquivos NAS.
PVs estáticos não suportam
archiveOnDelete. Definir Delete em um PV estático não exclui efetivamente o PV nem os dados do NAS. Use Retain (padrão), a menos que utilize volumes NAS provisionados dinamicamente.
Informações básicas
Configurar um volume de armazenamento compartilhado para ambientes de job do Arena preserva o trabalho dos cientistas de dados (código e dados), evitando perdas quando os contêineres são excluídos, e facilita o acesso a dados de treinamento compartilhados. No desenvolvimento em equipe, alocar um pool de armazenamento compartilhado permite compartilhar dados e código entre os membros.
Ao enviar um job do Arena, use o parâmetro --data para declarar o armazenamento compartilhado e o caminho de montagem. O armazenamento compartilhado é montado no diretório especificado, permitindo que jobs subsequentes reutilizem esses dados ou código.
No Kubernetes, objetos de armazenamento são descritos por Persistent Volumes (PVs) e Persistent Volume Claims (PVCs). Como administrador do cluster, ao atribuir ambientes, crie um PVC separado para cada cientista de dados. Por exemplo, PVCs para o usuário A e o usuário B podem montar o mesmo backend NAS ou CPFS, mas devem apontar para subdiretórios diferentes para manter os ambientes de trabalho isolados.
Etapa 1: Criar uma instância NAS
Crie um sistema de arquivos NAS de uso geral na mesma região e VPC do cluster ACK.
Consulte Create a General-purpose NAS file system using the console.
Use os seguintes valores:
|
Parâmetro |
Valor necessário |
|
File system type |
General-purpose NAS |
|
Region |
Mesma região do cluster ACK |
|
VPC |
Mesma VPC do cluster ACK |
|
Protocol type |
NFS |
Etapa 2: Montar o sistema de arquivos em uma instância ECS
Monte o sistema de arquivos NAS em uma instância ECS para preenchê-lo posteriormente com dados de treinamento. Esta etapa utiliza o recurso de montagem com um clique. Consulte Scenarios for mounting a file system para outros métodos.
Montar o sistema de arquivos NAS
Faça login no console NAS. No painel de navegação à esquerda, escolha .
-
Na barra de navegação superior, selecione o grupo de recursos e a região do sistema de arquivos.

-
Localize o sistema de arquivos e clique em Mount na coluna Actions.
Na primeira utilização, o NAS solicita a atribuição da função vinculada ao service AliyunServiceRoleForNasEcsHandler. Siga as instruções na tela. Consulte Service-linked roles of NAS .
-
No painel Mount, defina as opções de montagem:
Selecione um ponto de montagem e clique em Next.
-
Escolha uma instância ECS na mesma VPC do sistema de arquivos e clique em Next. Se a instância não estiver listada, atualize a página.
NotaEsta configuração suporta anexação apenas a uma única instância ECS. Consulte Batch mount an NFS file system on multiple ECS instances para montagem em lote.
-
Configure os parâmetros de montagem:
Parâmetro
Descrição
Obrigatório
Padrão
Mount path
Diretório local na instância ECS para o ponto de montagem.
Sim
—
Automatic mount
Remonta automaticamente o sistema de arquivos ao reiniciar a instância ECS.
Não
Ativado
Protocol type
Versão do protocolo NFS. O NAS de uso geral suporta NFSv3 e NFSv4; o Extreme NAS suporta apenas NFSv3. O NFSv3 oferece melhor desempenho quando várias instâncias não escrevem no mesmo arquivo simultaneamente.
Sim
—
NAS directory
Diretório NAS a ser montado. Insira
/para a raiz ou um subdiretório como/abc. Para diretórios inexistentes, selecione Confirm New Directory e defina o UID, GID e permissões POSIX.Não
/(raiz)Mount parameters
Flags de montagem NFS. Consulte Mount an NFS file system on a Linux ECS instance para a referência completa.
Não
Parâmetros de montagem padrão
-
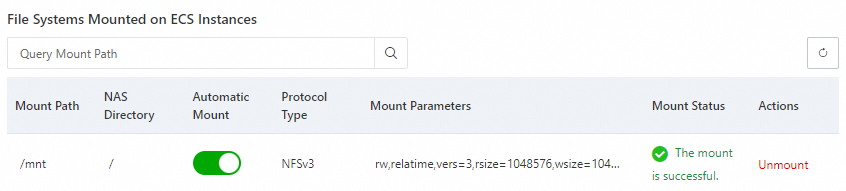
Clique em Complete. A montagem leva de 1 a 2 minutos. Quando o status mostrar Mounted, o sistema de arquivos estará pronto. Se aparecer Failed, consulte Mount an NFS file system on a Linux ECS instance para solução de problemas.
Verificar a montagem
Connect to the ECS instance e execute estes comandos para verificar o acesso:
mkdir /mnt/dir1
mkdir /mnt/dir2
touch /mnt/file1
echo 'some file content' > /mnt/file2
ls /mnt
A saída lista dir1, dir2, file1 e file2:
dir1 dir2 file1 file2Para visualizar detalhes da montagem ou verificar a capacidade, execute mount -l ou df -h.
Cada sistema de arquivos NAS requer um ponto de montagem. Consulte Manage mount targets para adicionar ou consultar pontos de montagem. Defina Mount target type como VPC e selecione a mesma VPC e vSwitch do cluster ACK.
Etapa 3: Criar um PV e um PVC
Registre o sistema de arquivos NAS como um PV no cluster ACK e crie um PVC para acesso pelos pods.
Criar um PV
Faça login no console ACK. No painel de navegação à esquerda, clique em Clusters.console NAS
Na página Clusters, clique no cluster desejado. No painel de navegação à esquerda, escolha Volumes > Persistent Volumes.
-
Na página Persistent Volumes, clique em Create. Defina os seguintes parâmetros e clique em OK.
Parâmetro
Descrição
Obrigatório
Padrão
Exemplo
PV type
Selecione NAS.
Sim
—
NAS
Name
Nome do PV. Deve ser único dentro do cluster.
Sim
—
pv-nasCapacity
Usado apenas para correspondência com PVC. Não limita o armazenamento real. Consulte General-purpose NAS file systems e Extreme NAS file systems para limites de capacidade.
Sim
—
5 GiAccess mode
ReadWriteMany: vários nós montam como leitura e escrita. ReadWriteOnce: apenas um nó.
Sim
—
ReadWriteManyEnable CNFS
Ativa o Container Network File System (CNFS) para O&M automatizado, aceleração de cache e monitoramento de desempenho. Consulte Create a CNFS to manage a NAS file system (Recommended) para gerenciar sistemas de arquivos existentes.
Não
Desativado
Desativado
Mount target domain name
Disponível quando o CNFS está desativado. Endereço do ponto de montagem do NAS. Selecione um destino existente ou insira um domínio personalizado. Consulte Manage mount targets para consultar endereços.
Sim (quando o CNFS está desativado)
—
0c47****-mpk25.cn-shenzhen.nas.aliyuncs.coMount path (Avançado)
Subdiretório NAS a ser montado. Para Extreme NAS, deve começar com
/share(ex.:/share/data). Diretórios inexistentes são criados automaticamente.Não
/(raiz)/dataReclaim policy
Retain (padrão): o PV e os dados do NAS são preservados quando o PVC é excluído; limpeza manual necessária. Delete: requer
archiveOnDelete. PVs estáticos não suportamarchiveOnDelete, portanto o PV e os dados persistem independentemente disso. Consulte Use dynamically provisioned NAS volumes para configuração dearchiveOnDelete.Não
Retain
RetainMount options
Versão do NFS protocol e flags de montagem. O NFSv3 apresenta melhor desempenho para leituras de treinamento de ML sem escritas simultâneas.
Não
—
nolock,tcp,noresvportvers=3Label
Rótulos para o PV.
Não
—
pv-nas
O PV aparece na página Persistent Volumes.
Criar um PVC
No painel de navegação, escolha Storage > Persistent Volume Claims.
-
Na página Persistent Volume Claims, clique em Create. Defina os seguintes parâmetros e clique em OK.
Parâmetro
Descrição
Obrigatório
Padrão
Exemplo
PVC type
Selecione NAS.
Sim
—
NAS
Name
Nome do PVC. Deve ser único dentro do cluster.
Sim
—
pvc-nasAllocation mode
Use Existing Persistent Volume: vincula ao PV acima. Create Volume: provisiona um novo PV inline.
Sim
—
Use Existing Persistent Volume
Existing volumes
O PV criado acima.
Sim (ao usar PV existente)
—
pv-nasCapacity
Capacidade de armazenamento reivindicada. Usada apenas para correspondência PVC-PV.
Sim
—
5
Verificar o PV e o PVC
Confirme se o PVC está vinculado ao PV. Connect to any node in the ACK cluster e execute:
kubectl get pvc pvc-nasA saída mostra o PVC no estado Bound:
NAME       STATUS   VOLUME   CAPACITY   ACCESS MODES   STORAGECLASS   AGE
pvc-nas    Bound    pv-nas   5Gi        RWX                           1m
Se o status for Pending, verifique se o nome do PV e os modos de acesso correspondem.
Etapa 4: Popular o PVC com dados
O cluster Kubernetes acessa dados compartilhados por meio de PVCs (que apontam para a instância NAS criada na Etapa 1), portanto, basta popular o NAS que sustenta o PVC. O procedimento a seguir cria dois Jobs do Kubernetes que copiam os conjuntos de dados MNIST do PyTorch e TensorFlow de imagens de contêiner de exemplo para o NAS nos diretórios especificados. O exemplo usa o PVC pvc-nas da Etapa 3.
-
Crie um arquivo chamado
prepare-pytorch-mnist-data.yamlcom o seguinte conteúdo:apiVersion: batch/v1 kind: Job metadata: name: prepare-pytorch-mnist-data namespace: default spec: completions: 1 parallelism: 1 backoffLimit: 3 ttlSecondsAfterFinished: 3600 template: spec: containers: - name: pytorch-mnist-example image: kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/pytorch-mnist-example:2.5.1-cuda12.4-cudnn9-runtime imagePullPolicy: Always command: - /bin/bash - -c args: - | set -eux mkdir -p /mnt/pytorch_data/MNIST/raw cp -r /data/MNIST/raw/* /mnt/pytorch_data/MNIST/raw || { echo "Copy failed"; exit 1; } echo "MNIST data prepared successfully at /mnt/pytorch_data/MNIST/raw." resources: requests: cpu: 100m memory: 128Mi limits: cpu: 100m memory: 128Mi volumeMounts: - name: training-data mountPath: /mnt volumes: - name: training-data persistentVolumeClaim: claimName: pvc-nas restartPolicy: Never -
Crie o Job para copiar o conjunto de dados MNIST do PyTorch para
/pytorch_datano NAS:# Create the Job kubectl create -f prepare-pytorch-mnist-data.yaml # Wait for the Job to complete kubectl wait --for=condition=complete --namespace=default --timeout=300s job/prepare-pytorch-mnist-dataQuando o Job terminar com sucesso, a saída será:
job.batch/prepare-pytorch-mnist-data condition met -
Crie um arquivo chamado
prepare-tensorflow-mnist-data.yamlcom o seguinte conteúdo:apiVersion: batch/v1 kind: Job metadata: name: prepare-tensorflow-mnist-data namespace: default spec: completions: 1 parallelism: 1 backoffLimit: 3 ttlSecondsAfterFinished: 3600 template: spec: containers: - name: tensorflow-mnist-example image: kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/tensorflow-mnist-example:2.15.0-gpu imagePullPolicy: Always command: - /bin/bash - -c args: - | set -eux mkdir -p /mnt/tf_data cp -r /data/mnist.npz /mnt/tf_data/mnist.npz || { echo "Copy failed"; exit 1; } echo "MNIST data prepared successfully at /mnt/tf_data/mnist.npz." resources: requests: cpu: 100m memory: 128Mi limits: cpu: 100m memory: 128Mi volumeMounts: - name: training-data mountPath: /mnt volumes: - name: training-data persistentVolumeClaim: claimName: pvc-nas restartPolicy: Never -
Crie o Job para copiar o conjunto de dados MNIST do TensorFlow para
/tf_datano NAS:# Create the Job kubectl create -f prepare-tensorflow-mnist-data.yaml # Wait for the Job to complete kubectl wait --for=condition=complete --namespace=default --timeout=300s job/prepare-tensorflow-mnist-dataQuando o Job terminar com sucesso, a saída será:
job.batch/prepare-tensorflow-mnist-data condition met
Este exemplo usa o PVC chamadopvc-nasno namespacedefault. Se o PVC tiver um nome diferente ou estiver em outro namespace, ajuste os manifests adequadamente.
O diretório /tf_data contém os dados MNIST do TensorFlow e /pytorch_data contém os dados MNIST do PyTorch. Ambos estão acessíveis para qualquer pod que monte pvc-nas.
Próximas etapas
Envie um job de treinamento do Arena com
--datapara montarpvc-nas.Para isolar ambientes de usuários, crie PVCs separados apontando para subdiretórios diferentes do mesmo sistema de arquivos NAS.
Para cargas de trabalho de produção, considere enabling CNFS.