Os node pools do Container Service for Kubernetes (ACK) oferecem suporte a reparo automático personalizado. Em nós ECS e Lingjun, incluindo super nós, o ACK detecta falhas de GPU e falhas subjacentes no nó, executa o reparo seguindo as etapas definidas por você e relata o progresso por meio de Kubernetes Events.
Antes de começar
Tipos de node pool: Node pools do Elastic Compute Service (ECS) e node pools Lingjun, incluindo super nós.
Tipos de falha: falhas de nó, falhas de GPU e falhas de sistema e componentes.
-
Dependência de add-on
Detecção de falhas: Requer ack-node-problem-detector (NPD) v1.2.36 ou posterior para detectar falhas de GPU, sistema, componentes e add-ons.
Reparo automático: Gerenciado pelo node-lifecycle-controller. Atualize para a versão mais recente para obter os recursos de reparo mais novos. Para instruções de atualização, consulte Upgrade the node auto repair add-on.
Diagnóstico automático de falhas: Suportado apenas para node pools ECS.
Regiões: Não suportado em regiões de cloud dedicada.
Mecanismo de reparo automático
O reparo automático de nós monitora os sinais de falha reportados pelos nós, como eventos do CloudMonitor (CMS), eventos subjacentes do sistema e as falhas de GPU, sistema e componentes detectadas pelo NPD. O ACK converte cada falha detectada em um Kubernetes Event e uma Node Condition, repara o nó com base nas regras de reparo automático configuradas e relata o progresso por meio de Kubernetes Events.
Processo
Detecção de falhas: O ACK monitora continuamente eventos subjacentes do nó e anomalias relatadas pelo NPD. Ao detectar uma falha, o ACK adiciona a Node Condition correspondente ao nó e gera um plano de reparo.
-
Tratamento de falhas: O ACK executa as etapas de reparo em sequência, conforme a regra de reparo automático. Cada etapa pode ser ativada ou ignorada, e qualquer etapa ativa pode exigir intervenção manual; nesse caso, o ACK prossegue somente após a concessão da autorização.
Isolamento do nó: Marca o nó com falha como Unschedulable para impedir que novas cargas de trabalho sejam agendadas nele.
Drenagem do nó: Evita as cargas de trabalho em execução no nó.
Reparo automático: Inicia uma ação de reparo, como reparo de hardware ou reinicialização do nó, com base no tipo de falha.
Remoção do isolamento do nó: Restaura o nó para o estado Schedulable após a conclusão do reparo.
Para determinar se um reparo foi bem-sucedido ou falhou, consulte Kubernetes Events for node auto repair.
A figura a seguir mostra o processo de reparo automático.

O ACK trata as falhas por prioridade: falhas do tipo reparo de alta prioridade são corrigidas primeiro, enquanto falhas do tipo reinicialização de baixa prioridade são adiadas até que todas as falhas de alta prioridade sejam tratadas.
Precauções
Caso o cluster já execute outro software de reparo automático de nós, avalie cuidadosamente a configuração antes de usar este recurso para evitar conflitos entre múltiplos mecanismos de reparo.
Se a intervenção manual estiver ativada para qualquer etapa de reparo, conceda a autorização prontamente. Caso contrário, o ACK pausa a etapa atual e todas as subsequentes, e o nó pode permanecer em um estado não íntegro.
Quando ocorre uma falha do tipo nó em um nó Lingjun, o ACK a repara durante a fase de reparo por meio da operação de O&M baseada em aprovação do Lingjun. Monitore a integridade do nó Lingjun e seu status de nó no cluster ACK para limitar o impacto nas suas cargas de trabalho.
Se o processo de reparo automático do nó falhar, faça logon no cluster o mais rápido possível, repare o nó manualmente e restaure-o para o estado Schedulable. Para assistência, entre em contato com o Suporte Técnico.
Após ativar o reparo automático de nós, habilite o gerenciamento de alertas e ative os conjuntos de regras de alerta GPU monitoring and alert rules, Alert Rules for Node Pool O&M Events e Cluster Node Auto Repair Alert Rule Set. Para mais informações, consulte Configure alerts.
Configurar regras de reparo automático
Procedimento
Para configurar e usar o reparo automático de nós, conclua as seguintes etapas:
Configure regras de reparo automático: Nas configurações gerenciadas de um node pool novo ou existente, crie uma regra de reparo automático e especifique os tipos de falha e o processo de reparo. Para mais informações, consulte Auto repair configuration.
Configure limitação e disjuntor (opcional): Nas configurações gerenciadas, defina o número máximo de nós reparados em paralelo e o limiar de disjuntor para evitar que operações de reparo sobrecarreguem o cluster durante falhas em grande escala. Para mais informações, consulte Auto repair throttling and circuit breaking.
Ative o diagnóstico automático de falhas (opcional, apenas para node pools ECS): Nas configurações gerenciadas, selecione Automatic Fault Diagnosis para habilitar o diagnóstico profundo de falhas de hardware de GPU. Para mais informações, consulte Enable automatic fault diagnosis.
Ative alertas: Ative o gerenciamento de alertas e os conjuntos de regras de alerta para reparo automático de nós. Para mais informações, consulte Configure alerts.
Monitore e trate eventos: Acompanhe o progresso do reparo automático por meio de Kubernetes Events (consulte Kubernetes Events for node auto repair). Conceda autorização assim que o ACK solicitar e intervenha manualmente se o processo falhar.
Configuração de reparo automático
É possível ativar o reparo automático de nós e definir regras de reparo automático ao criar um node pool ou modificar um node pool existente.
Pontos de entrada
Novo node pool: Ao criar um node pool, na área Configure Managed Node Pool, selecione Custom Node Management. Em seguida, siga as instruções na tela para ativar Auto Repair e criar regras de reparo automático. Para uma descrição completa dos itens de configuração, consulte Create and manage node pools.
Node pool existente: Na lista de node pools, localize o node pool alvo. Na coluna Actions, clique em
 Enable Managed Node Pool se o modo gerenciado não estiver ativado, ou clique em Configure Managed Node Pool se o modo gerenciado já estiver ativado. Depois, siga as instruções na tela para criar regras de reparo automático e ativar o reparo automático de nós.
Configurar uma regra de reparo automático
Acesse a página de configuração de regras: Abra o painel Create Self-Healing Rule na página de criação ou configuração do node pool, ou clique em Create Self-Healing Rule na página Self-Healing Rule.
-
Configure sub-regras:
Selecione o tipo de falha e a ação de reparo: Com base no tipo de falha (falhas de nó, falhas de GPU ou falhas de sistema e componentes), selecione a ação de reparo correspondente (consulte Faults).
-
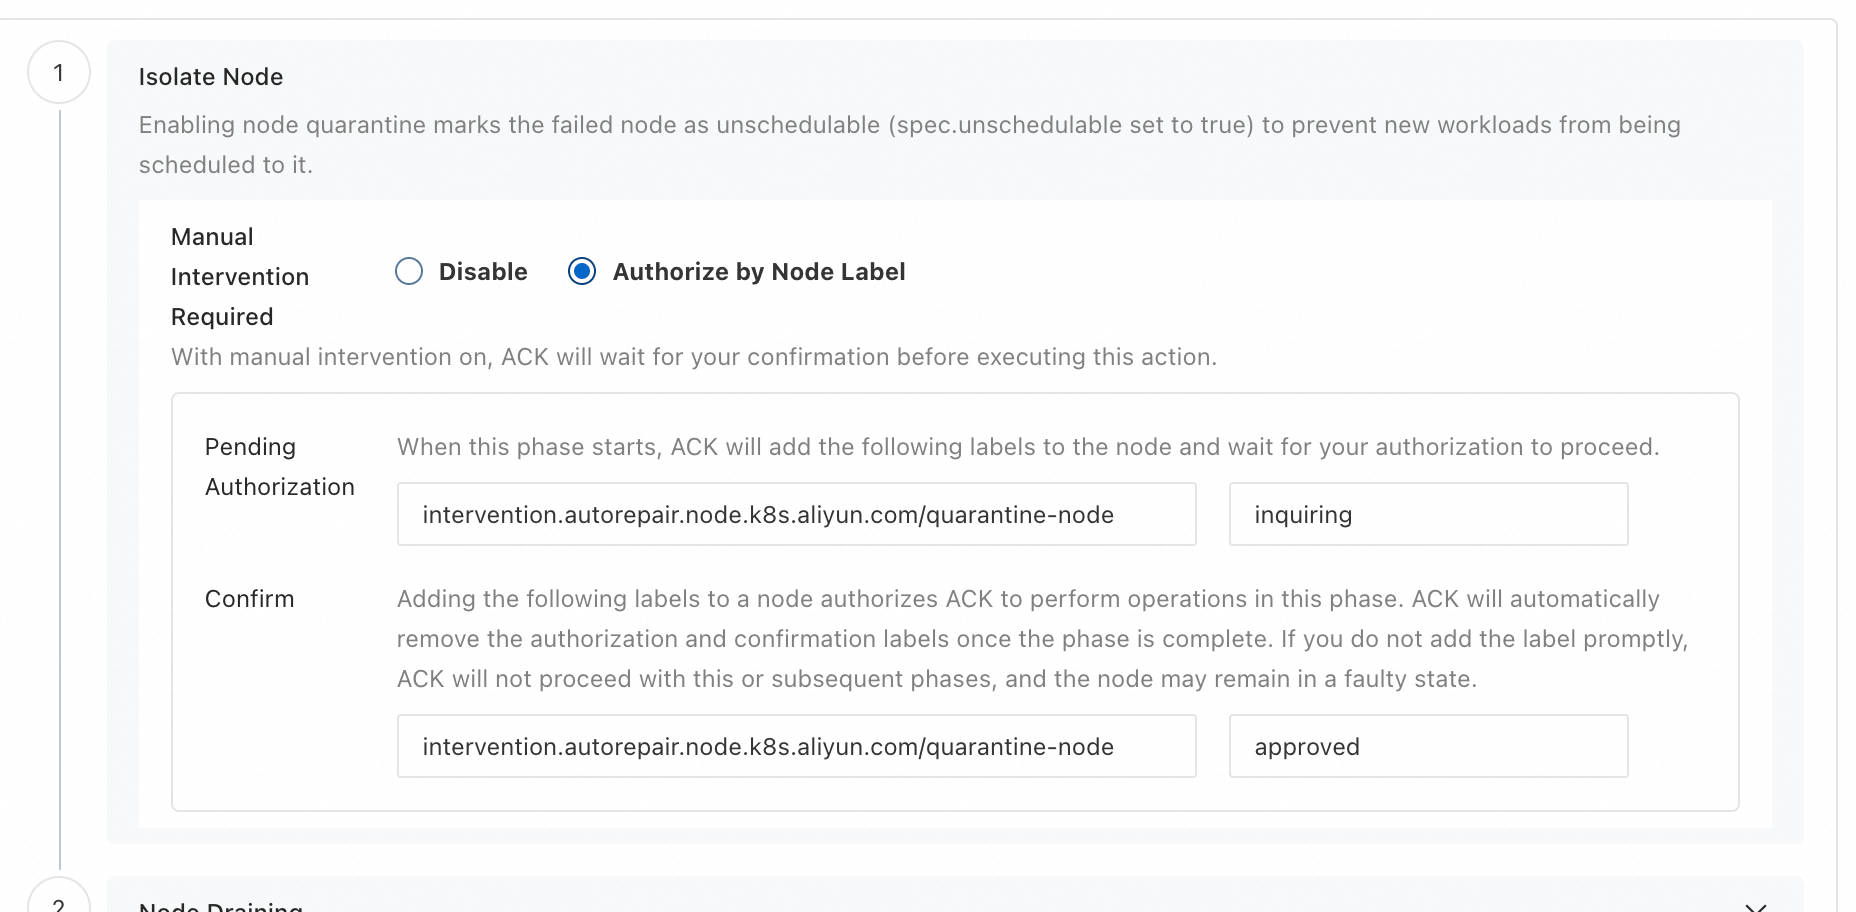
Configure o processo de reparo: Todas as etapas a seguir suportam intervenção manual; nesse caso, o ACK executa a etapa somente após a concessão da autorização. Para mais informações, consulte a descrição no console.
Parâmetro
Descrição
Isolamento do nó
Marca o nó com falha como Unschedulable (
spec.unschedulable=true) para impedir que novas cargas de trabalho sejam agendadas nele.Drenagem do nó
Requer isolamento do nó. Evita as cargas de trabalho no nó uma a uma e respeita as restrições do Pod Disruption Budget (PDB). O tempo limite padrão é de 300 segundos e é configurável. Pods gerenciados por um DaemonSet ou OpenKruise Advanced DaemonSet, e Pods rotulados com
alibabacloud.com/evict-pod=skip, não são evitados. O processo avança para a próxima etapa após o término do tempo limite.Reparo automático
Executa a ação de reparo correspondente ao tipo de falha (para mais informações, consulte Faults).
Remoção do isolamento do nó
Requer isolamento do nó. Torna o nó Schedulable novamente (
spec.unschedulable=false). Se o nó já estava como Unschedulable antes do início do processo de reparo, esta etapa não o restaura para o estado Schedulable.
Limitação e disjuntor de reparo automático
Após selecionar Custom Node Management e ativar Auto Repair na página Configure Managed Node Pool, a política de limitação e disjuntor de reparo automático entra em vigor com suas configurações padrão.
Política padrão
Por padrão, se vários nós em um node pool apresentarem anomalias simultaneamente, o ACK os repara um por vez e não aciona o disjuntor.
Modificar a política padrão
Caso a política padrão não atenda aos seus requisitos, clique em Modify Auto Repair Throttling and Circuit Breaking Policy e configure os seguintes parâmetros:
|
Parâmetro |
Descrição |
|
Maximum number of nodes repaired in parallel |
Número máximo de nós que o ACK repara simultaneamente quando muitos nós no node pool estão anormais. |
|
Circuit breaking condition |
Quando o número de nós com falha excede este limiar, o reparo automático entra em estado de disjuntor e para de iniciar novas operações de reparo. |
Limiar de disjuntor: Deve ser ≥ o limite de reparo paralelo para evitar que os reparos parem prematuramente.
Limite de reparo paralelo: Para recuperação de super nós, o ACK repara todos os nós filhos simultaneamente. Este limite deve ser pelo menos igual ao número de nós filhos em um único super nó.
Ativar diagnóstico automático de falhas
Ao ativar o diagnóstico automático de falhas, o ACK usa o probe no lado do nó ack-node-problem-detector para detectar possíveis anomalias e executar diagnósticos profundos do hardware de GPU. Quando uma anomalia é confirmada, o ACK gera alertas por meio de Kubernetes Events, Node Conditions e eventos de sistema ECS. Combine esses alertas com regras de reparo automático para que o ACK responda automaticamente.
Esta opção aplica-se apenas a node pools ECS.
Como ativar
Novo node pool
Ao criar um node pool, na área Configure Managed Node Pool, selecione Custom Node Management e marque a caixa de seleção Automatic Fault Diagnosis.
Node pool existente
Para node pools gerenciados: Na lista de node pools, clique em
> Configure Managed Node Pool na coluna Actions do node pool alvo. Na caixa de diálogo Configure Managed Node Pool, marque a caixa de seleção Auto Fault Diagnosis.Para node pools não gerenciados: Na lista de node pools, clique em
> Enable Managed Node Pool na coluna Actions do node pool alvo. Na caixa de diálogo Enable Managed Node Pool, selecione Custom Node Management e marque a caixa de seleção Auto Fault Diagnosis.
Os seguintes itens de erro do NPD acionam um diagnóstico profundo do ECS:
|
Item de erro |
Descrição |
|
|
Double Bit ECC Error (DBE). Este evento é registrado quando a GPU detecta um erro incorrigível. |
|
|
Parada do microcontrolador interno da GPU. |
|
|
Erro NVLink. |
|
|
A GPU desconectou-se do barramento. |
|
|
Erro de tempo limite de troca de contexto. |
|
|
Ocorre um tempo limite ao aguardar a resposta do núcleo GSP a uma mensagem RPC. |
|
|
Ocorre um erro no código em execução no núcleo GSP da GPU. |
|
|
NVLink: Erro RLW. |
|
|
Ação de Recuperação da GPU Alterada. |
|
|
O cabo de alimentação externo do dispositivo não está conectado corretamente. |
Configurar alertas
Após ativar o reparo automático de nós, habilite o gerenciamento de alertas e ative os seguintes conjuntos de regras de alerta: GPU monitoring and alert rules, Alert Rules for Node Pool O&M Events e Cluster Node Auto Repair Alert Rule Set. Configure um grupo de alertas ou contato dedicado para receber notificações prontamente quando ocorrer uma exceção.
Para obter informações sobre como ativar conjuntos de regras, consulte ACK alert management.
Descrições de alertas
Os conjuntos de regras de alerta incluem os seguintes itens relacionados ao reparo automático de nós:
|
Item de alerta |
Descrição |
|
Alerta de conversão de evento subjacente |
Acionado quando eventos subjacentes do nó (eventos CloudMonitor do Lingjun e eventos de sistema ECS) são convertidos em Node Conditions e Kubernetes Events, permitindo a detecção oportuna de anomalias de hardware e sistema do nó. Para o mapeamento completo, consulte Underlying event to Node Condition conversion. |
|
Alerta de monitoramento de GPU |
Acionado quando o NPD detecta uma anomalia em um dispositivo GPU. Para itens de falha específicos e ações de correção, consulte GPU faults. |
|
Alerta geral de progresso de reparo automático |
Relata o progresso geral do processo de reparo automático do nó, incluindo os resultados das etapas Node isolation, Node draining, Automatic repair e Node isolation removal. Para os eventos de cada etapa, consulte Kubernetes Events for node auto repair. |
|
Resumo de reparo automático para node pools do cluster |
Resume o status de reparo automático de cada node pool no cluster às 10:00 e 18:00 (hora local) todos os dias. O resumo destaca os nós aguardando aprovação e os nós em estado Unschedulable, fornecendo comandos de consulta prontos para execução para que você possa responder a tempo. |
Atualizar o add-on de reparo automático de nós
O reparo automático de nós é impulsionado pelo add-on node-lifecycle-controller. Novos tipos de falha, ações de reparo e itens de alerta exigem uma versão posterior; portanto, atualize o add-on para a versão mais recente.
Faça logon no console ACK. No painel de navegação à esquerda, abra o cluster alvo.
No painel de navegação à esquerda da página de gerenciamento do cluster, clique em Components and Add-ons.
-
Pesquise e localize o add-on
node-lifecycle-controller. Se uma nova versão estiver disponível, clique em Upgrade e confirme na caixa de diálogo.Para mais operações em add-ons, consulte Components.
Falhas
As tabelas a seguir descrevem as Node Conditions que acionam o reparo automático, as ações de correção e os critérios de recuperação para cada tipo de falha.
Falhas de nó
Aplica-se a anomalias de hardware subjacentes e falhas do tipo reinicialização em nós ECS e Lingjun, incluindo super nós.
Lingjun
Nome da falha | Nome do evento subjacente | Kubernetes Node Condition | Descrição | Ação de correção | Critérios de recuperação |
Nó Lingjun requer reparo devido a anomalia de hardware subjacente |
resourceType: Node |
| O nó Lingjun apresenta uma falha de hardware e requer reparo. O reparo pode causar perda de dados nos discos locais do nó. | Reparar nó Lingjun Importante Reparar um nó Lingjun pode causar perda de dados em seus discos locais. Faça backup dos seus dados antecipadamente. Se os diretórios do container runtime e do kubelet estiverem montados em um disco local, remova o nó da lista de nós do cluster ACK e adicione-o novamente após a conclusão do reparo. | Ambas as condições a seguir são atendidas:
|
Nó Lingjun requer reinicialização devido a anomalia subjacente |
resourceType: Node |
| O nó Lingjun apresenta uma falha. Reinicie o nó o mais rápido possível para tentar um reparo. | Reiniciar nó | Ambas as condições a seguir são atendidas:
|
Nó Lingjun requer reparo devido a anomalia de hardware subjacente (afetado por um super nó) |
resourceType: HyperNode |
| O super nó Lingjun apresenta uma falha de hardware que requer reparo. Autorize o reparo o mais rápido possível. O ACK inicia um fluxo de reparo automático separado para cada nó filho do super nó. Quando todos os processos de reparo dos nós filhos atingem a etapa de reparo, o ACK solicita uma única autorização para reparar todo o super nó. | Reparar nó Lingjun Importante Reparar um nó Lingjun pode causar perda de dados em seus discos locais. Faça backup dos seus dados antecipadamente. Se os diretórios do container runtime e do kubelet estiverem montados em um disco local, remova o nó da lista de nós do cluster ACK e adicione-o novamente após a conclusão do reparo. | Ambas as condições a seguir são atendidas:
|
Nó Lingjun requer reinicialização devido a anomalia subjacente (afetado por um super nó) |
resourceType: HyperNode |
| O super nó Lingjun apresenta uma falha. Autorize o reparo o mais rápido possível. O ACK inicia um fluxo de reparo automático separado para cada nó filho do super nó. Quando todos os processos de reparo dos nós filhos atingem a etapa de reparo, o ACK solicita uma única autorização para reparar todo o super nó. | Reiniciar nó | Ambas as condições a seguir são atendidas:
|
ECS
Nome da falha | Nome do evento subjacente | Kubernetes Node Condition | Descrição | Ação de correção | Critérios de recuperação |
Redeploy de instância necessário para manutenção do sistema (Scheduled) |
|
| A Alibaba Cloud detectou um risco potencial de software ou hardware no host subjacente da instância ECS, que pode exigir um redeploy da instância (ainda não é uma falha). Inicie o redeploy imediatamente para mitigar o risco. Caso contrário, o ECS acionará o redeploy após 24 a 48 horas. Para mais informações, consulte Overview of ECS system events. | Fazer redeploy do nó Importante Dados no disco local podem ser perdidos durante o redeploy do nó. Faça backup dos seus dados antecipadamente. | Ambas as condições a seguir são atendidas:
|
Redeploy de instância necessário para manutenção do sistema (Inquiring) |
|
| A Alibaba Cloud detectou um risco potencial de software ou hardware no host subjacente da instância ECS, que pode exigir um redeploy da instância (ainda não é uma falha). Inicie o redeploy imediatamente para mitigar o risco. Para mais informações, consulte Overview of ECS system events. | Fazer redeploy do nó Importante Dados no disco local podem ser perdidos durante o redeploy do nó. Faça backup dos seus dados antecipadamente. | Ambas as condições a seguir são atendidas:
|
Reinicialização de instância necessária para manutenção do sistema (Scheduled) |
|
| A Alibaba Cloud detectou um risco potencial de software ou hardware no host subjacente da instância ECS, que pode exigir uma reinicialização da instância (ainda não é uma falha). Inicie a reinicialização imediatamente para mitigar o risco. Caso contrário, o ECS acionará a reinicialização após 24 a 48 horas. Para mais informações, consulte Overview of ECS system events. | Reiniciar nó | Ambas as condições a seguir são atendidas:
|
Reinicialização de instância necessária para manutenção do sistema (Inquiring) |
|
| A Alibaba Cloud detectou um risco potencial de software ou hardware no host subjacente da instância ECS, que pode exigir uma reinicialização da instância (ainda não é uma falha). Inicie a reinicialização imediatamente para mitigar o risco. Para mais informações, consulte Overview of ECS system events. | Reiniciar nó | Ambas as condições a seguir são atendidas:
|
Para um mapeamento completo de eventos subjacentes, Node Conditions e Kubernetes Events, consulte Underlying event to Node Condition conversion.
Falhas de GPU
A detecção dessas falhas depende do add-on NPD. Todas as falhas de GPU compartilham os mesmos critérios de recuperação: o status do nó é Ready e a Node Condition acionadora foi resolvida.
Lingjun
Nome da falha | Kubernetes Node Condition | Descrição | Ação de correção |
|
| Double Bit ECC Error (DBE). Este evento é registrado quando a GPU detecta um erro incorrigível. | Reiniciar nó |
|
| Parada do microcontrolador interno da GPU. | Reiniciar nó |
|
| O driver da GPU detecta um erro incorrigível na memória da GPU. | Reiniciar nó |
|
| O driver da GPU detecta um erro incorrigível na memória da GPU e a supressão falhou. | Reiniciar nó |
|
| Ocorre um erro no código em execução no núcleo GSP da GPU. | Reiniciar nó |
|
| Falha de página de memória da GPU. | Reiniciar nó |
|
| A GPU possui páginas aposentadas em estado pendente. | Reiniciar nó |
|
| O remapeamento de linhas está pendente e será realizado na próxima reinicialização da GPU. | Reiniciar nó |
|
| Ocorre um tempo limite ao aguardar a resposta do núcleo GSP a uma mensagem RPC. | Reiniciar nó |
Todas as falhas de GPU são corrigidas reiniciando o nó. Se uma falha de GPU coincidir com um evento de sistema Lingjun que exija reparo, o ACK não reinicia o nó, pois uma reinicialização durante o reparo pode causar perda de dados no disco local e o processo de reparo automático falha. Configure uma regra de reparo automático separada para falhas do tipo reparo para cobrir este cenário. Para mais informações, consulte Lingjun node requires repair due to an underlying hardware anomaly .
ECS
Nome da falha | Kubernetes Node Condition | Descrição | Ação de correção |
|
| Double Bit ECC Error (DBE). Este evento é registrado quando a GPU detecta um erro incorrigível. | Reiniciar nó |
|
| Parada do microcontrolador interno da GPU. | Reiniciar nó |
|
| O driver da GPU detecta um erro incorrigível na memória da GPU. | Reiniciar nó |
|
| O driver da GPU detecta um erro incorrigível na memória da GPU e a supressão falhou. | Reiniciar nó |
|
| Ocorre um erro no código em execução no núcleo GSP da GPU. | Reiniciar nó |
|
| Falha de página de memória da GPU. | Reiniciar nó |
|
| A GPU possui páginas aposentadas em estado pendente. | Reiniciar nó |
|
| O remapeamento de linhas está pendente e será realizado na próxima reinicialização da GPU. | Reiniciar nó |
|
| Ocorre um tempo limite ao aguardar a resposta do núcleo GSP a uma mensagem RPC. | Reiniciar nó |
Falhas de sistema e componentes
A detecção dessas falhas depende do add-on NPD.
Nome da falha | Kubernetes Node Condition | Descrição | Ação de correção | Limiar de detecção de falha | Critérios de recuperação |
Processo de sincronização de tempo do nó está anormal |
| O processo de sincronização de tempo (ntpd ou chronyd) está anormal. | Faça logon no nó e execute comandos de reparo Nota Se você ativar a opção para permitir reinicializações de nó durante a etapa Automatic repair, o ACK tentará reiniciar o nó se a anomalia persistir após a execução da ação de reparo automático. | 10s | O status do nó é |
Container runtime do nó indisponível |
| O container runtime (containerd ou Docker Engine) parou e o nó está indisponível. | Faça logon no nó e execute comandos de reparo Nota Se você ativar a opção para permitir reinicializações de nó durante a etapa Automatic repair, o ACK tentará reiniciar o nó se a anomalia persistir após a execução da ação de reparo automático. | 90s | O status do nó é |
Unidade systemd do nó anormal |
| O status do systemd está anormal, impedindo que containers sejam iniciados ou destruídos. | Reiniciar nó | 90s | O status do nó é |
Nó está no estado NotReady |
| O kubelet parou ou seu heartbeat está anormal, fazendo com que o nó entre no estado NotReady. | Faça logon no nó e execute comandos de reparo Nota Se você ativar a opção para permitir reinicializações de nó durante a etapa Automatic repair, o ACK tentará reiniciar o nó se a anomalia persistir após a execução da ação de reparo automático. | 180s | Por três sondagens consecutivas, o status do nó é |
Sistema de arquivos (FS) do nó está no estado somente leitura |
| O sistema de arquivos do nó tornou-se somente leitura. | Reiniciar nó | 90s | O status do nó é |
Conversão de evento subjacente para Node Condition
O ACK converte os eventos subjacentes gerados por nós Lingjun, super nós Lingjun e nós ECS nas Node Conditions e Kubernetes Events correspondentes. As tabelas nesta seção fornecem o mapeamento completo de status para solução de problemas. Para as falhas que acionam o reparo automático, suas ações de correção e critérios de recuperação, consulte Faults.
Eventos subjacentes são mapeados para Node Conditions usando os seguintes campos:
Type: Identifica o tipo de falha.Reason: Identifica a fase atual do evento.
Fontes de eventos subjacentes
O reparo automático de nós do ACK converte eventos subjacentes de duas fontes: eventos do CloudMonitor publicados pelo plano de controle do Lingjun e eventos de sistema publicados pelo ECS.
Eventos do Cloud Monitor do Lingjun
O plano de controle do Lingjun publica anomalias de hardware e sistema para nós bare metal Lingjun como eventos do CloudMonitor. Um evento transita de Inquiring para Executing e, em seguida, para Executed ou Terminated. O ACK busca periodicamente esses eventos, identifica o tipo de evento, como Node.HardwareFault.HOST para um reparo necessário ou Node.FaultNeedReboot.HOST para uma reinicialização necessária, e os converte nas Node Conditions correspondentes.
O fluxograma a seguir usa o evento CloudMonitor Node.HardwareFault.HOST para uma falha de hardware de nó Lingjun como exemplo:

Eventos de sistema ECS
Os nós ECS reutilizam a estrutura de eventos de sistema do ECS. O ciclo de vida do evento inclui os seguintes status: Inquiring, Scheduled, Executing, Executed, Avoided, Failed e Canceled. O ACK chama a API de eventos de sistema do ECS para recuperar eventos de manutenção de instância, como SystemMaintenance.Reboot e SystemMaintenance.Redeploy, e os mapeia para a Node Condition correspondente no nó.
O fluxograma a seguir descreve as mudanças de status de um evento de manutenção de reinicialização SystemMaintenance.Reboot desde seu status inicial Inquiring:

Conversão de eventos subjacentes para nós Lingjun regulares
Cada evento subjacente para um nó Lingjun regular é convertido na Node Condition e Kubernetes Event correspondentes desse nó no cluster.
Status do evento | Descrição | Node Condition | Kubernetes Event |
resourceType: Node | Uma verificação de falha de hardware do nó está em andamento. |
|
|
resourceType: Node | A manutenção para uma falha de hardware do nó foi iniciada. |
|
|
resourceType: Node | A manutenção para uma falha de hardware do nó foi concluída. |
|
|
resourceType: Node | A manutenção para uma falha de hardware do nó foi encerrada. |
|
|
resourceType: Node | Uma verificação de falha que requer reinicialização do nó está em andamento. |
|
|
resourceType: Node | A reinicialização do nó para corrigir uma falha foi iniciada. |
|
|
resourceType: Node | A reinicialização do nó para corrigir uma falha foi concluída. |
|
|
resourceType: Node | A manutenção para uma falha que requer reinicialização do nó foi encerrada. |
|
|
Conversão de eventos subjacentes para super nós Lingjun
Cada evento subjacente para um super nó Lingjun é convertido nas Node Conditions e Kubernetes Events correspondentes para todos os nós filhos dentro desse super nó.
Status do evento | Descrição | Node Condition | Kubernetes Event |
resourceType: HyperNode | Uma verificação de falha de hardware do nó está em andamento. |
|
|
resourceType: HyperNode | A manutenção para uma falha de hardware do nó foi iniciada. |
|
|
resourceType: HyperNode | A manutenção para uma falha de hardware do nó foi concluída. |
|
|
resourceType: HyperNode | A manutenção para uma falha de hardware do nó foi encerrada. |
|
|
resourceType: HyperNode | Uma verificação de falha que requer reinicialização do nó está em andamento. |
|
|
resourceType: HyperNode | A reinicialização do nó para corrigir uma falha foi iniciada. |
|
|
resourceType: HyperNode | A reinicialização do nó para corrigir uma falha foi concluída. |
|
|
resourceType: HyperNode | A manutenção para uma falha que requer reinicialização do nó foi encerrada. |
|
|
Conversão de eventos de manutenção subjacentes para nós ECS
O ACK converte eventos de manutenção do sistema para nós ECS nas Node Conditions e Kubernetes Events correspondentes.
Status do evento | Descrição | Node Condition | Kubernetes Event |
| Uma verificação de reinicialização de instância devido à manutenção do sistema está em andamento. |
|
|
| Uma reinicialização de instância devido à manutenção do sistema está agendada. |
|
|
| Uma reinicialização de instância devido à manutenção do sistema está em andamento. |
|
|
| A reinicialização de instância devido à manutenção do sistema foi concluída. |
|
|
| A reinicialização de instância devido à manutenção do sistema foi evitada. |
|
|
| A reinicialização de instância devido à manutenção do sistema falhou. |
|
|
| A reinicialização de instância devido à manutenção do sistema foi cancelada, pois o risco foi mitigado. |
|
|
| Uma verificação de redeploy de instância devido à manutenção do sistema está em andamento. |
|
|
| Um redeploy de instância devido à manutenção do sistema está agendado. |
|
|
| Um redeploy de instância devido à manutenção do sistema está em andamento. |
|
|
| O redeploy de instância devido à manutenção do sistema foi concluído. |
|
|
| O redeploy de instância devido à manutenção do sistema foi evitado. |
|
|
| O redeploy de instância devido à manutenção do sistema foi cancelado. |
|
|
Kubernetes Events para reparo automático de nós
Após a ativação do modo gerenciado e a associação de uma regra de reparo automático a um node pool, o ACK converte eventos de falha de nó em Kubernetes Events e Node Conditions, e relata o progresso do plano de reparo por meio de Kubernetes Events. Para visualizar esses eventos, execute kubectl describe node <node-name> ou kubectl get events.
Determinar se o reparo automático foi bem-sucedido
O reparo automático é concluído quando o status do nó retorna para Ready, a Node Condition acionadora é limpa (ou os critérios de sucesso específicos da falha são atendidos) e um evento RepairPlanCompleted com uma mensagem de sucesso é gerado. Se ocorrer um evento NodeNotRecovery ou RepairPlanFailed, o nó não se recuperou. Nesse caso, faça logon no cluster e repare o nó manualmente conforme descrito em Precautions.
Eventos comuns do processo de reparo automático
A tabela a seguir descreve os Kubernetes Events que o ACK gera durante o processo de reparo automático.
|
Evento (Reason) |
Descrição |
|
|
Um evento de falha de nó Lingjun foi detectado ou o status de um evento de falha foi atualizado. |
|
|
Um evento de falha de super nó Lingjun foi detectado ou o status de um evento de falha foi atualizado. |
|
|
Um evento de falha de nó ECS foi detectado ou o status de um evento de falha foi atualizado. |
|
|
Um plano de reparo foi criado. |
|
|
A etapa atual requer autorização manual. A mensagem do evento descreve a operação a ser autorizada e como autorizá-la. |
|
|
O rótulo de autorização foi adicionado aos rótulos do nó. |
|
|
O status do plano de reparo foi atualizado. Este evento registra a etapa atual e seu resultado. |
|
|
O plano de controle do Lingjun foi autorizado a realizar o reparo. |
|
|
Após a conclusão do reparo, o status do nó é verificado a cada 30 minutos. Este evento é acionado se o nó não tiver se recuperado. |
|
|
O plano de reparo foi concluído. A mensagem do evento indica se o reparo foi bem-sucedido ou falhou. |
|
|
O reparo automático para um evento de super nó aguarda que todos os nós filhos do super nó entrem na fase de reparo. |
|
|
O número de nós com falha no node pool excedeu o limiar de disjuntor. O reparo automático entra em estado de disjuntor e para de iniciar novas operações de reparo. |
|
|
O número de nós com falha reparados em paralelo no node pool atingiu o limite superior. |
|
|
A falha do nó foi recuperada e a autoverificação foi aprovada. |
Eventos para cenários especiais
A tabela a seguir descreve os Kubernetes Events que o ACK gera em cenários especiais.
|
Evento (Reason) |
Descrição |
|
|
O plano de reparo anterior foi bem-sucedido, mas o tipo de falha atual difere do anterior. O sistema aguarda um período de resfriamento de 10 minutos antes de criar um novo plano de reparo. |
|
|
O processo de reparo automático mais recente tratou a falha atual com sucesso, mas o nó não se recuperou. É necessária solução de problemas manual. |
|
|
O plano de reparo para a falha atual falhou. O nó permanece não recuperado e requer solução de problemas manual. |
|
|
A atualização do status do plano de reparo falhou. |
|
|
Falha ao definir o rótulo de autorização e o processo de reparo automático foi abortado. |
|
|
O status atual da instância não atende aos requisitos da ação de reparo, portanto, o reparo automático é temporariamente ignorado. |