すべてのプロダクト
Search
ドキュメントセンター

Simple Log Service:OSS データのインポート

最終更新日:Sep 01, 2026

Object Storage Service (OSS) バケットから Simple Log Service (SLS) にログファイルをインポートして、クエリ、分析、変換を行うことができます。SLS は、最大 5 GB までの OSS オブジェクトをインポートできます。圧縮オブジェクトの場合、この制限は圧縮サイズに適用されます。

課金

Simple Log Service (SLS) はデータインポート機能に課金しません。ただし、この機能は Object Storage Service (OSS) API を呼び出すため、OSS のトラフィック料金とリクエスト料金が発生します。関連する課金項目の料金の詳細については、OSS の料金をご参照ください。OSS からデータをインポートする場合の 1 日あたりの OSS 費用は、次の式で計算されます:
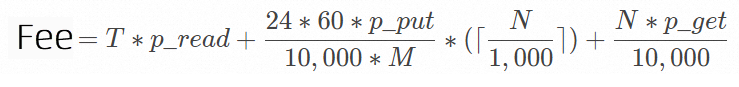
image..png

課金パラメーター

パラメーター

説明

N

1 日あたりにインポートされるファイルの数。

T

1 日あたりにインポートされるデータの総量 (単位:GB)。

p_read

データ 1 GB あたりのトラフィック料金。

  • 同一リージョン内でデータをインポートする場合、内部送信トラフィックが生成されます。このトラフィックは無料です。

  • リージョンをまたいでデータをインポートする場合、アウトバウンドインターネットトラフィックが生成されます。

p_put

10,000 PUT リクエストあたりの料金。

SLS は、ソースバケット内のファイルを一覧表示するために ListObjects API を呼び出します。OSS は ListObjects API を PUT リクエストとして課金します。各 API 呼び出しは、最大 1,000 個のオブジェクトを返すことができます。たとえば、インポートする新規ファイルが 1,000,000 個ある場合、1,000 回のリクエストが必要になります (1,000,000 ファイル / 1 リクエストあたり 1,000 ファイル)。

p_get

10,000 GET リクエストあたりの料金。

M

新規ファイルチェック間隔 (単位:分)。

データインポート設定を作成する際に、新しいファイルのチェックサイクル パラメーターを設定できます。

前提条件

  • ログファイルが Object Storage Service (OSS) バケットにアップロードされていること。詳細については、「オブジェクトのアップロード」をご参照ください。

  • プロジェクトと Logstore が作成されていること。詳細については、「プロジェクトの管理」および「基本的な Logstore の作成」をご参照ください。

  • AliyunLogImportOSSRole ロールを使用して Simple Log Service が OSS リソースにアクセスできるよう、クラウドリソースアクセス権限の付与が完了していること。

  • アカウントに、oss:ListBuckets 権限が付与されていること。詳細については、「RAM ユーザーへのカスタムポリシーのアタッチ」をご参照ください。

    RAM ユーザーを使用する場合、その RAM ユーザーに PassRole 権限も付与する必要があります。詳細については、「カスタムポリシーの作成」および「RAM ユーザー権限の管理」をご参照ください。

    {
      "Statement": [
        {
          "Effect": "Allow",
          "Action": ["ram:PassRole", "ram:GetRole"],
          "Resource": "acs:ram:*:*:role/aliyunlogimportossrole"
        },
        {
          "Effect": "Allow",
          "Action": "oss:GetBucketWebsite",
          "Resource": "*"
        },
        {
          "Effect": "Allow",
          "Action": "oss:ListBuckets",
          "Resource": "*"
        }
      ],
      "Version": "1"
    }    

    アカウントをまたいでデータをインポートする場合、ルートアカウント B はまず OSS コンソールで バケットポリシーを使用して、アカウント A およびアカウント A 内のロールを許可する必要があります。ロールの例: acs:ram::123456789:role/aliyunlogimportossrole。

    クロスアカウント権限付与

    OSS バケットを所有するアカウント B として、アカウント A およびアカウント A 内のインポートロールにバケットの読み取りアクセス権を付与するには、次の手順を実行します。

    1. アカウント B として OSS コンソールにログインします。

    2. [バケット] リストで、ターゲットバケットをクリックします。

    3. ナビゲーションペインで [バケットポリシー] をクリックし、[権限付与の追加] をクリックします。

    4. アカウント A にアクセス権を付与します: [リソース] をバケット全体に設定し、[許可されるユーザー] を [他のアカウント] に設定してアカウント A のアカウント ID (UID) を入力し、必要な [アクション] を設定してから [OK] をクリックします。

    5. アカウント A のインポートロールのポリシーを生成します。ロール (例: acs:ram::123456789:role/aliyunlogimportossrole) を入力して[ポリシーの生成] をクリックし、生成されたポリシーで Action を調整してから保存します。

    6. ポリシーを保存すると、[バケットポリシー] リストに新しいエントリが表示されます。このエントリは、アカウント A 内のそのロール用のポリシーです。

    権限付与が完了すると、アカウント A は OSS データインポート設定の作成時にアカウント B のバケットを選択できます。

データインポート設定の作成

重要

すでにインポート済みの OSS ファイルにデータを追加した場合、データインポートタスクはファイル全体を再インポートします。

  1. Log Serviceコンソールにログインします。

  2. データのインポート セクションで、データのインポート タブをクリックし、[OSS - データインポート] をクリックします。

  3. 宛先プロジェクトと Logstore を選択し、次へ をクリックします。

  4. インポート設定を行います。

    1. インポート設定 ステップで、次のパラメータを設定します。

      パラメータ

      パラメータ

      説明

      [タスク名]

      インポートタスクの一意の名前です。

      [表示名]

      タスクの表示名です。

      [ジョブの説明]

      インポートタスクの説明です。

      [OSS リージョン]

      ソース OSS バケットが配置されているリージョンです。

      OSS バケットと SLS プロジェクトが同じリージョンにある場合、パブリックネットワークトラフィック料金を節約でき、データ転送も高速化されます。

      バケット

      インポートするデータファイルを含むソースバケットです。

      [ファイルパスプレフィックスのフィルタリング]

      ファイルパスのプレフィックスで OSS ファイルを絞り込みます。たとえば、インポートするすべてのファイルが csv/ ディレクトリにある場合、プレフィックスとして csv/ を指定できます。

      このパラメータを設定しない場合、タスクは OSS バケット全体を走査します。

      説明

      このパラメータを設定することを推奨します。バケットに大量のファイルが含まれている場合、バケット全体の走査はデータインポート効率を大幅に低下させます。

      [ファイルパスの正規表現によるフィルタリング]

      ファイルパスを正規表現と照合して OSS ファイルをフィルタリングします。正規表現に一致するパスを持つファイルのみがインポートされます。デフォルトでは、このパラメータは空で、フィルタリングが行われないことを示します。

      たとえば、ファイルパスが testdata/csv/bill.csv の場合、正規表現を (testdata/csv/)(.*) に設定できます。

      正規表現をテストする方法の詳細については、「正規表現をテストする方法正規表現をテストする方法」をご参照ください。

      [ファイル変更時間のフィルタリング]

      ファイルの更新時刻で OSS ファイルをフィルタリングします。

      • [すべて]:一致するすべてのファイルをインポートする場合に選択します。

      • [特定の時間に開始されます]:特定の時点以降に更新されたファイルをインポートする場合に選択します。

      • [指定期間内]:特定の時間範囲内に更新されたファイルをインポートする場合に選択します。

      [データフォーマット]

      ファイルの解析形式です。有効な値は次のとおりです。

      • CSV:区切り文字で区切られたテキストファイルです。最初の行をフィールド名として使用するか、手動でフィールド名を指定できます。それ以降の各行は 1 つのログエントリとして解析されます。

      • [シングルライン JSON]:OSS ファイルを 1 行ずつ読み取り、各行を個別の JSON オブジェクトとして解析します。JSON オブジェクトのキーがログのフィールド名になります。

      • JSON 配列:OSS ファイル全体を一度に読み取ります。ファイルの内容は、1 つ以上の JSON オブジェクトを含む JSON 配列である必要があります。

      • CloudTrail:OSS ファイル全体を一度に読み取ります。内容は標準の CloudTrail データ構造形式である必要があります。

      • [シングルラインテキスト]:OSS ファイルの各行を 1 つのログエントリとして解析します。

      • [マルチラインテキスト]:複数行にまたがるログエントリの開始または終了を正規表現で識別する複数行モードです。

      • ORC:Optimized Row Columnar (ORC) 形式です。追加設定なしでファイルが自動的にログに解析されます。

      • Parquet:Parquet 形式です。追加設定なしでファイルが自動的にログに解析されます。

      • [Alibaba Cloud OSS アクセスログ]:Alibaba Cloud OSS アクセスログの形式です。詳細については、「ログ配信」をご参照ください。

      • [Alibaba Cloud CDN ダウンロードログ]:Alibaba Cloud CDN ダウンロードログの形式です。詳細については、「クイックスタート」をご参照ください。

      [圧縮フォーマット]

      ソースファイルの圧縮形式です。SLS は、データを読み取る前に指定された形式に基づいてファイルを解凍します。

      [エンコード形式]

      ソースファイルのエンコード形式です。現在、UTF-8 と GBK のみがサポートされています。

      [新しいファイルのチェックサイクル]

      ソース OSS パスに新しいファイルが継続的に追加される場合、新しいファイルのチェックサイクル を設定できます。インポートタスクはバックグラウンドで実行され、定期的に新しいファイルを検出して読み取ります。システムは、同じ OSS ファイルのデータが複数回インポートされないことを保証します。たとえば、12:00 にチェック間隔 30 分でタスクを作成した場合、最初のインポートは 12:00 に実行されます。新しいファイルが生成された場合、次のインポートは 12:30 に実行されます。

      ソース OSS パスに新しいファイルが追加される予定がない場合は、間隔を 今後はチェックしない に設定します。インポートタスクは、条件に一致する既存のすべてのファイルを読み取った後に停止します。

      [アーカイブファイルのインポート]

      ソースファイルが OSS のアーカイブまたはコールドアーカイブストレージクラスとして保存されている場合、読み取る前に復元する必要があります。このオプションを有効にすると、ファイルが自動的に復元されます。ディープコールドアーカイブストレージクラスはサポートされていません。

      説明
      • アーカイブファイルの復元には約 1 分かかるため、最初のプレビューがタイムアウトする場合があります。タイムアウトが発生した場合は、しばらく待ってから再試行してください。

      • コールドアーカイブファイルの復元には約 1 時間かかります。プレビューがタイムアウトした場合は、プレビューをスキップするか、1 時間待ってから再試行できます。

        コールドアーカイブファイルを復元する場合、復元されたコピーは 7 日間保持され、インポートに十分な時間が確保されます。

      [ログタイムの設定]

      [時間]

      データフォーマット として [単一行 JSON]、シングルライン JSON、[CloudTrail]、[ORC]、Alibaba Cloud OSS アクセスログ、Alibaba Cloud CDN ダウンロードログ、または データフォーマット を選択した場合は、時刻フィールドを指定する必要があります。SLS は、このフィールドを使用して、インポートされた各ログエントリの時刻を設定します。

      [時間フィールド抽出の正規表現]

      データフォーマット として シングルラインテキスト または マルチラインテキスト を選択した場合は、正規表現を使用してログコンテンツから時刻を抽出する必要があります。

      例えば、ログエントリ 127.0.0.1 - - [10/Sep/2018:12:36:49 +0800] "GET /index.html HTTP/1.1" には、時間フィールド抽出の正規表現 を [0-9]{0,2}\/[0-9a-zA-Z]+\/[0-9\: +]+ に設定できます。

      説明

      他のデータ形式の場合でも、時刻フィールドの一部のみを抽出する必要がある場合は、正規表現を使用できます。

      [時刻フィールドの形式]

      時刻フィールドの値を解析するために使用される時刻形式を指定します。

      • yyyy-MM-dd HH:mm:ss のような Java の SimpleDateFormat 構文をサポートしています。 構文の詳細については、「クラス SimpleDateFormat」をご参照ください。 一般的な時刻フォーマットについては、「時刻フォーマット」をご参照ください。

      • エポック形式 (epoch、epochMillis、epochMicro、epochNano) をサポートしています。

      [タイムゾーン]

      時刻フィールドのタイムゾーンを選択します。時刻形式がエポックタイプの場合、このパラメータは不要です。

      ログ時刻を解析する際に夏時間を考慮する場合は、UTC ベースの形式を選択してください。それ以外の場合は、GMT ベースの形式を選択してください。

      [詳細設定]

      [OSS メタデータインデックスの使用]

      OSS バケット内のファイル数が 100 万を超える場合は、このオプションを有効にすることを強く推奨します。有効にしない場合、ファイルの検出が非効率的になります。OSS メタデータインデックスを使用すると、バケット内の新しいファイルを数秒以内に検出でき、ほぼリアルタイムのデータインポートが可能になります。

      OSS メタデータインデックスを使用するには、まず OSS コンソールでバケットのメタデータ管理機能を有効にする必要があります。詳細については、「スカラー検索」をご参照ください。

      データフォーマット として [CSV] または マルチラインテキスト を選択した場合は、次の表に記載されている追加のパラメータを設定する必要があります。

      CSV

      パラメータ

      説明

      [区切りモード]

      ログ内のフィールドを区切るために使用される区切り文字です。デフォルトはカンマ (,) です。

      [引用符]

      CSV ファイル内の文字列に使用される引用符です。

      [クォート]

      ログのエスケープ文字です。デフォルトはバックスラッシュ (\\) です。

      [ログがまたぐ行の最大数]

      1 つのログエントリがまたがることができる最大行数です。デフォルトは 1 です。

      [最初の行フィールド名として使用]

      最初の行フィールド名として使用 スイッチをオンにすると、CSV ファイルの最初の行がフィールド名として使用されます。たとえば、次のサンプルの最初の行がログフィールドの名前として抽出されます。サンプルファイルのプレビュー:

      remote_addr,remote_user,time_local,request_time,request_length
      xxx,5,-,11/Dec/2020:15:31:06,0,000,133,3650,404,GET
      xxx,5,-,11/Dec/2020:15:32:06,0,000,133,3650,404,GET
      xxx,5,-,11/Dec/2020:15:34:10,0,000,133,3650,404,GET

      [カスタムフィールド]

      最初の行フィールド名として使用 オプションを無効にした場合は、カンマ区切りのカスタムフィールド名のリストを指定する必要があります。

      [スキップ行数]

      スキップするヘッダー行の数です。たとえば、値が 1 の場合、CSV ファイルの 2 行目からデータ収集が開始されます。

      複数行テキストログ

      パラメータ

      説明

      [正規表現と一致する位置]

      正規表現を照合する位置を指定します。

      • [最初の行のみに一致する正規表現]:正規表現を使用してログエントリの最初の行を照合します。一致しない後続の行は、設定された最大行数まで、現在のログエントリに追加されます。

      • [最終行のみに一致する正規表現]:正規表現を使用してログエントリの終了を識別します。ログエントリには、この式に一致する行までのすべての行が含まれます。

      [正規表現]

      ログコンテンツに基づいて正規表現を入力します。

      詳細については、「正規表現をテストする方法正規表現をテストする方法」をご参照ください。

      [最大ライン]

      1 つのログエントリがまたがることができる最大行数です。

    2. プレビュー をクリックして、インポート結果をプレビューします。

    3. 設定を確認したら、次へ をクリックします。

  5. インデックスの作成とプレビュー 次に、[次へ] をクリックします。 デフォルトでは、Simple Log Serviceでフルテキストインデックスが有効になっています。 収集したログのフィールドインデックスを手動で作成するか、[自動インデックス生成] をクリックすることもできます。 その後、Simple Log Serviceはフィールドインデックスを生成します。 詳細については、「インデックスの作成」をご参照ください。

    重要

    ログのすべてのフィールドをクエリする場合は、フルテキストインデックスを使用することを推奨します。 特定のフィールドのみをクエリする場合は、フィールドインデックスを使用することを推奨します。 これは、インデックストラフィックを減らすのに役立ちます。 フィールドを分析する場合は、フィールドインデックスを作成する必要があります。 分析のために、クエリ文にSELECT文を含める必要があります。

  6. ログ照会 をクリックしてクエリと分析ページを開き、OSS データが正常にインポートされたかどうかを確認します。

    約 1 分待ちます。対象の OSS データが表示されれば、インポートは成功です。

関連操作

データインポート設定を作成した後、コンソールで設定とその統計レポートを表示できます。

  1. [プロジェクト] リストで、目的のプロジェクトをクリックします。

  2. 左側のナビゲーションペインで、ログ管理 > ログストア を選択します。表示されたページで、目的の Logstore を見つけ、データのインポート > データのインポート を選択し、設定名をクリックします。

  3. 概要

    インポート設定の概要 ページで、設定の基本情報と統計レポートを表示できます。

    [インポート設定の概要] ページには、次の情報が表示されます。[基本情報] セクションには、[設定名]、[ステータス]、[バケット]、[圧縮形式]、[エンコーディング形式]、[ファイルパスの正規表現フィルター]、[アーカイブファイルのインポート]、[OSS リージョン]、[新規ファイルチェック間隔]、[データ形式]、[システム時刻の使用] などのパラメーターが表示されます。[統計レポート] ([データ処理インサイト]) セクションには、[読み取り成功]、[読み取り失敗]、[パブリック読み取りトラフィック]、[書き込み成功]、[書き込み失敗]、[パブリック書き込みトラフィック] の 6 つのメトリクス、および処理率の折れ線グラフと進捗ラグチャートが表示されます。下部の [実行ステータス] テーブルには、[時間]、[タイプ]、[インスタンス]、[成功項目]、[失敗項目]、[平均応答時間] など、各タスクの情報が一覧表示されます。右上隅には、[設定の編集]、[停止]、[設定の削除] のアクションボタンがあります。

    変更

    設定の変更 をクリックしてデータインポート設定を変更します。詳細については、「データインポート設定の作成」をご参照ください。

    削除

    設定の削除 をクリックして、データインポート設定を削除します。

    警告

    この操作は元に戻せません。慎重に実行してください。

    停止

    データインポートタスクを停止するには、停止 をクリックします。

    開始

    開始 をクリックして、データインポートタスクを開始します。

よくある質問

問題

考えられる原因

解決策

バケット内の HDFS ディレクトリからファイルをプレビューすると、データが表示されません。

HDFS ディレクトリから直接ファイルをインポートすることはサポートされていません。

バケットで HDFS サービスが有効になっている場合、OSS パスにデフォルトで .dlsdata ディレクトリが作成されます。.dlsdata ディレクトリからファイルをインポートできます。

プレビュー時にデータが表示されません。

OSS バケットにファイルが存在しないか、ファイルが空であるか、フィルター条件に一致するファイルがありません。

  • バケットに空でないファイルが含まれていることを確認してください。CSV ファイルの場合は、ヘッダー行以外の行が含まれていることを確認してください。含まれていない場合は、データが利用可能になるまで待ってからインポートを開始してください。

  • ファイルパスプレフィックスのフィルタリング、ファイルパスの正規表現によるフィルタリング、ファイル変更時間のフィルタリング などの設定を調整してください。

インポートされたデータに文字化けが含まれています。

データ形式、圧縮形式、またはエンコーディング形式が正しくありません。

OSS ファイルの実際の形式を確認してから、データフォーマット、圧縮フォーマット、エンコード形式 などの設定を調整してください。

既存の文字化けしたデータを修正するには、新しい Logstore と新しいデータインポート設定を作成してください。

Simple Log Service のタイムスタンプがソースデータのタイムスタンプと一致しません。

データインポート設定にログ時間フィールドがないか、時刻形式またはタイムゾーンが正しくありません。

ログ時間フィールドを指定し、正しい時刻形式とタイムゾーンを設定してください。詳細については、「データインポート設定の作成」をご参照ください。

データをインポートした後、クエリや分析ができません。

  • データがクエリ時間範囲外にあります。

  • インデックスが設定されていません。

  • インデックスがまだ反映されていません。

  • クエリしたいデータが指定された時間範囲内にあるかどうかを確認してください。範囲内にない場合は、時間範囲を調整して再度クエリしてください。

    データがクエリ範囲内にない場合は、範囲を調整して再度検索してください。

  • Logstore にインデックスが設定されているかどうかを確認してください。

    インデックスが設定されていない場合は、まず設定してください。詳細については、「インデックスの作成」または「インデックスの再構築」をご参照ください。

  • インデックスを設定済みで、[Data Processing Insight] ダッシュボードに表示される正常にインポートされたデータ量が期待どおりである場合、インデックスがまだ反映されていない可能性があります。データを再インデックスしてください。詳細については、「データの再インデックス」をご参照ください。

インポートされたエントリ数が想定よりも少ないです。

一部のファイルに 3 MB の制限を超える単一行のデータが含まれており、インポートプロセス中に破棄されています。詳細については、「収集制限」をご参照ください。

OSS ファイルにデータを書き込む際は、単一行のデータが 3 MB を超えないようにしてください。

データインポート設定を作成する際に、OSS バケットを選択できません。

Simple Log Service には、AliyunLogImportOSSRole ロールを引き受ける権限が付与されていません。

前提条件に記載されているとおりに権限付与を完了してください。

一部のファイルがインポートされません。

フィルター条件が正しく設定されていないか、一部のファイルが 5 GB のサイズ制限を超えています。詳細については、「収集制限」をご参照ください。

  • インポートするファイルがフィルター条件に一致するかどうかを確認してください。一致しない場合は、フィルター条件を変更してください。

  • インポートする各ファイルのサイズが 5 GB 未満であることを確認してください。ファイルがこの制限を超える場合は、サイズを削減する必要があります。

    単一ファイルが 5 GB を超える場合は、サイズを小さくしてください。

アーカイブファイルがインポートされません。

アーカイブファイルのインポート スイッチがオフになっています。詳細については、「収集制限」をご参照ください。

  • 方法 1:データインポート設定を変更し、アーカイブファイルのインポート スイッチをオンにします。

  • 方法 2:新しいデータインポート設定を作成し、アーカイブファイルのインポート スイッチをオンにします。

複数行テキストログが正しく解析されません。

先頭行の正規表現または最終行の正規表現が正しく設定されていません。

先頭行と最終行の正規表現を修正してください。

新しいファイルのインポートレイテンシーが高くなっています。

ファイルパスプレフィックスフィルターに一致する既存のファイルが多すぎるため、データインポート設定で OSS メタデータインデックスの使用 スイッチがオフになっています。

ファイルパスプレフィックスフィルターに一致するファイルが大量 (100 万を超える) にある場合は、データインポート設定で OSS メタデータインデックスの使用 スイッチをオンにする必要があります。オンにしない場合、新しいファイルの検出が非常に遅くなります。

作成時に STS 関連の権限エラーが発生します。

RAM ユーザーの権限が不足しています。

  1. RAM ユーザーの AccessKey が有効化されていることを確認してください。詳細については、「AccessKey ペア」をご参照ください。

  2. RAM ユーザーの一時的なアクセス認証情報 (STS トークン) の有効期限が切れていないかを確認してください。期限切れの場合は、有効期間を延長してください。詳細については、「STS 一時認証情報を使用した OSS へのアクセス」をご参照ください。

  3. Cloud Resource Access Authorization を完了し、Simple Log Service が AliyunLogImportOSSRole ロールを引き受けて OSS リソースにアクセスする権限が付与されていることを確認してください。

エラー処理

エラー

説明

オブジェクトの読み取り失敗

データインポートジョブがネットワーク例外やオブジェクトの破損などにより、オブジェクトを完全に読み取れない場合は、自動的に再試行します。3 回試行しても読み取り操作が失敗する場合、ジョブはそのオブジェクトをスキップします。

再試行間隔は、[New File Check Cycle] と同じです。[New File Check Cycle] が [Never Check] に設定されている場合、ジョブは 5 分後に再試行します。

圧縮形式の解析エラー

データインポートジョブが無効な圧縮形式のオブジェクトを検出した場合、そのオブジェクトをスキップします。

データ形式の解析エラー

  • データインポートジョブが ORC や Parquet などのバイナリ形式のオブジェクトを解析できない場合、そのオブジェクトをスキップします。

  • 他の形式のデータの解析に失敗した場合、データインポートジョブは生のテキストコンテンツをログのcontent フィールドに保存します。

OSS バケットが見つからない

データインポートジョブは定期的に再試行します。OSS バケットが再作成されると、ジョブは自動的にインポートを再開します。

権限エラー

OSS バケットからの読み取り、または Logstore への書き込みで権限エラーが発生した場合、データインポートジョブは定期的に再試行します。権限の問題が解決すると、ジョブは自動的に再開します。

権限エラーが発生している間は、データインポートジョブはオブジェクトをスキップしません。そのため、権限を修正した後、ジョブは OSS バケット内の未処理のオブジェクトをすべて処理し、そのデータを Logstore にインポートします。

OSS インジェスト API

アクション

API

OSS データインポートジョブの作成

CreateOSSIngestion

OSS データインポートジョブの更新

UpdateOSSIngestion

OSS データインポートジョブの取得

GetOSSIngestion

OSS データインポートジョブの削除

DeleteOSSIngestion

OSS データインポートジョブの開始

StartOSSIngestion

OSS データインポートジョブの停止

StopOSSIngestion