ApsaraDB RDS for MySQL インスタンスで発生するスロー SQL は、一般的に以下のいずれかの根本原因に起因します:スキーマまたはインデックスの問題、リソース枯渇、バージョンアップグレードによる副作用、パラメータ設定の誤り、キャッシュスターミデ(キャッシュエントリの同時有効期限切れ)、重いバッチ操作、未クローズのトランザクション、定期タスクなどです。各原因には特有の症状と対応策があります。
トラブルシューティングの進め方
特定の原因を調査する前に、まずモニタリングから始めます。以下の手順に従ってください。
特定の原因を調査する前に、まずリソースボトルネックを除外します。モニターとアラーム を ApsaraDB RDS コンソールで開き、標準モニタリング タブを確認します。リソースモニター をクリックし、CPU 使用率、メモリ使用率、ディスク使用率、IOPS(1 秒あたりの入出力操作数)、接続数、キャッシュヒット率、秒間クエリ数(QPS)、および TPS(1 秒あたりのトランザクション数)を確認します。これらのメトリックのいずれかが継続的に高い場合は、特定の SQL ステートメントの問題ではなく、リソースボトルネックが原因である可能性が高いです。詳細については、「インスタンスの使用制限」をご参照ください。
いずれかのメトリックが 100 % 近くになっている場合は、「インスタンスの使用制限」または「バッチ操作」から調査を開始してください。
メトリックが正常にもかかわらずクエリが遅い場合は、「未クローズのトランザクション」および「SQL 例外」を確認してください。
SQL Explorer and Audit を開き、具体的なスロー SQL ステートメントを特定します。以下の 2 つのメトリックにより、どのステートメントを優先して対処すべきかを判断できます。
実行時間:長時間実行されるクエリはロックを長く保持し、他の操作をブロックします。これらを最優先で修正してください。
実行回数:個々の実行が高速であっても、頻繁に実行されるクエリは累積的な負荷が高くなります。これらは最適化の有力な候補です。
インスタンスの使用制限によるスロー SQL のトラブルシューティング
原因
インスタンスがパフォーマンス上限に達する主な理由は以下のとおりです。
ワークロードが増加しているにもかかわらず、ストレージ容量や計算リソースがそれに見合って増強されていない。
物理ホストが老朽化し、インスタンス全体のパフォーマンスが低下している。
データ量が増加し、データ構造が変化したことで、特定の SQL ステートメントの実行が時間とともに遅くなっている。
識別方法
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの モニタリングとアラート に移動します。標準モニタリング タブで、リソース監視 をクリックし、すべてのリソース使用量メトリックが 100 % 近辺にあるかどうかを確認します。該当する場合は、インスタンスがパフォーマンス上限に達しています。
解決策
SysBench を使用して、ご利用のインスタンスの最大パフォーマンスをベンチマークします。SysBench で測定された QPS および TPS 値は、複雑なクエリワークロード下でも上限値を示します。ベンチマーク手順については、「テストガイドライン」をご参照ください。
インスタンスがパフォーマンス上限に達している場合は、より高い仕様にスペックアップしてください。詳細については、「インスタンスの仕様変更」をご参照ください。
SQL 例外によるスロー SQL のトラブルシューティング
原因
SQL 例外は、スキーマ設計の問題、欠落しているインデックス、またはスキャンが必要な行数が過剰に多いことにより、クエリ自体が非効率的になることで発生します。
特定方法
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの SQL Explorer and Audit に移動します。各スロー SQL ステートメントの実行時間と実行回数を確認し、対応が必要なクエリを特定します。
解決策
ビジネス要件に基づき、問題のある SQL ステートメントを最適化してください。詳細については、「SQL 最適化」をご参照ください。
バージョンアップグレードによるスロー SQL のトラブルシューティング
原因
RDS インスタンスのアップグレードにより、既存の SQL ステートメントのクエリプランが変更されることがあります。MySQL のクエリプランでは、結合タイプ(join type)が使用されますが、その効率性は以下のように異なります(効率が高い順):system、const、eq_ref、ref、fulltext、ref_or_null、index_merge、unique_subquery、index_subquery、range、index、および all。詳細については、MySQL 公式ドキュメント をご参照ください。
頻繁に実行されるステートメントのクエリプランが、効率の低い結合タイプ(例:range や index)にシフトすると、そのステートメントの実行が遅くなります。このようなステートメントが多数同時に並列実行されると、スレッドが解放されるよりも速く蓄積され、接続プールが枯渇し、インスタンス上のすべてのワークロードに影響を及ぼします。
特定方法
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの モニタリングとアラート に移動します。標準モニタリング タブで、リソース監視 をクリックし、アクティブ接続数を確認します。アップグレード後に接続数が急激に増加している場合は、強い兆候となります。
解決策
EXPLAIN を使用して、スロー SQL ステートメントのクエリプランを分析します。各ステートメントの結合タイプ、インデックス使用状況、スキャンされる行数を特定します。この分析に基づき、SQL ステートメントを再構築するか、インデックスを調整してクエリ効率を回復させてください。詳細については、「SQL 最適化」をご参照ください。
不適切なパラメータ設定によるスロー SQL のトラブルシューティング
原因
innodb_buffer_pool_instances パラメーターおよび join_buffer_size パラメーターの値が不適切であると、SQL 実行パフォーマンスが低下することがあります。
識別方法
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの パラメーター に移動します。編集履歴 タブで、これらのパラメーターの再設定履歴を確認し、最近の変更がパフォーマンス劣化と一致しているかどうかを調べます。
解決策
innodb_buffer_pool_instances および join_buffer_size を、ご利用のワークロードおよびインスタンスの仕様に適した値に再設定してください。
キャッシュエントリの有効期限切れによるスロー SQL のトラブルシューティング
原因
キャッシュエントリが同時に有効期限切れになると(キャッシュスターミデ)、大量のリクエストがキャッシュをバイパスして直接データベースに到達します。ApsaraDB RDS は 100 % のキャッシュヒット率を保証しないため、高い同時実行性下ではこのようなシナリオが発生する可能性があります。
特定方法
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの モニタリングとアラート に移動します。標準モニタリング タブで、リソース監視 をクリックし、キャッシュヒット率と QPS・TPS を併せて確認します。キャッシュヒット率が急激に低下し、同時に QPS が急増している場合は、キャッシュスターミデが発生していることを示唆します。
解決策
負荷増加に対応し、キャッシュミスの影響を軽減するために、以下の機能を有効化してください。
スレッドプール:接続の同時実行数を管理し、スレッド枯渇を防止します。「スレッドプール」をご参照ください。
高速クエリキャッシュ:クエリ結果をキャッシュして、繰り返しの計算を削減します。「高速クエリキャッシュ」をご参照ください。
自動 SQL スロットリング:インスタンスを保護するために、着信 SQL リクエストのレートを制限します。「自動 SQL スロットリング」をご参照ください。
バッチ操作によるスロー SQL のトラブルシューティング
原因
大規模なデータインポート、削除、またはクエリが通常のワークロードと同時に実行されると、ディスク I/O およびトランザクションリソースを競合し、すべての SQL 実行が遅くなります。
識別方法
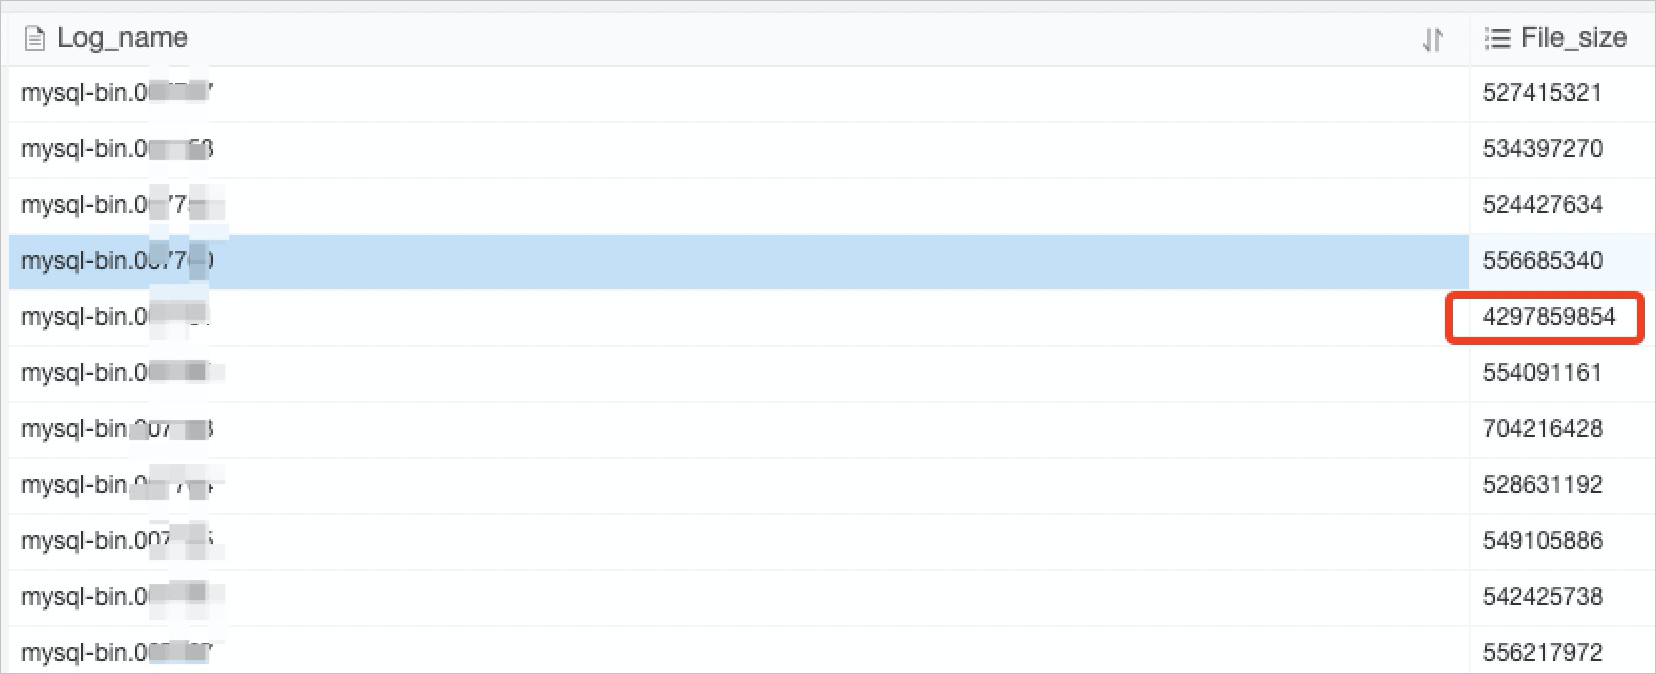
ディスク使用率、SQL ログ、またはスロークエリ統計を確認します。有用な兆候の 1 つとして、バイナリログ(binlog)ファイルは通常 500 MB ですが、500 MB を超える binlog ファイルが存在する場合は、バッチ操作が原因である可能性があります。
ApsaraDB RDS コンソールで、ナビゲーションウィンドウの モニタリングとアラート に移動します。標準モニタリング タブで、リソース監視 をクリックし、ディスク使用率および IOPS を確認します。エンジンモニタリング をクリックし、TPS を確認します。
解決策
バッチ操作はオフピーク時間帯にスケジュールしてください。オフピーク時間帯でのスケジュールが不可能な場合は、各バッチ操作をより小さなリクエストに分割し、順次送信することでピーク負荷を軽減してください。
未クローズのトランザクションによるスロー SQL のトラブルシューティング
原因
未クローズのトランザクションはロックを保持し続け、他のクエリをブロックします。影響を受けたクエリはキューに溜まり、スロー SQL として現れ、アクティブセッション数が増加します。
識別方法
ワークロードが突然遅くなったにもかかわらず CPU 使用率および IOPS が正常で、アクティブセッション数が増加し続ける場合は、未クローズのトランザクションが原因である可能性が高いです。これは、Data Management Service (DMS) を通じて手動で SQL ステートメントを実行した場合や、通常のアプリケーションフロー外で実行された場合によく発生します。
解決策
ロックを保持しているトランザクションを特定します。トランザクション間のロック競合を確認し、ブロッキングしている SQL ステートメントを終了させてロックを解放してください。
定期タスクによるスロー SQL のトラブルシューティング
原因
バッチ書き込みまたは更新を実行する定期タスクは、固定間隔で実行されます。オフピーク時間帯に設定されていても、ロックおよび I/O 負荷により他のワークロードと競合し、重複期間中にスロー SQL を引き起こすことがあります。
識別方法
インスタンスの負荷が一定の予測可能な間隔で急上昇する場合は、定期タスクが関与している可能性があります。モニタリングとアラート ページの 標準モニタリング タブのモニタリング情報を確認し、負荷パターンとタスクスケジュールを照合してください。
解決策
トラフィックが最も少ない時間帯にタスクを実行するようスケジュールを調整してください。複数の定期タスクがある場合は、ピーク負荷が重複しないようにずらして実行してください。
ネットワークの問題によるスロー SQL のトラブルシューティング
リソースメトリックおよび SQL ステートメントの分析がともに正常にもかかわらずワークロードが遅い場合は、ネットワーク接続方法を確認してください。インスタンスの詳細ページで データベース接続 に移動し、エンドポイントタイプを確認します。パブリックエンドポイントはプライベート(VPC)エンドポイントよりもレイテンシが高くなります。ご利用のアプリケーションが RDS インスタンスと同じ VPC 内の ECS インスタンスで実行されている場合は、ネットワーク遅延を低減するためにプライベートエンドポイントを使用して接続してください。詳細については、「インスタンスへの接続障害のトラブルシューティング」をご参照ください。
次のステップ
スロー SQL のさらなる調査には、以下のツールおよびトピックをご利用ください。