PolarDB for MySQL は、データベースカーネルと RDMA ネットワークを深く統合し、グローバル整合性 (高性能モード)、略して PolarDB-SCC (PolarDB-StronglyConsistentCluster) を提供します。これにより、データのグローバルな整合性を確保しながら、高性能なデータの読み書きを実現します。結果整合性ソリューションと比較して、グローバル整合性 (高性能モード) を有効にした後のクラスターのパフォーマンスオーバーヘッドは 10% 以内に収まります。本トピックでは、グローバル整合性 (高性能モード) の使用制限、技術的原則、有効化方法、およびパフォーマンスベンチマークの比較について説明します。
適用範囲
グローバル整合性 (高性能モード) を有効にするには、PolarDB for MySQL Enterprise Edition クラスターが次のいずれかのバージョンである必要があります。
8.0.2、カーネルのマイナーバージョンが 8.0.2.2.19 以降。
8.0.1、カーネルのマイナーバージョンが 8.0.1.1.29 以降。
5.7、カーネルのマイナーバージョンが 5.7.1.0.26 以降。
クラスターバージョンの確認方法の詳細については、「エンジンバージョンの照会」をご参照ください。
注意事項
グローバル整合性 (高性能モード) は、サーバーレスクラスター 内のすべての読み取り専用ノードでデフォルトで有効になっています。
グローバルデータベースネットワーク (GDN) のセカンダリクラスターの読み取り専用ノードは、グローバル整合性 (高性能モード) をサポートしていません。
グローバル整合性 (高性能モード) は 高速クエリキャッシュ と互換性があります。以前にグローバル整合性 (高性能モード) の階層的なきめ細かい変更追跡 (MTT) 最適化が有効になっていた場合、高速クエリキャッシュとグローバル整合性 (高性能モード) を同時に有効にすると、グローバル整合性 (高性能モード) の MTT 最適化は無効になります。
グローバル整合性 (高性能モード) の技術的ソリューション
PolarDB for MySQL のグローバル整合性 (高性能モード) は、新しく設計されたタイムスタンプベースのトランザクションシステムである PolarTrans 上に構築されています。これは、ネイティブ MySQL のアクティブトランザクション配列に基づく従来のトランザクション管理アプローチを再構築したものです。このシステムは、分散トランザクションのスケーリングをサポートし、単一ノードのパフォーマンスを大幅に向上させます。
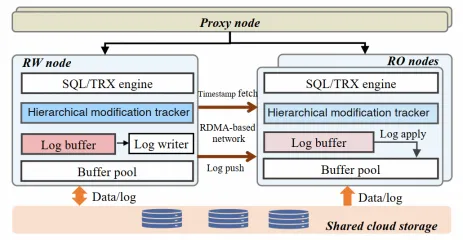
次の図は、PolarDB のグローバル整合性 (高性能モード) がどのように実装されているかを示しています。高速な RDMA ネットワークを使用して、対話的で多次元のプライマリ/セカンダリ情報同期メカニズムを構築し、従来のプライマリ/セカンダリのログレプリケーションアーキテクチャを置き換えます。線形 Lamport タイムスタンプアルゴリズムにより、読み取り専用 (RO) ノードがタイムスタンプを取得する回数が減り、ログ再生の不要な待機を回避します。
線形 Lamport タイムスタンプ:RO ノードが最新の変更タイムスタンプを取得する効率を向上させるため、システムは線形 Lamport タイムスタンプメカニズムを導入しています。従来のアプローチでは、RO ノードはリクエストを処理するたびに読み書き (RW) ノードからタイムスタンプを取得する必要がありました。高速なネットワークであっても、これは高負荷下で大きなオーバーヘッドを生み出します。線形 Lamport タイムスタンプを使用すると、RO ノードは RW ノードから取得したタイムスタンプをローカルに保存できます。ローカルに保存されたタイムスタンプより前のリクエストに対しては、RO ノードは RW ノードから再度タイムスタンプを取得することなく、ローカルのタイムスタンプを直接使用できます。このメカニズムは、高負荷下での頻繁なタイムスタンプ取得のオーバーヘッドを効果的に削減し、RO ノードのパフォーマンスを向上させます。
階層的なきめ細かい変更追跡:RO ノードのパフォーマンスを向上させるため、RW ノードはグローバル、テーブルレベル、ページレベルの 3 段階のタイムスタンプメカニズムを導入しています。RO ノードがリクエストを処理する際、まずグローバルタイムスタンプを取得します。グローバルタイムスタンプが RO ノードのログ再生済みタイムスタンプより新しい場合でも、RO ノードはすぐに待機状態には入りません。代わりに、リクエストがアクセスするテーブルとページのタイムスタンプを引き続き確認します。アクセスされたページのタイムスタンプがまだ条件を満たさない場合にのみ、RO ノードはログ再生が完了するのを待ちます。このメカニズムは、ログ再生の不要な待機を効果的に回避し、RO ノードの応答速度を向上させます。
RDMA ベースのログ転送:PolarDB のグローバル整合性 (高性能モード) は、片側 RDMA インターフェイスを使用して、RW ノードから RO ノードへログを転送します。これにより、ログ転送速度が大幅に向上し、ログ転送による CPU オーバーヘッドが削減されます。
線形 Lamport タイムスタンプ
読み取りリクエストのレイテンシーと帯域幅の消費を削減するため、RO ノードは線形 Lamport タイムスタンプメカニズムを使用できます。リクエストが RO ノードに到達し、別のリクエストがすでに RW ノードからタイムスタンプを取得している場合、RO ノードはそのタイムスタンプを直接再利用できます。これにより、繰り返しのリクエストを回避し、強い整合性を確保しながらパフォーマンスを向上させます。
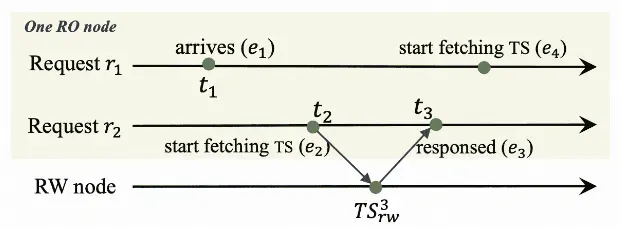
上の図では、2 つの同時読み取りリクエスト r1 と r2 が RO ノードに到達します。r2 は t2 で RW ノードにタイムスタンプを要求し、t3 で RW ノードのタイムスタンプ TS3rw を取得します。これらのイベントの関係は e2TS3rwe3 です。r1 は t1 に到着します。RO ノード上の各イベントにタイムスタンプを割り当てることで、同じ RO ノード上の異なるイベントの順序が決定されます。t1 が t2 より前の場合、イベントの関係は e1e2TS3rwe3 となります。つまり、r2 が取得したタイムスタンプは、r1 が到着する前に行われたすべての更新をすでに反映しています。したがって、r1 は新しいタイムスタンプを取得することなく、r2 のタイムスタンプを直接使用できます。この原則に基づき、RO ノードは RW ノードからタイムスタンプを取得するたびに、そのタイムスタンプをローカルに保存し、タイムスタンプを取得した時刻を記録します。リクエストの到着時刻がローカルにキャッシュされたタイムスタンプの取得時刻より前であれば、そのリクエストはそのタイムスタンプを直接使用できます。
階層的なきめ細かい変更追跡
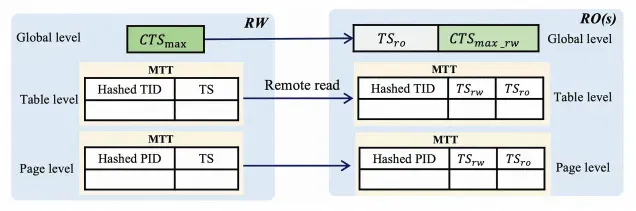
強い整合性のある読み取りを実行するために、RO ノードはまず RW ノード上の現在のトランザクションの最新のコミットタイムスタンプを取得し、ログがそのタイムスタンプまで再生されるのを待ってから読み取りリクエストを処理する必要があります。しかし、RO ノードがログ再生を待っている間、現在のリクエストが必要とするデータはすでに最新であり、待機は不要な場合があります。この不要な待機を避けるため、PolarDB のグローバル整合性 (高性能モード) は、よりきめ細かい変更追跡を使用します。RW ノードは、グローバルな最新変更タイムスタンプ、テーブルレベルのタイムスタンプ、ページレベルのタイムスタンプという 3 段階の変更情報を維持します。
読み取りリクエストを処理する際、RO ノードはまずグローバルタイムスタンプを取得してデータの一貫性を判断します。グローバルタイムスタンプが条件を満たさない場合、RO ノードはさらにターゲットテーブルのローカルタイムスタンプを取得して、よりきめ細かい検証を行います。それでも条件が満たされない場合、RO ノードはターゲットページのタイムスタンプを引き続きチェックして、より正確な判断を下します。RO ノードがログ再生を待つ必要があるのは、ページのタイムスタンプがまだログ再生済みタイムスタンプより新しい場合のみです。これにより、RO ノードが最新のデータを読み取ることが保証されます。
RW ノードでは、メモリ消費量を削減するために、3 段階すべてのタイムスタンプがメモリ内のハッシュテーブルに格納されます。メモリ使用量をさらに最適化するため、複数のテーブルやページのタイムスタンプを同じハッシュテーブルエントリにマッピングすることができます。一貫性を確保するため、より小さいタイムスタンプをより大きいタイムスタンプで置き換えることしかできません。この設計により、RO ノードがより大きいタイムスタンプを取得した場合でも、一貫性が損なわれないことが保証されます。次の図は実装を示しており、TID と PID はそれぞれテーブル ID とページ ID を示します。RO ノードによって取得されたタイムスタンプは、線形 Lamport タイムスタンプの設計に基づいてローカルにキャッシュされ、他の適格なリクエストがそれを使用できるようになります。
RDMA ベースのログ転送
PolarDB のグローバル整合性 (高性能モード) では、RW ノードは片側 RDMA を介して RO ノードのキャッシュにログをリモートで書き込みます。このプロセスは RO ノードの CPU を必要とせず、低レイテンシーです。次の図は実装を示しています。RO ノードと RW ノードは両方とも同じサイズのログバッファを維持します。RW ノードのバックグラウンドスレッドが、RDMA を介して RW ログバッファを RO ログバッファに書き込みます。RO ノードはファイルを読み取る代わりにローカルのログバッファを読み取るため、レプリケーションの同期が高速化されます。
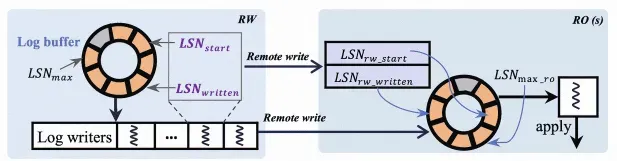
RDMA ベースのログ転送の詳細については、「RDMA ベースのログ転送」をご参照ください。
グローバル整合性 (高性能モード) の有効化
PolarDB コンソールにログインします。対象のクラスターの 基本情報 ページで、データベースへの接続 セクションで、グローバル一貫性 (高性能モード) を有効にする接続アドレスを選択し、設定 をクリックし、一貫性レベル を グローバル整合性 (強) に設定し、グローバル整合性モード を 高性能モード に設定します。詳細については、「データベースプロキシを設定する」をご参照ください。
グローバル整合性 (高性能モード) は、クラスター内のすべてのアドレスで同時に有効になります。1 つのアドレスで有効にすると、クラスター内の他のすべてのアドレスでも有効になります。
パフォーマンスの比較
テスト環境
8 コア、32 GB メモリの Cluster Edition の PolarDB for MySQL 8.0 クラスター。
テストツール
Sysbench
テストデータ量
25 テーブル、各テーブルに 250,000 行。
テスト結果と説明
次の図は、グローバル整合性 (高性能モード) クラスターの混合読み書きパフォーマンスの比較を示しています。グラフの説明:
縦軸 (qps):Sysbench のテスト結果。
横軸 (threads):テスト中に使用された同時 Sysbench スレッド数。
RW:すべての読み書きリクエストは RW ノードに送信されます。RO ノードがグローバルに整合性のある読み取りを提供できないと仮定します。
グローバル整合性:プロキシによって提供されるグローバル整合性機能。
グローバル整合性 (高性能モード):カーネルが提供するグローバル整合性 (高性能モード) を有効にするプロキシ設定。
結果整合性:プロキシは結果整合性の読み取り用に設定され、カーネルが提供するグローバル整合性 (高性能モード) は無効になります。
sysbench oltp_read_writeシナリオでは、結果整合性と比較して、グローバル整合性 (高性能モード) のクラスター全体のパフォーマンスオーバーヘッドは 10% 以内です。