このトピックでは、データソースとして MaxCompute を使用するテーブルを追加する方法について説明します。
前提条件
MaxCompute は、以前は ODPS と呼ばれていました。詳細については、「MaxCompute とは」をご参照ください。
OpenSearch へのログインに使用する Alibaba Cloud アカウントには、MaxCompute テーブルに対する必要な権限が必要です。これらの権限には、describe、select、download、および label 権限が含まれます。
次のステートメントは、権限を付与する方法を示しています。
-- ユーザーを追加
add user ****@aliyun.com;

-- ユーザーに必要なテーブル権限を付与
GRANT describe,select,download ON TABLE table_xxx TO USER ****@aliyun.com
GRANT describe,select,download ON TABLE table_xxx_done TO USER ****@aliyun.com

-- MaxCompute ではフィールドレベルの権限検証が有効になっているため、データ取得時に高権限フィールドにアクセスできず、インデックスビルドが失敗する場合があります。この場合、ユーザーにフィールドレベルのアクセス権限を付与する必要があります。
-- プロジェクト全体に権限を付与
SET LABEL 3 to USER ****@aliyun.com

-- 単一のテーブルに権限を付与
GRANT LABEL 3 ON TABLE table_xxx(col1, col2) TO ****@aliyun.com
Vector Search Edition は、MaxCompute テーブルの次のフィールドタイプをサポートします:STRING、BOOLEAN、DOUBLE、BIGINT、および DATETIME。
CREATE TABLE ステートメントとパラメーター設定の詳細については、「MaxCompute データソースの CREATE TABLE ステートメント」をご参照ください。
テーブルの追加
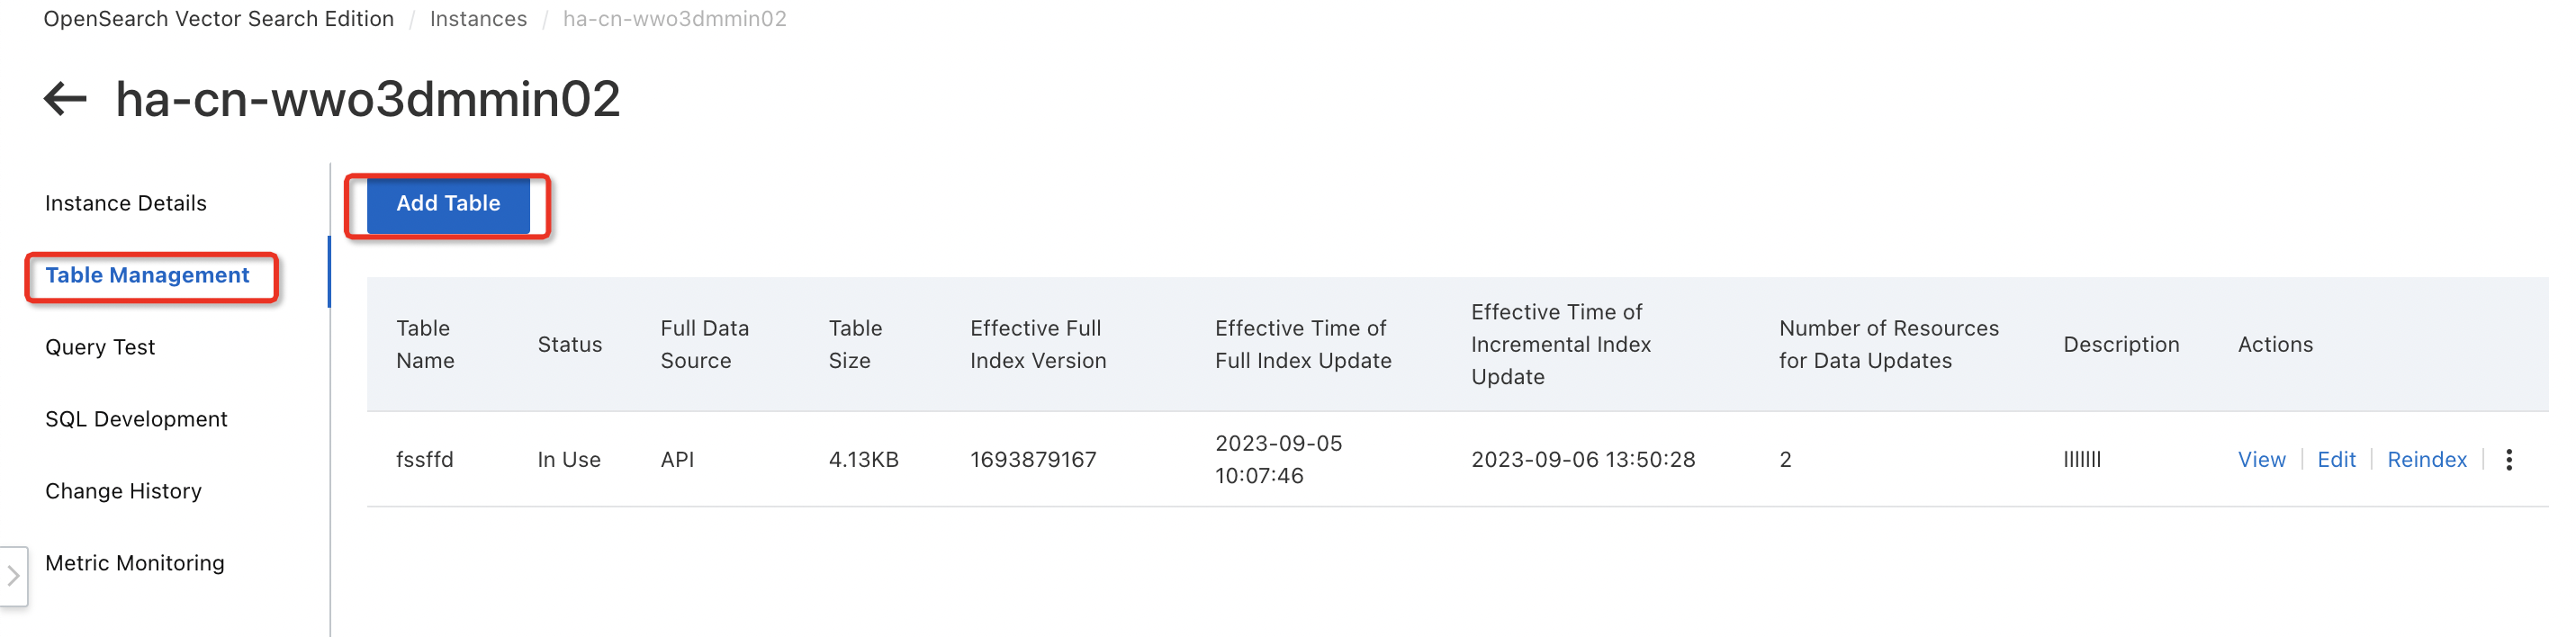
[インスタンス詳細] > [テーブル管理] ページで、 [テーブルの追加] をクリックします。
テーブルの基本情報を入力し、 [次へ] をクリックします。
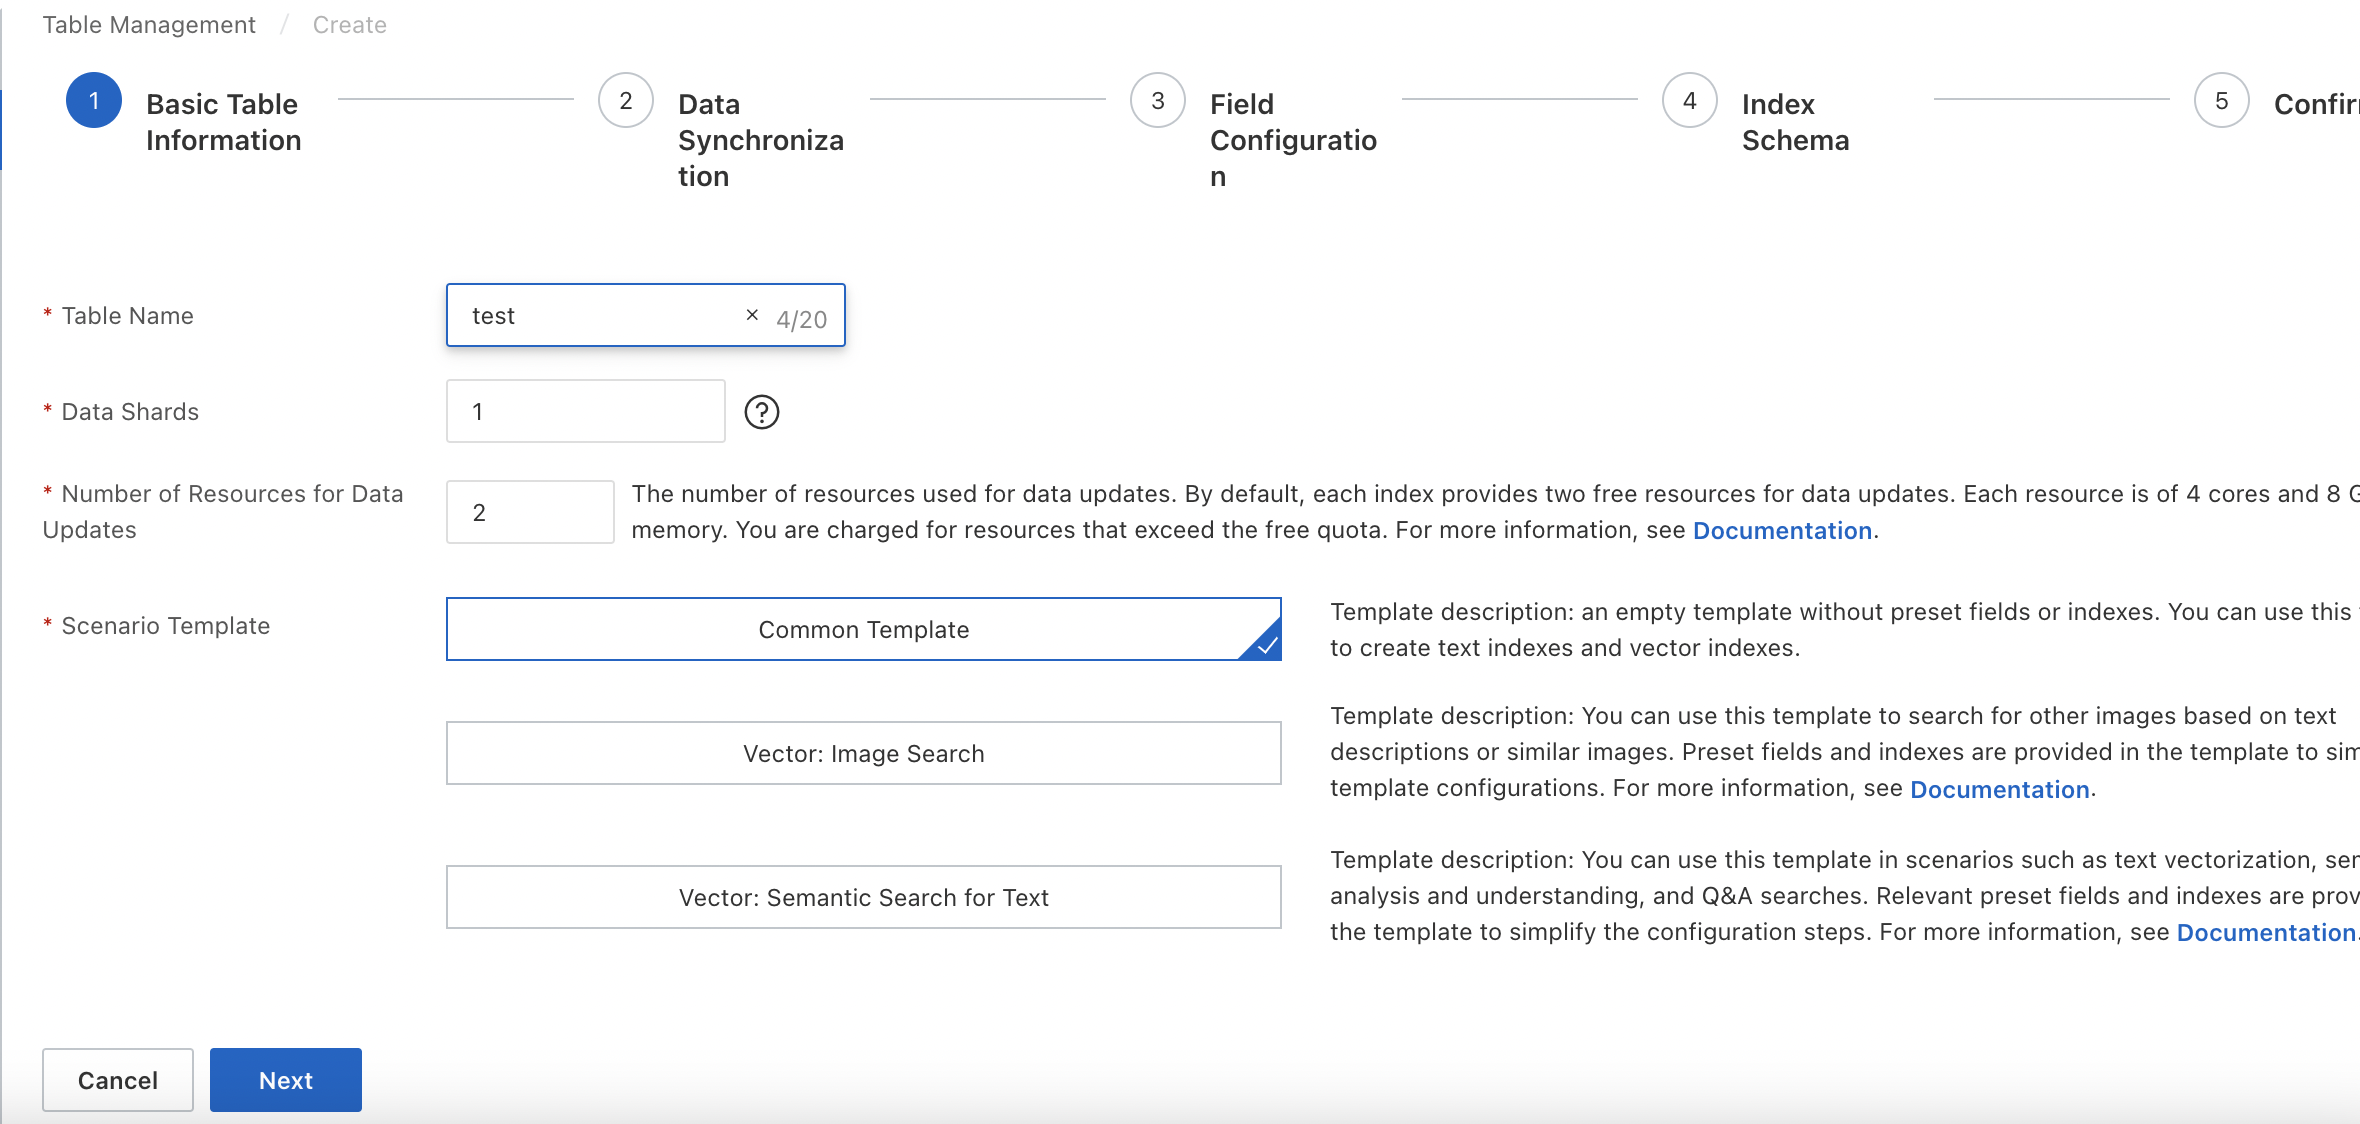
パラメーターの説明:
テーブル名:テーブルのカスタム名。
シャード数:256 までの正の整数を入力します。シャードは、フルデータビルドの速度と個々のクエリのパフォーマンスを向上させます。一部の既存のインスタンスでは、すべてのインデックステーブルでシャード数が同じである必要があります。または、1 つのインデックステーブルは 1 シャード、他のテーブルは同数のシャードを持つ構成も可能です。
データ更新リソース:データ更新に使用されるリソースの数。デフォルトでは、各インデックスには 2 つの 4 コア 8 GB の更新リソースの無料クォータが割り当てられています。無料クォータを超えるリソースは課金されます。詳細については、「」および「」をご参照ください。
シナリオテンプレート:Vector Search Edition は、General、Vector - Image Search、Vector - Text Semantics の 3 つの組み込みテンプレートを提供します。
データ同期用のデータソースを設定します。設定内容の検証後、 [次へ] をクリックします。
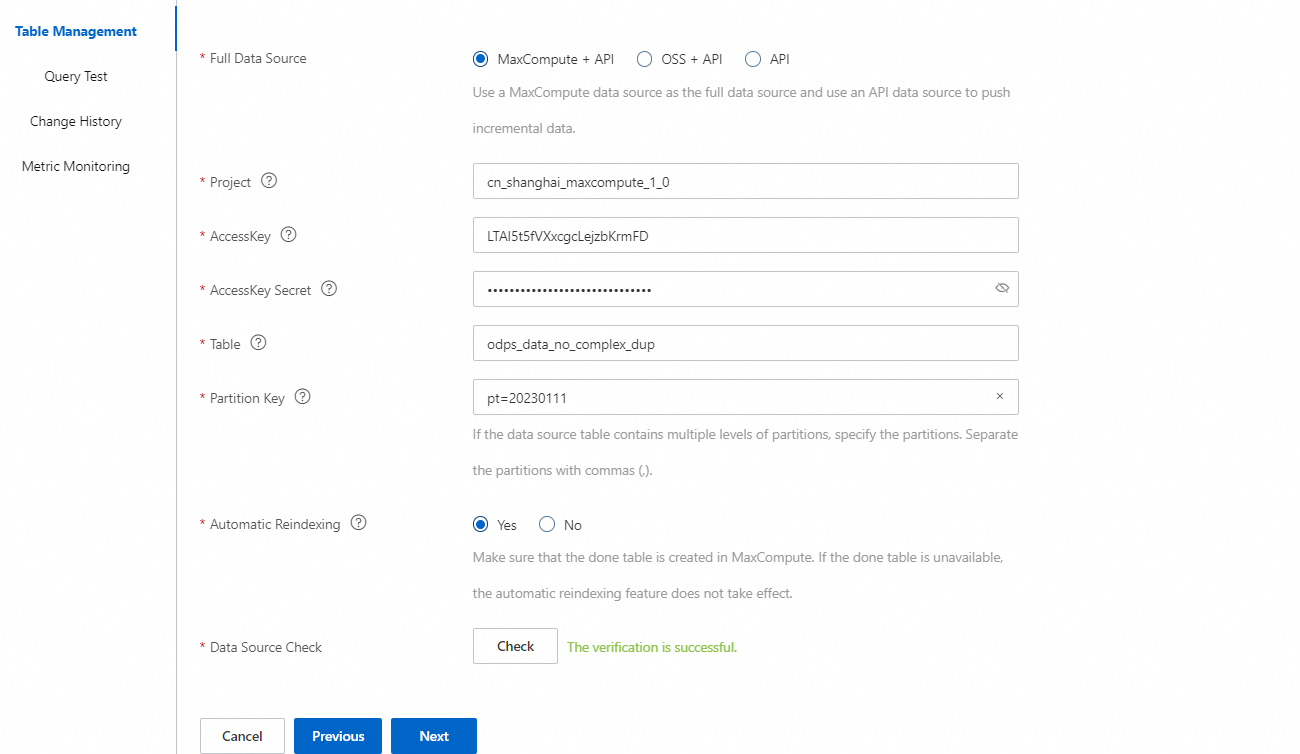
パラメーターの説明:
データソースタイプ: MaxCompute を選択します。
プロジェクト:対象の MaxCompute プロジェクトの名前。
accesskeyId:Alibaba Cloud アカウントまたは Resource Access Management (RAM) ユーザーの AccessKey ID。
accesskeySecret:AccessKey ID に対応する AccessKey シークレット。
テーブル:対象の MaxCompute テーブルの名前。
パーティションキー (partition):MaxCompute データソースにはパーティションキーを設定する必要があります。例:ds=20170626。
タイムスタンプ:フルデータビルドに続く、APIからの増分データ取得の開始点を指定します。システムは過去3日間の増分APIデータを取得できます。
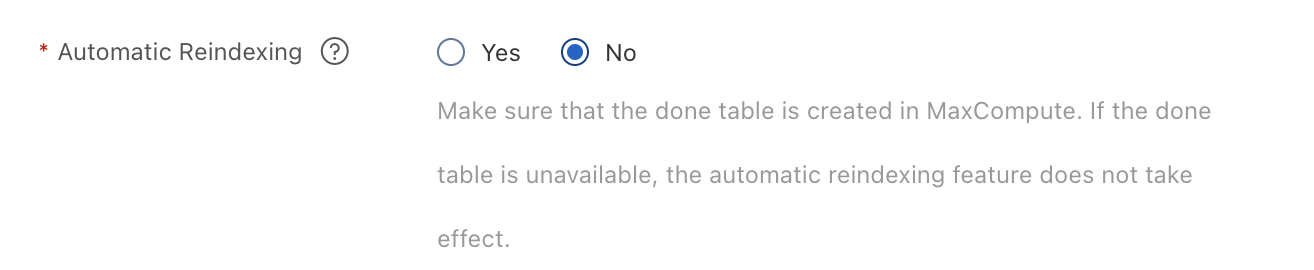
自動インデックス再構築:インデックスの自動再構築を有効にするかどうかを指定します。有効にすると、変更が検出されたときに、このデータソースを参照するテーブルのインデックスをシステムが自動的に再構築します。
自動インデックス再構築を有効にする場合は、done テーブルを作成する必要があります。手順については、後述の「自動インデックス再構築」をご参照ください。
フィールドを設定し、 [次へ] をクリックします。
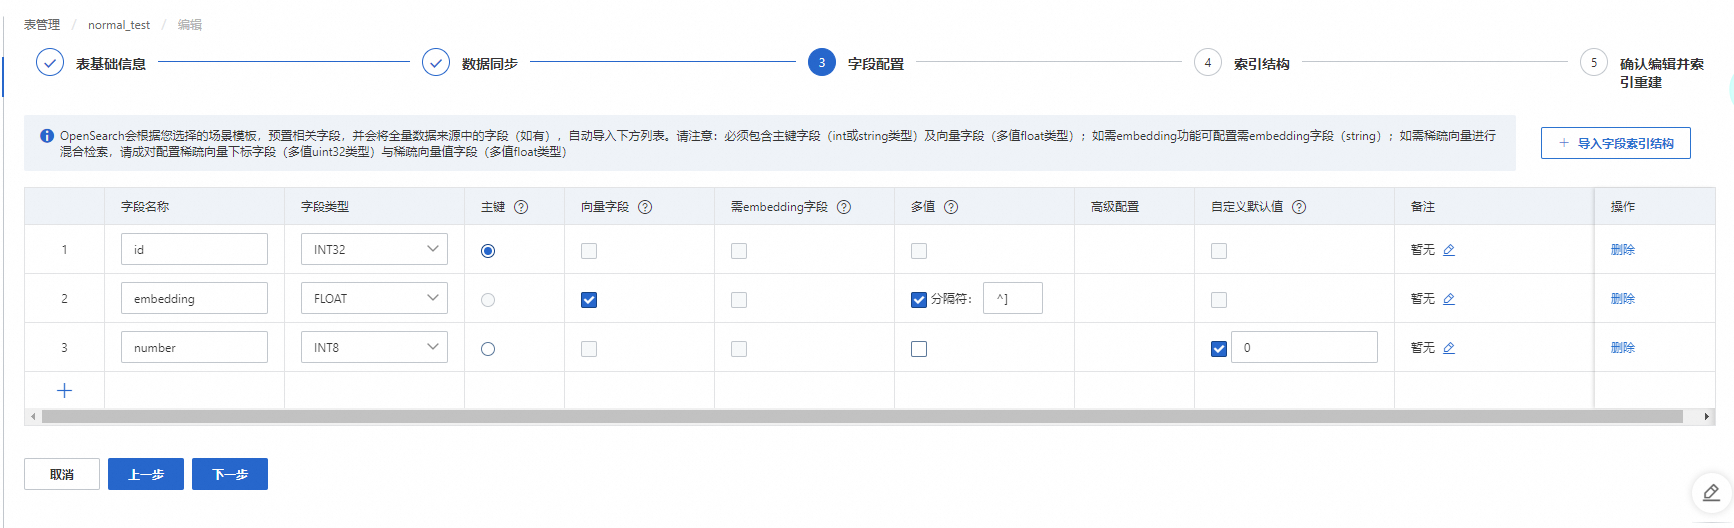
プライマリキーフィールドとベクトルフィールドは必須です。プライマリキーフィールドは INT または STRING 型で、その [プライマリキー] チェックボックスにチェックを入れる必要があります。ベクトルフィールドは FLOAT 型で、その [ベクトルフィールド] チェックボックスにチェックを入れる必要があります。
デフォルトでは、ベクトルフィールドは複数値の FLOAT 型です。デフォルトの複数値の区切り文字は、ha3 の区切り文字
^](UTF-8 エンコーディング:\x1D) です。カスタムの複数値の区切り文字を入力することもできます。データ内のフィールドが欠落しているか空の場合、システムは自動的にデフォルト値を設定します。デフォルト値は、数値型の場合は 0、STRING 型の場合は空の文字列です。[カスタムのデフォルト値] を指定することもできます。
インデックススキーマを設定し、 [次へ] をクリックします。
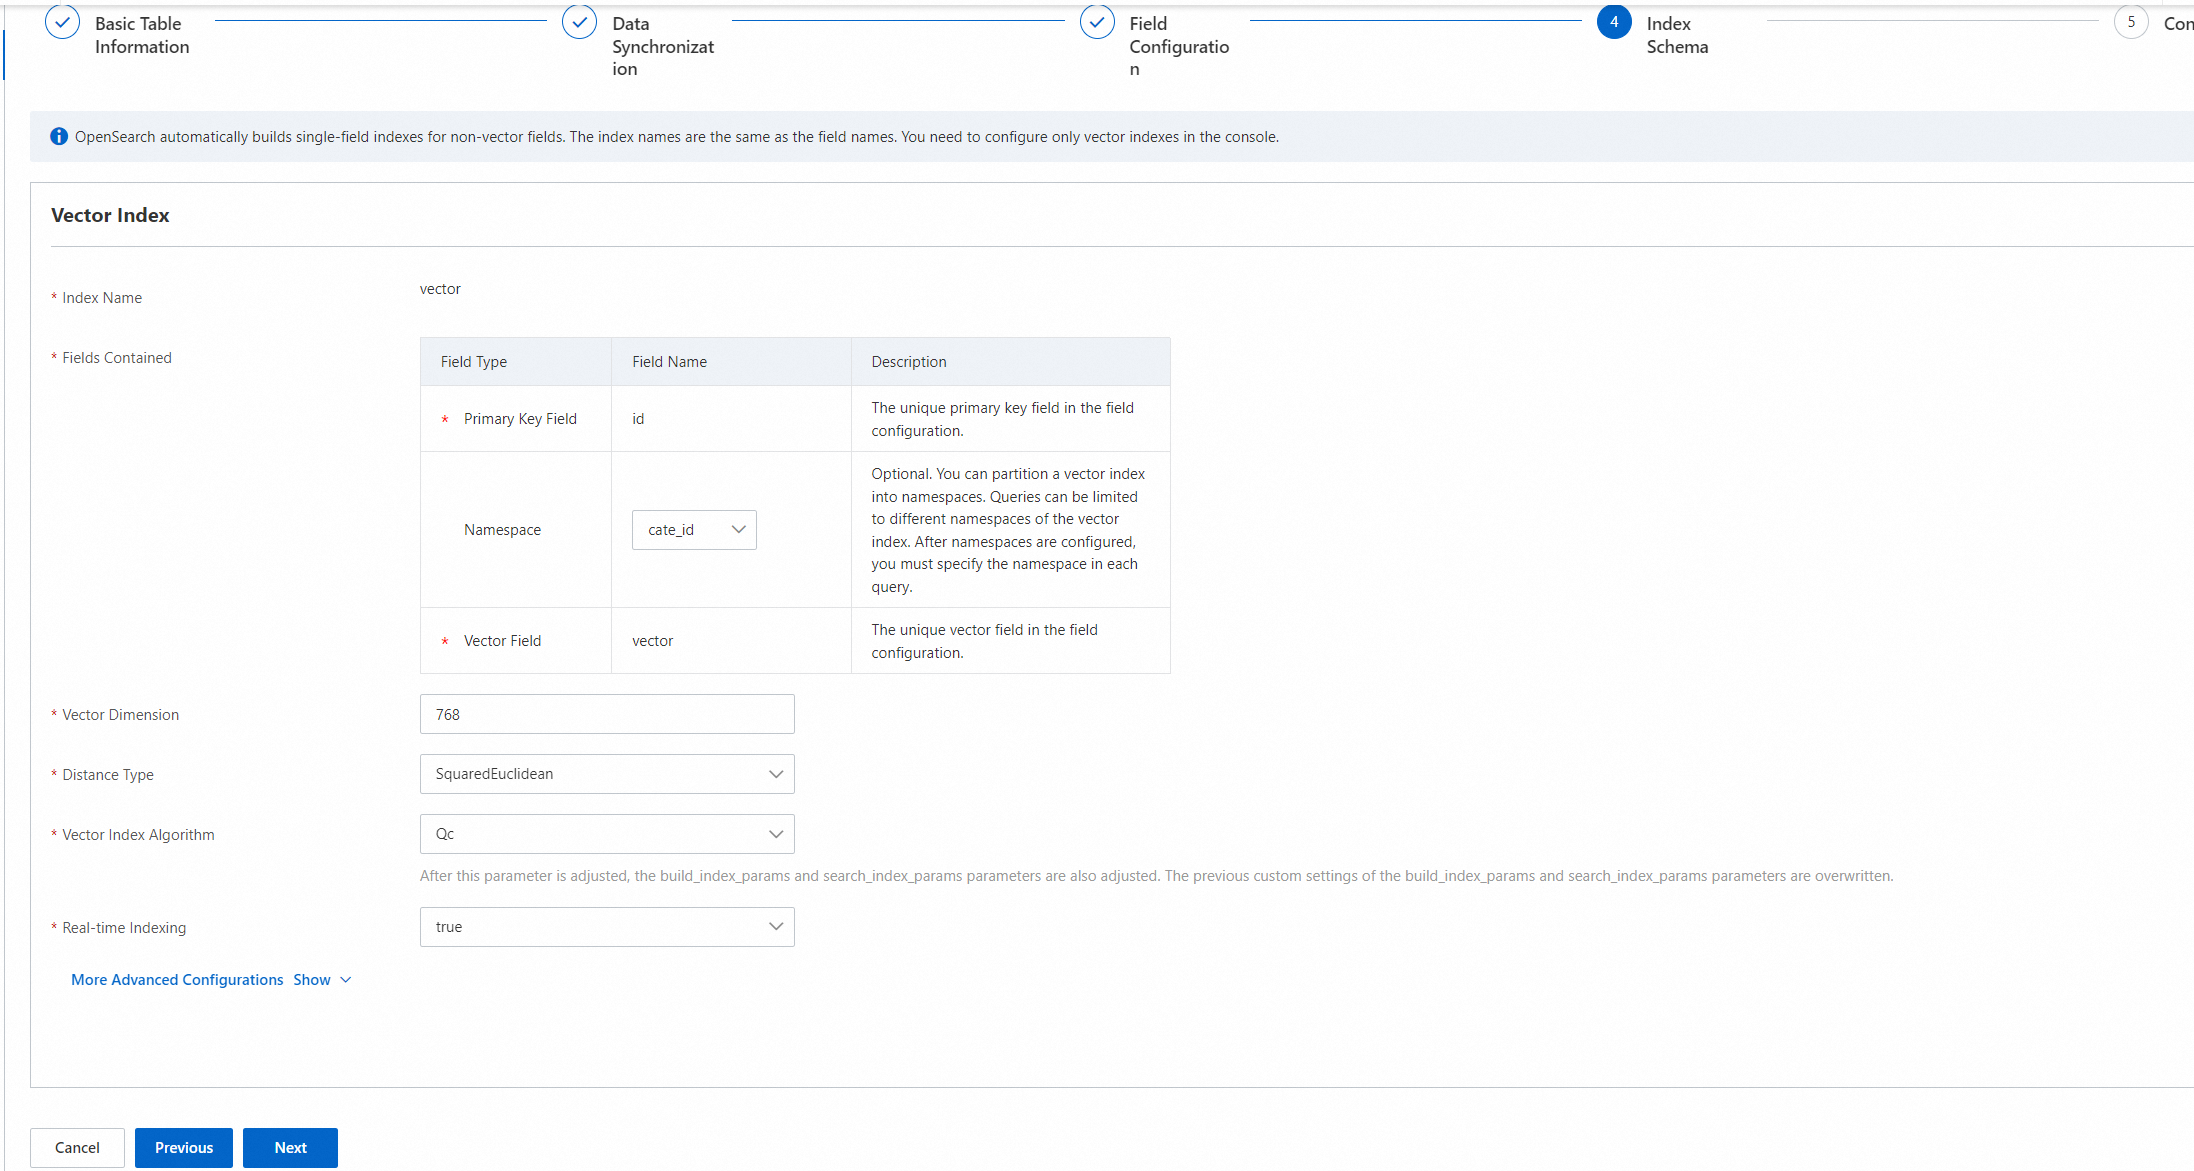
このセクションでは、ベクトルインデックスの設定方法について説明します。
プライマリキーフィールドとベクトルフィールドは必須です。namespace フィールドはオプションであり、省略可能です。
これらの 3 つの固定フィールドからのみ選択できます。新しいフィールドは追加できません。
ベクトル次元:モデルが生成したベクトルに基づいて次元を選択します。
距離メトリック:モデルが生成したベクトルに基づいてメトリックを選択します。システムは、SquareEuclidean と内積の 2 つの距離メトリックをサポートします。
ベクトルインデックスアルゴリズム:モデルが生成したベクトルに基づいてアルゴリズムを選択します。システムは、Quantized Clustering、linear、HNSW (Hierarchical Navigable Small World) のベクトルインデックスアルゴリズムをサポートします。
リアルタイムインデックス:API からの増分データに対してリアルタイムでベクトルインデックスを構築するかどうかを指定します。デフォルト値は true です。
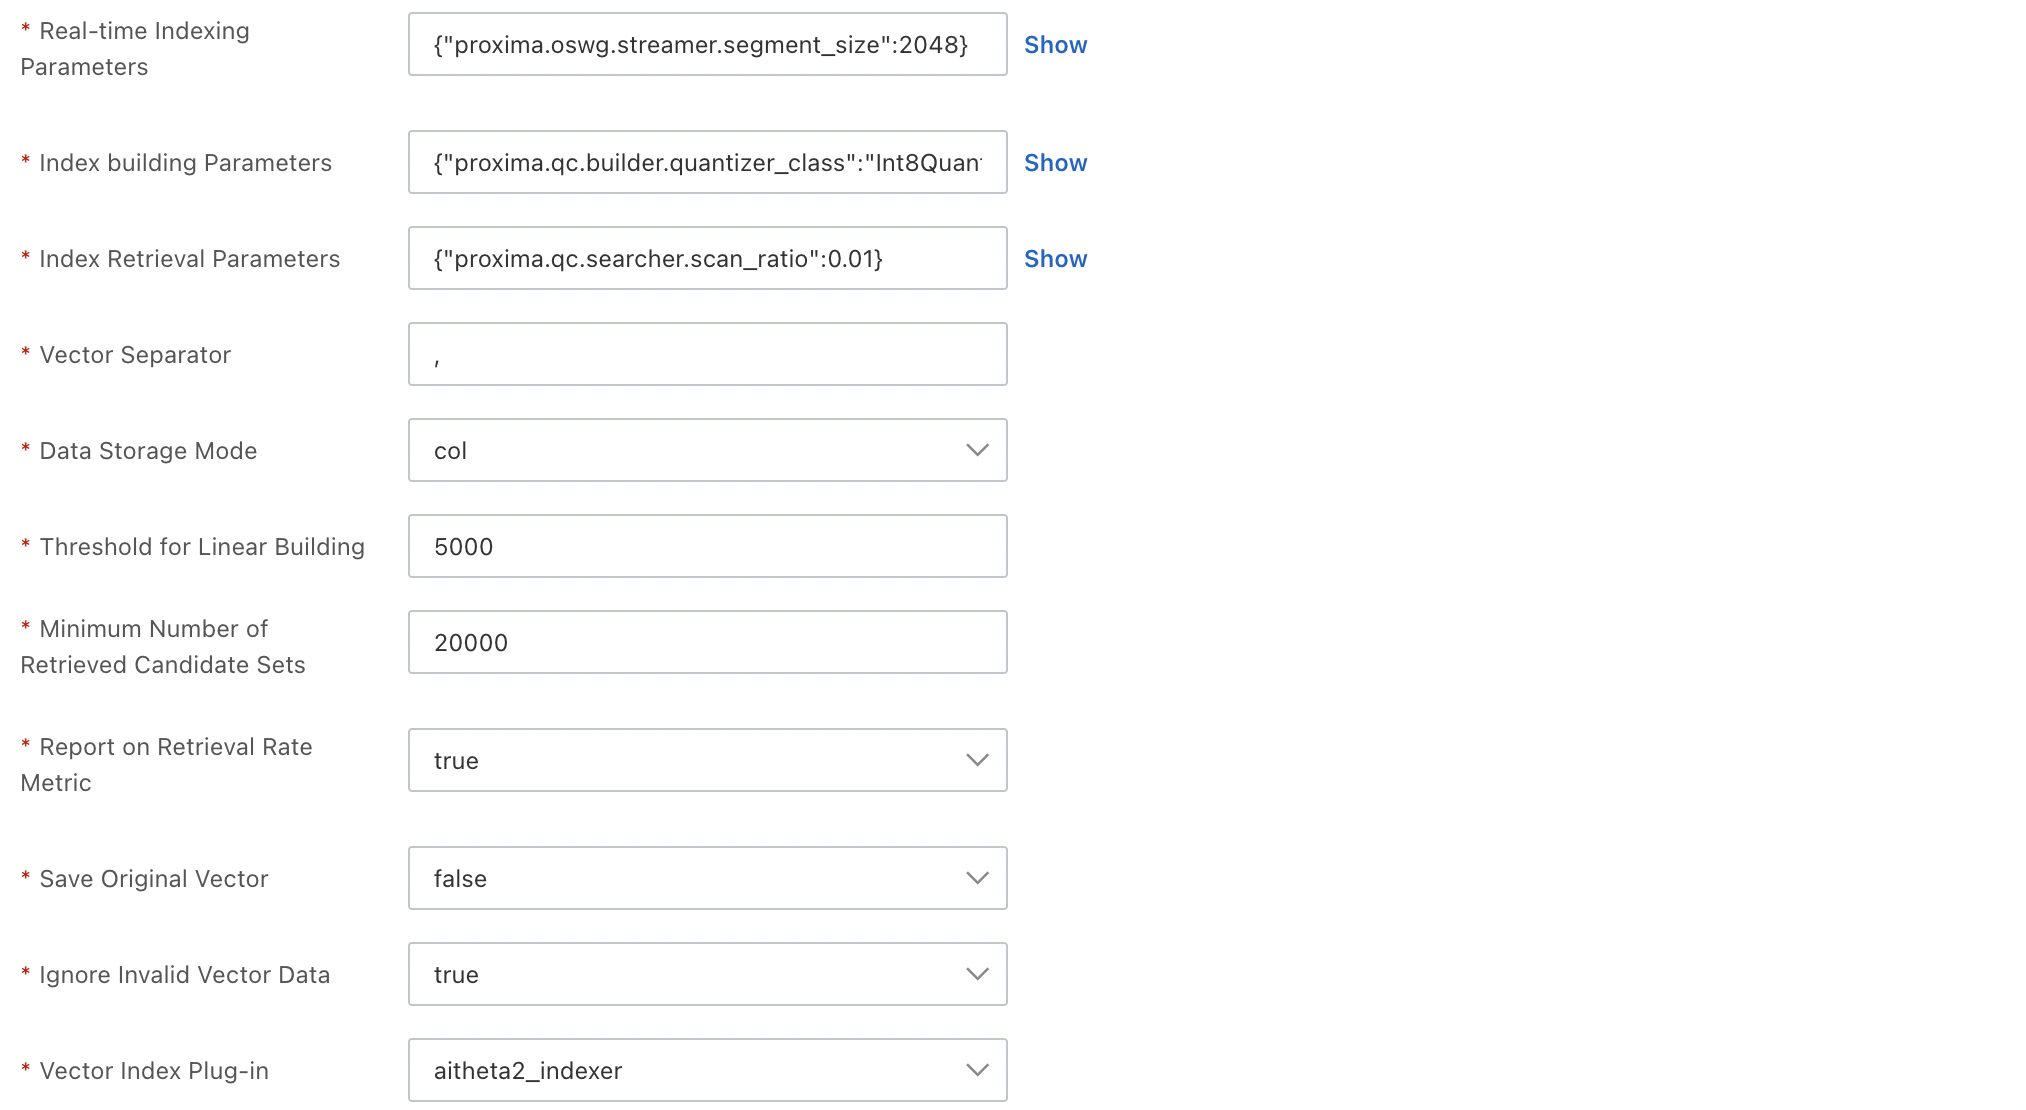
その他の詳細設定を設定するには、クリックしてセクションを展開します。パラメーターの説明については、「ベクトルインデックスの一般設定」をご参照ください。
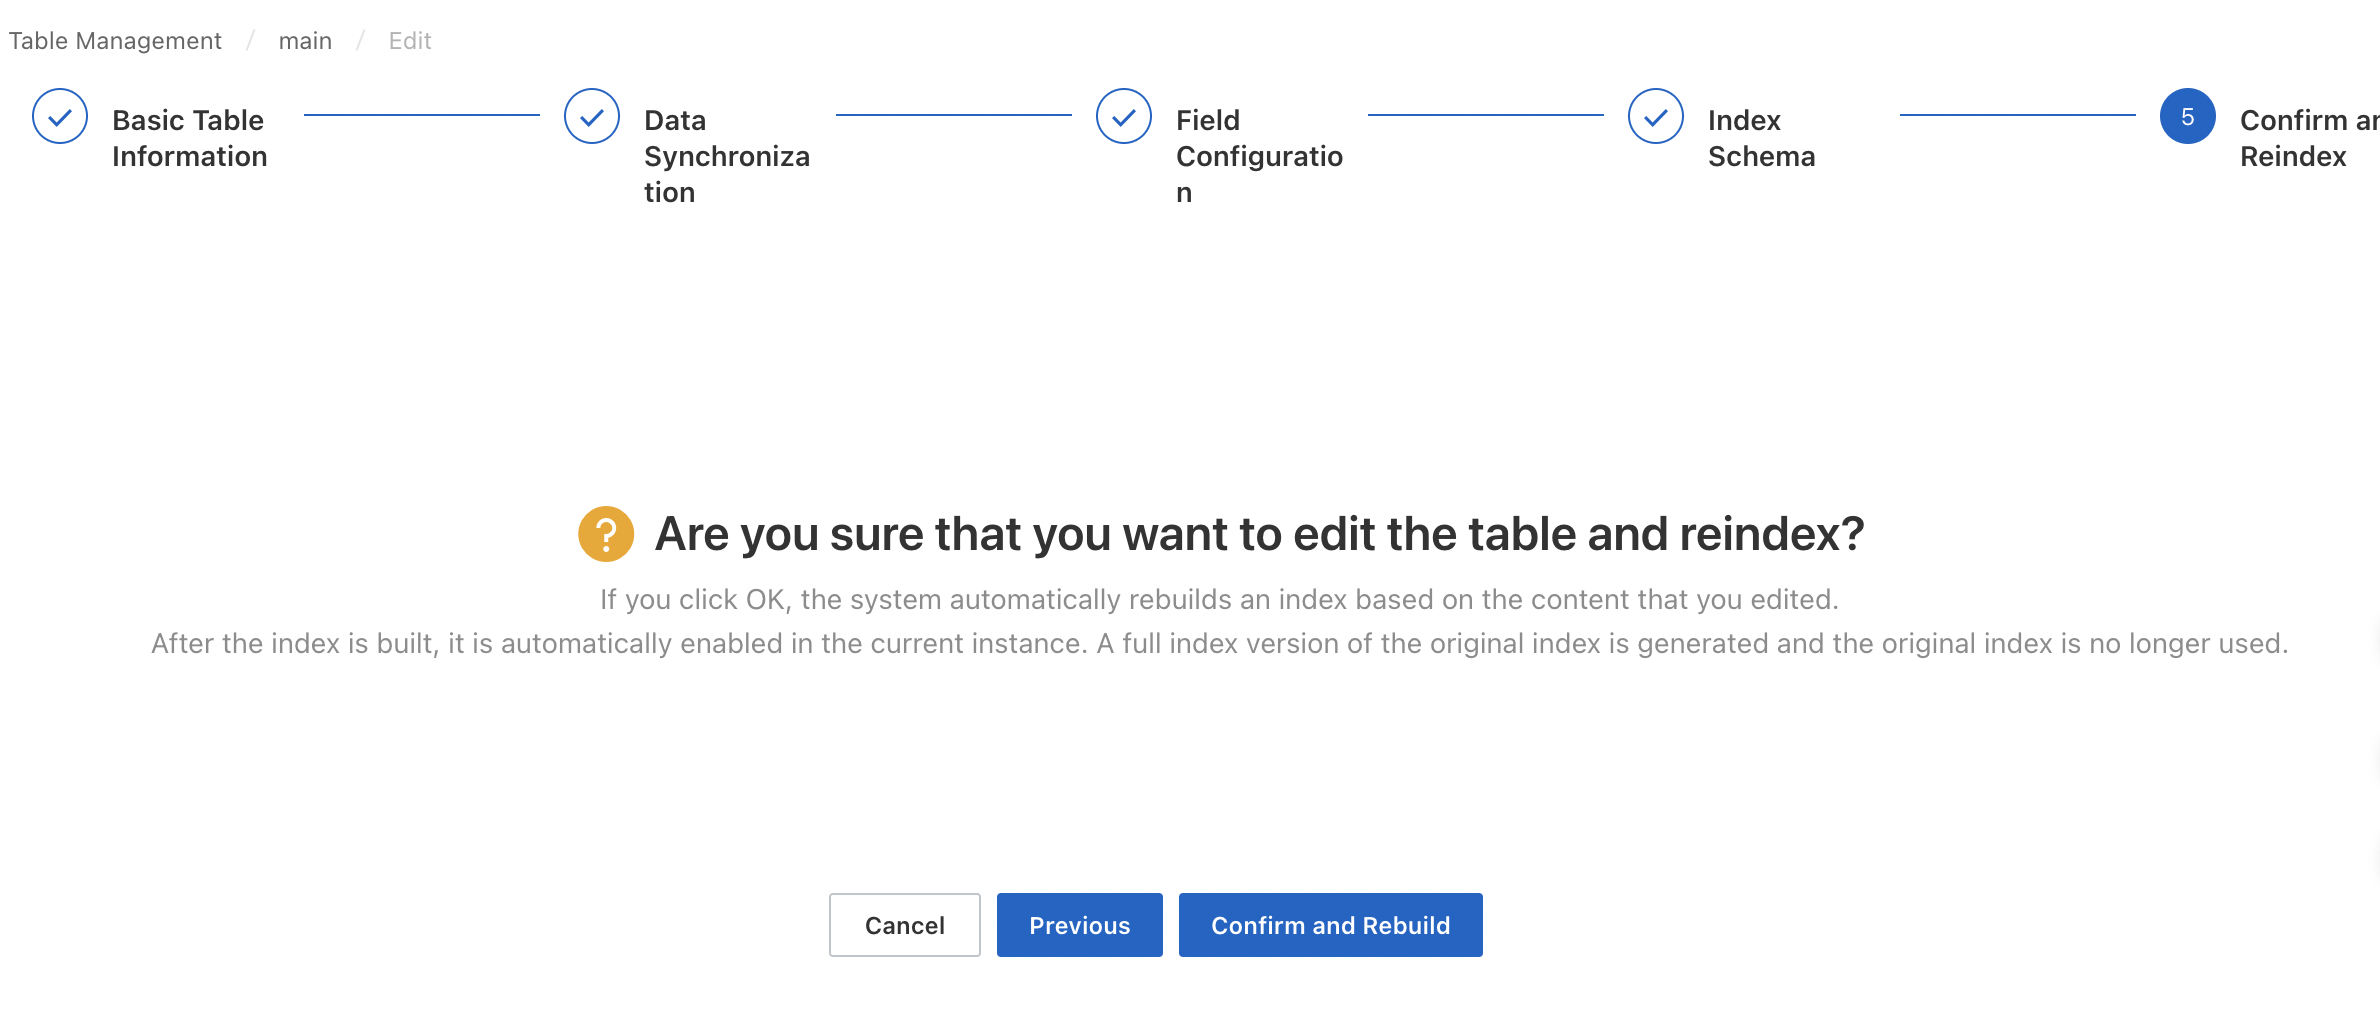
設定を確認します。 [作成の確認] をクリックすると、システムが自動的にテーブルを作成します。
変更履歴で作成の進捗状況を確認できます。
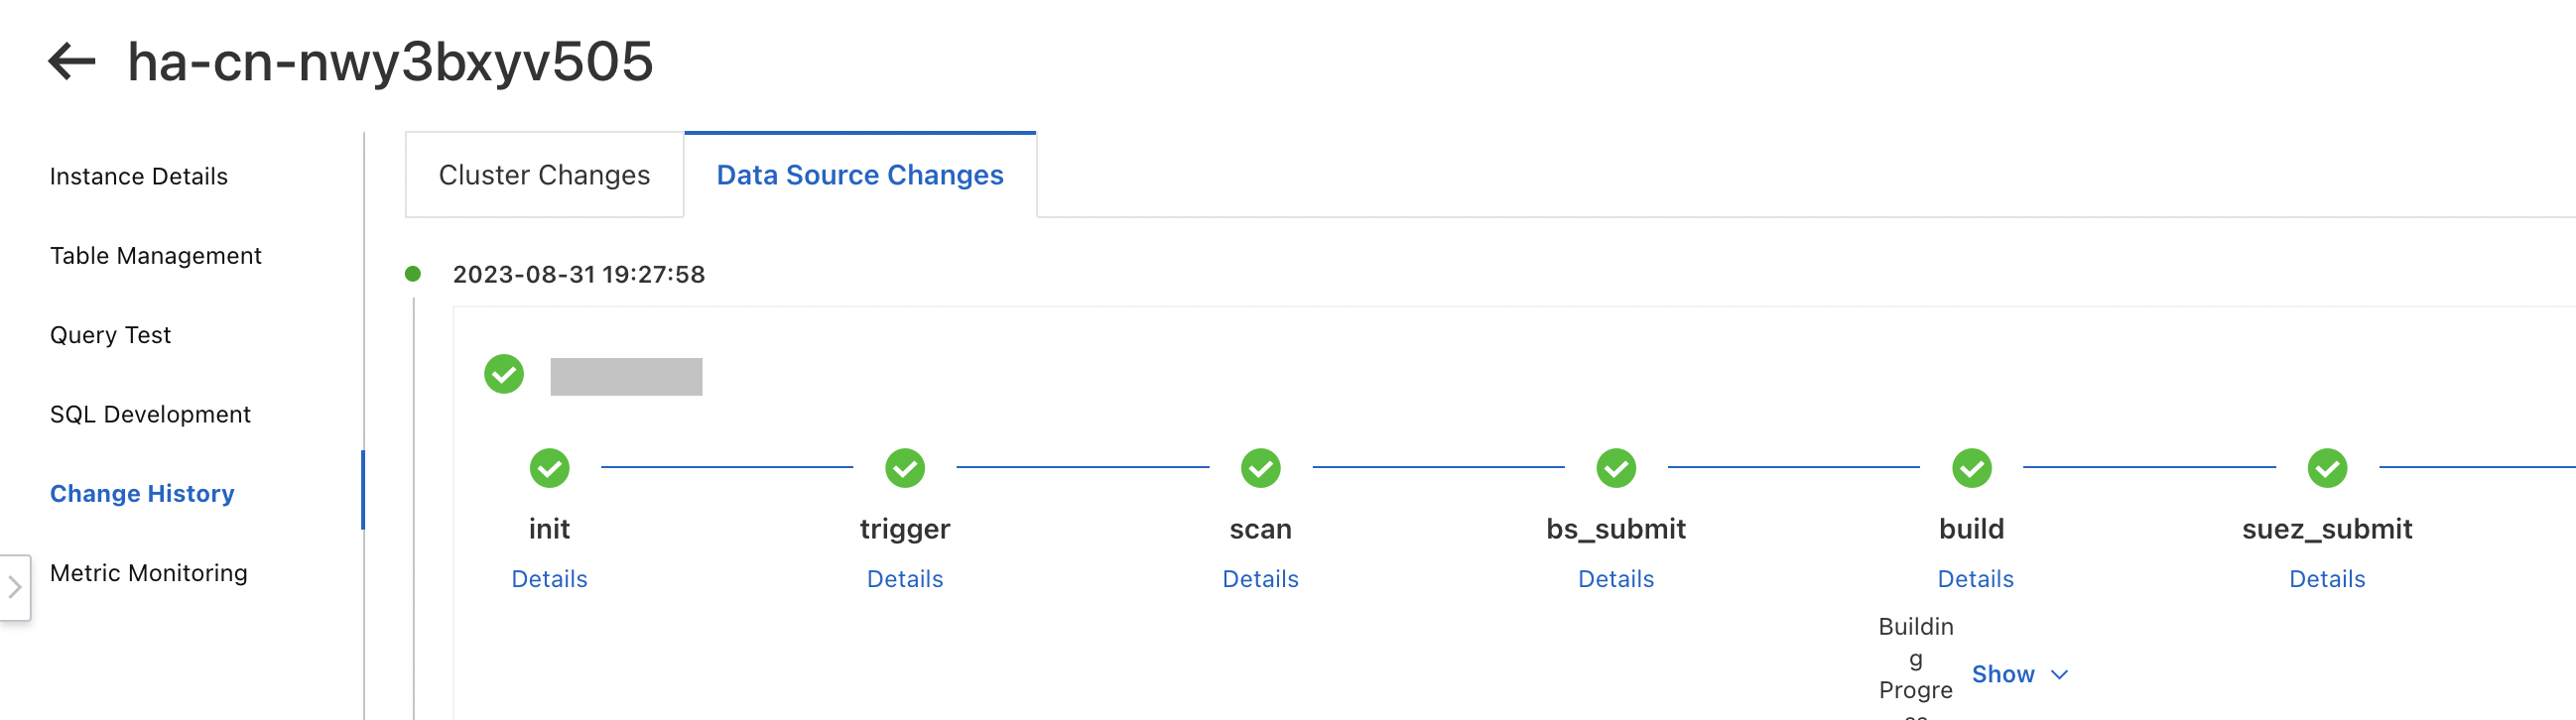
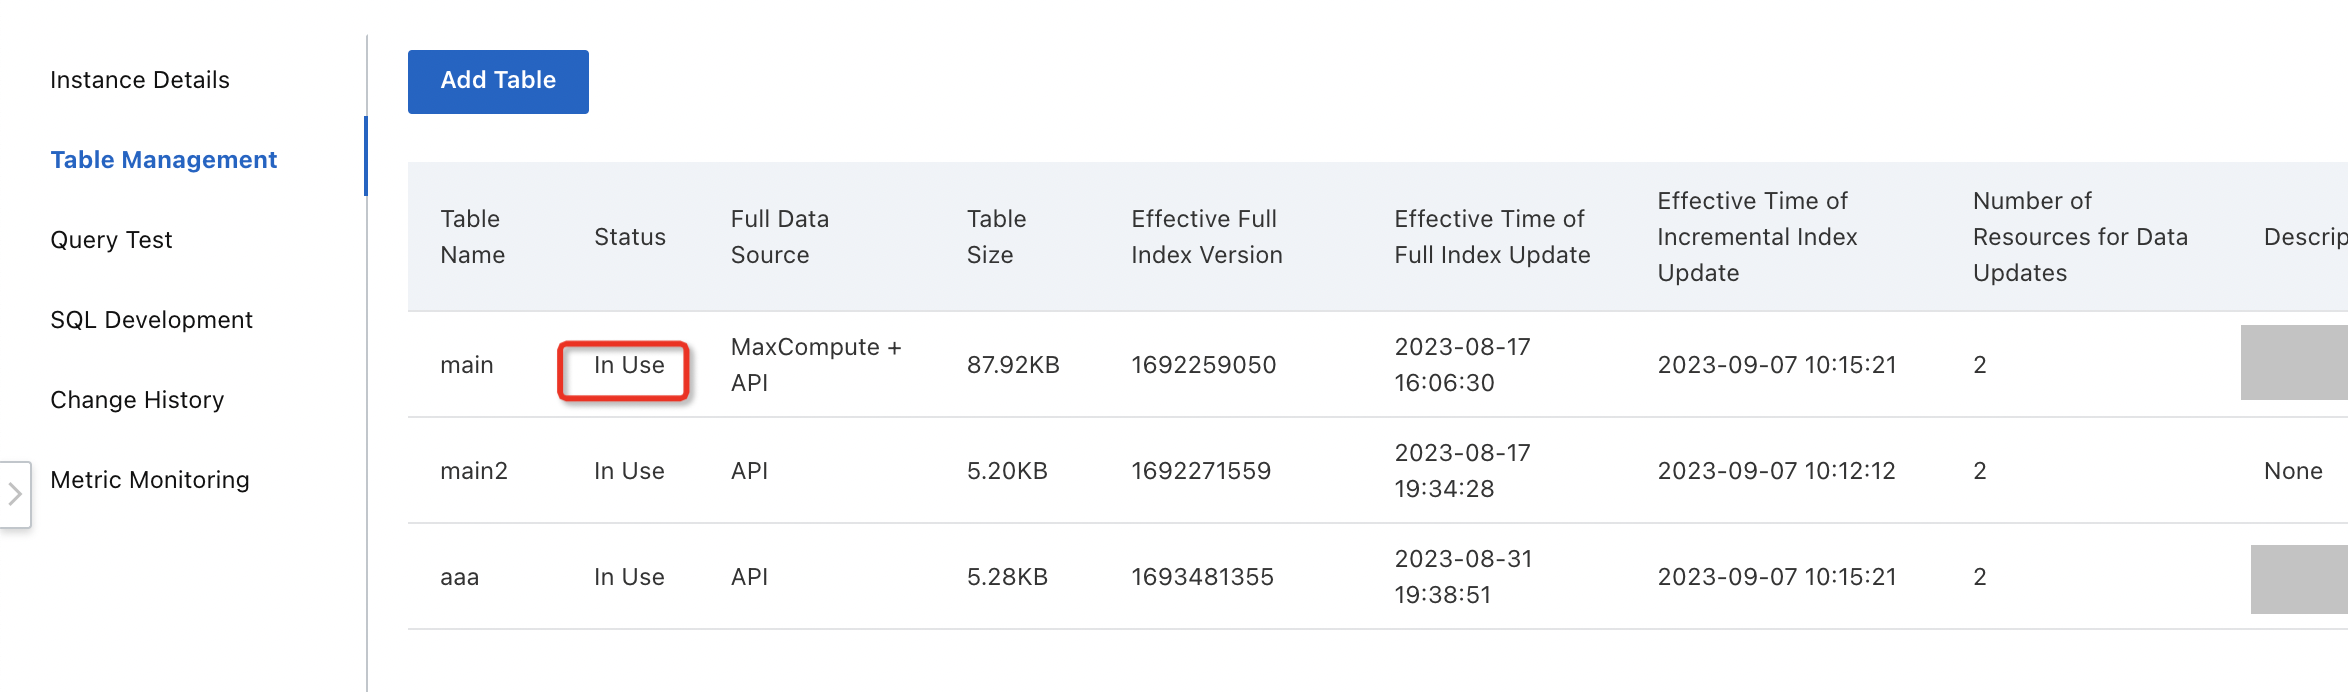
テーブルのステータスが [使用中] に変わったら、 [クエリテスト] ページでクエリをテストできます。
自動インデックス再構築
done テーブルの目的:データソースの自動インデックス再構築を有効にすると、Vector Search Edition インスタンスは done テーブルの変更に基づいてインデックスを自動的に再構築します。
たとえば、MaxCompute データテーブルの名前が mytable で、ds=20220113 によってパーティション分割されているとします。データソースを設定し、初めてインデックスを再構築すると、全量データを含む新しいパーティションが毎日生成されます。Vector Search Edition インスタンスが新しいパーティションをスキャンし、自動的にインデックスを再構築して新しいデータを取得させたい場合は、自動インデックス再構築機能とdone テーブルを使用する必要があります。
手順:
データソースを追加するときに、 [自動インデックス再構築] を有効にします。
MaxCompute で、done テーブルを作成します。データテーブルの名前が
mytableでパーティションキーがdsの場合、done テーブルの名前はmytable_doneで、そのパーティションキーもdsである必要があります。2 つのテーブルは MaxCompute で次のように表示されます。
odps:sql:xxx> show tables;
InstanceId: xxx
SQL: .

ALIYUN$****@aliyun.com:mytable          # 全量データソーステーブル
ALIYUN$****@aliyun.com:mytable_done     # インデックスの自動全量再構築を制御する done テーブル
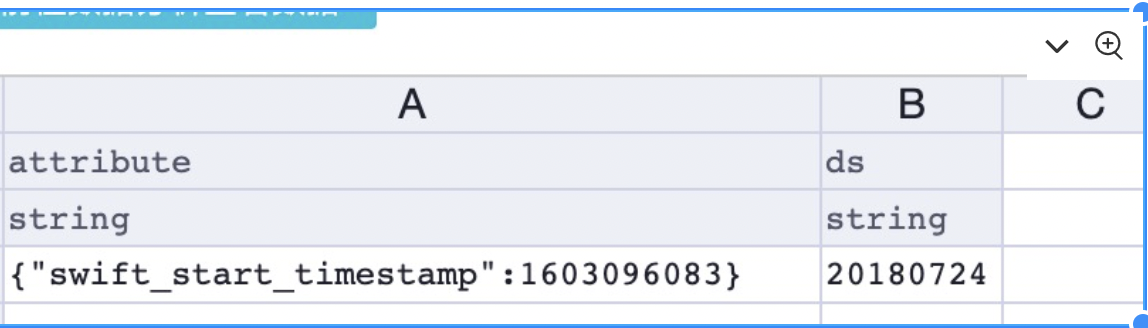
次の図は done テーブルを示しています。
done テーブルを作成するステートメント:
create table mytable_done (attribute string) partitioned by (ds string);mytableパーティションds=20220114のデータが生成された後、done テーブルを設定して Vector Search Edition インスタンスでインデックスの再構築をトリガーします。
-- パーティションを追加
alter table mytable_done add if not exists partition (ds="20220114");

-- インデックスの自動全量再構築用のシグナルデータを挿入
insert into table mytable_done partition (ds="20220114") select '{"swift_start_timestamp":1642003200}';
done テーブルの最終的な内容は次のとおりです。
odps:sql:xxx> select * from mytable_done where ds=20220114 limit 1;
InstanceId: xxx
SQL: .
+-----------+----+
| attribute | ds |
+-----------+----+
| {"swift_start_timestamp":1642003200} | 20220114 |
+-----------+----+
シグナルデータが done テーブルに挿入されると、Vector Search Edition インスタンスはシグナルをスキャンし、自動的にインデックスの再構築をトリガーします。
done テーブルには少なくとも 1 つのパーティションキーが必要であり、パーティションキーの名前はデータテーブルのパーティションキーと同じでなければなりません。たとえば、データテーブルのパーティションキーが
dsの場合、done テーブルのパーティションキーもdsである必要があります。done テーブルには STRING 型のフィールドが 1 つだけ必要であり、フィールド名は
attributeでなければなりません。done テーブルに追加されるパーティションは、データテーブルに存在する必要があります。たとえば、データテーブルにパーティション
ds="20220114"、ds="20220115"、およびds="20220116"がある場合、done テーブルに追加される新しいパーティションはこれらのいずれかである必要があります。done テーブルにデータを挿入するとき、
attributeフィールドの値は、{"swift_start_timestamp":1642003200} のような JSON 文字列でなければなりません。このタイムスタンプは、リアルタイムの増分データを取得するための開始オフセットを示します。
注意事項
MaxCompute は外部テーブルをサポートしていません。内部テーブルを作成する必要があります。
MaxCompute データソースとして使用するテーブルは、パーティションテーブルである必要があります。
MaxCompute で生成されたテーブルはフルデータビルドに、API データソースはリアルタイムデータのプッシュに使用されます。