このトピックでは、Data Lake Formation (DLF) をデータソースとして使用し、マルチモーダルベクターデータを Alibaba Cloud OpenSearch に同期するプロセス全体について説明します。 ここでは、OpenSearch の強力なマルチモーダルデータ処理能力に焦点を当てます。OpenSearch は、DLF からテキスト、画像、動画データを自動的に抽出し、組み込みモデルまたは AI Search Open Platform を使用してコンテンツをベクター化および解析し、非構造化データを構造化されたベクターに変換して OpenSearch に同期します。 このソリューションは、Paimon、Lance、オブジェクトテーブルなど、複数のデータフォーマットをサポートし、ベクター次元、距離タイプ、検索アルゴリズムなどの包括的なベクターインデックス設定オプションを提供します。 これにより、画像検索、テキストセマンティック検索、動画検索などのユースケースに対応するマルチモーダル検索アプリケーションを効率的に構築できます。
前提条件
-
Data Lake Formation に精通していること。
-
DLF の データカタログ ID、データベース、および データテーブル が設定されていること。 これらの識別子は、データ同期を設定する際に必要です。
Data Lake Formation (DLF) データソースの追加
-
[インスタンス詳細] > [テーブル管理] ページで、[テーブルの追加] をクリックします。
-
テーブルの基本情報を入力し、[次へ] をクリックします。
 設定に関する注意事項:
-
テーブル名:任意の名前を指定します。
-
データシャード:シャード数を設定する際、すべてのインデックステーブルでシャード数を同じにする必要があります。または、少なくとも 1 つのインデックステーブルが単一のシャードを持ち、残りのテーブルが同じシャード数を共有するように設定することもできます。
-
データ更新リソース数:データ更新に使用されるリソースの数。 各インデックスは、デフォルトで 4 コア 8 GB の無料更新リソースを 2 つ提供します。 無料クォータを超えるリソースは課金対象となります。 詳細については、「OpenSearch Vector Search Edition の課金の概要」をご参照ください。
-
シナリオテンプレート: OpenSearch Vector Search Edition は、「共通テンプレート」、「Vector: 画像検索」、「Vector: テキストセマンティック検索テンプレート」、「Vector: 動画検索」の 4 つの組み込みテンプレートを提供します (最後のテンプレートは現在、データレイクを全量データソースとしてサポートしていません)。
-
データ同期用にデータソースを設定します。 検証に成功したら、[次へ] をクリックします。
-
全量データソース: Data Lake Formation (DLF) を選択します。
-
テーブルフォーマット: Paimon、Lance、オブジェクトテーブルがサポートされています。
Paimon は、データベースのようにリアルタイムでデータを更新でき、ストリーム処理とバッチ処理の両方をサポートするレイクハウス テーブルフォーマットです。
Lance は、AI 向けに設計されたベクターテーブルフォーマットで、ベクターに対する超高速な類似検索を可能にします。
オブジェクトテーブルは、SQL を使用してクラウドに保存されているさまざまなファイルを直接クエリし、特定できるメタデータテーブルフォーマットです。
-
データカタログ:アクセスする DLF のデータカタログ ID。
-
データベース:アクセスするターゲットデータカタログ配下のデータベース。
-
データテーブル:アクセスするターゲットデータベース配下のデータテーブル。
説明-
既存のインスタンスの場合、Data Lake Formation (DLF) タイプを選択する前に、エンジンバージョンをアップグレードする必要があります。
-
[共通テンプレート] と [Vector: 画像検索テンプレート] は、Paimon、Lance、およびオブジェクトテーブルのフォーマットをサポートします。 [Vector: テキストセマンティック検索テンプレート] は、Paimon のデータカタログをサポートします。
-
Paimon のプライマリキーテーブルは、追加、削除、更新、クエリ操作をサポートします。 Paimon の追記専用テーブルは、書き込みのみをサポートし、更新や削除はサポートしません。
-
-
相対パス:テーブルフォーマットがオブジェクトテーブルの場合の、オブジェクトテーブル内のファイルへの相対パス。
-
データフォーマット:テーブルフォーマットがオブジェクトテーブルの場合、ha3 または JSON データフォーマットのいずれかを選択する必要があります。
-
タグ:データバージョンのタグです。 タグを指定すると、OpenSearch はそのタグのデータを全量同期に使用します。 タグを指定しない場合、OpenSearch はテーブル内の最新データを全量同期に使用します。
Paimon は、特定のスナップショットのメタデータとデータファイルを保持するためのタグ機能を提供し、スナップショットの期限切れによる過去のデータの損失を防ぎます。 タグは、書き込みジョブに基づいて自動的に作成したり、処理時間またはウォーターマーク時間によって定期的に生成したり、手動で作成、削除、または指定したタグにロールバックしたりできます。 保持ポリシーを設定することで、タグの最大数や保持期間を制御し、過去のデータをクエリ可能な状態に保つことができます。 詳細については、「Paimon のタグ」をご参照ください。
Lance は、タグ機能を使用してデータセットの履歴内の特定のバージョンをマークし、データセットの進化を追跡しやすくします。これは、頻繁に更新される機械学習パイプラインで特に役立ちます。 タグの作成、更新、削除、一覧表示が可能です。 タグは新しいバージョンを生成するのではなく、別のディレクトリにメタデータとして存在します。 タグ付けされたバージョンは
cleanup_old_versionsによってクリーンアップされません。対応するバージョンを削除する前に、まずタグを削除する必要があります。 詳細については、「Lance のタグ」をご参照ください。 -
データソースの検証:検証に成功すると、次のステップに進めます。
-
列の設定については、設定が完了したら [次へ] をクリックします。

-
必須の列は、プライマリキー列とベクター列です。 プライマリキー列は int または文字列型とし、プライマリキーボタンを選択する必要があります。ベクター列は float 型とし、ベクター列ボタンを選択する必要があります。
-
ベクター列は、デフォルトで多値の float 型になります。
-
データ前処理が必要です。String 型の列をサポートします。これを選択した後、Configure をクリックしてモデルを呼び出して列を前処理します。
テキストデータ型
-
データ型:テキスト。
-
前処理テンプレート:密なベクター化、密なベクター化 + 疎なベクター化。
-
サービスリスト:
前処理テンプレートを選択すると、そのテンプレートのサービスリストが自動的に表示され、テンプレートで使用されるモデルタイプが示されます。
利用可能なモデルソース:
-
組み込みモデル:無料で呼び出すことができる、限られた種類と数量のモデル。
-
AI Search Open Platform: AI Search Open Platform は豊富なモデル機能を提供し、呼び出し量に応じて課金されます。 「課金方法と課金項目」をご参照ください。 使用する前に、まず AI Search Open Platform のワークスペースと API キーを有効化する必要があります。
-
カスタムモデル:必要に応じてモデルをカスタマイズできます。 Vector Search Edition ページの モデル一覧>Custom Models で、Create Model 操作を実行します。 詳細については、「カスタムモデル」をご参照ください。
-
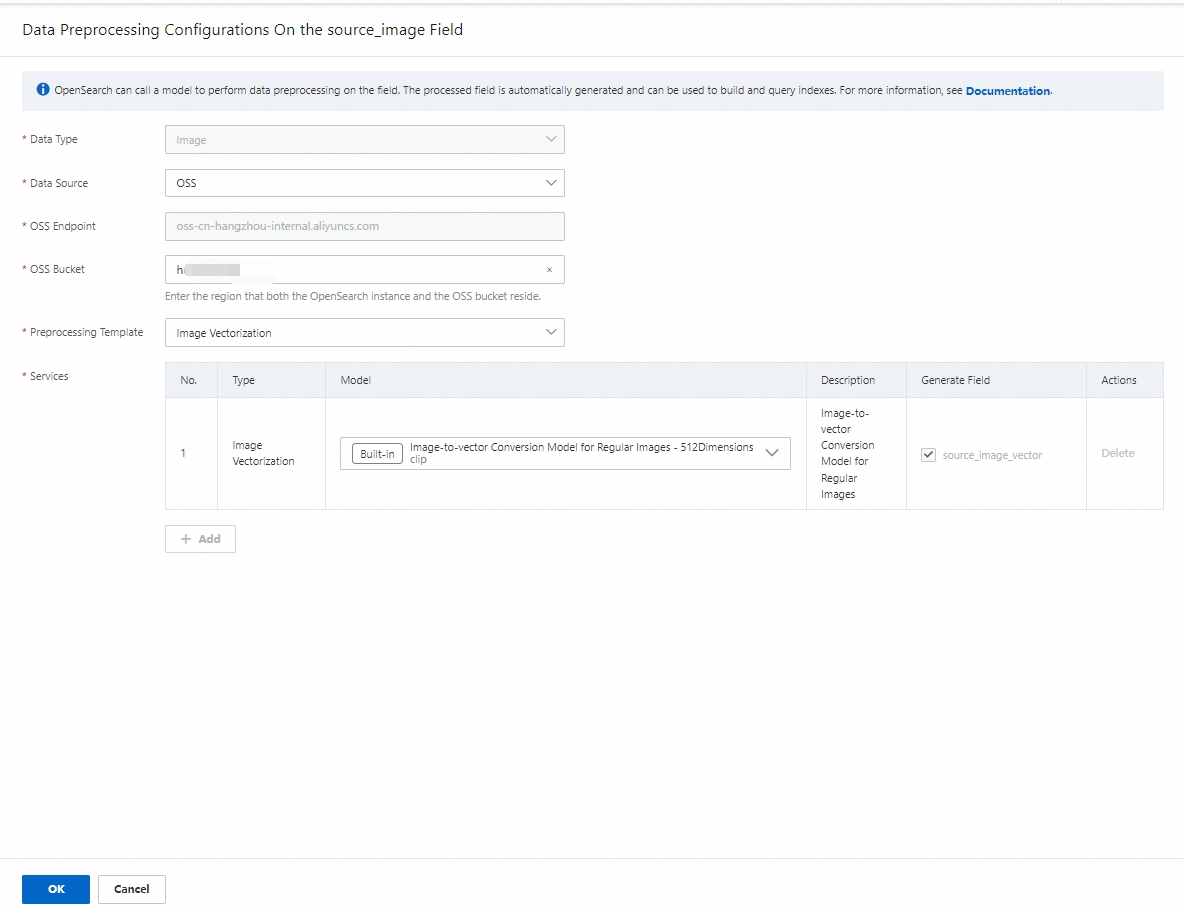
画像データ型
-
データ型:画像。
-
データソース: OSS、Base64 エンコーディング、DLF-Object Table。
-
OSS: OSS パスを提供する必要があります。 これは、画像が OSS フォルダに保存され、OSS から直接インポートされることを示します。
-
Base64 エンコーディング:画像は一度エンコードされてからデータベースに保存されるか、API を介して直接送信されます。
-
DLF-Object Table:データレイク内のオブジェクトテーブルフォーマットのテーブル。 対応するデータカタログ、データベース、およびデータテーブルを指定する必要があります。
-
-
前処理テンプレート:画像ベクター化、画像コンテンツ解析、画像コンテンツ解析 + 画像ベクター化。
-
サービスリスト:
前処理テンプレートを選択すると、そのテンプレートのサービスリストが自動的に表示され、テンプレートで使用されるモデルタイプが示されます。
利用可能なモデルソース:
-
組み込みモデル:無料で呼び出すことができる、限られた種類と数量のモデル。
-
AI Search Open Platform: AI Search Open Platform は豊富なモデル機能を提供し、呼び出し量に応じて課金されます。 「課金方法と課金項目」をご参照ください。 使用する前に、まず AI Search Open Platform のワークスペースと API キーを有効化する必要があります。
-
カスタムモデル: ニーズに合わせてモデルをカスタマイズできます。 Vector Search Edition ページでモデル一覧 > Custom Modelsを選択し、Create Model操作を実行します。 詳細については、「カスタムモデル」をご参照ください。
-
動画データ型
-
データ型:動画。
-
データソース: OSS。
-
前処理テンプレート:動画処理。
-
サービスリスト:
前処理テンプレートを選択すると、そのテンプレートのサービスリストが自動的に表示され、テンプレートで使用されるモデルタイプが示されます。
利用可能なモデルソース:
-
組み込みモデル:無料で呼び出すことができる、限られた種類と数量のモデル。
-
AI Search Open Platform: AI Search Open Platform は豊富なモデル機能を提供し、呼び出し量に応じて課金されます。 「課金方法と課金項目」をご参照ください。 使用する前に、まず AI Search Open Platform のワークスペースと API キーを有効化する必要があります。
-
カスタムモデル:必要に応じてモデルをカスタマイズできます。 ベクトル検索版ページの モデル一覧 > Custom Models で、Create Model 操作を実行します。 詳細については、「カスタムモデル」をご参照ください。
-
-
-
データ内で列が見つからないか空の場合、システムは自動的にデフォルト値を入力します。数値型はデフォルトで 0、文字列型はデフォルトで空の文字列になります。 カスタムのデフォルト値がサポートされています。
-
-
インデックス構造の設定については、設定が完了したら [次へ] をクリックします。

-
ベクターインデックス:
-
ベクター次元:モデルによって生成されたベクターに基づいて、必要に応じて選択します。
-
距離タイプ:モデルによって生成されたベクターに基づいて、必要に応じて選択します。 システムは、SquareEuclidean、InnerProduct、Cosine の 3 つの距離タイプをサポートしています。
-
アルゴリズム:モデルによって生成されたベクターに基づいて、必要に応じて選択します。 システムは、Liner、HNSW、QGraph、QC、DiskANN、CagraHnsw のベクターインデックスアルゴリズムをサポートしています。
-
リアルタイムインデックス: API からの増分データがリアルタイムでベクターインデックスを構築する必要があるかどうかを示します。 デフォルトは true です。
その他の詳細設定については、クリックして展開し、設定します。 パラメーターの説明については、「一般的なベクターインデックスの設定」をご参照ください。

-
-
その他のインデックスタイプ: システムは pk 列とプライマリキーインデックスを生成し、デフォルトで残りの非ベクター列に対して同名のインデックスを生成します。
-
グローバルインデックス設定:期限切れドキュメントの自動クリーンアップを有効にできます。 有効にすると、現在時刻 - ドキュメント時刻 > 有効期限 の条件を満たすドキュメントが自動的にクリーンアップされます。
-
-
作成を確定するには、[作成の確認] をクリックします。 システムは設定されたテーブルを自動的に作成します。 変更履歴でテーブルの作成進捗状況を確認できます。
-
テーブルのステータスが [使用中] になると、クエリテストページでクエリテストを実行できます。
注意
新しいデータが DLF の Paimon テーブルに書き込まれると、OpenSearch は新しいデータに基づいてリアルタイムのインデックス構築を自動的にトリガーします。 API を介して手動でデータを書き込むと、データの一貫性に問題が発生する可能性があるため、慎重に行ってください。