Alibaba Cloud Model Studio は、 汎用的な作成 (テキストから動画、画像から動画、リファレンス動画、動画編集)および 特定のシナリオ (デジタルヒューマンのリップシンク、画像からアクション、動画キャラクター置き換え、絵文字作成)向けの動画生成モデルを提供します。
モデル概要
| サービスデプロイ範囲 | グローバル
| インターナショナル
| 米国
| 中国本土
|
リージョン | バージニア | シンガポール | バージニア | 北京 |
サポートされるモデル |
モデル選択
-
一般的な動画生成
- テキストプロンプトから動画を生成するには、Wan - テキストから動画 を使用します。
- 単一の画像から映画のようなショットを生成するには、Wan - 画像から動画 - 最初のフレーム を使用します。
- 開始画像と終了画像の間のトランジションを制御するには、Wan - 画像から動画 - 最初と最後のフレーム を使用します。
- リファレンス動画からキャラクターの外見と声を複製して新しいスクリプトに合わせるには、Wan - リファレンス動画 を使用します。
-
デジタルヒューマンのリップシンク: 静止画像を話したり歌ったり物語を語ったりするようにアニメーション化します。背景は固定されたまま、顔・頭・体が動きます。
- 表情・頭・体の動きを含め、最も自然な結果を得るには、Wan - デジタルヒューマン を使用します。このモデルは EMO を置き換えます。
- ニュースレポートなどの単純な頭の動きを伴う 20 秒を超える動画には、LivePortrait を使用します。
-
動画モーション転送: 写真の背景を静止したままにして、リファレンス動画のモーションを使用して人物をアニメーション化します。Wan - 画像からアクション を使用します。
-
動画キャラクター置き換え: 動画内の人物を画像の人物に置き換えながら、元の背景を保持します。Wan - 動画キャラクター置き換え を使用します。
-
ダンス置き換え: 動画内のダンサーを画像の人物に置き換えます。最高品質を得るには、Wan - 画像からアクション と Wan - 動画キャラクター置き換え を使用します。予算が限られている場合は、AnimateAnyone を使用します。
-
動画リップ置き換え: 既存の動画の口の動きを新しい音声に合わせて置き換えます。VideoRetalk を使用します。
-
絵文字作成: 固定スタイルのテンプレートを使用して絵文字を作成します。絵文字 を使用します。
-
動画再描画: 固定スタイルのテンプレートを使用するには、動画スタイル変換 を使用します。プロンプトを使用してスタイルを自由に記述するには、Wan - 動画編集 を使用します。
-
動画編集: 次のすべてのタスクには、Wan - 一般動画編集 を使用します。
- ローカル動画編集: 被写体や衣類などの要素を置き換えたり、通行人を削除したりします。
- 動画拡張: 短い動画を延長します(例: 1 秒から 5 秒へ)。
- 動画フレーム拡張: 横長動画を縦長モードに変換したり、欠落している境界を埋めたりします。
- マルチ画像リファレンス生成: 背景画像と被写体画像を融合して動画を作成します。
サポートされるモデル
Wan - テキストから動画
テキストプロンプトから動画を生成します。 テキストと音声の入力に対応し、映画のようなマルチショット動画を作成します。
API リファレンス | モデル料金 | オンラインで試す: シンガポール, バージニア, 北京
グローバル
デプロイメント範囲として Global を選択すると、モデル推論計算リソースは世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 米国 (バージニア) およびドイツ (フランクフルト)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-t2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: 5s、10s、15s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
インターナショナル
デプロイメント範囲としてInternationalを選択すると、モデル推論計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポート対象リージョン: シンガポール。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-t2v-2026-04-25 | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.7-t2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-t2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.5-t2v-preview | 音声付き動画 音声と動画の同期 | テキスト、音声 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s、10s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-t2v-plus | 無音動画
| テキスト | 解像度オプション: 480P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-t2v-turbo | 無音動画 | テキスト | 解像度オプション: 480P、720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-t2v-plus | 無音動画 | テキスト | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
米国
[US] デプロイメント範囲を選択すると、モデル推論の計算リソースは米国内に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン: 米国 (バージニア)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-t2v-us | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: 5s、10s、15s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
中国本土中国本土デプロイメント範囲を選択すると、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン:中国 (北京)。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-t2v-2026-04-25 | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.7-t2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-t2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.5-t2v-preview | 音声付き動画 音声と動画の同期 | テキスト、音声 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s、10s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-t2v-plus | 無音動画
| テキスト | 解像度オプション: 480P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-t2v-turbo | 無音動画 | テキスト | 解像度オプション: 480P、720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-t2v-plus | 無音動画 | テキスト | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
| 入力プロンプト | 出力動画 (wan2.6、マルチショット動画) |
|---|---|
ローアングル、ミディアムクローズアップ、暖色調、混合照明(机上のランプの実用光が窓からの曇り空の光と混ざる)、サイドライティング、中央構図で撮影されたショット。クラシックな探偵事務所では、木製の本棚に古い事件ファイルや灰皿が詰まっています。緑色の机上のランプが、机の中央に広げられた事件ファイルを照らしています。濃い茶色のトレンチコートと薄灰色のフェドラ帽をかぶったキツネが革張りの椅子に座り、その赤みがかった毛皮と尾を軽く縁にかけ、黄色くなったページをゆっくりとめくっています。外では青空の下、穏やかな雨が降り続き、ガラスに蛇行する筋を作っています。彼はゆっくりと頭を上げ、耳をわずかにぴくつかせ、琥珀色の目でカメラをまっすぐ見つめ、滑らかで皮肉な声で口を動かして言います。「この事件は冷え切っている、冬の魚よりも冷たい。だが、どんな鶏にも秘密はあるものだ。少なくとも私は、それを見つけ出すつもりだ」。 |
Wan - 画像から動画
Wan 画像から動画モデルはマルチモーダル入力(テキスト/画像/音声/動画)でアップグレードされ、次の 3 つのタスクをサポートします。最初のフレームから動画、最初と最後のフレームから動画、動画継続。
API リファレンス | モデルの価格設定 | プロンプトガイド
インターナショナル
デプロイメント範囲として[International]を選択した場合、モデル推論計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-i2v-2026-04-25 | 音声付き動画 最初のフレームから動画、最初と最後のフレームから動画、動画継続、最後のフレーム制御付き動画継続 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.7-i2v | 音声付き動画 最初のフレームから動画、最初と最後のフレームから動画、動画継続、最後のフレーム制御付き動画継続 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
中国本土 中国本土 デプロイメント範囲を選択すると、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 中国 (北京)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-i2v-2026-04-25 | 音声付き動画 最初のフレームから動画、最初と最後のフレームから動画、動画継続、最後のフレーム制御付き動画継続 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.7-i2v | 音声付き動画 最初のフレームから動画、最初と最後のフレームから動画、動画継続、最後のフレーム制御付き動画継続 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
Wan - 画像から動画 - 最初のフレーム
指定された最初のフレーム画像から動画を生成します。 このモデルは、テキスト、最初のフレーム画像、および音声を入力として受け取り、映画のようなマルチショット動画を生成します。
API リファレンス | モデル料金 | オンラインで試す: シンガポール, バージニア, 北京
グローバル
デプロイメント範囲として Global を選択すると、モデル推論計算リソースは世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 米国 (バージニア) およびドイツ (フランクフルト)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-i2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: 5s、10s、15s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
インターナショナル
デプロイメント範囲としてInternationalを選択すると、モデル推論の計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-i2v-flash | 音声付き動画、無音動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-i2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.5-i2v-preview | 音声付き動画 音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s、10s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-i2v-flash | 無音動画
| テキスト、画像 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-i2v-plus | 無音動画
| テキスト、画像 | 解像度オプション: 480P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-i2v-plus | 無音動画 | テキスト、画像 | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-i2v-turbo | 無音動画 | テキスト、画像 | 解像度オプション: 480P、720P 動画持続時間: 3s、4s、5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
米国
「US」デプロイメント範囲を選択すると、モデル推論の計算リソースは米国内に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン: 米国 (バージニア)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-i2v-us | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: 5s、10s、15s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
デプロイメント範囲として中国本土を選択した場合、モデル推論計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン:中国 (北京)。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-i2v-flash | 音声付き動画、無音動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-i2v | 音声付き動画 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、15s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.5-i2v-preview | 音声付き動画 音声と動画の同期 | テキスト、画像、音声 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s、10s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-i2v-flash | 無音動画
| テキスト、画像 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.2-i2v-plus | 無音動画
| テキスト、画像 | 解像度オプション: 480P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-i2v-plus | 無音動画 | テキスト、画像 | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-i2v-turbo | 無音動画 | テキスト、画像 | 解像度オプション: 480P、720P 動画持続時間: 3s、4s、5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
| 入力プロンプト | 最初のフレーム画像と音声の入力 | 出力動画 (wan2.6、マルチショット動画) |
|---|---|---|
都市ファンタジーアートシーン。ダイナミックなグラフィティアートキャラクター。コンクリートの壁からスプレー塗料でできたティーンエイジャーが命を吹き込まれます。彼は夜の都市の鉄道橋の下で、クラシックでエネルギッシュなラッパーのポーズを取りながら、高速で英語のラップを披露します。照明は街灯 1 基から来ており、高エネルギーで驚くほど詳細な映画のような雰囲気を作り出しています。動画の音声は完全に彼のラップで構成されており、他の会話やノイズはありません。 | 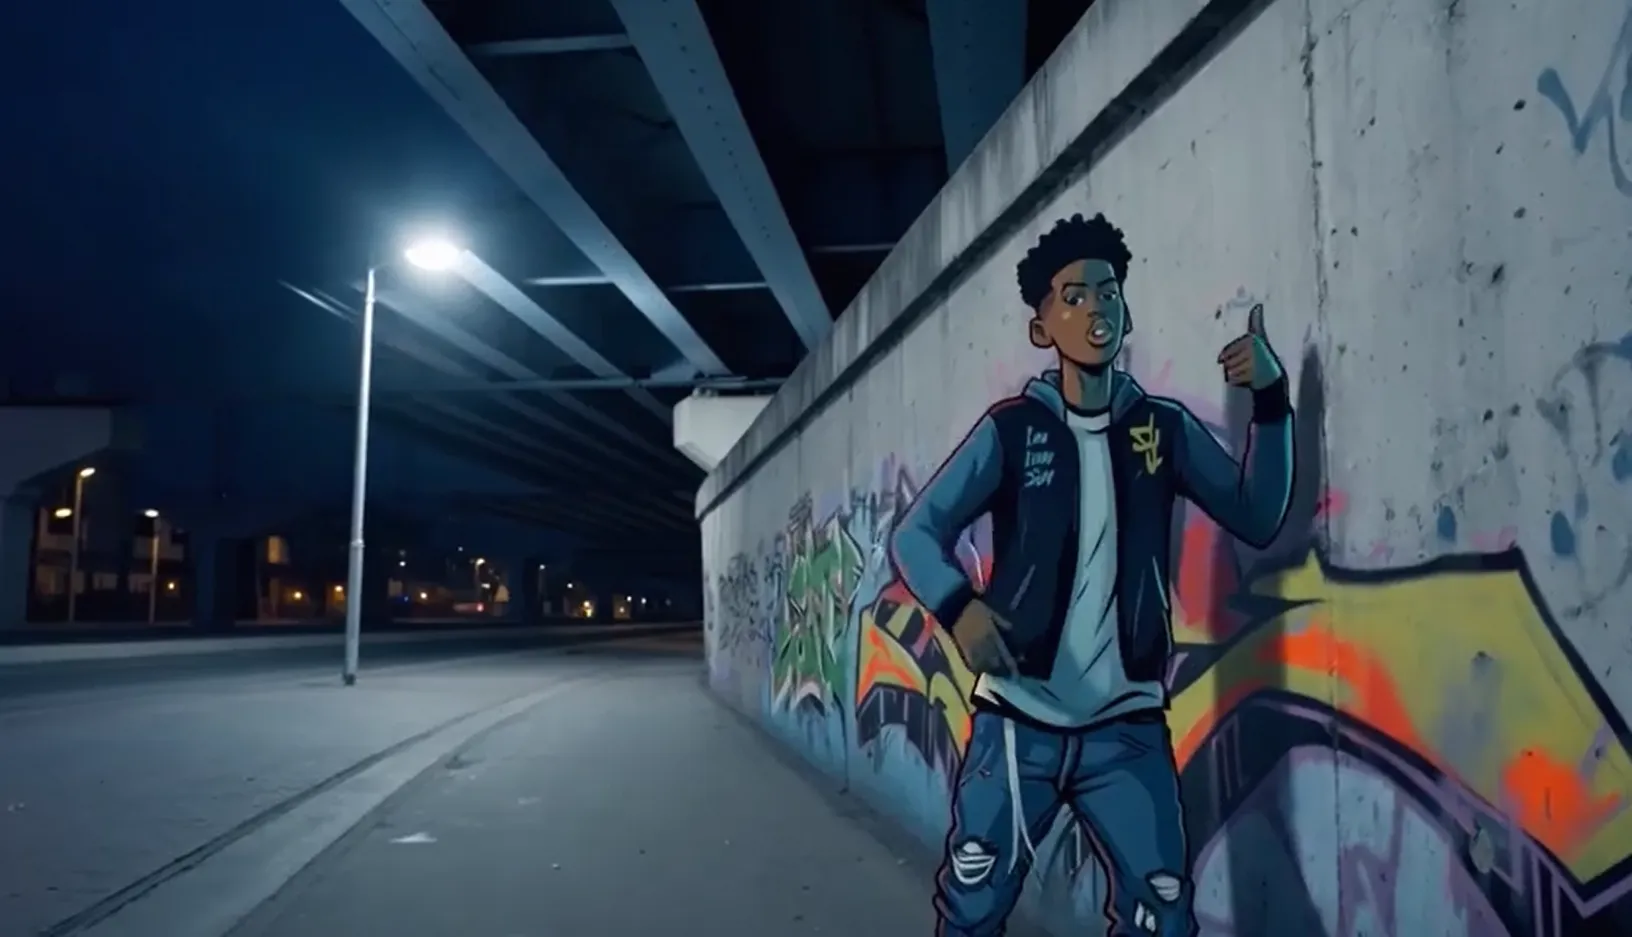 入力音声: |
Wan - 画像から動画 - 最初と最後のフレーム
指定された最初と最後のフレーム画像の間にスムーズなトランジションを持つ動画を生成します。 このモデルは、テキスト、最初と最後のフレーム画像、および音声を入力として受け取り、映画のようなマルチショット動画を生成します。
API リファレンス | モデル料金 | オンラインで試す
インターナショナル
デプロイメント範囲として 国際 を選択すると、モデル推論計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-kf2v-flash | 無音動画
| テキスト、画像 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-kf2v-plus | 無音動画 | テキスト、画像 | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
中国本土中国本土デプロイメント範囲を選択すると、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン:中国 (北京)。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-kf2v-flash | 無音動画
| テキスト、画像 | 解像度オプション: 480P、720P、1080P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-kf2v-plus | 無音動画 | テキスト、画像 | 解像度オプション: 720P 動画持続時間: 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
| 最初のフレーム画像の入力 | 最後のフレーム画像の入力 | 入力プロンプト | 出力動画 |
|---|---|---|---|
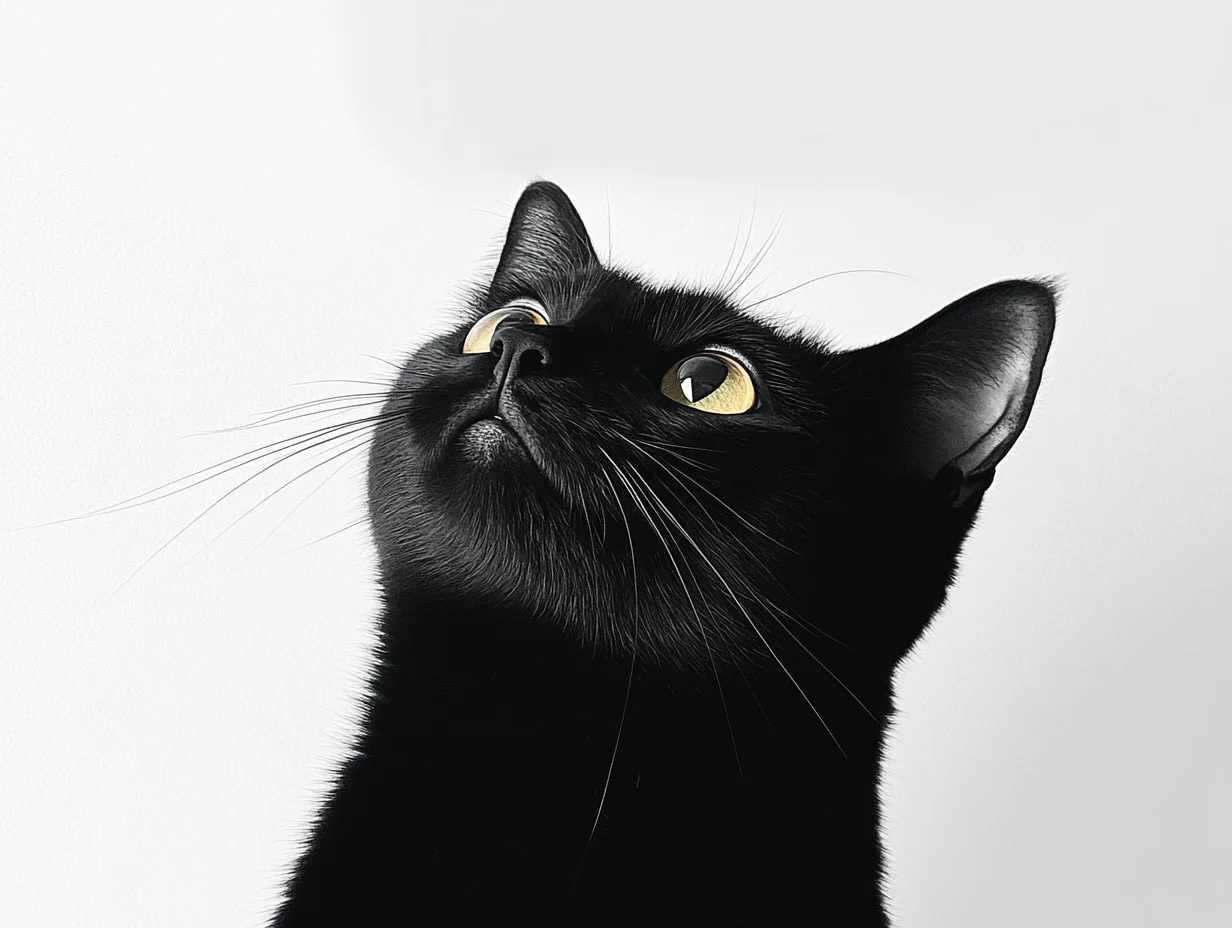 |  | リアルなスタイル。小さな黒猫が空を好奇心を持って見上げています。カメラは目の高さから始まり、徐々に上昇し、猫の好奇心に満ちた視線を上から捉えるショットで終わります。 |
Wan - リファレンス動画
指定された動画のキャラクターにアクションを行わせます。 動画とテキストプロンプトを入力として、キャラクターの一貫性を維持した出力動画を生成します。
グローバル
デプロイメント範囲として [Global] を選択すると、モデル推論の計算リソースが世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: 米国 (バージニア) およびドイツ (フランクフルト)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.6-r2v | 音声付き動画 シングルロール/マルチロール動画生成 マルチショットナラティブ、音声と動画の同期 | テキスト、動画 | 解像度オプション: 720P、1080P 動画持続時間: 5s、10s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
インターナショナル
[国際]デプロイメント範囲を選択すると、モデル推論の計算リソースは中国本土を除く世界中にわたって動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-r2v | 音声付き動画 マルチエンティティリファレンス動画。各エンティティの音色設定をサポート。 | テキスト、画像、動画、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-r2v-flash | 音声付き動画、無音動画 シングルロール/マルチロール動画生成 マルチショットナラティブ、音声と動画の同期
| テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-r2v | 音声付き動画 シングルロール/マルチロール動画生成 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
中国本土中国本土デプロイメント範囲を選択した場合、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポートされているリージョン:中国 (北京)。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-r2v | 音声付き動画 マルチエンティティリファレンス動画により、各エンティティの音色を設定できます。 | テキスト、画像、動画、音声 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-r2v-flash | 音声付き動画、無音動画 シングルロール/マルチロール動画生成 マルチショットナラティブ、音声と動画の同期
| テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.6-r2v | 音声付き動画 シングルロール/マルチロール動画生成 マルチショットナラティブ、音声と動画の同期 | テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
| 入力リファレンス動画 1 (ロール: 小さな女の子) | 入力リファレンス動画 2 (ロール: 目覚まし時計) | 入力プロンプト | 出力動画 (マルチロール対話) |
|---|---|---|---|
character1 が character2 に言います: 「明日の朝は頼りにしてるよ!」character2 が答えます: 「任せて!」 |
Wan - 動画編集
動画編集モデル。テキスト、画像、動画のマルチモーダル入力を受け取り、さまざまな動画生成および編集タスクを実行します。
動画編集 2.7 API リファレンス | 動画編集 2.1 API リファレンス | モデル料金
インターナショナル
デプロイメント範囲として International を選択すると、モデル推論の計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-videoedit | 音声付き動画、無音動画 (入力動画に依存) 指示ベースの編集、動画移行 | テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wan2.1-vace-plus | 無音動画 マルチ画像リファレンス、動画再描画、ローカル編集、動画拡張、動画フレーム拡張 | テキスト、画像、動画 | 解像度オプション: 720P 動画持続時間: 最大 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
中国本土
デプロイメント範囲として中国本土を選択すると、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 中国 (北京)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.7-videoedit | 音声付き動画、無音動画 (入力動画に依存) 指示ベースの編集、動画移行 | テキスト、画像、動画 | 解像度オプション: 720P、1080P 動画持続時間: [2s、10s] (整数) 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
wanx2.1-vace-plus | 無音動画 マルチ画像リファレンス、動画再描画、ローカル編集、動画拡張、動画フレーム拡張 | テキスト、画像、動画 | 解像度オプション: 720P 動画持続時間: 最大 5s 定義済み仕様: 30 fps、MP4 (H.264 エンコーディング) |
動画編集 2.1
-
特徴 1: マルチ画像リファレンス
入力リファレンス画像 1 (リファレンスエンティティ) 入力リファレンス画像 2 (リファレンス背景) 入力プロンプト 出力動画 

動画では、少女が古くて霧に包まれた森の奥深くから優雅に歩いて出てきます。彼女の足取りは軽やかで、カメラはその素早い動きを捉えます。彼女が立ち止まって緑豊かな森を見渡すと、驚きと喜びの笑みが彼女の顔に広がります。この瞬間は、光と影の相互作用の中に凍結され、自然との素晴らしい出会いを記録しています。
-
特徴 2: 動画再描画
入力動画 入力プロンプト 出力動画 動画は、歯車や銅管で飾られた紳士が運転する蒸気パンク風の黒い車を示しています。背景はレトロ要素のある蒸気式キャンディ工場で、ビンテージで遊び心のあるシーンを作り出しています。
-
特徴 3: ローカル動画編集
入力動画 入力マスク画像 (白い領域が編集領域を示す) 入力プロンプト 出力動画 
動画は、パリ風のフランスカフェを示しており、スーツを着たライオンが優雅にコーヒーをすすっています。片方の手でコーヒーカップを持ち、満足げな表情でそっと一口飲みます。カフェは趣のある装飾が施されており、柔らかな色合いと温かい照明がライオンのいるエリアを照らしています。
-
特徴 4: 動画拡張
入力最初の動画セグメント (1s) 入力プロンプト 出力動画 (拡張された動画は 5s) サングラスをかけた犬が路上でスケートボードをする、3D カートゥーン。
-
特徴 5: 動画フレーム拡張
入力動画 入力プロンプト 出力動画 優雅な女性が情熱的にバイオリンを演奏しており、背後にはフルシンフォニーオーケストラがいます。
Wan - デジタルヒューマン
Noteサポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
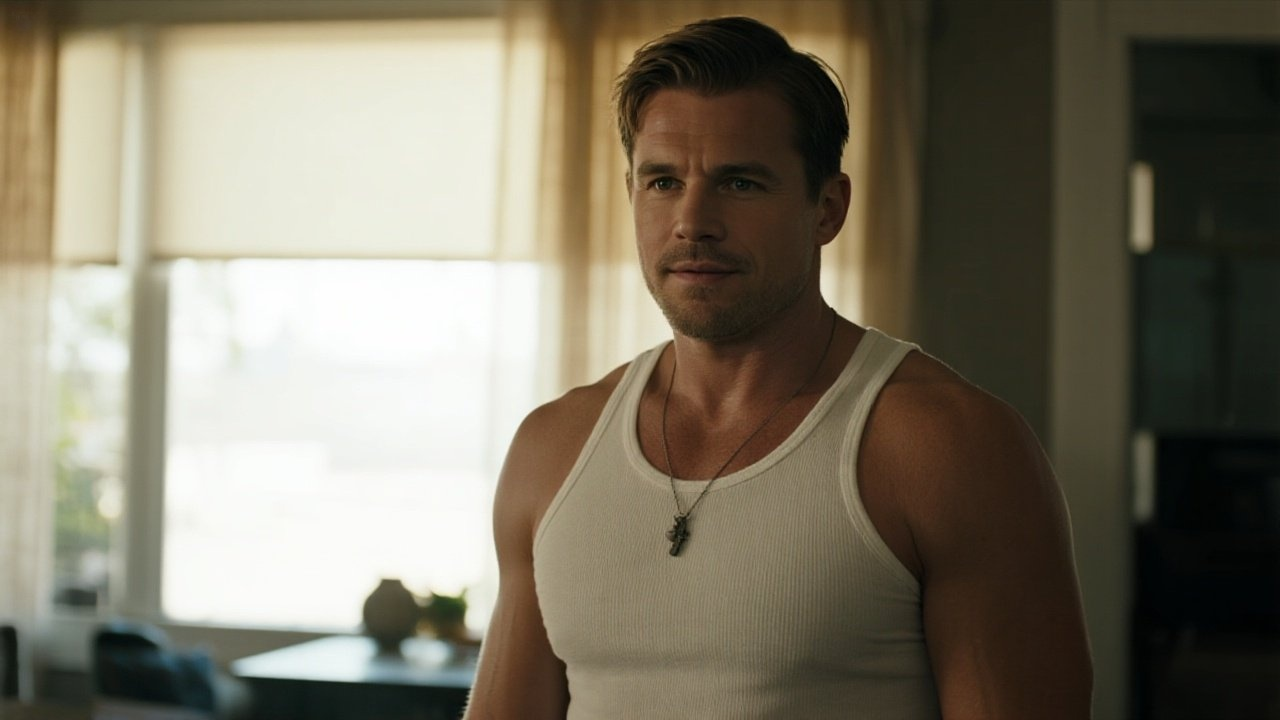
デジタルヒューマンのリップシンクは、画像内の人物または漫画キャラクターを話したり歌ったり物語を語ったりするようにアニメーション化します。 画像と音声ファイルを提供すると、モデルは自動的に同期された口の動き、表情、頭と体の動きを備えた動画を生成します。
画像検出 API リファレンス | 動画生成 API リファレンス | モデル料金
モデル | 特徴 | 入力モダリティ | 出力説明 |
|---|---|---|---|
wan2.2-s2v-detect | 画像検出 | 画像 | 検出ステータスの出力: Pass または Fail |
wan2.2-s2v | 動画生成 音声付き動画 | 画像、音声 | 解像度オプション: 480P、720P 動画持続時間: 最大 20s (音声の持続時間に従う) 定義済み仕様:
|
| 入力例 (キャラクター画像 + 音声) | 出力動画 (リップシンク) |
|---|---|
 入力音声: |
Wan - 画像からアクション
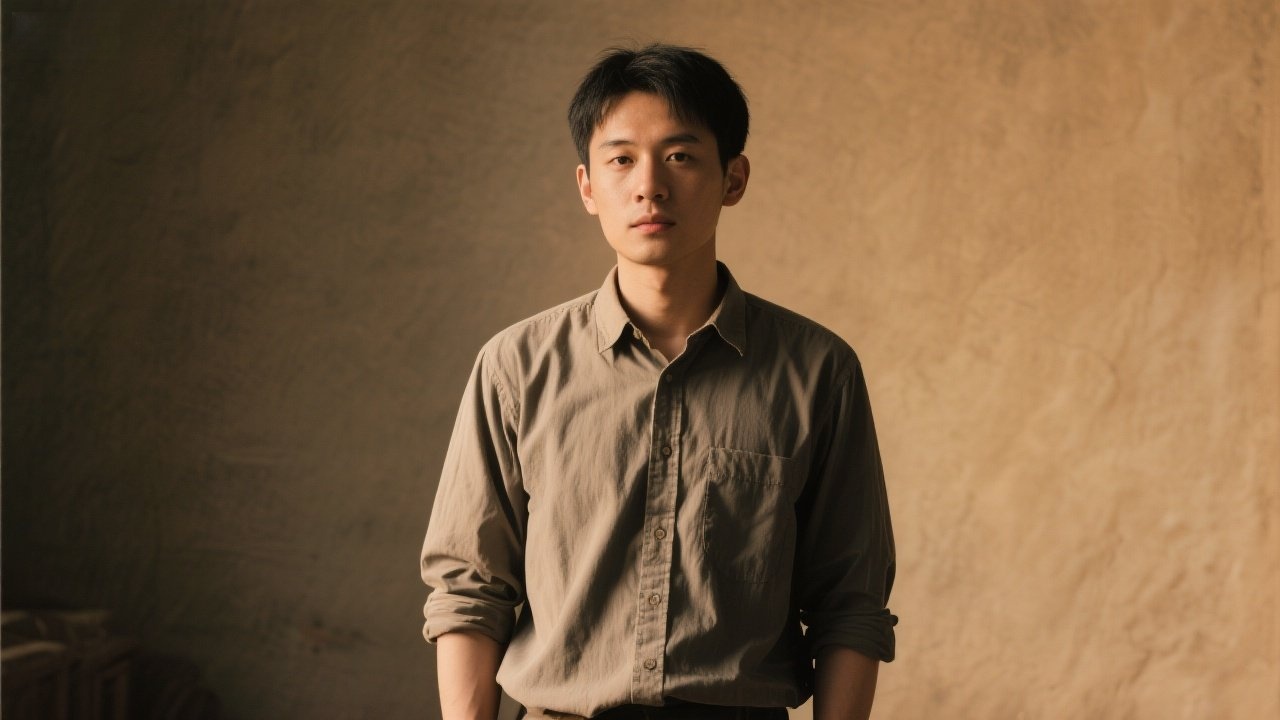
リファレンス動画のモーションを使用して画像内の人物をアニメーション化します。 画像と動画を提供すると、モデルはリファレンス動画のモーションを適用しながら、元の画像の背景を静止したままにした動画を生成します。
インターナショナル
デプロイメント範囲として国際を選択すると、モデル推論の計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-animate-move | 音声付き動画、無音動画 (入力動画に依存)
| 画像、動画 | 解像度オプション: 720P 動画持続時間: 2s < 持続時間 < 30s 定義済み仕様:
|
中国本土
「中国本土」デプロイメント範囲を選択した場合、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 中国 (北京)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-animate-move | 音声付き動画、無音動画 (入力動画に依存)
| 画像、動画 | 解像度オプション: 720P 動画持続時間: 2s < 持続時間 < 30s 定義済み仕様:
|
| 入力キャラクター画像 | 入力リファレンス動画 | 出力動画 (標準モード | 出力動画 (プロフェッショナルモード |
|---|---|---|---|
 |
Wan - 動画キャラクター置き換え
動画内のキャラクターをリファレンス画像のキャラクターに置き換えます。 ソース動画とリファレンス画像を提供すると、モデルは元の背景を保持した出力動画を生成します。この機能は、顔の置き換えや完全なキャラクター置き換えなどのユースケースに最適です。
インターナショナル
[International] デプロイメント範囲を選択すると、モデル推論の計算リソースは中国本土を除く世界中で動的にスケジュールされます。静的データは選択したリージョンに保存されます。サポートされているリージョン: シンガポール。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-animate-mix | 音声付き動画、無音動画 (入力動画に依存)
| 画像、動画 | 解像度オプション: 720P 動画持続時間: 2s < 持続時間 < 30s 定義済み仕様:
|
中国本土
デプロイメント範囲として 中国本土 を選択した場合、モデル推論の計算リソースは中国本土に制限されます。静的データは選択したリージョンに保存されます。サポート対象リージョン: 中国 (北京)。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
wan2.2-animate-mix | 音声付き動画、無音動画 (入力動画に依存)
| 画像、動画 | 解像度オプション: 720P 動画持続時間: 2s < 持続時間 < 30s 定義済み仕様:
|
| 入力動画 | 置き換え用入力キャラクター画像 | 出力動画 (標準モード | 出力動画 (プロフェッショナルモード |
|---|---|---|---|
|
AnimateAnyone
Note
- サポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
- AnimateAnyone の代わりに、Wan - 画像からアクション および Wan - 動画キャラクター置き換え を使用することを推奨します。これらのモデルはより高品質を提供しますが、AnimateAnyone はよりコスト効率的なオプションです。
ダンス専用に設計されたこのモデルは、動画内のダンサーを画像の人物に置き換えます。 画像と動画を提供すると、次の 2 つの方法で出力動画を生成できます。1. 画像の背景を保持する。2. 動画の背景を保持する。
画像検出 API リファレンス | アクションテンプレート生成 API リファレンス | 動画生成 API リファレンス | モデル料金
| モデル | 特徴 | 入力モダリティ | 出力説明 |
|---|---|---|---|
animate-anyone-detect-gen2 | 画像検出 | 画像 | 検出ステータスの出力: Pass または Fail |
animate-anyone-template-gen2 | ダンス動画テンプレート生成
| 動画 | ダンスアクションテンプレート ID を出力します。 |
animate-anyone-gen2 | 動画生成 無音動画 | 画像、動画、ダンスアクションテンプレート ID | 動画解像度オプション: 720P 動画持続時間: 2s ≤ 持続時間 ≤ 60s 定義済み仕様: 15 fps、MP4 (H.264 エンコーディング) |
| 入力キャラクター画像 | 入力ダンス動画 | 出力動画 (画像背景で生成) | 出力動画 (動画背景で生成) |
|---|---|---|---|
 |
EMO
Note
- サポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
- EMO の代替として Wan - デジタルヒューマン を使用することを検討してください。Wan - デジタルヒューマンはより良い結果を提供しますが、EMO はよりコスト効率的なオプションです。
画像から歌唱およびパフォーマンス動画を生成します。 画像と音声ファイルを提供すると、モデルは自動的に同期された口の動き、表情、頭の動きを備えた動画を生成します。
画像検出 API リファレンス | 動画生成 API リファレンス | モデル料金
モデル | 特徴 | 入力モダリティ | 出力説明 |
|---|---|---|---|
emo-detect-v1 | 画像検出 | 画像 | 検出ステータスの出力: Pass または Fail |
emo-v1 | 動画生成 音声付き動画 | 画像、音声 | 動画解像度:
動画持続時間: 最大 60s 定義済み仕様: 15 fps、MP4 (H.264 エンコーディング) |
| 入力例 (ポートレート画像 + 音声) | 出力動画 (リップシンク歌唱) |
|---|---|
 入力音声: |
LivePortrait
Note
- サポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
- LivePortrait の代替として Wan - デジタルヒューマン を使用することを検討してください。Wan - デジタルヒューマンはより高品質な結果を提供しますが、LivePortrait はよりコスト効率的なオプションです。なお、LivePortrait は長尺動画 (20 秒以上) の生成に適しています。
画像からナレーション動画を生成し、画像内の人物をニュースを伝えたり物語を語ったりするようにアニメーション化します。 画像と音声ファイルを提供すると、モデルは自動的に同期された口の動き、表情、わずかな頭の動きを備えた動画を生成します。
画像検出 API リファレンス | 動画生成 API リファレンス | モデル料金
モデル | 特徴 | 入力モダリティ | 出力説明 |
|---|---|---|---|
liveportrait-detect | 画像検出 | 画像 | 検出ステータスの出力: Pass または Fail |
liveportrait | 動画生成 音声付き動画 | 画像、音声 | 動画解像度: 入力画像に従い、最大約 4K (4096 × 4096)。 動画持続時間: 1s < 持続時間 < 180s 動画フレームレート: 15 fps ≤ フレームレート ≤ 30 fps 動画フォーマット: MP4 (H.264 エンコーディング) |
| 入力例 (ポートレート画像 + 音声) | 出力動画 (リップシンクボイスオーバー) |
|---|---|
 入力音声: |
絵文字
Noteサポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
固定絵文字テンプレートを使用して絵文字を作成します。 画像と絵文字テンプレート ID を提供して、絵文字動画を生成します。
画像検出 API リファレンス | 動画生成 API リファレンス | モデル料金
モデル | 特徴 | 入力モダリティ | 出力説明 |
|---|---|---|---|
emoji-detect-v1 | 画像検出 | 画像 | 検出ステータスの出力: Pass または Fail |
emoji-v1 | 動画生成 無音動画 | 画像、絵文字テンプレート ID | 動画解像度: 512 × 512 固定 動画持続時間: 最大 5s (テンプレートの持続時間に従う) 定義済み仕様: 15 fps、MP4 (H.264 エンコーディング) |
| 入力ポートレート画像 | 出力動画 ("嫌悪" 絵文字) |
|---|---|
 |
VideoRetalk
Noteサポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
リップシンク: 動画の口の動きを新しい音声トラックに合わせて置き換えます。 動画と音声ファイルを提供すると、モデルは同期された口の動きを備えた出力動画を生成します。
モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
videoretalk | 音声付き動画 | 動画、音声 | 動画解像度: 入力動画に従い、最大約 2K (2048 × 2048)。 動画持続時間: 2s < 持続時間 < 120s 動画フレームレート: 15 fps ≤ フレームレート ≤ 60 fps 動画フォーマット: MP4 (H.264 エンコーディング) |
| 入力例 (キャラクターブロードキャスト動画 + 音声) | 出力動画 (リップシンク置き換え) |
|---|---|
入力音声: |
動画スタイル変換
Noteサポートされているのは中国本土のサービスデプロイ範囲のみです。データストレージは北京アクセシリージョンにあります。モデル推論の計算リソースは中国本土内に限定されます。
事前定義されたスタイルテンプレートに基づいて動画に新しいアーティスティックなスタイルを適用します。 動画とスタイル変換 ID を提供して、スタイル変更された動画を生成します。
| モデル | 特徴 | 入力モダリティ | 出力動画仕様 |
|---|---|---|---|
video-style-transform | 音声付き動画、無音動画
| 動画再描画スタイル ID | 動画解像度: 入力動画に従い、最大約 4K (4096 × 4096)。 動画持続時間: 最大 30s 動画フレームレート: 15 fps ≤ フレームレート ≤ 25 fps 動画フォーマット: MP4 (H.264 エンコーディング) |
| 入力動画 | 出力動画 (スタイル変換: "日本のマンガ") |
|---|---|