Python Software Foundation はまもなく Python 2 の保守を終了します。MaxCompute は Python 3 (具体的には CPython-3.7.3) をサポートするようになりました。このトピックでは、Python 3 でユーザー定義集計関数 (UDAF) を作成する方法について説明します。
UDAF コードの構造
MaxCompute Studio を使用して、Python 3 でユーザー定義集計関数 (UDAF) のコードを作成できます。コードには、次の情報を含める必要があります。
- モジュールのインポート:必須。
少なくとも
from odps.udf import annotateとfrom odps.udf import BaseUDAFをインポートする必要があります。from odps.udf import annotate文は、MaxCompute がコードで定義された関数シグネチャを認識できるようにする関数シグネチャモジュールをインポートします。from odps.udf import BaseUDAFは、Python UDAF の基底クラスをインポートします。派生クラスでは、iterate、merge、terminateなどのメソッドを実装する必要があります。UDAF コードがファイルリソースまたはテーブルリソースを参照する必要がある場合は、ファイルリソースには
from odps.distcache import get_cache_fileを、テーブルリソースにはfrom odps.distcache import get_cache_tableを含めます。 関数シグネチャ:必須。
フォーマットは
@annotate(<signature>)です。signatureは、関数の入力パラメーターと戻り値のデータ型を定義します。関数シグネチャの詳細については、「関数シグネチャとデータ型」をご参照ください。カスタム Python クラス (派生クラス):必須。
このクラスは UDAF コードの組織単位です。ビジネスロジックを実装する変数とメソッドを定義します。コード内でビルトインのサードパーティライブラリ、ファイル、またはテーブルリソースを参照することもできます。詳細については、「サードパーティライブラリ」または「リソースの参照」をご参照ください。
- Python クラスメソッドの実装:必須。
Python クラスの実装には、次のメソッドが含まれます。必要に応じてメソッドを実装できます。
メソッド定義 説明 BaseUDAF.new_buffer()集計関数の中間値用のバッファーを返します。 bufferは、LIST や DICT などの Marshal オブジェクトである必要があります。bufferのサイズはデータ量に応じて増加してはいけません。極端な場合、オブジェクトシリアル化後のbufferのサイズは 2 MB を超えてはなりません。BaseUDAF.iterate(buffer[, args, ...])argsを中間値bufferに集計します。BaseUDAF.merge(buffer, pbuffer)中間値 bufferとpbufferをマージし、結果をbufferに格納します。BaseUDAF.terminate(buffer)bufferを MaxCompute SQL の基本データ型に変換します。
次のコードは UDAF の例です。
# 関数シグネチャモジュールと基底クラスをインポートします。
from odps.udf import annotate
from odps.udf import BaseUDAF
# 関数シグネチャ。
@annotate('double->double')
# カスタム Python クラス。
class Average(BaseUDAF):
# Python クラスのメソッドを実装します。
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
return buffer[0] / buffer[1]avg) を計算するための MaxCompute UDAF の実装ロジックと計算フローを示しています。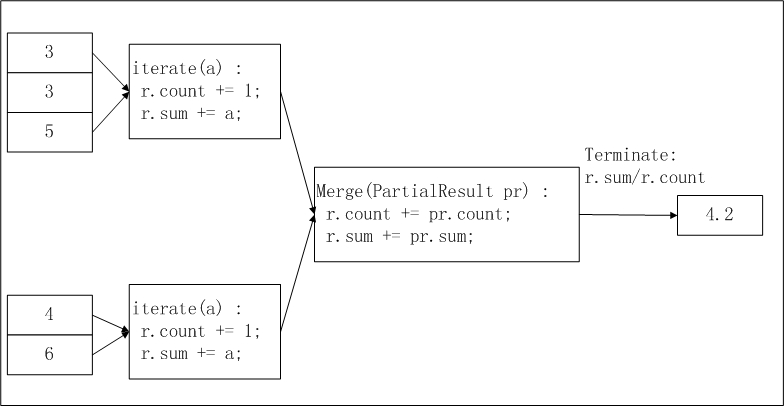
pbuffer は図中の pr に対応し、buffer は r に対応します。Python 2 UDAF と Python 3 UDAF の違いは、基盤となる Python のバージョンです。対応する Python バージョンの機能に基づいて UDAF を作成する必要があります。
注意事項
Python 3 は Python 2 と互換性がなく、両方を同じ SQL ステートメントで使用することはできません。切り替える前に互換性を考慮してください。
Python 2 は 2020 年初頭に保守終了 (EOL) となりました。プロジェクトの種類に基づいてプロジェクトを移行することを推奨します。
Python 2 UDAF の移行
Python Software Foundation はまもなく Python 2 の保守を終了します。プロジェクトの種類に基づいてプロジェクトを移行することを推奨します。
新規プロジェクト:これは、新規の MaxCompute プロジェクト、または初めて Python UDAF を作成する MaxCompute プロジェクトに適用されます。すべての Python UDAF を Python 3 で作成することを推奨します。
既存のプロジェクト:これは、多数の既存の Python 2 UDAF を持つ MaxCompute プロジェクトに適用されます。Python 3 の有効化は慎重に行ってください。すべての Python 2 UDAF を段階的に Python 3 に移行する予定の場合は、次のメソッドを使用します。
新しいジョブと新しい UDAF:Python 3 で作成し、セッションレベルで Python 3 を有効にします。Python 3 を有効にする方法の詳細については、「Python 3 の有効化」をご参照ください。
Python 2 UDAF:Python 2 と Python 3 の両方と互換性があるように Python 2 UDAF を書き換えます。コードの書き換えの詳細については、「Porting Python 2 Code to Python 3」をご参照ください。
説明パブリック UDAF を作成し、複数の MaxCompute プロジェクトに使用権限を付与する場合は、UDAF を Python 2 と Python 3 の両方と互換性があるようにすることを推奨します。
Python 3 の有効化
デフォルトでは、MaxCompute は Python 2 を使用します。Python 3 を使用するには、SQL ステートメントに次のセッションフラグを含めます。
set odps.sql.python.version=cp37;サードパーティライブラリ
MaxCompute に組み込まれている Python 3 実行環境には、サードパーティライブラリ NumPy がインストールされていません。NumPy を必要とする UDAF を使用するには、NumPy の WHEEL パッケージを手動でアップロードする必要があります。PyPI またはミラーから NumPy パッケージをダウンロードすると、パッケージファイル名は numpy-<version_number>-cp37-cp37m-manylinux1_x86_64.whl になります。パッケージのアップロード方法の詳細については、「リソース操作」または「UDF の例:Python UDF でサードパーティパッケージを使用する」をご参照ください。
関数シグネチャとデータ型
@annotate(<signature>)signature は、入力パラメーターと戻り値のデータ型を識別する文字列です。UDAF を実行する場合、その入力パラメーターと戻り値のデータ型は、関数シグネチャで指定された型と一致する必要があります。クエリ解析フェーズ中に、システムは関数呼び出しを関数シグネチャに対して検証します。型の不一致が見つかった場合、エラーが報告されます。具体的なフォーマットは次のとおりです。'arg_type_list -> type'-
arg_type_list:入力パラメーターのデータ型を表します。複数の入力パラメーターをコンマ (,) で区切って指定できます。サポートされているデータ型は、BIGINT、STRING、DOUBLE、BOOLEAN、DATETIME、DECIMAL、FLOAT、BINARY、DATE、DECIMAL(precision,scale)、CHAR、VARCHAR、複雑なデータ型 (ARRAY、MAP、STRUCT)、およびネストされた複雑なデータ型です。arg_type_listは、アスタリスク (*) または空の文字列 ('') もサポートします。-
arg_type_listがアスタリスク (*) の場合、関数が任意の数の入力パラメーターを受け入れることを示します。 -
arg_type_listが空の文字列 ('') の場合、関数に入力パラメーターがないことを示します。
Resolve アノテーションの拡張構文の詳細については、「UDAF と UDTF の動的パラメーター」をご参照ください。
-
-
type:戻り値のデータ型を表します。UDAF は 1 つの列のみを返します。サポートされているデータ型には、BIGINT、STRING、DOUBLE、BOOLEAN、DATETIME、DECIMAL、FLOAT、BINARY、DATE、DECIMAL(precision,scale)、複雑なデータ型 (ARRAY、MAP、STRUCT)、およびネストされた複雑なデータ型が含まれます。
以下は有効な関数シグネチャです。
| 関数シグネチャの例 | 説明 |
@annotate('bigint,double->string') | 入力パラメーターの型は BIGINT と DOUBLE で、戻り値の型は STRING です。 |
@annotate('*->string') | 関数は任意の数の入力パラメーターを受け入れ、戻り値の型は STRING です。 |
@annotate('->double') | 関数には入力パラメーターがなく、戻り値の型は DOUBLE です。 |
@annotate('array<bigint>->struct<x:string, y:int>') | 入力パラメーターの型は ARRAY<BIGINT> で、戻り値の型は STRUCT<x:STRING, y:INT> です。 |
Python UDAF のデータ型が MaxCompute でサポートされているデータ型と一致するように、正しいデータ型マッピングを使用する必要があります。次の表に、これらのマッピングを示します。
|
MaxCompute SQL 型 |
Python 3 型 |
|
BIGINT |
INT |
|
STRING |
UNICODE |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
DATETIME.DATETIME |
|
FLOAT |
FLOAT |
|
CHAR |
UNICODE |
|
VARCHAR |
UNICODE |
|
BINARY |
BYTES |
|
DATE |
DATETIME.DATE |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
リソースの参照
Python UDAF は、odps.distcache モジュールを使用してファイルリソースとテーブルリソースを参照できます。
odps.distcache.get_cache_file(resource_name):指定されたファイルリソースのファイルライクオブジェクトを返します。resource_nameは STRING 型で、現在の MaxCompute プロジェクトに存在するファイルリソースの名前に対応します。ファイルリソース名が無効であるか、リソースが存在しない場合は、例外が発生します。説明 UDAF からリソースにアクセスするには、UDAF を作成するときに参照するリソースを宣言する必要があります。そうしないと、エラーが報告されます。- 戻り値はファイルライクオブジェクトです。このオブジェクトの使用が終了したら、
closeメソッドを呼び出して開いているリソースファイルを解放します。
odps.distcache.get_cache_table(resource_name):指定されたテーブルリソースのジェネレーターオブジェクトを返します。resource_nameは STRING 型で、現在の MaxCompute プロジェクトに存在するテーブルリソースの名前に対応します。テーブルリソース名が無効であるか、リソースが存在しない場合は、例外が発生します。- 戻り値は GENERATOR 型です。呼び出し元はジェネレーターを走査してテーブルの内容を取得します。各反復では、テーブルから 1 つのレコードが配列として返されます。
使用方法の詳細については、「リソースの参照 (Python 3 UDF)」および「リソースの参照 (Python 3 UDTF)」をご参照ください。
注意事項
開発フローに従って Python 3 UDAF を開発した後、MaxCompute SQL ステートメントでそれを呼び出すことができます。呼び出しメソッドは次のとおりです。
MaxCompute プロジェクトで UDF を使用する:メソッドはビルトイン関数の使用方法と似ています。ビルトイン関数を使用するのと同じ方法でユーザー定義関数を使用できます。
プロジェクト間で UDF を使用する:プロジェクト A でプロジェクト B の UDF を使用します。次のステートメントは例を示しています:
select B:udf_in_other_project(arg0, arg1) as res from table_t;。プロジェクト間の共有の詳細については、「パッケージに基づくプロジェクト間のリソースアクセス」をご参照ください。
MaxCompute Studio を使用して Python 3 UDAF を開発および呼び出す完全なプロシージャについては、「Python UDF の開発」をご参照ください。
UDAF の動的パラメーター
関数シグネチャ
Python UDAF 関数シグネチャのフォーマットの詳細については、「関数シグネチャとデータ型」をご参照ください。
パラメーターリストでアスタリスク (
*) を使用して、任意の数と任意の型の入力パラメーターを受け入れることができます。たとえば、@annotate('double,*->string')は、最初のパラメーターが DOUBLE 型であり、その後に任意の数と任意の型のパラメーターリストが続くことを示します。この場合、入力パラメーターの数と型を決定し、それらに対応する操作を実行するコードを記述する必要があります。これは、C 言語のprintf関数に似ています。説明アスタリスク (
*) は、戻り値リストで使用される場合、意味が異なります。UDTF の戻り値でアスタリスク (
*) を使用して、任意の数の STRING 型の戻り値を示すことができます。戻り値の数は、関数が呼び出されるときに設定されるエイリアスの数によって異なります。たとえば、@annotate("bigint,string->double,*")の場合、呼び出しメソッドはUDTF(x, y) as (a, b, c)です。この例では、asの後に 3 つのエイリアスが設定されています:a、b、c。エディターは、アノテーションで戻り値の最初の列の型が指定されているため、aを DOUBLE 型と見なし、bとcを STRING 型と見なします。3 つの戻り値が指定されているため、UDTF がforwardを呼び出すとき、forwardは長さ 3 の配列でなければなりません。そうでない場合、実行時エラーが発生します。説明この種のエラーはコンパイル時に報告できません。したがって、UDTF の呼び出し元が SQL ステートメントでエイリアスの数を設定するときは、UDTF によって定義されたルールに従う必要があります。集計関数の戻り値の数は 1 に固定されているため、この特徴は UDAF には該当しません。
UDAF の例
from odps.udf import annotate
from odps.udf import BaseUDAF
@annotate('bigint,*->string')
class MultiColSum(BaseUDAF):
    def new_buffer(self):
        return [0]
    def iterate(self, buffer, *args):
        for arg in args:
            buffer[0] += int(arg)
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
    def terminate(self, buffer):
        return str(buffer[0])
UDAF は 1 つの戻り値しか持つことができません。上記の UDAF の例では、戻り値は複数の入力パラメーターの合計であり、それが複数の行にわたって集計および合計されます。次のコードは使用例です。
-- 複数の入力パラメーターを合計します。
SELECT my_multi_col_sum(a,b,c,d,e) from values (1,"2","3","4","5"), (6,"7","8","9","10") t(a,b,c,d,e);
-- 戻り値は 55 です。