挿入または更新のパフォーマンスが期待を下回る場合は、まず Hologres コンソールの CPU 使用率メトリックを確認してください。CPU 使用率が低い場合は、アップストリームのボトルネック (データ読み取りの遅延) を示しています。CPU 使用率が高い (常に 100% に近い) 場合は、Hologres 自体がボトルネックであることを意味します。このトピックでは、両方のケースの診断と解決方法について説明します。
仕組み
Hologres のすべての SQL ステートメントは、次の 2 つの実行パスのいずれかに従います。
-
標準パス (HQE/PQE) — クエリオプティマイザー (QO) とクエリエンジン (QE) を通過します。書き込み操作はテーブルロックを取得するため、同時実行される
INSERT、UPDATE、DELETEステートメントは互いに待機する必要があり、高負荷時には高いレイテンシーが発生します。ほとんどの書き込み操作は HQE (Hologres Query Engine) が処理し、PQE (PostgreSQL Query Engine) は互換性シナリオを処理します。 -
Fixed Plan パス (FixedQE) — 単純なポイント書き込みのために QO と QE をバイパスします。テーブルロックの代わりに行ロックを使用することで、書き込みの同時実行性とスループットが劇的に向上します。
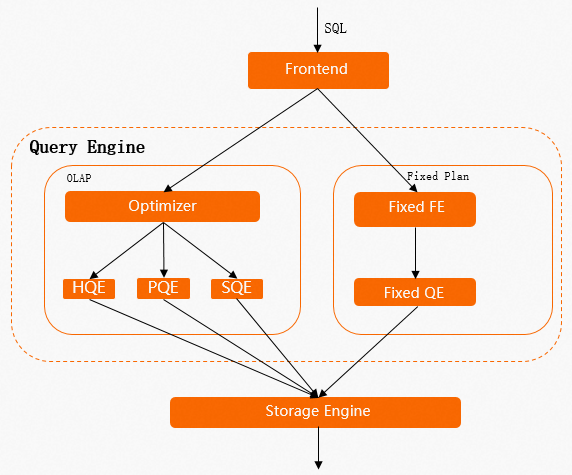
この違いを理解することで、ほとんどの書き込みパフォーマンスの問題の原因と、なぜ Fixed Plan の有効化が最も効果的な最適化であるかがわかります。
パフォーマンスのベースライン
チューニングを行う前に、ご利用のテーブル構成のパフォーマンス上限を把握しておきましょう。
ストレージフォーマット別 (全列書き込み/更新):
行指向 > 列指向 > 行列ハイブリッド
ストレージフォーマット別 (部分列書き込み/更新):
行指向 > 行列ハイブリッド > 列指向
列指向テーブルの書き込みモード別:
パフォーマンスは、結果テーブルにプライマリキーがない場合に最も高くなります。結果テーブルにプライマリキーがある場合、パフォーマンスは次のようにランク付けされます。
InsertOrIgnore > InsertOrReplace >= InsertOrUpdate (full) > InsertOrUpdate (partial)
行指向テーブルの書き込みモード別:
InsertOrReplace = InsertOrUpdate (full) >= InsertOrUpdate (partial) >= InsertOrIgnore
Binlog が有効なテーブルの場合:
行指向 > 行列ハイブリッド > 列指向
書き込みモード
|
書き込みモード |
動作 |
プライマリキーが必須 |
|
|
追加のみ。重複行はチェックされません。 |
いいえ |
|
|
プライマリキーの競合が発生した場合、受信レコードは破棄されます。 |
はい |
|
|
プライマリキーの競合が発生した場合、既存の行が置き換えられます。書き込みに含まれない列は NULL に設定されます。 |
はい |
|
|
プライマリキーの競合が発生した場合、指定された列のみが更新されます。書き込みに含まれない列は既存の値を保持します。 |
はい |
書き込みモードの選択:
-
プライマリキーのない追加専用パイプラインには
Insertを使用します。 -
重複排除がアップストリームで処理され、プライマリキーテーブルで最高の書き込みスループットを求める場合は
InsertOrIgnoreを使用します。 -
行全体の置換が必要で、欠損列に NULL を設定することが許容される場合は
InsertOrReplaceを使用します。 -
部分的な列の更新には
InsertOrUpdateを使用します。エンジンが書き込み前に既存の行を検索する必要があるため、パフォーマンスのトレードオフを受け入れることになります。
ボトルネックの特定
Hologres コンソールで CPU 使用率を確認します。
|
CPU 使用率 |
解釈 |
次のステップ |
|
低い |
Hologres のリソースが十分に活用されていません。ボトルネックはアップストリームにあります。 |
アップストリームのソースでデータ読み取りが遅くなっていないか確認します。 |
|
高い (常に 100% に近い) |
Hologres がリソースのボトルネックに達しています。 |
このトピックのチューニング方法を適用します。 |
クエリと書き込みが同時に実行されると、クエリによって CPU 使用率が高くなり、書き込みパフォーマンスに影響を与える可能性があります。スロークエリログをチェックして、同時実行クエリがリソースを消費しているかどうかを確認します。もしそうであれば、読み書き分離 を用いた高可用性 (HA) デプロイメントの構成を検討してください。
すべてのチューニング方法を試しても書き込みパフォーマンスが要件を満たさない場合は、Hologres インスタンスをスケールアップしてください。
Fixed Plan の有効化
Fixed Plan は、書き込みパフォーマンスにとって最も影響の大きい単一の最適化です。他の方法を試す前に、これを有効にしてください。
書き込みが Fixed Plan を使用しているかの確認
Hologres コンソールで、次の RPS メトリックを確認します。
-
QE DML RPS — 標準の HQE/PQE パスを通過する書き込み (テーブルロック、高レイテンシー)。
-
FixedQE DML RPS — Fixed Plan を使用する書き込み (行ロック、高同時実行性)。
Fixed Plan を使用していない書き込み操作を見つけるには、スロークエリログをクエリします。
-- 過去3時間以内に Fixed Plan を使用しなかった INSERT、UPDATE、DELETE 操作を検索
SELECT *
FROM hologres.hg_query_log
WHERE query_start >= now() - interval '3 h'
  AND command_tag IN ('INSERT', 'UPDATE', 'DELETE')
  AND ARRAY['HQE'] && engine_type
ORDER BY query_start DESC
LIMIT 500;
Fixed Plan が使用されないシナリオ
次のいずれかの条件に一致する SQL ステートメントは、HQE パスにフォールバックします。
-
複数行の
INSERT ON CONFLICT構文:INSERT INTO test_upsert(pk1, pk2, col1, col2) VALUES (1, 2, 5, 6), (2, 3, 7, 8) ON CONFLICT (pk1, pk2) DO UPDATE SET col1 = excluded.col1, col2 = excluded.col2; -
Hologres テーブルの列が挿入データ列と一致しない部分更新のための
INSERT ON CONFLICT。 -
Hologres テーブルに
SERIAL型の列が含まれている。 -
Hologres テーブルに
Defaultプロパティが設定されている。 -
プライマリキーに基づく
UPDATEまたはDELETE(例:UPDATE table SET col1 = ?, col2 = ? WHERE pk1 = ? AND pk2 = ?)。 -
Fixed Plan でサポートされていないデータ型。
これらのシナリオで Fixed Plan を有効化
GUC パラメーターを使用して、Fixed Plan の適用範囲を拡張します。これらはデータベースレベルで設定します。
|
シナリオ |
GUC パラメーター |
注意 |
|
複数行の |
|
データベースレベルで設定します。 |
|
|
|
Hologres V1.3.25 以降ではデフォルトで |
|
|
Hologres V1.3 以降では GUC は不要です。 |
V1.3 以降では、 |
|
プライマリキーに基づく |
|
Hologres V1.3.25 以降ではデフォルトで |
|
プライマリキーに基づく |
|
Hologres V1.3.25 以降ではデフォルトで |
詳細については、「固定プランによる SQL 実行の高速化」をご参照ください。
書き込みが Fixed Plan を使用すると、FixedQE DML RPS メトリックにカウントされ、スロークエリログの engine_type フィールドには FixedQE が表示されます。
Hologres V2.2 より前は、Fixed Plan の書き込みは engine_type が SDK と報告され、コンソールはすべての DML 書き込みを単一の統合 RPS メトリックで追跡していました。Hologres V2.2 以降、engine_type は FixedQE となり、メトリックは QE DML RPS と FixedQE DML RPS に分割されました。メトリックの定義については、「監視メトリック」をご参照ください。
Fixed Plan は有効だが書き込みが遅い場合
書き込みが既に Fixed Plan を使用しているにもかかわらずレイテンシーが高い場合、最も一般的な原因は、同じテーブルに対する HQE と FixedQE の書き込みが混在していることです。HQE 操作はテーブルロックを保持し、これが FixedQE の書き込みをブロックします。確認するには、次のようにします。
-- 過去3時間以内の特定のテーブルに対する HQE 操作を検索
SELECT *
FROM hologres.hg_query_log
WHERE query_start >= now() - interval '3 h'
  AND command_tag IN ('INSERT', 'UPDATE', 'DELETE')
  AND ARRAY['HQE'] && engine_type
  AND table_write = '<table_name>'
ORDER BY query_start DESC
LIMIT 500;
HQE 操作を FixedQE 互換のステートメントに書き換えてください。HoloWeb の クエリ診断の取得 を使用すると、HQE ロックが Fixed Plan の書き込みをブロックしているかどうかを迅速に特定できます。
すべての書き込みが既に FixedQE 書き込みであり、それでもレイテンシーが高い場合は、CPU 使用率を確認してください。一貫して高い CPU 使用率は、インスタンスのリソースボトルネックを示しています。スケールアウトを検討してください。
基本的なチューニング方法
VPC 接続の使用
パブリックネットワークの代わりに Virtual Private Cloud (VPC) 接続を使用してください。パブリックネットワークにはトラフィック制限があり、VPC よりもレイテンシーが高くなります。これは特に、Java Database Connectivity (JDBC) や psql を介してアプリケーションから接続する場合に当てはまります。
Hologres がサポートするネットワークタイプと選択のガイダンスについては、「ネットワーク構成」をご参照ください。
列指向テーブルでの Binlog 有効化の回避
Binlog は、すべての INSERT、UPDATE、DELETE を行全体のレベルで記録します。列指向テーブルの場合、行全体の変更を記録するには、行全体を読み取るためのポイントクエリが必要となり、これは行指向テーブルよりも多くのリソースを消費します。Binlog が必要な場合は、行指向テーブルを使用してください。
同一テーブルへのリアルタイム書き込みとバッチ書き込みの同時実行の回避
バッチ書き込み (例:MaxCompute から Hologres へ) はテーブルロックを使用します。ストリーム書き込み (例:Flink や DataWorks Data Integration) は、通常 Fixed Plan を介して行ロックを使用します。両方が同じテーブルに対して同時に実行されると、バッチ書き込みのテーブルロックが解放されるまで、すべてのリアルタイム書き込みがブロックされます。これらのワークロードは分離してください。バッチ書き込みはメンテナンスウィンドウで実行するか、別のテーブルに書き込むようにします。
INSERT OVERWRITE を使用したパーティションデータの置換
パーティション内のすべてのデータを置換またはクリアする必要がある場合は、DELETE に続けて INSERT を行うのではなく、INSERT OVERWRITE を使用してください。
INSERT OVERWRITE は、ファイルポインタを交換することでパーティションデータを置き換えるメタデータレベルの操作です。これは迅速に実行され、動的プルーニングロジックをトリガーしません。対照的に、DELETE ステートメントは、エンジンが行を特定して削除するためにパーティション内のすべてのデータファイルをスキャンする必要があり、大幅な I/O と CPU オーバーヘッドを引き起こします。DELETE + INSERT での書き込みパフォーマンスは、INSERT OVERWRITE よりも大幅に低くなります。
スケジューリングタスクを使用してパーティションテーブルに書き込む場合は、スケジューリングパラメーターを使用して、INSERT OVERWRITE ステートメントでターゲットパーティションを直接指定します。サブクエリを使用して削除および再挿入するデータを決定することは避けてください。
-- 推奨:スケジューリングパラメーターと共に INSERT OVERWRITE を使用
INSERT OVERWRITE hologres_table PARTITION(ds='${bizdate}')
SELECT col1, col2, col3
FROM source_table
WHERE ds = '${bizdate}';

-- 非推奨:DELETE + INSERT
DELETE FROM hologres_table WHERE ds = '${bizdate}';
INSERT INTO hologres_table
SELECT col1, col2, col3
FROM source_table
WHERE ds = '${bizdate}';
Holo Client と JDBC 書き込みのチューニング
バッチでの書き込み
バッチ書き込みは、単一レコードの書き込みよりも大幅に高いスループットを提供します。
-
Holo Client はデータを自動的にバッチ処理します。デフォルトの構成を使用してください。
-
JDBC — 接続文字列に
reWriteBatchedInserts=trueを追加します。jdbc:postgresql://{ENDPOINT}:{PORT}/{DBNAME}?ApplicationName={APPLICATION_NAME}&reWriteBatchedInserts=true
次の例は、バッチ処理の仕組みを示しています。
-- 2つの個別の挿入 (低スループット)
INSERT INTO data_t VALUES (1, 2, 3);
INSERT INTO data_t VALUES (2, 3, 4);

-- バッチ挿入 (高スループット)
INSERT INTO data_t VALUES (1, 2, 3), (4, 5, 6);

-- または、unnest を使用
INSERT INTO data_t
SELECT unnest(ARRAY[1, 4]::int[]), unnest(ARRAY[2, 5]::int[]), unnest(ARRAY[3, 6]::int[]);詳細については、「Holo Client」および「JDBC」をご参照ください。
プリペアドステートメントモードの使用
Hologres は PostgreSQL 拡張プロトコルとプリペアドステートメントモードをサポートしています。これにより、SQL コンパイル結果がサーバーにキャッシュされ、書き込みのたびにフロントエンド (FE) と QO での繰り返し解析のオーバーヘッドがなくなります。これは特に高頻度の書き込みに有益です。
JDBC と Holo Client でプリペアドステートメントモードを有効にする方法については、「JDBC」をご参照ください。
Flink 書き込みのチューニング
テーブルタイプの要件
Binlog ソーステーブル:
-
Flink は Hologres Binlog を消費する際に、限られたデータ型セットをサポートします。サポートされていない型 (例:
SMALLINT) がスキーマに存在する場合、そのフィールドを消費しなくてもジョブが失敗することがあります。Ververica Runtime (VVR) 6.0.3 以降では、Binlog 消費に JDBC モードを使用してください。より多くのデータ型をサポートしています。 -
Binlog が有効なソースには行指向テーブルを使用してください。列指向テーブルで Binlog を有効にすると、より多くのリソースを消費し、書き込みパフォーマンスが低下します。
ディメンションテーブル:
-
行指向または行列ハイブリッドテーブルを使用してください。列指向テーブルは、ポイントクエリのシナリオで高いオーバーヘッドがあります。
-
プライマリキーを設定してください。パフォーマンス向上のために、プライマリキーをクラスタリングキーとして構成します。
-
ディメンションテーブルのプライマリキーは、Flink の
JOIN ON句で使用されるフィールドと完全に一致している必要があります。両者は同一でなければなりません。
結果テーブル:
-
ワイドテーブルのマージや部分更新の場合、Hologres テーブルにはプライマリキーが必要です。各結果テーブルはプライマリキーフィールドを宣言して書き込み、
InsertOrUpdate書き込みモードを使用し、リトラクションメッセージがDELETEリクエストを生成しないようにignoredelete = trueを設定する必要があります。 -
ワイドテーブルマージシナリオの列指向テーブルでは、高い秒間レコード数 (RPS) での CPU 使用率を削減するために、テーブルフィールドのディクショナリエンコーディングを無効にします。
-
プライマリキーを持つテーブルには
segment_keyを設定してください。書き込み時間と強い相関のあるタイムスタンプまたは日付フィールドを使用します。これにより、エンジンは書き込みおよび更新中にターゲットデータファイルを迅速に見つけることができます。
推奨される Flink コネクタ構成
Hologres コネクタオプションのデフォルト値は、ほとんどのシナリオに適しています。次の問題が発生した場合に調整してください。
Binlog 消費における高レイテンシー:
デフォルトのバッチ読み取りサイズ (binlogBatchReadSize) は 100 行です。個々の行が小さい場合は、この値を増やして消費レイテンシーを削減します。
ディメンションテーブルのポイントクエリパフォーマンスの低下:
-
async = trueを設定して非同期モードを有効にします。これにより、複数のリクエストが同時に処理され、連続するリクエスト間のブロッキングが排除されます。非同期モードは厳密なリクエスト順序を保証しないことに注意してください。 -
大きく、更新頻度の低いディメンションテーブルの場合は、LRU キャッシュを有効にします。
cache = 'LRU'を設定します。デフォルトのcacheSizeは 10,000 行 (控えめ) です。実際のテーブルサイズとアクセスパターンに基づいて増やしてください。
多数の Flink ジョブによる接続の枯渇:
connectionPoolName パラメーターを使用してください。同じ TaskManager 内で同じ接続プール名を持つテーブルは、接続を共有します。
ジョブ開発のプリファレンス
保守性と移植性の観点から、DataStream よりも Flink SQL を優先してください。
Flink SQL > Flink DataStream (コネクタ) > Flink DataStream (holo-client) > Flink DataStream (JDBC)
DataStream ジョブでは、生の JDBC ではなく、Hologres DataStream コネクタまたは Holo Client を使用してください。
遅い Flink 書き込みの診断
Flink での書き込みの遅延は、Hologres の結果テーブルではなく、ジョブの初期段階のボトルネックが原因である可能性があります。ノードのバックプレッシャーを確認してください。ソースまたは計算ノードでバックプレッシャーが発生している場合、Hologres の結果テーブルに到着するデータはすでに遅くなっています。まずアップストリームの Flink ステップを最適化してください。
Hologres の CPU 使用率が一貫して 100% に近く、書き込みレイテンシーが高い場合、ボトルネックは Hologres 側にあります。
一般的な Flink のエラーと解決策については、「Blink と Flink の FAQ と診断」をご参照ください。
DataWorks Data Integration 書き込みのチューニング
接続と同時実行数の設定
ウィザードモードでは、各並行スレッドは 3 つの接続を使用します。コードエディタモードでは、次のように構成します。
-
maxConnectionCount— タスクの総接続数。 -
insertThreadCount— 並行スレッドあたりの接続数。
ほとんどの場合、デフォルトの同時実行数と接続設定で良好なパフォーマンスが得られます。リソース競合が観察された場合にのみ調整してください。
専用リソースグループのサイジング
ほとんどの Data Integration ジョブには専用リソースグループが必要です。リソースグループの仕様が、タスクのパフォーマンス上限を設定します。最適なスループットを得るには、リソースグループの CPU コアごとに 1 つの並行スレッドを割り当てます。
リソースグループがタスクの同時実行数に対して小さすぎる場合、JVM メモリエラーが発生することがあります。リソースグループの帯域幅が飽和状態の場合は、タスクをより小さなタスクに分割し、複数のリソースグループに分散させてください。リソースグループの仕様とメトリックについては、「パフォーマンスメトリック」をご参照ください。
ボトルネックがアップストリームか Hologres かの診断
-
読み取り側の待機時間が書き込み側の待機時間よりも長い場合、ボトルネックはアップストリームのデータソースにあります。
-
Hologres の CPU 使用率が一貫して高く、書き込みレイテンシーが上昇している場合、ボトルネックは Hologres 側にあります。
DataX の書き込みが遅く、CPU 使用率が高い場合
DataX の書き込みが遅く、Hologres インスタンス監視で CPU 使用率が高いレベル (例えば、一部のワーカーノードが 100% に達する) を維持している場合、CPU リソースの飽和が原因で、受信した書き込みリクエストがキューイングされたり、処理遅延が発生したりしています。
この問題を解決するには、次のようにします。
-
書き込みが Fixed Plan を使用しているか確認します。Hologres コンソールで、RPS メトリックを確認します。書き込みが FixedQE DML RPS ではなく QE DML RPS (HQE パス) に表示される場合、それらは Fixed Plan を使用していません。GUC パラメーターを構成するか、SQL ステートメントを書き換えて Fixed Plan を有効にしてください。詳細については、このトピックの「Fixed Plan の有効化」セクションをご参照ください。
-
Fixed Plan が既に有効になっているにもかかわらず CPU 使用率が一貫して高い場合、インスタンスはリソース容量に達しています。Hologres インスタンスをスケールアップして、より多くのコンピューティングリソースを追加してください。
高度なチューニング
これらの方法は、データ分散とテーブル構成によって引き起こされるパフォーマンス問題に対処します。Fixed Plan を有効にし、基本的なチューニング方法を使用した後に適用してください。
データスキュー
データが偏っているか、分散キーが不適切に設定されていると、Hologres インスタンス内のコンピューティングリソースが不均衡になります。一部のシャードが他のシャードよりもはるかに多くの作業を行うことになります。データスキューを確認して解決するには、「ワークロードスキューの検出と対処」をご参照ください。
不適切なセグメントキー
セグメントキーは、Hologres がデータを基盤となるストレージファイルにどのようにパーティション分割するかを制御します。書き込みおよび更新中、Hologres はセグメントキーを使用して既存の行を特定します。セグメントキーがない場合、無関係なフィールドに設定されている場合、またはセグメントキーフィールドのデータが書き込み時間と相関がない場合 (例えば、順不同で到着する場合)、すべての書き込みは多数のファイルをスキャンする必要があり、ワークロードが書き込み中心であっても、大量の I/O と CPU を消費します。
症状として、コンソールの IO スループットメトリックが、主に書き込みワークロード中に高い読み取り値を示すことがあります。
修正:タイムスタンプまたは日付フィールドをセグメントキーとして使用します。このフィールドのデータは、書き込み時間と強い相関関係を持つ必要があります。ほぼ時系列順に到着する値が最良の結果を生み出します。
行指向テーブルにおける不適切なクラスタリングキー
プライマリキーを持つ行指向テーブルの場合、Hologres は書き込みまたは更新中に既存の行を検索するために、プライマリキーインデックスとクラスタリングキーインデックスの両方を使用します。クラスタリングキーがプライマリキーと異なる場合、各書き込みは 1 回ではなく 2 回のインデックスルックアップを実行し、レイテンシーが増加します。
行指向テーブルでは、クラスタリングキーとプライマリキーを同一に保ってください。
列指向テーブルでは、クラスタリングキーは書き込みパフォーマンスではなく、クエリパフォーマンスに影響します。書き込み最適化のための変更は不要です。