Hologres のダイナミックテーブルは、1 つ以上のベーステーブルから集計した結果を自動的に処理・保存する、宣言的なデータ処理アーキテクチャです。設定可能な組み込みのデータリフレッシュポリシーによってベーステーブルからダイナミックテーブルへのデータ転送が自動化され、開発の統一、データ転送の自動化、タイムリーなデータ処理といったニーズに対応します。
ダイナミックテーブルのユースケース
ダイナミックテーブルは、次のような場合に適しています。
-
カスタムのスケジューリングコードを記述することなく、データ変換を自動化したい場合。
-
データ依存関係を手動で追跡したり、リフレッシュスケジュールを管理したりすることを避けたい場合。
-
データウェアハウスの DWD (Data Warehouse Detail) → DWS (Data Warehouse Service) → ADS (Application Data Service) の各層を自動的に構築するなど、パイプラインで複数のテーブルを連結してデータ変換を行う場合。
-
ワークロードに厳密なリアルタイムの鮮度が不要で、分単位または時間単位の適時性で十分な場合。
-
ラムダアーキテクチャを、統一された SQL インターフェースを持つ単一のエンジンに統合したい場合。
メリット
-
データウェアハウスアーキテクチャの簡素化:フルリフレッシュモードと増分リフレッシュモードは、オフラインデータ変換とニアリアルタイムデータ変換の両方をサポートします。Hologres の統一ストレージに基づき、ダイナミックテーブルは単一のエンジン、単一の計算、単一の SQL ステートメントを使用して、オンライン分析処理 (OLAP) クエリ、オンラインサービス、AI ワークロードといった複数のアプリケーションシナリオに直接対応します。これにより、ラムダアーキテクチャが不要になり、開発コストと運用保守 (O&M) コストを削減します。
-
[データウェアハウス階層化の自動化]:ダイナミックテーブルは、ベーステーブルデータの鮮度に基づいて自動的にリフレッシュをトリガーし、運用データストア (ODS) → DWD → DWS → ADS の各層へのデータ転送を自動化します。
-
ETL 効率の向上:増分リフレッシュは、実行ごとにベーステーブルから新しいデータのみを処理し、1 回の抽出、変換、ロード (ETL) サイクルで計算されるデータ量を削減します。ストリームコンピューティングのようにリソースを常にアクティブにしておく必要はありません。データの鮮度によってトリガーされる自動リフレッシュにより、コンピューティングコストが削減されます。
-
開発コストと運用保守 (O&M) コストの削減:すべてのリフレッシュモードで統一された SQL インターフェースを使用します。ダイナミックテーブルはリフレッシュタスクと階層間の依存関係を自動的に管理するため、複雑な開発ワークフローと運用保守ワークフローが簡素化されます。
基本概念
-
ベーステーブル:ダイナミックテーブルのデータソースです。単一の内部テーブルまたは外部テーブル、あるいは複数テーブルの結合が可能です。サポートされるベーステーブルのタイプは、リフレッシュモードによって異なります。詳細については、「ダイナミックテーブルでサポートされる機能と制限」をご参照ください。
-
クエリ:ダイナミックテーブルの作成時に指定するクエリです。ETL プロセスと同様に、ベーステーブルのデータの処理方法を定義します。サポートされるクエリタイプは、リフレッシュモードによって異なります。詳細については、「ダイナミックテーブルでサポートされる機能と制限」をご参照ください。
-
リフレッシュ:ベーステーブルのデータが変更されると、その変更を反映するためにダイナミックテーブルをリフレッシュする必要があります。ダイナミックテーブルは、設定されたリフレッシュ開始時刻と間隔に基づいて、バックグラウンドでリフレッシュタスクを自動的に実行します。リフレッシュタスクのモニタリングと管理に関する詳細については、「ダイナミックテーブルのリフレッシュタスクの管理」をご参照ください。
仕組み
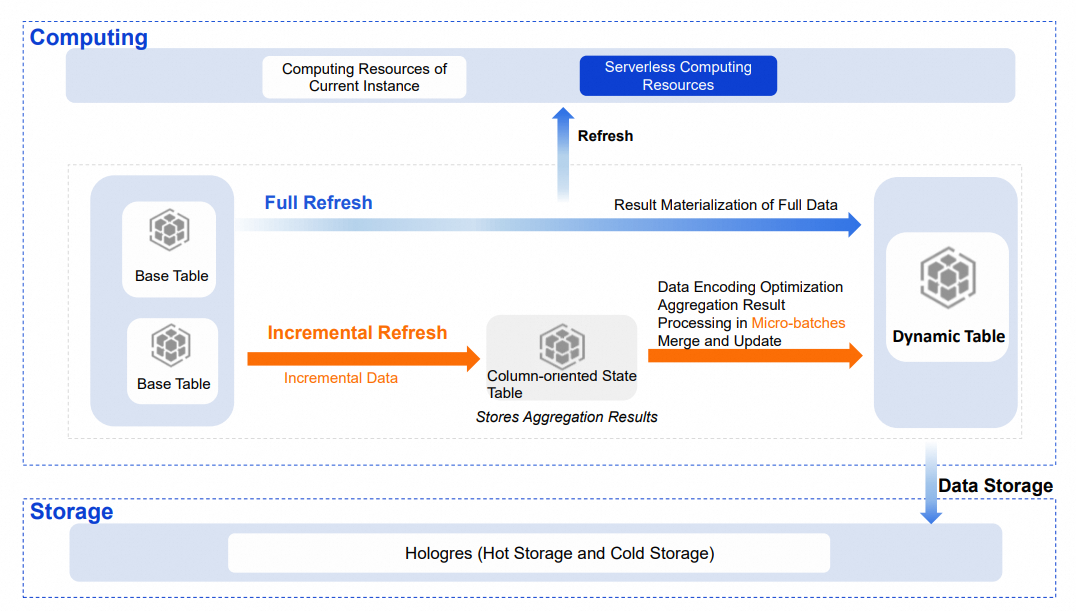
ベーステーブルのデータは、ダイナミックテーブルのクエリで定義されたデータ処理フローに従い、リフレッシュプロセスを通じてダイナミックテーブルに書き込まれます。以下のセクションでは、リフレッシュモード、コンピューティングリソース、データストレージ、テーブルインデックスを取り上げ、ダイナミックテーブルの技術的な仕組みについて説明します。
リフレッシュモード
ダイナミックテーブルは、フルと増分の 2 つのリフレッシュモードをサポートしています。基盤となる技術的な原則は、設定されたリフレッシュモードによって異なります。
フルリフレッシュ
フルリフレッシュは、実行ごとにすべてのデータを再処理し、ベーステーブルから計算された完全な結果でダイナミックテーブルを上書きします。これは原則として INSERT OVERWRITE 操作に似ています。このプロセスは大量の Binlog データを生成し、大幅なストレージオーバーヘッドを引き起こす可能性があります。制限と Binlog を無効にする方法の詳細については、「INSERT OVERWRITE」をご参照ください。
増分リフレッシュ
増分リフレッシュは、実行ごとにベーステーブルから新しいデータのみを読み取ります。中間集計状態と増分データに基づいて最終結果を計算し、ダイナミックテーブルを更新します。フルリフレッシュと比較して、増分リフレッシュは実行ごとのデータ処理量が少ないため、適時性を向上させつつ、コンピューティングリソースの使用量を削減します。
技術的な原則
増分リフレッシュでダイナミックテーブルを作成すると、システムは Stream 方式または Binlog 方式を使用してベーステーブルから増分データを読み取ります。次に、バックグラウンドで列指向の状態テーブルを作成し、クエリの中間集計状態を保存します。DPI エンジンは、この中間状態のエンコーディングとストレージを最適化して、読み取りと更新を高速化します。増分データはメモリ内でマイクロバッチで集計され、状態テーブルとマージされます。最新の集計結果は、BulkLoad メソッドを使用してダイナミックテーブルに書き込まれます。
Stream と Binlog の選択
| 方式 | 原則 | 読み取りパフォーマンス | 注意 |
|---|---|---|---|
| Stream (推奨) | ファイルレベルでデータの変更を検出し、ベーステーブルの増分データを計算します。 | Binlog の 10 倍以上です。 | 使い方がより簡単です。増分変更を別途記録しないため、余分なストレージオーバーヘッドがなく、バイナリログのライフサイクル管理も不要です。ベーステーブルとして行指向テーブルをサポートしていません。 |
| Binlog | バイナリロギングは、ベーステーブルへのデータ操作言語 (DML) の変更を記録し、バックグラウンドでバイナリログとして保存します。システムはバイナリログを読み取ってデータの変更を検出します。 | 低いです。 | 余分なストレージオーバーヘッドが発生します。バイナリログのストレージライフサイクル (TTL) を管理する必要があります。そうしないと、データの変更に伴いストレージ使用量が継続的に増加します。 |
使用上の注意
-
増分リフレッシュでサポートされるベーステーブルには、特定の制限があります。詳細については、「ダイナミックテーブルでサポートされる機能と制限」をご参照ください。
-
増分リフレッシュ用の組み込み状態テーブルは、一部のストレージ領域を占有します。システムは TTL を設定して定期的にデータをクリーンアップします。提供されている関数を使用することで、状態テーブルのストレージサイズを表示できます。詳細については、「状態テーブルの管理」をご参照ください。
リフレッシュモードの選択
以下の基準を使用してリフレッシュモードを選択します。
| 条件 | 推奨モード |
|---|---|
| クエリがサポートされている演算子を使用し、ベーステーブルが行指向ではない | 増分 |
| リフレッシュごとのデータ変更率が高い、またはクエリにサポートされていない演算子が含まれる | フル |
| 初回ロードまたは階層間のデータ整合性の確保 | フル (1 回限り) |
コンピューティングリソース
リフレッシュタスクは、現在のインスタンスのリソースまたはサーバーレスリソースを使用できます。
-
サーバーレスリソース (デフォルト):Hologres V2.1 以降では、新しいダイナミックテーブルはデフォルトでサーバーレスリソースを使用します。複雑なクエリや大量のデータの場合、サーバーレスリソースはリフレッシュの安定性を向上させ、インスタンス内のタスク間のリソースの競合を回避します。単一のリフレッシュタスクのコンピューティングリソースは、個別に調整できます。
-
現在のインスタンスリソース:リフレッシュタスクはインスタンス内の他のタスクとリソースを共有するため、ピーク時にリソースの競合が発生する可能性があります。
データストレージ
ダイナミックテーブルのデータストレージは標準テーブルと同じで、デフォルトでホットストレージモードを使用します。ストレージコストを削減するには、クエリ頻度の低いデータをコールドストレージに移動できます。
テーブルインデックス
ダイナミックテーブルを直接クエリすることは、集計された結果をクエリすることに相当し、クエリのパフォーマンスが大幅に向上します。標準テーブルと同様に、ダイナミックテーブルは行ストアまたは列ストア、Distribution Key、Clustering Key などのテーブルインデックスをサポートします。DPI エンジンは、ダイナミックテーブルのクエリに基づいて適切なインデックスを推測します。追加のインデックスを設定することで、クエリのパフォーマンスをさらに向上させることができます。
マテリアライズドビューとの比較
ダイナミックテーブル vs Hologres リアルタイムマテリアライズドビュー
Hologres は V1.3 でSQL で管理されるマテリアライズドビューを導入しました。ダイナミックテーブルは、これらの機能を大幅に拡張したものです。
| 機能 | Hologres ダイナミックテーブル | Hologres リアルタイムマテリアライズドビュー |
|---|---|---|
| ベーステーブルのタイプ | 内部テーブル、外部テーブル (MaxCompute、Paimon、OSS)、ダイナミックテーブル、ビュー | 単一の内部テーブル |
| ベーステーブルの操作 | 書き込み、更新、削除 | 追記専用の書き込み |
| リフレッシュの原則 | 非同期リフレッシュ (フルまたは増分) | 同期 |
| リフレッシュの適時性 | 分単位または時間単位 | リアルタイム |
| クエリタイプ | 単一テーブル集計、複数テーブル結合、ディメンションテーブル JOIN、複雑な OLAP (ウィンドウ関数、CTE、RB など) 説明
サポートされるクエリタイプはリフレッシュモードによって異なります。詳細については、「ダイナミックテーブルでサポートされる機能と制限」をご参照ください。 |
限定的な演算子サポート (AGG、RB 関数など) |
| クエリモード | ダイナミックテーブルを直接クエリ | マテリアライズドビューを直接クエリ、クエリリライト |
ダイナミックテーブル vs 非同期マテリアライズドビュー
他のプラットフォームでは、OLAP 製品の非同期マテリアライズドビューや Snowflake ダイナミックテーブルなど、ダイナミックテーブルに類似した機能が提供されています。
| 機能 | Hologres ダイナミックテーブル | OLAP 製品の非同期マテリアライズドビュー | Snowflake ダイナミックテーブル |
|---|---|---|---|
| ベーステーブルのタイプ | 内部テーブル、外部テーブル (MaxCompute、Paimon、OSS)、ダイナミックテーブル、ビュー 説明
サポートされるクエリタイプはリフレッシュモードによって異なります。詳細については、「ダイナミックテーブルでサポートされる機能と制限」をご参照ください。 |
内部テーブル、外部テーブル (Hive、Hudi、Iceberg など)、マテリアライズドビュー、ビュー | 内部テーブル、ダイナミックテーブル、ビュー |
| リフレッシュモード | フル、増分 | フル、指定されたパーティションまたはタイムスタンプ範囲によるリフレッシュ | フル、増分 |
| リフレッシュの適時性 | 分単位または時間単位 | 時間単位 | 時間単位または分単位 |
| クエリタイプ | 単一テーブル集計、複数テーブル結合、ディメンションテーブル JOIN、複雑な OLAP (ウィンドウ関数、CTE、RB など) | 単一テーブル集計、複数テーブル結合、ディメンションテーブル JOIN、複雑な OLAP (ウィンドウ関数、CTE など) | 単一テーブル集計、複数テーブル結合、ディメンションテーブル JOIN、複雑な OLAP (ウィンドウ関数、CTE など) |
| クエリモード | ダイナミックテーブルを直接クエリ | マテリアライズドビューを直接クエリ、クエリリライト | ダイナミックテーブルを直接クエリ |
| モニタリング / 運用保守 | DataWorks と HoloWeb の可視化インターフェース、豊富なモニタリングメトリック | 豊富なモニタリングメトリック | 可視化インターフェース |
ユースケース
ダイナミックテーブルはデータ変換とストレージを自動的に完了し、データアクセラレーションとビジネスの適時性向上の両方をサポートします。
ラムダアーキテクチャのアップグレード
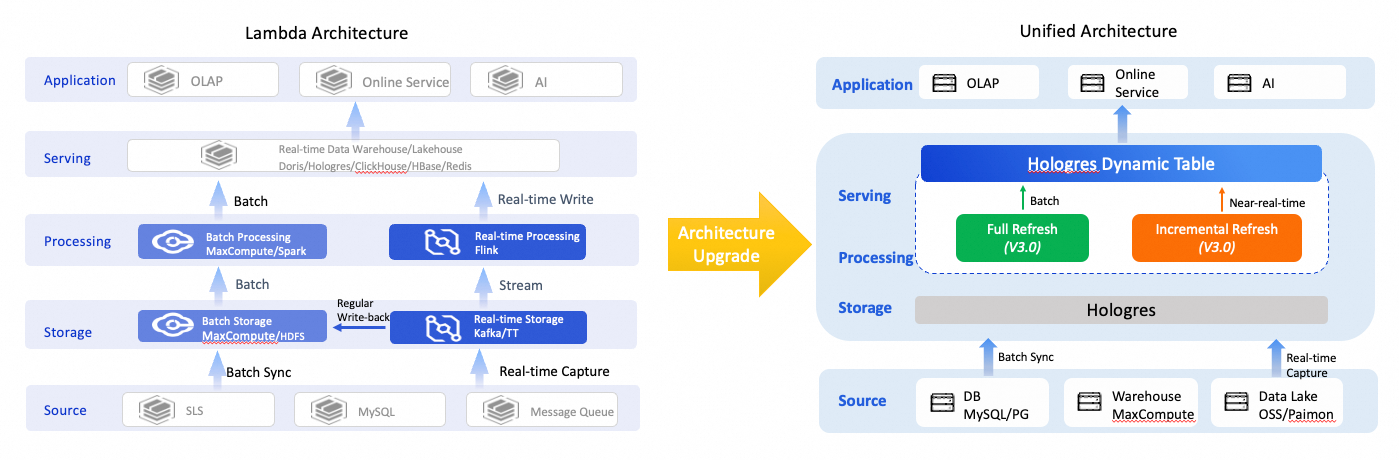
ラムダアーキテクチャは、複数の製品コンポーネントを使用してさまざまな適時性要件を満たしますが、その結果、冗長なアーキテクチャ、一貫性のないデータ定義、メンテナンスの困難化、ストレージの冗長性といった問題が生じます。ダイナミックテーブルは、バッチデータ変換とニアリアルタイム処理をサポートします。OLAP クエリとキー・バリュー (KV) ポイントクエリをサポートする Hologres の統一ストレージと組み合わせることで、単一の製品内で複数のアプリケーションシナリオをカバーし、アーキテクチャを簡素化し、開発の複雑さとストレージコストを削減します。
ニアリアルタイムデータ処理
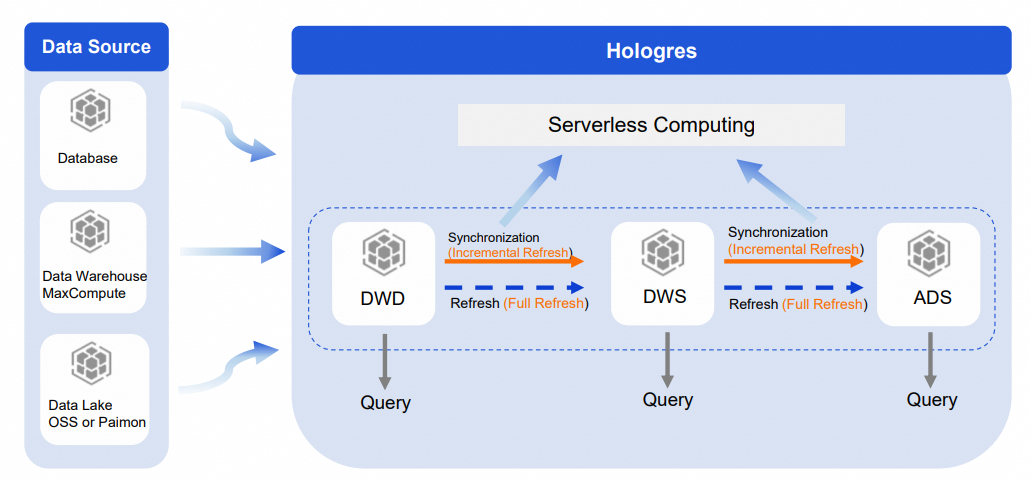
複雑な ETL 処理を必要とする大規模なベーステーブルの場合、データウェアハウス階層化が標準的なアプローチです。ダイナミックテーブルには自動データ処理が組み込まれているため、Hologres での階層化の実装が簡単になります。
Hologres でダイナミックテーブルを使用して DWD → DWS → ADS の各層を構築します。
-
階層間で増分リフレッシュを使用します。これにより、各層で処理されるデータが少なくなり、繰り返し計算が削減され、同期速度が向上します。リフレッシュタスクをサーバーレスコンピューティングに送信することで、適時性と安定性がさらに向上します。
-
階層間のデータ整合性を確保するために、1 回限りのフルリフレッシュを実行します。フルリフレッシュタスクもサーバーレスコンピューティングに送信します。
-
各層は Hologres で直接クエリ可能で、すべてのレベルで可視性と再利用性を備えた明確なデータウェアハウス階層化を提供します。
レイクハウスの高速化
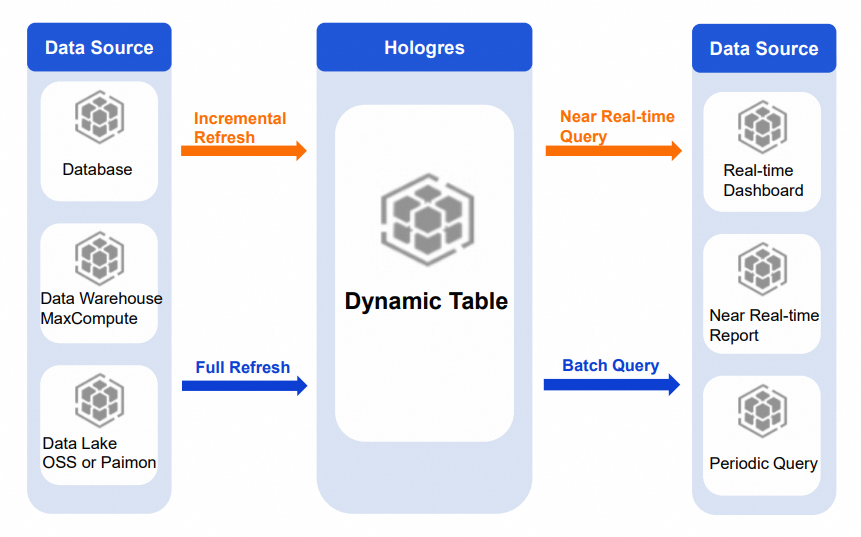
ダイナミックテーブルのベーステーブルは、Hologres テーブル、MaxCompute などのデータウェアハウス、または OSS や Paimon などのデータレイクから取得できます。このデータに対するフルまたは増分リフレッシュは、さまざまな適時性要件を持つ多様なクエリと探索のニーズをサポートします。
-
定期的なレポートクエリ:データ量が少ない、またはクエリが単純な定期的な観測シナリオでは、フルリフレッシュまたは増分リフレッシュを使用します。レイクハウスデータからの集計および分析結果を定期的にダイナミックテーブルにリフレッシュします。アプリケーション層はダイナミックテーブルを直接クエリして事前計算された結果を取得し、レポートクエリを高速化します。
-
リアルタイムのダッシュボードとレポート:より高い適時性の要件があるシナリオでは、増分リフレッシュを使用します。Paimon またはリアルタイムデータからの集計および分析結果をダイナミックテーブルにリフレッシュし、ニアリアルタイム分析を可能にします。
オフラインの定期スケジューリングの置き換え
一般的なオフライン処理シナリオでは、データ量が大きく、計算サイクルが長くなります。一般的なアプローチでは、DWD から DWS、ADS への T+H 処理 (例:30 分ごと) を実行し、さらに精度を確保するために過去数日間のデータを処理する別の T+1 オフラインパイプラインも実行します。これにより、冗長な計算、リソースの無駄、データの重複が発生します。また、スケジュールされたタスクが時間内に完了しない場合、ダウンストリームジョブがブロックされる可能性もあります。
ダイナミックテーブルを使用すると、DWD から DWS、ADS への各層で T+H 増分リフレッシュを使用できます。複数のジョブが単一の増分コンピューティングジョブにマージされます。ダイナミックテーブルはスケジューリングを自動的に処理するため、外部のスケジューリングジョブを維持する必要がなくなります。毎回増分データのみが計算されるため、冗長な計算が排除され、計算が高速化され、タスクのバックログが防止され、コンピューティングリソースの使用量が大幅に削減されます。
