MaxCompute のデータが 200 GB を超え、秒単位のクエリ応答時間が必要な場合は、データを Hologres の内部テーブルにインポートします。外部テーブルを介したデータクエリとは異なり、内部テーブルはインデックスをサポートしているため、クエリパフォーマンスが大幅に向上します。このトピックでは、さまざまなシナリオで SQL を使用して MaxCompute のデータをインポートする方法と、メモリ不足 (OOM) エラーのトラブルシューティング方法について説明します。
前提条件
開始する前に、以下をご確認ください。
インポートするデータを含む MaxCompute テーブルが用意されていること
MaxCompute プロジェクトに接続されている有効な Hologres インスタンスがあること
(任意) MaxComputeとHologres間のデータ型マッピング に精通していること
注意事項
MaxCompute のパーティションと Hologres のパーティションは直接マッピングされません。MaxCompute のパーティションフィールドは、Hologres の通常のフィールドにマッピングされます。MaxCompute のパーティションテーブルから、非パーティションテーブルまたはパーティションテーブルのいずれかの Hologres テーブルにインポートできます。
Hologres は単一レベルのパーティション分割のみをサポートしています。複数レベルのパーティションを持つ MaxCompute テーブルからインポートする場合、1 つのパーティションフィールドのみをマッピングします。残りのパーティションフィールドは、Hologres の通常のフィールドになります。
インポート中に既存のデータを更新または上書きするには、INSERT ON CONFLICT (UPSERT) 構文を使用します。
MaxCompute テーブルのデータが更新された後、Hologres には最大 10 分間のキャッシュ遅延があります。インポートする前に、IMPORT FOREIGN SCHEMA コマンドを実行して外部テーブルのメタデータを更新し、最新のデータを取得します。
MaxCompute のデータを Hologres にインポートする場合、データ統合ではなく SQL を使用します。SQL インポートの方がパフォーマンスが優れています。
MaxComputeの非パーティションテーブルからのデータインポート
ステップ1:ソースデータの準備
既存の MaxCompute テーブルを使用するか、新しいテーブルを作成します。この例では、MaxCompute の [public_data] パブリックデータセットにある customer テーブルを使用します。パブリックデータセットへのアクセスについては、「パブリックデータセットの使用」をご参照ください。
customer テーブルの DDL とサンプルクエリは次のとおりです:
-- MaxCompute パブリックデータセット内のテーブルの DDL
CREATE TABLE IF NOT EXISTS public_data.customer(
  c_customer_sk BIGINT,
  c_customer_id STRING,
  c_current_cdemo_sk BIGINT,
  c_current_hdemo_sk BIGINT,
  c_current_addr_sk BIGINT,
  c_first_shipto_date_sk BIGINT,
  c_first_sales_date_sk BIGINT,
  c_salutation STRING,
  c_first_name STRING,
  c_last_name STRING,
  c_preferred_cust_flag STRING,
  c_birth_day BIGINT,
  c_birth_month BIGINT,
  c_birth_year BIGINT,
  c_birth_country STRING,
  c_login STRING,
  c_email_address STRING,
  c_last_review_date STRING,
  useless STRING);

-- テーブルをクエリしてデータを確認します
SELECT * FROM public_data.customer;
次の図は、データのサンプルを示しています。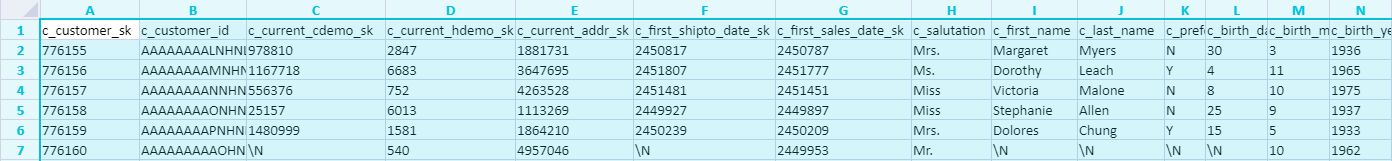
ステップ2:Hologresでの外部テーブルの作成
MaxCompute のソーステーブルをマッピングする外部テーブルを作成します。
CREATE FOREIGN TABLE foreign_customer (
    "c_customer_sk" int8,
    "c_customer_id" text,
    "c_current_cdemo_sk" int8,
    "c_current_hdemo_sk" int8,
    "c_current_addr_sk" int8,
    "c_first_shipto_date_sk" int8,
    "c_first_sales_date_sk" int8,
    "c_salutation" text,
    "c_first_name" text,
    "c_last_name" text,
    "c_preferred_cust_flag" text,
    "c_birth_day" int8,
    "c_birth_month" int8,
    "c_birth_year" int8,
    "c_birth_country" text,
    "c_login" text,
    "c_email_address" text,
    "c_last_review_date" text,
    "useless" text
)
SERVER odps_server
OPTIONS (project_name 'public_data', table_name 'customer');
パラメーター | 説明 |
| 外部テーブルサーバー。Hologres が提供する組み込みの |
| ソーステーブルが存在する MaxCompute プロジェクトの名前。 |
| インポートする MaxCompute テーブルの名前。 |
外部テーブルのフィールドのデータ型は、MaxCompute テーブルのデータ型と一致する必要があります。データ型のマッピングについては、「MaxComputeとHologres間のデータ型マッピング」をご参照ください。
ステップ3:Hologresでの内部テーブルの作成
インポートしたデータを格納する内部テーブルを作成します。クエリのパフォーマンスを最適化するために、適切なインデックスを定義します。テーブルのプロパティの詳細については、「CREATE TABLE」をご参照ください。
-- 列指向の内部テーブルを作成します
BEGIN;
CREATE TABLE public.holo_customer (
 "c_customer_sk" int8,
 "c_customer_id" text,
 "c_current_cdemo_sk" int8,
 "c_current_hdemo_sk" int8,
 "c_current_addr_sk" int8,
 "c_first_shipto_date_sk" int8,
 "c_first_sales_date_sk" int8,
 "c_salutation" text,
 "c_first_name" text,
 "c_last_name" text,
 "c_preferred_cust_flag" text,
 "c_birth_day" int8,
 "c_birth_month" int8,
 "c_birth_year" int8,
 "c_birth_country" text,
 "c_login" text,
 "c_email_address" text,
 "c_last_review_date" text,
 "useless" text
);
CALL SET_TABLE_PROPERTY('public.holo_customer', 'orientation', 'column');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'bitmap_columns', 'c_customer_id,c_salutation,c_first_name,c_last_name,c_preferred_cust_flag,c_birth_country,c_login,c_email_address,c_last_review_date,useless');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'dictionary_encoding_columns', 'c_customer_id:auto,c_salutation:auto,c_first_name:auto,c_last_name:auto,c_preferred_cust_flag:auto,c_birth_country:auto,c_login:auto,c_email_address:auto,c_last_review_date:auto,useless:auto');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'time_to_live_in_seconds', '3153600000');
CALL SET_TABLE_PROPERTY('public.holo_customer', 'storage_format', 'segment');
COMMIT;
ステップ4:INSERT文の実行
INSERT INTO ... SELECT を使用して、外部テーブルから内部テーブルにデータをコピーします。すべてのフィールドまたは一部のフィールドをインポートできます。
Hologres V2.1.17 以降、大規模なオフラインインポート、大規模な抽出、変換、ロード (ETL) ジョブ、および大量の外部テーブルクエリにサーバーレスコンピューティングを使用できます。サーバーレスコンピューティングは、インスタンスリソースの代わりに専用のサーバーレスリソースを使用するため、安定性が向上し、OOM エラーが削減されます。実行したタスクに対してのみ料金が発生します。詳細については、「サーバーレスコンピューティング」および「サーバーレスコンピューティングのユーザーガイド」をご参照ください。
-- (任意) 大規模なインポートおよび ETL ジョブにサーバーレスコンピューティングを使用します
SET hg_computing_resource = 'serverless';

-- 一部のフィールドをインポートします
INSERT INTO holo_customer (c_customer_sk, c_customer_id, c_email_address, c_last_review_date, useless)
SELECT
    c_customer_sk,
    c_customer_id,
    c_email_address,
    c_last_review_date,
    useless
FROM foreign_customer;

-- すべてのフィールドをインポートします
INSERT INTO holo_customer
SELECT * FROM foreign_customer;

-- 後続の SQL 文がサーバーレスリソースを使用しないように、リソース設定をリセットします
RESET hg_computing_resource;
ステップ5:インポートされたデータのクエリ
インポートが完了したら、内部テーブルをクエリしてデータを確認します。
SELECT * FROM holo_customer;MaxComputeのパーティションテーブルからのデータインポート
詳細な手順については、「MaxComputeのパーティションテーブルからのデータインポート」をご参照ください。
INSERT OVERWRITEのベストプラクティス
INSERT OVERWRITE のパターンと推奨事項については、「INSERT OVERWRITE」をご参照ください。
可視化ツールまたはスケジュールされたジョブによるデータ同期
1 回限りの大規模なインポートや定期的なデータ同期には、手動で SQL を記述する代わりに HoloWeb または DataWorks を使用します。
ワンクリック同期のためのHoloWebの使用
HoloWeb は、インポート SQL を生成して実行するためのガイド付き UI を提供します。
[HoloWeb] ページを開きます。アクセス手順については、「HoloWebへの接続とクエリの実行」をご参照ください。
上部メニューで、[Metadata Management] > [MaxCompute Query Acceleration] を選択し、[Import MaxCompute Data] をクリックします。
[Create MaxCompute Data Import Task] ページでパラメーターを設定します。
[SQL Script] には、設定から自動的に生成された SQL 文が表示されます。[SQL Script] で直接文を編集することはできません。カスタマイズするには、文をコピーし、手動で変更して SQL として実行します。
カテゴリ
パラメーター
説明
インスタンスの選択
インスタンス名
ログインしている Hologres インスタンスの名前。
MaxComputeソーステーブル
プロジェクト名
MaxCompute プロジェクトの名前。
スキーマ名
MaxCompute のスキーマ名。2層モデルのプロジェクトでは非表示になります。3層モデルのプロジェクトでは、承認されたスキーマから選択します。
テーブル名
インポートする MaxCompute テーブル。プレフィックスベースのあいまい検索をサポートしています。
Hologresターゲットテーブル
データベース名
内部テーブルが作成される Hologres データベース。
スキーマ名
Hologres のスキーマ。デフォルトは [public] です。
テーブル名
新しい内部テーブルの名前。デフォルトは MaxCompute のテーブル名ですが、名前を変更できます。
ターゲットテーブルの説明
新しい内部テーブルの説明 (任意)。
パラメーター設定
GUCパラメーター
適用する GUC (Grand Unified Configuration) パラメーター。詳細については、「GUCパラメーター」をご参照ください。
インポート設定
フィールド
インポートするフィールド。すべてまたは一部を選択します。
パーティション設定
パーティションフィールド
パーティションフィールドを選択します。Hologres は単一レベルのパーティション分割のみをサポートしています。複数レベルの MaxCompute パーティションの場合、1 つのパーティションフィールドを設定し、残りは通常のフィールドにマッピングされます。
データタイムスタンプ
日付でパーティション分割された MaxCompute テーブルの場合、インポートするパーティションの日付を選択します。
インデックス設定
ストレージモード
[列指向ストレージ] (デフォルト) :複雑なクエリに最適化されています。[行指向ストレージ]:主キーのポイントクエリとスキャンに最適化されています。[行列表ストレージ]:主キー以外のポイントクエリを含む、すべての行指向および列指向のシナリオをサポートします。
テーブルデータのライフサイクル
データ保持期間。デフォルトは [永続] です。指定された期間内に変更されなかったデータは、有効期限が切れると自動的に削除されます。
Binlog
Binlog を有効にするかどうか。詳細については、「Hologres Binlogのサブスクライブ」をご参照ください。
Binlogライフサイクル
Binlog の TTL (Time To Live)。デフォルトは30日 (2,592,000秒) です。
ディストリビューション列
Hologres はこれらの列に基づいてデータをシャードに分散します。同じ値を持つ行は同じシャードに配置されます。ディストリビューション列をフィルター条件として使用すると、クエリ効率が向上します。
セグメント列
セグメントキーとして使用される列。セグメント列を含むクエリは、データストレージの位置を迅速に特定できます。
クラスタリング列
クラスタリングキーとして使用される列。クラスタリングインデックスは、これらの列に対する範囲クエリおよびフィルタークエリを高速化します。
辞書エンコーディング列
Hologres が辞書マッピングを構築する列。辞書エンコーディングは、文字列比較を数値比較に変換し、GROUP BY およびフィルタークエリを高速化します。すべての [text] 型の列は、デフォルトで辞書エンコーディング列として設定されます。
ビットマップ列
Hologres がビットマップインデックスを構築する列。ビットマップ列は、指定された条件に基づいてデータを迅速にフィルタリングします。すべての [text] 型の列は、デフォルトでビットマップ列として設定されます。
[Submit] をクリックします。インポートが完了したら、内部テーブルをクエリしてデータを確認します。
DataWorksを使用した定期的なスケジューリング
HoloWeb のワンクリック同期は、定期的なスケジューリングをサポートしていません。大規模な履歴データのインポートや定期的な同期には、DataWorks の DataStudio を使用します。詳細については、「DataWorksを使用したMaxComputeデータの定期的なインポートに関するベストプラクティス」をご参照ください。
OOMエラーのトラブルシューティング
症状:インポート中に OOM エラーが発生し、Query executor exceeded total memory limitation xxxxx: yyyy bytes used というメッセージが表示されます。
エラーが解決するまで、次の手順を順番に実行してください。
ステップ1:テーブル統計の更新
統計情報が古いか欠落していると、クエリオプティマイザが最適でない結合順序を選択し、過剰なメモリ使用につながる可能性があります。これは、インポートクエリにサブクエリが含まれている場合に特に一般的です。
インポートに関連するすべての内部テーブルと外部テーブルに対して ANALYZE コマンドを実行します。
ANALYZE foreign_customer;
ANALYZE holo_customer;
これにより、統計メタデータが更新され、クエリオプティマイザがより最適な実行計画を生成するのに役立ちます。
ステップ2:バッチ読み取りサイズの削減
多くの列を持つ幅の広いテーブルは、読み取りバッチあたりのデータ量が大きくなり、メモリ制限を超える可能性があります。
INSERT 文の前に hg_experimental_query_batch_size をより小さい値に設定します (デフォルトは 8192 です)。
SET hg_experimental_query_batch_size = 1024;
INSERT INTO holo_table SELECT * FROM mc_table;
ステップ3:インポート同時実行数の削減 (Hologres V1.1未満)
高いインポート同時実行数はより多くの CPU とメモリを消費し、他の内部テーブルのクエリに影響を与える可能性があります。
hg_experimental_foreign_table_executor_max_dop をより小さい値に設定します (デフォルトはインスタンスのコア数です)。このパラメーターは、外部テーブルで実行されるすべてのジョブに有効です。
SET hg_experimental_foreign_table_executor_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;
ステップ4:DML同時実行数の削減 (Hologres V1.1以降)
Hologres V1.1 以降では、hg_foreign_table_executor_dml_max_dop を使用して、インポートを含む DML 文の同時実行数を制御します (デフォルトは 32 です)。これをより小さい値に設定すると、特にデータインポートおよびエクスポートのシナリオで DML 文の同時実行数が減少し、DML 文が過剰なリソースを消費するのを防ぎます。
SET hg_foreign_table_executor_dml_max_dop = 8;
INSERT INTO holo_table SELECT * FROM mc_table;