テーブルに対して GROUP BY または JOIN 操作を頻繁に実行する場合や、データスキューを防止したい場合は、テーブル作成時に分散キーを設定できます。適切な分散キーを設定すると、すべてのコンピューティングノードにデータが均等に分散され、計算およびクエリのパフォーマンスが大幅に向上します。このトピックでは、Hologres のテーブルに分散キーを設定する方法について説明します。
概要
Hologres では、テーブルのデータ分散戦略を distribution_key テーブルプロパティで指定します。システムは、同じ分散キー値を持つレコードが同一のシャードに割り当てられることを保証します。このプロパティは、次の構文でテーブル作成時に設定できます。
-- Hologres V2.1 以降でサポートされている構文
CREATE TABLE <table_name> (...) WITH (distribution_key = '[<columnName>[,...]]');
-- すべてのバージョンでサポートされている構文
BEGIN;
CREATE TABLE <table_name> (...);
call set_table_property('<table_name>', 'distribution_key', '[<columnName>[,...]]');
COMMIT;
次の表にパラメーターを示します。
|
パラメーター |
説明 |
|
table_name |
分散キーを設定するテーブルの名前。 |
|
columnName |
分散キーとして使用する列の名前。 |
分散キーを適切に設定すると、次のメリットがあります。
-
計算パフォーマンスの向上
異なるシャード間で計算を並列実行できるため、全体の計算パフォーマンスが向上します。
-
秒間クエリ数 (QPS) の向上
分散キーをフィルター条件として使用すると、Hologres は該当するシャードのみをスキャンできます。そうでない場合、Hologres はすべてのシャードをスキャンする必要があり、QPS が低下します。
-
結合パフォーマンスの大幅な向上
2 つのテーブルが同じテーブルグループに属し、かつ結合列がそれぞれの分散キーでもある場合、Hologres は一致する結合キーを持つデータが同じシャードに配置されることを保証します。これによりローカル結合が可能になり、各ノードはノード間でデータを移動せずに自身のデータを結合できるため、実行効率が大幅に向上します。
利用ガイドライン
分散キーを設定する際は、次の原則に従ってください。
-
分布キーには、カーディナリティが高く、データ分布が均等なカラムを選択してください。データ分布が不均等であると、データスキューやワークロードの不均衡が発生し、クエリ効率が低下します。データスキューのトラブルシューティングについては、「ワークロードスキューの検出と処理」をご参照ください。
-
GROUP BY句で頻繁に使用される列を分散キーとして選択してください。 -
結合操作では、ローカル結合を有効にしてデータシャッフルを回避するために、結合列を分散キーとして設定してください。結合するテーブルは同じテーブルグループに属している必要があります。
-
分散キーは 2 列以内で設定することを推奨します。複数列キーを使用する場合、すべてのキー列に対するフィルターを含まないクエリではデータシャッフルが発生する可能性があります。常に同じ値を持つ 2 列など、冗長な列を含む複合分散キーは使用しないでください。基となるデータのカーディナリティが低い場合、データスキューの原因になります。
-
分散キーには単一列または複数列を設定できます。単一列を使用する場合、コマンドに余分なスペースを入れないでください。複数列を使用する場合、列名はカンマ (,) で区切り、余分なスペースを入れないでください。複数列の分散キーにおける列の順序は、データレイアウトやクエリパフォーマンスに影響しません。
-
テーブルにプライマリキー (PK) がある場合、分散キーは PK、または PK 列のサブセットである必要があります。分散キーは空にできないため、少なくとも 1 つの列を指定する必要があります。この要件により、単一レコードのすべてのデータが 1 つのシャードのみに属することが保証されます。分散キーを明示的に指定しない場合、Hologres は PK をデフォルトの分散キーとして使用します。
制限事項
-
分散キーはテーブル作成時に設定する必要があります。既存テーブルの分散キーを変更するには、テーブルを再作成してデータをインポートし直す必要があります。
-
分散キー列の値は更新できません。これらの値を変更するには、テーブルを再作成する必要があります。
-
次のデータ型の列は分散キーとして設定できません:FLOAT、DOUBLE、NUMERIC、ARRAY、JSON、またはその他の複雑なデータ型。
-
プライマリキーのないテーブルでは、分散キーを空にでき、その場合は全シャードにランダムにデータが分散されます。ただし、Hologres V1.3.28 以降では、明示的に空の分散キーを設定することは禁止されています。次の構文は、禁止される例です。
-- この構文は Hologres V1.3.28 以降では使用できません。 CALL SET_TABLE_PROPERTY('<tablename>', 'distribution_key', ''); -
分散キー列に
null値が含まれる場合、Hologres はそれらを空文字列""として扱います。つまり、すべての null 値は同じキーにマップされ、同じシャードに分散されます。
仕組み
分散キーは、テーブルのデータ分散戦略を指定します。その動作は、ユースケースや設定によって異なります。
分散キーの設定
テーブルにディストリビューションキーを設定すると、Hologres はそのキーに基づいてデータを異なるシャードに割り当てます。Hologres は Hash(distribution_key) % shard_count アルゴリズムを使用して、各レコードのターゲットシャードを決定します。システムにより、同じディストリビューションキーの値を持つレコードが同じシャードに配置されることが保証されます。ディストリビューションキーの設定方法の例を次に示します。
-
Hologres V2.1 以降でサポートされている構文:
-- 列 'a' を分散キーとして設定します。 システムは列 'a' の値をハッシュ化し、剰余演算を適用します (hash(a) % shard_count = shard_id)。 同じハッシュ値を持つレコードは同じシャードに分散されます。 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- 列 'a' と 'b' を分散キーとして設定します。 システムは両方の列の値をハッシュ化し、剰余演算を適用します (hash(a,b) % shard_count = shard_id)。 同じハッシュ値を持つレコードは同じシャードに分散されます。 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -
すべてのバージョンでサポートされている構文:
-- 列 'a' を分散キーとして設定します。 システムは列 'a' の値をハッシュ化し、剰余演算を適用します (hash(a) % shard_count = shard_id)。 同じハッシュ値を持つレコードは同じシャードに分散されます。
begin;
create table tbl (
a int not null,
b text not null
);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- 列 'a' と 'b' を分散キーとして設定します。 システムは両方の列の値をハッシュ化し、剰余演算を適用します (hash(a,b) % shard_count = shard_id)。 同じハッシュ値を持つレコードは同じシャードに分散されます。
begin;
create table tbl (
  a int not null,
  b text not null
);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
このデータ分散を次の図に示します。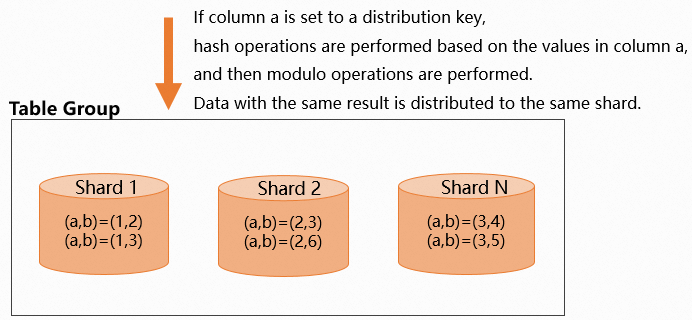 distribution key を設定する際は、データを均等に分散する列を選択してください。Hologres では、シャード数は worker ノード数に関連しています。詳細については、「基本概念」をご参照ください。データ分散が不均一になるキーを選択すると、データは少数のシャードに集中します。これにより、少数の worker ノードがほとんどの計算処理を担うことになり、ロングテール効果が発生してクエリ効率が低下する可能性があります。データスキューを特定して解決する方法については、「ワークロードスキューの検出と処理」をご参照ください。
分散キーを省略する場合
分散キーを設定しない場合、データはシャード全体にランダムに分散されます。同じ値のレコードは同じシャードに配置される場合もあれば、異なるシャードに配置される場合もあります。次の例は、分散キーを設定せずにテーブルを作成する方法を示します。
-- 分散キーを設定しません。
begin;
create table tbl (
a int not null,
b text not null
);
commit;
次の図は、このランダムなデータ分散を示しています。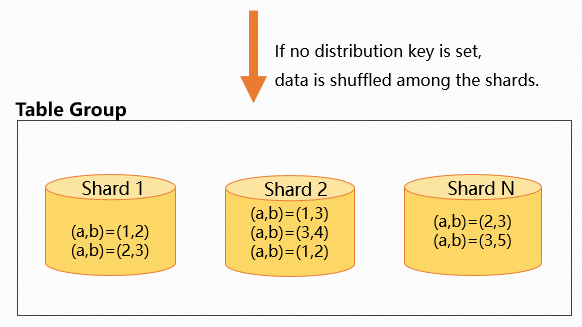
GROUP BY 集約向けの分散キー
分散キーを設定すると、同じキー値を持つレコードは同じシャードに配置されます。GROUP BY 集約クエリでは、システムはグルーピングキーに基づいてデータを再配布します。GROUP BY 句で頻繁に使用される列を分散キーに設定すると、データが各シャード上にあらかじめ同一配置されている状態になります。これにより、シャード間のデータ再配布が減り、クエリパフォーマンスが向上します。次の例は、その方法を示します。
-
Hologres V2.1 以降でサポートされている構文:
CREATE TABLE agg_tbl ( a int NOT NULL, b int NOT NULL ) WITH ( distribution_key = 'a' ); -- クエリ例:列 a による集約 select a,sum(b) from agg_tbl group by a; -
すべてのバージョンでサポートされている構文:
begin;
create table agg_tbl (
a int not null,
b int not null
);
call set_table_property('agg_tbl', 'distribution_key', 'a');
commit;
-- クエリ例:列 a による集約
select a,sum(b) from agg_tbl group by a;
EXPLAIN コマンドを実行すると、再配布 演算子を含まない実行計画が表示されます。テーブルの分散キー (a) が GROUP BY 列と一致しているため、Hologres は各シャード内で直接集約を実行でき、データの再配布を回避できます。
2 テーブル結合向けの分散キー
-
結合列を分散キーとして設定する
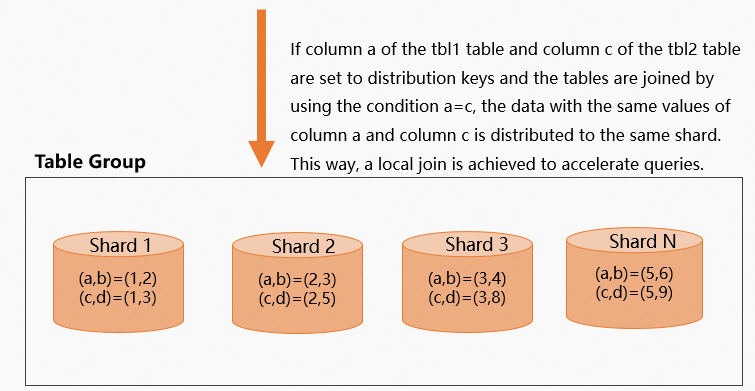
2 テーブル結合のシナリオでは、両テーブルの結合列をそれぞれの分散キーとして設定すると、Hologres は同じ結合キー値を持つデータが同じシャードに配置されることを保証します。これによりローカル結合が可能になり、クエリ実行が高速化されます。次の例に示します。
-
テーブル作成用 DDL:
-
Hologres V2.1 以降でサポートされている構文:
-- tbl1 のデータは列 'a' で、tbl2 のデータは列 'c' で分散されます。 tbl1 と tbl2 を a=c で結合すると、対応するデータが同じシャードに配置されるため、ローカル結合が有効になり、クエリパフォーマンスが向上します。 BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; -
すべてのバージョンでサポートされている構文:
-- tbl1 のデータは列 'a' で、tbl2 のデータは列 'c' で分散されます。 tbl1 と tbl2 を a=c で結合すると、対応するデータが同じシャードに配置されるため、ローカル結合が有効になり、クエリパフォーマンスが向上します。
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
-
-
クエリ文:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
次の図は、データ分散を示しています。
 実行計画 (EXPLAIN SQL) を確認すると、
再配布演算子が含まれていないことが分かり、データの再配布が発生していないことを確認できます。QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl1.a = tbl2.c) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1000 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) Optimizer: HQO version 1.3.0 -
-
結合列の両方が分散キーとして設定されていない場合
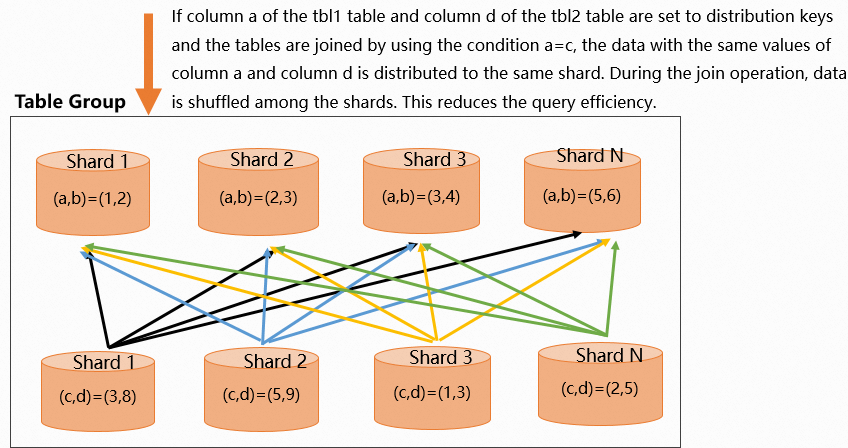
2 つのテーブルを結合する場合、結合列が両方とも分散キーとして設定されていないと、Hologres はクエリ中にシャード間でデータをシャッフルします。 オプティマイザは、2 つのテーブルのサイズに基づいて、シャッフルを実行するかブロードキャストを実行するかを決定します。 次の例では、
tbl1の分散キーは列aで、tbl2の分散キーは列dです。 結合条件はa=cです。 列cはtbl2の分散キーではないため、そのデータをすべてのシャードでシャッフルする必要があり、これによりクエリパフォーマンスが低下します。-
テーブル作成用 DDL:
-
Hologres V2.1 以降でサポートされている構文:
BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'd' ); COMMIT; -
すべてのバージョンでサポートされている構文:
begin;
create table tbl1(
a int not null,
b text not null
);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(
c int not null,
d text not null
);
call set_table_property('tbl2', 'distribution_key', 'd');
commit;
-
-
クエリ文:
select * from tbl1 join tbl2 on tbl1.a=tbl2.c;
次の図は、データ分散を示しています。
 実行計画には
再配布演算子が含まれており、データがシャードをまたいで再シャッフルされていることを示しています。これは、分散キーの設定が最適ではなく、余分なデータ移動によりパフォーマンスが低下していることを意味します。QUERY PLAN Gather (cost=0.00..10.27 rows=1000 width=24) -> Hash Join (cost=0.00..10.21 rows=1000 width=24) Hash Cond: (tbl2.c = tbl1.a) -> Redistribution (cost=0.00..5.10 rows=1000 width=12) Hash Key: tbl2.c -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1000 width=12) -> Decode (cost=0.00..5.10 rows=1000 width=12) -> Seq Scan on tbl2 (cost=0.00..5.00 rows=1000 width=12) -> Hash (cost=5.10..5.10 rows=1 width=12) -> Exchange (Gather Exchange) (cost=0.00..5.10 rows=1 width=12) -> Decode (cost=0.00..5.10 rows=1 width=12) -> Seq Scan on tbl1 (cost=0.00..5.00 rows=1 width=12) Optimizer: HQO version 1.3.0 -
複数テーブル結合向けの分散キー
複数テーブル結合はより複雑です。次の一般原則に従ってください。
-
すべてのテーブルが同じ列で結合される場合は、それらの結合列を各テーブルの分散キーとして設定してください。
-
テーブルが異なる列で結合される場合は、最も大きいテーブル同士の結合を優先してください。大きいテーブルの結合列を分散キーとして設定してください。
次の例では 3 テーブル結合を使用してこれらのケースを示します。同様のロジックは、4 テーブル以上の結合にも適用できます。
-
3 つのテーブルが同じ結合列を持つ場合
3 つのテーブルが同じ列で結合される場合、シナリオは単純です。共通の結合列を 3 つのテーブルすべての分散キーとして設定することで、ローカル結合を有効にできます。
-
Hologres V2.1 以降でサポートされている構文:
BEGIN; CREATE TABLE join_tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE join_tbl3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'a' ); COMMIT; -- 3 テーブル結合クエリ SELECT * FROM join_tbl1 INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a; -
すべてのバージョンでサポートされている構文:
begin;
create table join_tbl1(
a int not null,
b text not null
);
call set_table_property('join_tbl1', 'distribution_key', 'a');
create table join_tbl2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl2', 'distribution_key', 'a');
create table join_tbl3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl3', 'distribution_key', 'a');
commit;
-- 3 テーブル結合クエリ
SELECT * FROM join_tbl1
INNER JOIN join_tbl2 ON join_tbl2.a = join_tbl1.a
INNER JOIN join_tbl3 ON join_tbl2.a = join_tbl3.a;
実行計画 (EXPLAIN SQL) では、次のことが分かります。
-
再配布演算子がありません。これは、データの再シャッフルが行われず、ローカル結合が実行されたことを示します。 -
exchange演算子は、実行ステージ間またはノード間でデータを移動します。この処理により、該当するシャードのデータのみが処理されるようになり、クエリ効率が向上します。
QUERY PLAN Gather (cost=0.00..16.44 rows=10000 width=36) -> Hash Join (cost=0.00..15.57 rows=10000 width=36) Hash Cond: ((join_tbl2.a = join_tbl3.a) AND (join_tbl1.a = join_tbl3.a)) -> Hash Join (cost=0.00..10.31 rows=10000 width=20) Hash Cond: (join_tbl2.a = join_tbl1.a) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=12) -> Decode (cost=0.00..5.11 rows=10000 width=12) -> Seq Scan on join_tbl2 (cost=0.00..5.00 rows=10000 width=12) -> Hash (cost=5.11..5.11 rows=10000 width=8) -> Exchange (Gather Exchange) (cost=0.00..5.11 rows=10000 width=8) -> Decode (cost=0.00..5.11 rows=10000 width=8) -> Seq Scan on join_tbl1 (cost=0.00..5.00 rows=10000 width=8) -> Hash (cost=5.12..5.12 rows=10000 width=16) -> Exchange (Gather Exchange) (cost=0.00..5.12 rows=10000 width=16) -> Decode (cost=0.00..5.12 rows=10000 width=16) -> Seq Scan on join_tbl3 (cost=0.00..5.00 rows=10000 width=16) Optimizer: HQO version 1.3.0 -
-
3 つのテーブルの結合列が異なる場合
実運用では、複数テーブル結合における結合列が異なる場合があります。この場合は、次の原則を使用して分散キーを設定してください。
-
中核となる最適化原則は、最も大きいテーブル同士の結合を優先することです。大きいテーブルの結合列を分散キーとして設定してください。小さいテーブルはデータ量が少ないため、分散戦略の優先度は低くなります。
-
テーブルのデータ量がほぼ同じ場合は、
GROUP BY句で最も頻繁に使用される結合列を分散キーに設定してください。
次の例では、3 つのテーブルが結合されますが、結合列は異なります。最適な戦略は、最大テーブルの結合列を分散キーとして選択することです。
join_tbl_1テーブルには 1,000 万行が含まれているのに対し、join_tbl_2とjoin_tbl_3にはそれぞれ 100 万行が含まれています。したがって、join_tbl_1が主な最適化対象となります。-
Hologres V2.1 以降でサポートされている構文:
BEGIN; -- join_tbl_1 は 1,000 万行を含みます。 CREATE TABLE join_tbl_1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_2 は 100 万行を含みます。 CREATE TABLE join_tbl_2 ( a int NOT NULL, d text NOT NULL, e text NOT NULL ) WITH ( distribution_key = 'a' ); -- join_tbl_3 は 100 万行を含みます。 CREATE TABLE join_tbl_3 ( a int NOT NULL, e text NOT NULL, f text NOT NULL, g text NOT NULL ) WITH ( distribution_key = 'g' ); COMMIT; -- 結合キーが異なる場合は、最大テーブルの結合キーを分散キーとして選択します。 SELECT * FROM join_tbl_1 INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f; -
すべてのバージョンでサポートされている構文:
begin;
-- join_tbl_1 は 1,000 万行を含みます。
create table join_tbl_1(
a int not null,
b text not null
);
call set_table_property('join_tbl_1', 'distribution_key', 'a');
-- join_tbl_2 は 100 万行を含みます。
create table join_tbl_2(
a int not null,
d text not null,
e text not null
);
call set_table_property('join_tbl_2', 'distribution_key', 'a');
-- join_tbl_3 は 100 万行を含みます。
create table join_tbl_3(
a int not null,
e text not null,
f text not null,
g text not null
);
call set_table_property('join_tbl_3', 'distribution_key', 'g');
commit;
-- 結合キーが異なる場合は、最大テーブルの結合キーを分散キーとして選択します。
SELECT * FROM join_tbl_1
INNER JOIN join_tbl_2 ON join_tbl_2.a = join_tbl_1.a
INNER JOIN join_tbl_3 ON join_tbl_2.d = join_tbl_3.f;
実行計画 (EXPLAIN SQL) では、次のことが分かります。
-
join_tbl_2とjoin_tbl_3の間の結合にredistribution演算子が表示されます。join_tbl_3は小さいテーブルであり、その結合列が分布キーと一致しないため、Hologres はそのデータを再配布します。 -
再配布演算子は、join_tbl_1とjoin_tbl_2の結合には表示されません。両テーブルが共通の結合列を分散キーとして使用しているため、この結合ではデータの再配布が不要です。
QUERY PLAN Gather (cost=0.00..183.90 rows=1000000 width=49) -> Hash Join (cost=0.00..64.87 rows=1000000 width=49) Hash Cond: (join_tbl_2.d = join_tbl_3.f) -> Redistribution (cost=0.00..40.22 rows=1000000 width=27) Hash Key: join_tbl_2.d -> Hash Join (cost=0.00..35.99 rows=1000000 width=27) Hash Cond: (join_tbl_1.a = join_tbl_2.a) -> Exchange (Gather Exchange) (cost=0.00..18.45 rows=10000000 width=11) -> Decode (cost=0.00..18.08 rows=10000000 width=11) -> Seq Scan on join_tbl_1 (cost=0.00..7.75 rows=10000000 width=11) -> Hash (cost=6.93..6.93 rows=1000000 width=16) -> Exchange (Gather Exchange) (cost=0.00..6.93 rows=1000000 width=16) -> Decode (cost=0.00..6.88 rows=1000000 width=16) -> Seq Scan on join_tbl_2 (cost=0.00..5.29 rows=1000000 width=16) -> Hash (cost=10.97..10.97 rows=1000000 width=22) -> Redistribution (cost=0.00..10.97 rows=1000000 width=22) Hash Key: join_tbl_3.f -> Exchange (Gather Exchange) (cost=0.00..7.53 rows=1000000 width=22) -> Decode (cost=0.00..7.45 rows=1000000 width=22) -> Seq Scan on join_tbl_3 (cost=0.00..5.31 rows=1000000 width=22) Optimizer: HQO version 1.3.0 -
例
-
Hologres V2.1 以降でサポートされている構文:
-- 単一列の分散キーを設定します。 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); -- 複数列の分散キーを設定します。 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a,b' ); -- 結合シナリオで結合キーを分散キーとして設定します。 BEGIN; CREATE TABLE tbl1 ( a int NOT NULL, b text NOT NULL ) WITH ( distribution_key = 'a' ); CREATE TABLE tbl2 ( c int NOT NULL, d text NOT NULL ) WITH ( distribution_key = 'c' ); COMMIT; SELECT b, count(*) FROM tbl1 JOIN tbl2 ON tbl1.a = tbl2.c GROUP BY b; -
すべてのバージョンでサポートされている構文:
-- 単一列の分散キーを設定します。
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a');
commit;
-- 複数列の分散キーを設定します。
begin;
create table tbl (a int not null, b text not null);
call set_table_property('tbl', 'distribution_key', 'a,b');
commit;
-- 結合シナリオで結合キーを分散キーとして設定します。
begin;
create table tbl1(a int not null, b text not null);
call set_table_property('tbl1', 'distribution_key', 'a');
create table tbl2(c int not null, d text not null);
call set_table_property('tbl2', 'distribution_key', 'c');
commit;
select b, count(*) from tbl1 join tbl2 on tbl1.a = tbl2.c group by b;
関連ドキュメント
-
ビジネスシナリオに応じたテーブルプロパティの設定については、「シナリオベースのテーブル設計ガイド」をご参照ください。
-
Hologres 内部テーブルのクエリパフォーマンス最適化に関するベストプラクティスの詳細については、「クエリパフォーマンスの最適化」をご参照ください。
-
Hologres 内部テーブルに関連する DDL ステートメントについては、以下をご参照ください。