JSONB データのクエリパフォーマンスを向上させるため、Hologres V1.3 以降では JSONB 型に対する列指向ストレージ最適化をサポートしています。この機能により、ストレージサイズを削減し、クエリを高速化できます。本トピックでは、Hologres でカラムナー JSONB を使用する方法について説明します。
カラムナーJSONBの原理
次の図に示すように、JSONB に対して列指向ストレージ最適化を有効にすると、システムは下位レイヤーで JSONB カラムを強く型付けされた列指向ストレージ形式に自動的に変換します。JSONB データ内の特定の値をクエリする場合、システムは対応するカラムに直接アクセスできるため、クエリパフォーマンスが向上します。同時に、JSONB データ内の値が列指向形式で格納されるため、通常の構造化データと同じストレージおよび圧縮効率を実現できます。これにより、ストレージコストが削減され、コスト効率が向上します。
JSONB に対する列指向ストレージ最適化は、JSON データ型には適用されません。

制限事項
-
最適なパフォーマンスを得るには、カラムナー JSONB 機能を使用する前に、Hologres インスタンスを V1.3.37 以降にアップグレードすることを推奨します。アップグレードをリクエストするには、「Common errors when upgrade preparation fails」をご参照いただくか、Hologres DingTalk グループにご参加ください。詳細については、「How to get more online support?」をご参照ください。
-
JSONB に対する列指向最適化は、列指向テーブルにのみ適用されます。また、最適化はテーブルに少なくとも 1,000 行が含まれている場合にのみトリガーされます。
-
現在、次の演算子のみが列指向ストレージ最適化をサポートしています。サポートされていない演算子をクエリで使用すると、クエリパフォーマンスが低下する可能性があります。
演算子
右オペランドの型
説明
操作と結果
->
text
キーによって JSON オブジェクトのフィールドを取得します。
-
例:
select '{"a": {"b":"foo"}}'::jsonb -> 'a' -
結果:
{"b":"foo"}
->>
text
JSON オブジェクトのフィールドを TEXT として取得します。
-
例:
select '{"a":1,"b":2}'::jsonb ->> 'b' -
結果:
2
-
カラムナーJSONBの使用
カラムナーJSONBの有効化
次のステートメントを使用して、テーブル内の特定の JSONB カラムに対して列指向ストレージ最適化を有効にします。
-- テーブルの特定カラムで列指向ストレージ最適化を有効化
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = ON);
table_name はテーブル名で、column_name はカラム名です。
-
JSONB に対して列指向ストレージ最適化を有効にすると、システムはコンパクション中に履歴データを列指向ストレージに変換します。この変換は、コンパクションが完了した時点で終了します。
-
コンパクションはメモリなどのシステムリソースを消費します。この操作はオフピーク時に実行することを推奨します。
vacuum table_name;コマンドを実行して、強制的にコンパクションを実行できます。vacuum コマンドの実行が終了すると、コンパクションプロセスが完了します。 -
コンパクションが完了すると、新しく書き込まれたデータは列指向形式で格納されます。
DECIMAL 型推論の有効化
DECIMAL 型推論を有効にする前に、JSONB に対する列指向ストレージ最適化がすでに有効になっていることを確認してください。
Hologres V2.0.11 以降では、DECIMAL データに対する列指向ストレージ最適化をサポートしています。次の JSON データを例として考えます。
{
  "name":"Mike",
  "statistical_period":"2023-01-01 00:00:00+08",
  "balance":123.45
}
balance の値も列指向最適化をサポートします。次のステートメントを使用して、この機能を有効にします。
-- テーブルの特定カラムにある DECIMAL 値の列指向最適化を有効化
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = ON);
table_name はテーブル名で、column_name はカラム名です。
カラムナーJSONBのステータス確認
次のステートメントを使用して、テーブルのカラムナー JSONB のステータスを確認します。
-
次のコマンドは Hologres V1.3.37 以降でサポートされています。
説明Hologres V2.0.17 以前では、このコマンドは
publicスキーマのテーブルのみを表示できます。V2.0.18 以降では、他のスキーマのテーブルのステータスも表示できます。-- V2.0.17 以前は public スキーマのテーブルのみ、V2.0.18 以降は他のスキーマのテーブルもクエリ可能 SELECT * FROM hologres.hg_column_options WHERE schema_name='<schema_name>' AND table_name = '<table_name>';schema_name はスキーマ名で、table_name はテーブル名です。
-
Hologres V1.3.10 から V1.3.36 の場合は、次のコマンドを使用します。
SELECT DISTINCT
    a.attnum as num,
    a.attname as name,
    format_type(a.atttypid, a.atttypmod) as type,
    a.attnotnull as notnull,
    com.description as comment,
    coalesce(i.indisprimary,false) as primary_key,
    def.adsrc as default,
    a.attoptions
FROM pg_attribute a
JOIN pg_class pgc ON pgc.oid = a.attrelid
LEFT JOIN pg_index i ON
    (pgc.oid = i.indrelid AND i.indkey[0] = a.attnum)
LEFT JOIN pg_description com on
    (pgc.oid = com.objoid AND a.attnum = com.objsubid)
LEFT JOIN pg_attrdef def ON
    (a.attrelid = def.adrelid AND a.attnum = def.adnum)
WHERE a.attnum > 0 AND pgc.oid = a.attrelid
AND pg_table_is_visible(pgc.oid)
AND NOT a.attisdropped
AND pgc.relname = '<table_name>'
ORDER BY a.attnum;
table_name はテーブル名です。
-
結果の例:
結果において、カラムの attoptions または options プロパティが
enable_columnar_type = ONである場合、設定が成功したことを示します。num | name | type | notnull | comment | primary_key | default | attoptions ------+------+--------------------------+---------+---------+-------------+---------+------------------------------ 1 | ds | timestamp with time zone | f | | f | | 2 | tags | jsonb | f | | f | | {enable_columnar_type=on} (2 rows)
カラムナーJSONBの無効化
次のコマンドを使用して、テーブル内の特定の JSONB カラムに対する列指向ストレージ最適化を無効にします。
-- テーブルの特定カラムで列指向ストレージ最適化を無効化
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = OFF);
table_name はテーブル名で、column_name はカラム名です。
-
JSONB に対する列指向ストレージ最適化を無効にすると、システムはコンパクション中に履歴データを標準の JSONB ストレージ形式に戻します。この変換は、コンパクションが完了した時点で終了します。
-
コンパクションはメモリなどのシステムリソースを消費します。この操作はオフピーク時に実行することを推奨します。
vacuum table_name;コマンドを実行して、強制的にコンパクションを実行できます。vacuum コマンドの実行が終了すると、コンパクションプロセスが完了します。 -
コンパクションが完了すると、新しく書き込まれたデータは標準の JSONB 形式で格納されます。
DECIMAL 型推論の無効化
特定のカラムの DECIMAL 型推論を無効にするには、次のコマンドを使用します。
-- テーブルの特定カラムにある DECIMAL 値の列指向最適化を無効化
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = OFF);
table_name はテーブル名で、column_name はカラム名です。
DECIMAL 型推論を無効にすると、以前に最適化された DECIMAL データを元の形式に戻すために、すぐにコンパクションがトリガーされます。
ビットマップインデックスの設定
Hologres では、bitmap_columns プロパティはビットマップインデックスを指定します。これはデータストレージとは独立したインデックス構造です。ビットマップベクトル構造を使用して等価比較を高速化し、ファイルブロック内のデータの高速な等価フィルタリングを可能にします。V2.0 以降、Hologres は列指向ストレージが有効になっている JSONB カラムに対するビットマップインデックスの設定をサポートしています。カラムナー JSONB が有効になると、システムはデータを int、int[]、bigint、bigint[]、text、text[]、jsonb の 7 つのデータ型に解析します。ビットマップインデックスが有効になっている場合、システムは int、int[]、bigint、bigint[]、text、text[] 型として推論されたデータに対してビットマップインデックスを構築します。
構文は次のとおりです。
call set_table_property('<table_name>', 'bitmap_columns', '[<columnName>{:[on|off]}[,...]]');パラメーター:
|
パラメーター |
説明 |
|
table_name |
テーブル名。 |
|
columnName |
カラム名。 |
|
on |
指定されたフィールドに対してビットマップインデックスを有効にします。 重要
ビットマップインデックスは、列指向ストレージが有効になっている JSONB カラムに対してのみ設定できます。 |
|
off |
指定されたフィールドに対してビットマップインデックスを無効にします。 |
例
-
テーブルを作成します。
DROP TABLE IF EXISTS user_tags; -- データテーブルの作成 BEGIN; CREATE TABLE IF NOT EXISTS user_tags ( ds timestamptz, tags jsonb ); COMMIT; -
tagsカラムに対して列指向ストレージ最適化を有効にします。ALTER TABLE user_tags ALTER COLUMN tags SET (enable_columnar_type = ON); -
カラムナー JSONB ストレージのステータスを確認します。
select * from hologres.hg_column_options where table_name = 'user_tags';次の結果において、tags 行の options プロパティが {enable_columnar_type=on} である場合、設定が成功したことを示します。
schema_name | table_name | column_id | column_name | column_type | notnull | comment | default | options -------------+------------+-----------+-------------+--------------------------+---------+---------+---------+--------------------------- public | user_tags | 1 | ds | timestamp with time zone | f | | | public | user_tags | 2 | tags | jsonb | f | | | {enable_columnar_type=on} (2 rows) -
データをインポートします。
INSERT INTO user_tags (ds, tags) SELECT '2022-01-01 00:00:00+08' , ('{"id":' || i || ',"first_name" :"Sig", "gender" :"Male"}')::jsonb FROM generate_series(1, 10001) i; -
(オプション) データのフラッシュを強制します。
データが書き込まれた後、システムはデータフラッシュ中にカラムナー JSONB 最適化を実行します。効果をすぐに確認したい場合は、次のコマンドを実行してデータのフラッシュを強制します。
VACUUM user_tags; -
サンプルクエリを実行します。
次の SQL ステートメントを実行して、
idが10のfirst_nameをクエリします。SELECT (tags -> 'first_name')::text AS first_name FROM user_tags WHERE (tags -> 'id')::int = 10; -
実行計画を確認して、クエリがカラムナー最適化を使用していることを確認します。
-- 詳細な統計情報の表示
SET hg_experimental_show_execution_statistics_in_explain = ON;
-- 実行計画の表示
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
結果に
columnar_access_usedが表示される場合、カラムナー JSONB 最適化が使用されたことを示します。 -
手順 6 のクエリの場合、
tagsカラムにビットマップインデックスを設定して、次のコマンドを使用して特定のキーに対する等価クエリの効率を向上させることもできます。call set_table_property('user_tags', 'bitmap_columns', 'tags'); -
実行計画を確認して、ビットマップインデックスが有効であることを確認します。
-- 実行計画の表示
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
結果は次のとおりです。
QUERY PLAN
Gather  (cost=0.00..6.42 rows=3334 width=8)
[2:1 id=100002 dop=1 time=7/7/7ms rows=1(1/1/1) mem=584/584/584B open=0/0/0ms get_next=7/7/7ms]
 -> Local Gather  (cost=0.00..6.30 rows=3334 width=8)
     [id=6 dop=2 time=6/4/3ms rows=1(1/0/0) mem=584/584/584B open=0/0/0ms get_next=6/4/3ms pull_dop=0/0/0]
     -> Decode  (cost=0.00..6.30 rows=3334 width=8)
         [id=4 dop=2 time=7/5/3ms rows=1(1/0/0) mem=0/0/0B open=7/5/3ms get_next=0/0/0ms]
         -> Project  (cost=0.00..6.20 rows=3334 width=8)
             [id=3 dop=2 time=7/5/3ms rows=1(1/0/0) mem=2/2/2KB open=7/5/3ms get_next=0/0/0ms]
             -> Seq Scan on user_tags  (cost=0.00..5.18 rows=3334 width=8)
                 Filter: (int4((tags -> 'id'::text)) = 10)
                 [id=2 dop=2 time=7/5/3ms rows=1(1/0/0) mem=260/160/60KB open=7/5/3ms get_next=0/0/0ms scan_rows=10001(8192/5000/1809) bitmap_used=1]
結果に
bitmap_usedが表示される場合、ビットマップインデックスが使用されたことを示します。
カラムナーJSONBを使用すべきでない場合
カラムナー JSONB を使用すると、ストレージを削減し、クエリ効率を大幅に向上させることができます。ただし、すべてのシナリオに適しているわけではありません。次のシナリオでは使用を推奨しません。逆効果になる可能性があります。
JSONBカラム全体を返す場合
Hologres のカラムナー JSONB は、ほとんどのユースケースで優れた最適化を提供します。ただし、クエリ結果に JSONB カラム全体を含める必要があるシナリオでは、元の JSONB 形式でデータを格納する場合と比較して、パフォーマンスが低下する可能性があります。たとえば、次の SQL ステートメントを例に説明します。
-- テーブル作成の DDL
CREATE TABLE TBL(key int, json_data jsonb);
SELECT json_data FROM TBL WHERE key = 123;
SELECT * FROM TBL limit 10;
このパフォーマンスの低下は、下位レイヤーがすでに JSONB データを列指向ストレージに変換しているために発生します。したがって、完全な JSON データをクエリする必要がある場合、システムはカラムナーデータを元の JSONB 形式に再構築する必要があります。
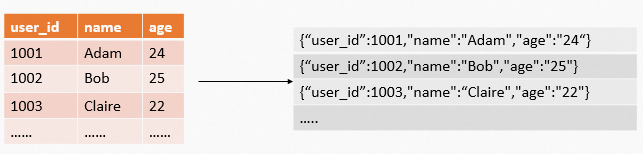
このステップでは、大量の I/O と変換のオーバーヘッドが発生します。データ量が多く、カラム数が多い場合、このプロセスがパフォーマンスのボトルネックになる可能性があります。したがって、このシナリオでは列指向最適化を有効にしないことを推奨します。
極めてスパースなJSONBデータ
Hologres が JSONB データを列指向形式に変換する際にスパースなフィールドに遭遇すると、カラム数が爆発的に増加するのを防ぐために、これらのフィールドを holo.remaining という名前の特殊なカラムにマージします。したがって、JSONB データが完全にスパースなフィールドで構成されている場合 (たとえば、極端なケースでは各フィールドが 1 回しか出現しない場合)、カラムナー変換は効果的ではありません。すべてのフィールドがスパースであるため、すべて holo.remaining カラムにマージされ、実際のカラムナー変換が妨げられます。この場合、クエリパフォーマンスの向上は見られません。
複雑な入れ子構造を持つJSONBデータ
次の JSONB データでは、ルートノードは非同質な JSONB データを含む配列です。現在、Hologres が JSONB データを列指向形式に変換する際、このような複雑な入れ子構造を単一のカラムにダウングレードします。したがって、このタイプの JSONB データに対してカラムナー JSONB 最適化を有効にしても、クエリパフォーマンスの大幅な向上は得られません。
'[
  {"key1": "value1"},
  {"key2": 123},
  {"key3": 123.01}
]'
ベストプラクティス
スロークエリの診断
カラムナー JSONB を有効にした後にクエリパフォーマンスが悪化した場合は、まずクエリが JSONB カラム全体を返しているかどうかを確認してください。SQL ステートメントが複雑すぎる場合は、EXPLAIN ANALYZE コマンドを使用して診断できます。コマンドの例は次のとおりです。
-- テーブル作成の DDL
CREATE TABLE TBL(key int, json_data jsonb);
ALTER TABLE TBL ALTER COLUMN json_data SET (enable_columnar_type = on);
Explain Analyze SELECT json_data FROM TBL WHERE key = 123;
EXPLAIN ANALYZE の結果にはヒント情報が含まれています。ヒントに次のメッセージが含まれている場合、クエリが JSONB カラム全体を返したためにパフォーマンスが低下したことを意味します。
Column 'json_data' has enabled columnar jsonb, but the query scanned the entire Jsonb valueより効率的なSQL構文
-
JSONB フィールドデータを TEXT 形式に変換する方法は複数ありますが、
->>演算子の方がパフォーマンスが優れています。たとえば、json_data カラムの name 属性を取得するには:-- 推奨: 高パフォーマンス SELECT json_data->>'name' FROM tbl; -- 非推奨: 低パフォーマンス SELECT (json_data->'name')::text FROM tbl; -
JSON フィールドに TEXT 配列が格納されており、配列に特定の値が含まれているかどうかを確認する必要がある場合は、次の構文を使用することを推奨します。
SELECT key FROM tbl WHERE jsonb_to_textarray(json_data->'phones') && ARRAY['123456'];
よくある質問
列指向最適化を有効にした後、ストレージ使用量が増加したのはなぜですか?
カラムナー JSONB 最適化を有効にすると、元の JSONB データのフィールド名は格納されなくなります。各フィールドの特定の値のみが格納されます。列指向形式に変換された後、各カラムのすべてのデータは同じ型であるため、列指向ストレージは高いデータ圧縮率を実現できます。理論的には、これによりデータストレージスペースが大幅に削減されるはずです。
ただし、JSONB データのフィールドがスパースで、カラム数が大幅に拡大する場合、各新しいカラムには統計やインデックスなどのメタデータに対する追加のストレージオーバーヘッドが発生します。さらに、ほとんどのカラムが TEXT 型として推論される場合、圧縮はそれほど効果的ではありません。したがって、実際のストレージ圧縮効率は、スパース性などのデータの特定の特性に依存し、すべてのデータセットで理想的な圧縮が保証されるわけではありません。