このトピックでは、Realtime Compute for Apache Flink におけるデータの有効性に関するよくある質問にお答えします。
シンクテーブルで出力が得られないのはなぜですか。
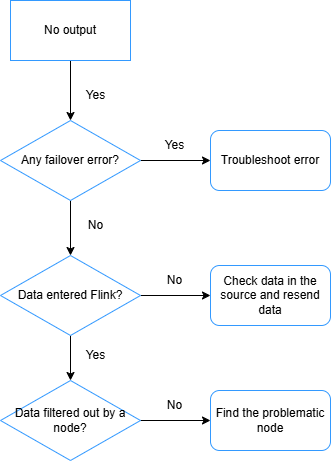
ジョブが開始された後、シンクテーブルにデータが表示されません。以下のチェックを順番に実行してください。
-
フェイルオーバーの確認。 ジョブがフェイルオーバーした場合、エラーメッセージを分析して根本原因を特定し、ジョブが期待どおりに実行されるように解決します。
-
Realtime Compute for Apache Flink にデータが到達しているかの確認。 フェイルオーバーが発生していないにもかかわらず、データレイテンシーが非常に高い場合は、モニタリングおよびアラートページで
numRecordsInOfSourceメトリックを確認します。ソースのメトリックがゼロの場合、ソーステーブルは Flink にデータを送信していません。アップストリームのデータソースを調査してください。 -
オペレーターがすべてのレコードをフィルタリングしていないかの確認。
pipeline.operator-chaining: 'false'を [Other Configuration] フィールドに追加します (「ジョブのカスタム実行パラメーターを設定する方法」をご参照ください)。これにより、オペレーターチェーンが分割され、各オペレーターの [Bytes Received] と [Bytes Sent] のメトリックを個別に確認できます。入力はあるが出力がゼロのオペレーターが原因です。これに該当する一般的なオペレーターには、JOIN、WINDOW、WHERE があります。 -
ダウンストリームデータベースが書き込みバッファーにデータを保持していないかの確認。 ダウンストリームコネクタのバッチサイズを小さくして、データをより早くフラッシュしてください。
重要バッチサイズを極端に小さくしないでください。バッチサイズが 1 の場合、Flink は処理されたレコードごとに個別のリクエストを送信するため、データ量が多い場合にダウンストリームデータベースに過負荷をかける可能性があります。
-
ApsaraDB RDS for MySQL のデッドロックの確認。 「ApsaraDB RDS または TDDL コネクタを介して MySQL に書き込む際のデッドロック」をご参照ください。
問題を切り分けるには、プリントコネクタを使用して中間結果をログに出力します。「プリントコネクタの出力の表示」をご参照ください。
CDC での MiniBatch 有効化と部分的な binlog 消費による空の出力
-
症状
CDC ジョブが MiniBatch を有効にした状態で、
latestまたは特定のオフセットを使用して binlog の途中から消費を開始します。その後、シンクテーブルは部分的なデータを受信するか、まったく出力がなくなります。 -
原因
MiniBatch は、バッチ内で同じプライマリキーのチェンジログメッセージをマージして相殺します。ジョブが binlog の途中から開始されると、対応する
UPDATE_BEFOREがないUPDATE_AFTER(またはその逆) を受信する可能性があります。相反するメッセージがバッチ内で互いに相殺され、出力が生成されないため、ダウンストリームのデータが不正確になります。 -
解決策
-
binlog を最初から消費してください。
latestや指定されたオフセットなどの部分的な消費モードを避けることで、すべてのレコードの完全な変更シーケンスが保持されます。 -
MiniBatch を無効にすると、ジョブはレコードを 1 つずつ処理します。この方法では、正確性を確保する代わりに、スループットがある程度犠牲になります。
-
Flink ソースの読み取り問題のトラブルシューティング
Realtime Compute for Apache Flink がソースから読み取れない場合は、以下を確認してください。
ネットワーク接続性
デフォルトでは、Realtime Compute for Apache Flink は同じリージョンおよび同じ Virtual Private Cloud (VPC) 内のサービスにのみアクセスできます。クロスネットワークアクセスの場合:
-
クロス VPC:「VPC をまたいで他のサービスにアクセスする方法」
-
インターネットアクセス:「インターネットにアクセスする方法」
アップストリームサービスのホワイトリスト
Kafka や Elasticsearch などのサービスから読み取るには、Flink ワークスペースをそれらのホワイトリストに追加する必要があります。
-
Flink ワークスペースの vSwitch の CIDR ブロックを取得します。「ホワイトリストを設定する方法」をご参照ください。
-
その CIDR ブロックをアップストリームサービスのホワイトリストに追加してください。コネクタドキュメントの「前提条件」セクションをご参照ください。例:Kafka。
Flink テーブルと物理テーブル間のフィールドの一貫性
フィールド定義の不一致は、読み取り失敗の一般的な原因です。Flink のソーステーブルの DDL を記述する際は、以下を確認してください。
-
フィールドの順序:物理テーブルの正確なフィールド順序に一致させてください。
-
フィールド名の大文字/小文字:物理テーブルと同じ大文字/小文字を使用してください。
-
フィールドタイプ:マッピングされた同等の型を使用してください。関連するコネクタドキュメントの「データ型のマッピング」セクションを確認してください。例:Simple Log Service。
TaskManager ログの例外
ソーステーブルの TaskManager ログに例外メッセージが含まれているかどうかを確認してください。
-
左側メニューで、[O&M] > [Deployment] に移動します。
-
デプロイ名をクリックします。
-
[Status] タブをクリックし、DAG 内のソース頂点をクリックします。
-
右側のパネルで、[SubTasks] タブをクリックします。
-
[More] 列で、
 アイコンをクリックし、[Open TaskManager Log Page] を選択します。
-
[Logs] タブで、「Caused by」を含む最も古いエントリを探してください。これが通常、根本原因を示しています。
ダウンストリームシステムで出力がない場合のトラブルシューティング
以下のチェックを実行してください。
ネットワーク接続性
デフォルトでは、Realtime Compute for Apache Flink は同じリージョンおよび同じ VPC 内のサービスにのみアクセスできます。クロスネットワークアクセスの場合:
-
クロス VPC:「VPC をまたいで他のサービスにアクセスする方法」
-
インターネットアクセス:「インターネットにアクセスする方法」
ダウンストリームシステムのホワイトリスト
ApsaraDB RDS for MySQL、Kafka、Elasticsearch、AnalyticDB for MySQL 3.0、Apache HBase、Redis、ClickHouse などのサービスに書き込むには、Flink ワークスペースをそれらのホワイトリストに追加する必要があります。
-
Flink ワークスペースの vSwitch の CIDR ブロックを取得します。「ホワイトリストを設定する方法」をご参照ください。
-
その CIDR ブロックをダウンストリームサービスのホワイトリストに追加してください。コネクタドキュメントの「前提条件」セクションをご参照ください。例:ApsaraDB RDS for MySQL。
Flink テーブルと物理テーブル間のフィールドの一貫性
「Flink ソースの読み取り問題のトラブルシューティング」で説明されているのと同じチェックを使用してください。フィールドの順序、フィールド名の大文字/小文字、フィールドタイプのマッピングを確認してください。
オペレーターによってフィルタリングされたデータ
ジョブ DAG 内の各頂点の入力数と出力数を確認してください。WHERE などの頂点で input = 5、output = 0 と表示されている場合、そのオペレーターがすべてのレコードを破棄しています。
シンクコネクタのバッファーしきい値が高すぎる
入力ボリュームが低い場合、デフォルトのバッファーしきい値が高いと、データがダウンストリームシステムにフラッシュされないことがあります。これは、書き込みをトリガーするのに十分なデータがバッファーに蓄積されないためです。必要に応じて、関連するオプションを減らしてください。
| オプション | 説明 | 関連するダウンストリームサービス |
|---|---|---|
batchSize
|
一度に書き込まれるデータのサイズ | DataHub、Tablestore、MongoDB、ApsaraDB RDS for MySQL、AnalyticDB for MySQL V3.0、ApsaraDB for ClickHouse、TSDB for InfluxDB |
batchCount
|
一度に書き込まれるレコードの最大数 | DataHub |
flushIntervalMs
|
MaxCompute Tunnel Writer バッファーのフラッシュ間隔 | MaxCompute |
sink.buffer-flush.max-size
|
HBase に書き込む前にメモリにバッファリングされるデータのサイズ (バイト単位) | ApsaraDB for Hbase |
sink.buffer-flush.max-rows
|
HBase に書き込む前にメモリにバッファリングされるレコードの数 | ApsaraDB for Hbase |
sink.buffer-flush.interval
|
バッファリングされたデータが HBase に定期的にフラッシュされる間隔 | ApsaraDB for Hbase |
jdbcWriteBatchSize
|
JDBC ドライバーを使用する場合に Hologres ストリーミングシンクノードが一度に処理する最大行数 | Hologres |
イベントタイムウィンドウ内の順序が正しくないデータ
ウォーターマークは、ウィンドウがどのレコードを受け入れるかを制御します。最初のレコードのタイムスタンプが 2100 で、ウォーターマークを 2100 に設定した場合、2100 未満のタイムスタンプ (2021 など) を持つ後続のレコードは遅延と見なされ、破棄されます。ウィンドウは、2100 より大きいタイムスタンプを持つレコードが到着するまで閉じることができません。
順序が正しくないレコードを検出するには、プリントシンクテーブルを使用するか、Log4j ログを調べてください。「プリントシンクテーブルの作成」および「ログ出力の設定」をご参照ください。遅延レコードが確認された場合は、それらをフィルタリングするか、遅延到着の猶予期間を許可するようにウォーターマーク戦略を設定します。
入力がないソースサブタスク
ソースサブタスクがデータを受信しない場合、そのウォーターマークはエポックのデフォルト (1970-01-01T00:00:00Z) のままとなり、これがオペレーター全体のウォーターマークになります。これにより、イベントタイムウィンドウが閉じられなくなります。
ジョブ DAG を確認し、すべてのソースサブタスクが入力を受信していることを確認してください。アイドル状態のサブタスクがある場合は、ジョブの並列度をアップストリームテーブルのシャード数に合わせて減らし、すべてのサブタスクにデータが割り当てられるようにしてください。
空の Kafka パーティション
空の Kafka パーティションは、ウォーターマークの生成を停止させる可能性があります。「Kafka ソーステーブルからのイベントタイムウィンドウが出力を生成しないのはなぜですか。」をご参照ください。
データ損失のトラブルシューティング
データ量の減少は、通常、WHERE 句、JOIN、またはウィンドウ操作が原因で発生します。原因不明の損失については、以下を確認してください。
ディメンションテーブルのキャッシュポリシー
不正なキャッシュポリシーは、ルックアップ結合の失敗を引き起こし、レコードが通知なくドロップされる原因となります。コネクタドキュメントのキャッシュ関連オプションを使用して、適切なキャッシュポリシーを設定してください。たとえば、ApsaraDB for Hbase の「ディメンションテーブル固有 (キャッシュパラメーターなど)」セクションなどです。
関数の使用法
to_timestamp_tz や date_format などの関数の不適切な使用は、データ変換の失敗を引き起こし、レコードが通知なく破棄される原因となります。プリントシンクテーブルまたは Log4j ログを使用して、関数の動作を確認してください。「Print」および「ログ出力の設定」をご参照ください。
順序が正しくないデータ
遅延イベントは、そのタイムスタンプが現在のウィンドウの許容範囲外にある場合に破棄されます。たとえば、タイムスタンプが 11 秒のイベントが 15~20 秒のウィンドウに入ると、そのウォーターマークが 11 であり、ウィンドウの下限を下回っているため破棄されます。
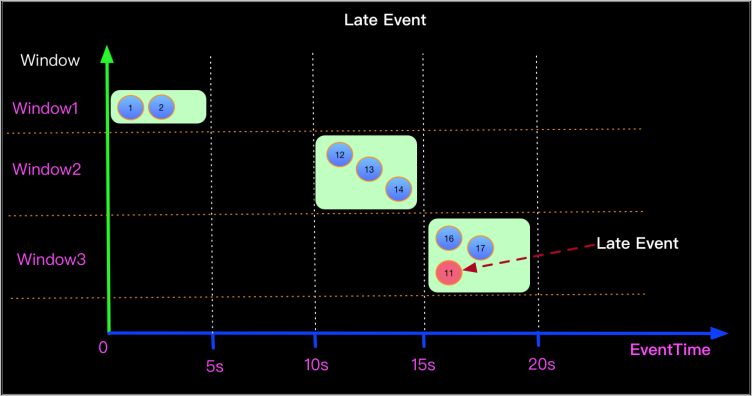
この原因による損失は、通常、単一のウィンドウに集中します。プリントシンクテーブルまたは Log4j を使用して、順序が正しくないデータが存在することを確認してください。
順序が正しくないことによる損失を最小限に抑えるには、猶予期間を持つウォーターマーク生成戦略を設定してください (例: Watermark = Event time - 5s)。ウィンドウを正確な日、時、または分の境界に合わせてください。これにより、ウィンドウの動作が予測可能になり、適切な猶予期間と組み合わせることで、エッジケースでの破棄を減少させることができます。
CDC モードで Hologres から取り込んだデータを ROW_NUMBER を使用して重複排除すると、不正確な結果が得られるのはなぜですか。
SELECT
    hg_binlog_timestamp_us,
    order_id,
    order_name,
    order_pay,
    order_starttime
FROM(
    SELECT
        hg_binlog_lsn,
        hg_binlog_event_type,
        hg_binlog_timestamp_us,
        order_id,
        order_name,
        order_pay,
        order_starttime,
        ROW_NUMBER()
            OVER(
                PARTITION BY
                    order_id
                ORDER BY
                order_starttime desc
            ) as rn
    FROM test_cdc
)
where rn = 1
test_cdc テーブルに次のサンプルデータが含まれていると仮定します。このデータでは、order_id が 1001 の注文に 2 つの変更レコードがあります。
hg_binlog_timestamp_us | order_id | order_name | order_pay | order_starttime
1785578400000000       | 1001     | phone      | 3999.00   | 2026-08-01 10:00:00
1785582000000000       | 1001     | phone      | 3599.00   | 2026-08-01 11:00:00
1785578460000000       | 1002     | earphone   | 299.00    | 2026-08-01 10:01:00
上記の SQL ステートメントを実行した後、レコードは order_id でパーティション分割され、order_starttime で降順にソートされ、rn = 1 のレコードのみが保持されることが期待されます。しかし、この異常なシナリオでは、重複排除が有効にならず、結果には依然として order_id が 1001 の注文の両方の変更レコードが含まれています。
hg_binlog_timestamp_us | order_id | order_name | order_pay | order_starttime
1785578400000000       | 1001     | phone      | 3999.00   | 2026-08-01 10:00:00
1785582000000000       | 1001     | phone      | 3599.00   | 2026-08-01 11:00:00
1785578460000000       | 1002     | earphone   | 299.00    | 2026-08-01 10:01:00
ダウンストリームではリトラクションオペレーター (たとえば、重複排除のための ROW_NUMBER OVER WINDOW) を使用していますが、Hologres ソースは upsert モードでデータを出力するように設定されていません。upsert モードでない場合、ソースは挿入のみのイベントを生成するため、リトラクションオペレーターはこれを正しく処理できません。
ソーステーブルの DDL ステートメントの WITH 句に 'upsertSource' = 'true' を追加してください。
,'binlog' = 'true'
,'sdkMode' = 'jdbc'
,'cdcMode' = 'true'
,'binlogStartUpMode' = 'initial'
,'jdbcBinlogSlotName' = 'test_cdc_1_replication_slot'
,'binlogMaxRetryTimes' = '10',
'binlogRetryIntervalMs' = '500',
'binlogBatchReadSize' = '100'
,'upsertSource' = 'true'
)
不正確な結果のトラブルシューティング
-
ジョブロジックを変更せずに中間結果を検査するために、オペレータープロファイリングを有効にしてください。
-
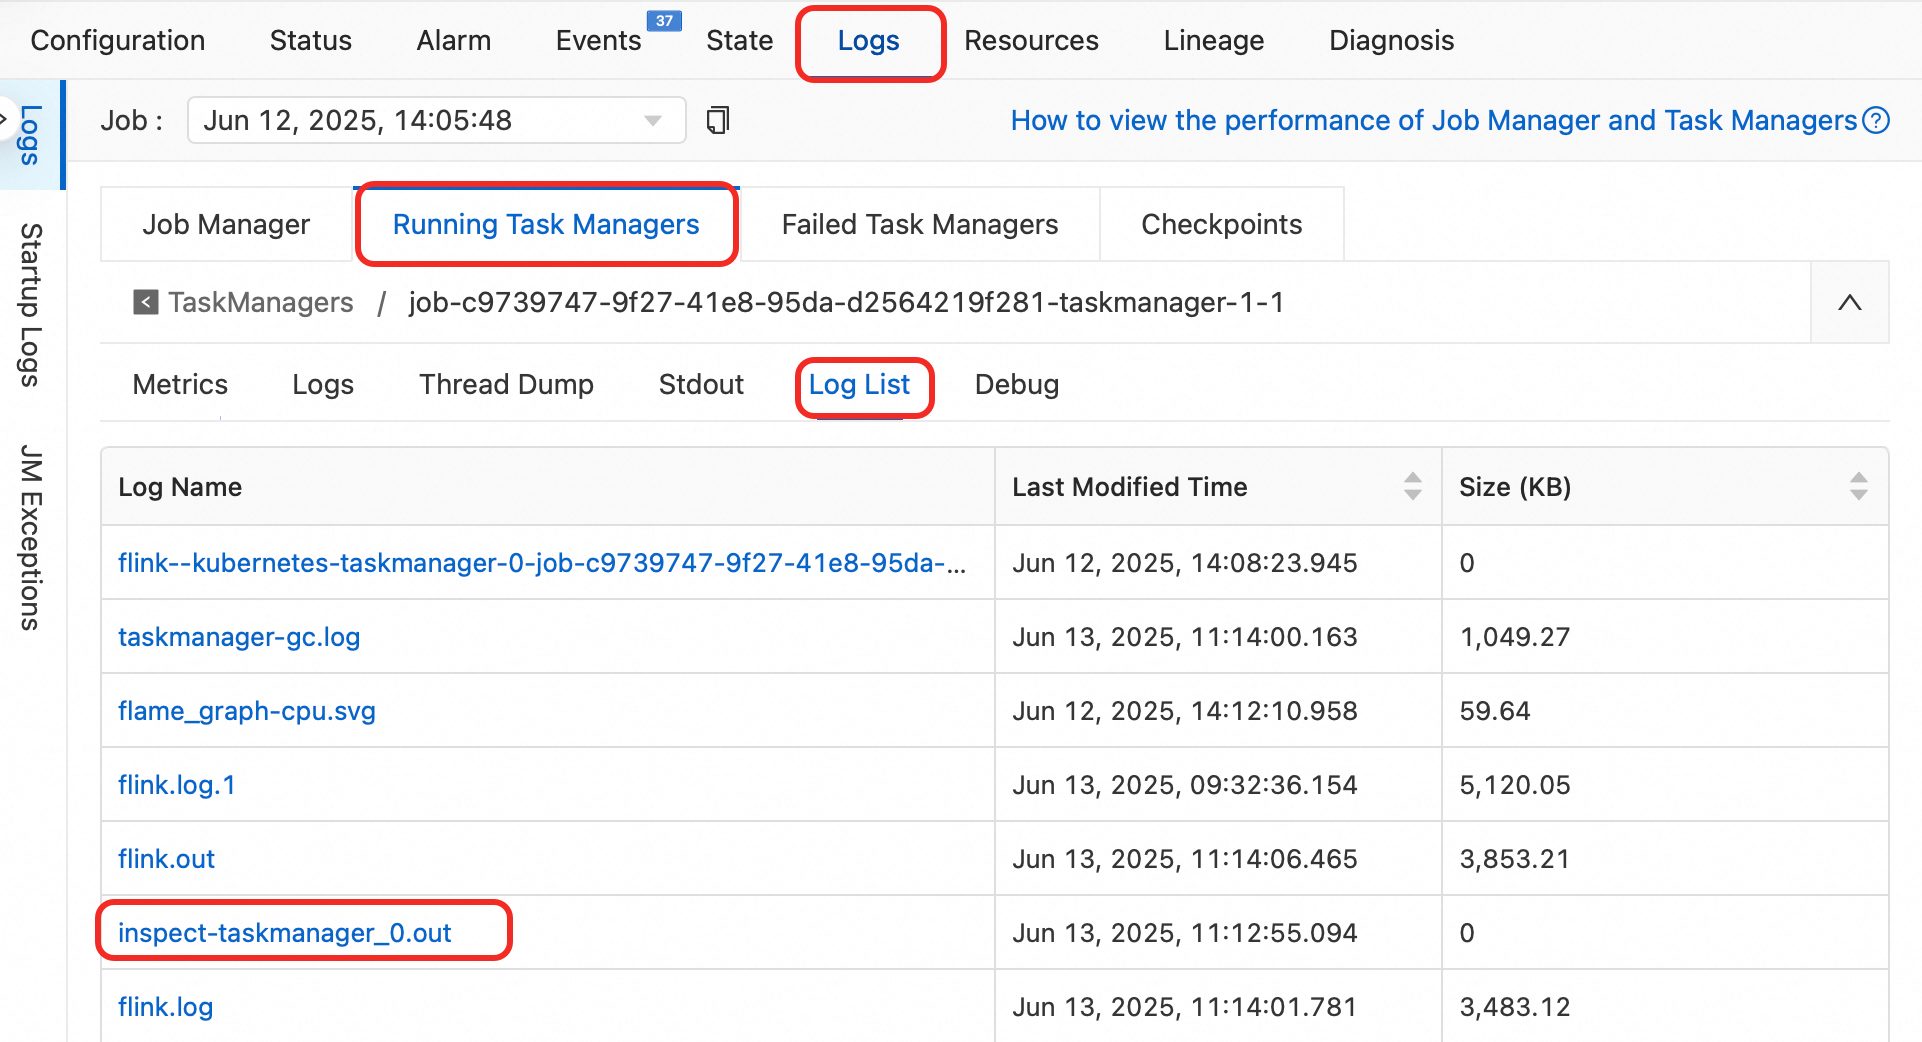
実行時ログを分析してください:
-
デプロイ名をクリックし、[Status] タブをクリックします。
-
DAG で、誤った結果を生成しているオペレーターの名前をコピーします。
-
ログリストで、[Log Name] の下にある
inspect-taskmanager_0.outをクリックし、オペレーター名を検索してください。
-
-
根本原因を特定した後、オペレーターのロジックを修正し、ジョブを再起動して、データの正確性を検証してください。
「doesn't support consuming update and delete changes which is produced by node TableSourceScan」エラーの修正方法
エラーメッセージは次のようになります。
Table sink 'vvp.default.***' doesn't support consuming update and delete changes which is produced by node TableSourceScan(table=[[vvp, default, ***]], fields=[id,b, content])
    at org.apache.flink.table.sqlserver.execution.DelegateOperationExecutor.wrapExecutor(DelegateOperationExecutor.java:286)
    at org.apache.flink.table.sqlserver.execution.DelegateOperationExecutor.validate(DelegateOperationExecutor.java:211)
    at org.apache.flink.table.sqlserver.FlinkSqlServiceImpl.validate(FlinkSqlServiceImpl.java:741)
    at org.apache.flink.table.sqlserver.proto.FlinkSqlServiceGrpc$MethodHandlers.invoke(FlinkSqlServiceGrpc.java:2522)
    at io.grpc.stub.ServerCalls$UnaryServerCallHandler$UnaryServerCallListener.onHalfClose(ServerCalls.java:172)
    at io.grpc.internal.ServerCallImpl$ServerStreamListenerImpl.halfClosed(ServerCallImpl.java:331)
    at io.grpc.internal.ServerImpl$JumpToApplicationThreadServerStreamListener$1HalfClosed.runInContext(ServerImpl.java:820)
    at io.grpc.internal.ContextRunnable.run(ContextRunnable.java:37)
    at io.grpc.internal.SerializingExecutor.run(SerializingExecutor.java:123)
    at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1147)
    at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:622)
at java.lang.Thread.run(Thread.java:834)シンクテーブルが追記専用モードであり、ソースからの更新または削除イベントを消費できません。これを、Upsert Kafka のように upsert をサポートするシンクに置き換えてください。
Lindorm コネクタ使用時の予期しないデータ上書きや削除の修正方法
デフォルトでは、Lindorm コネクタは、書き込み順序を管理するために upsert materialize オペレーター (デフォルト: AUTO) を使用します。このオペレーターは、同じプライマリキーに対して DELETE の後に INSERT を生成します。Lindorm の 2 つの特性により、これが問題となります。
-
ミリ秒単位のタイムスタンプ精度: Lindorm はミリ秒単位のタイムスタンプを使用してデータをバージョニングします。単一のミリ秒内に書き込まれた同じプライマリキーを持つ複数のレコードが順不同で到着することがあり、バージョンの競合を引き起こします。
-
DELETE のネイティブサポートがない: Lindorm は UPSERT セマンティクスのみをサポートしており、削除は元に戻せません。したがって、
upsert materializeの順序維持ロジックは効果がなく、DELETE + INSERT シーケンスからデータ異常を引き起こす可能性があります。
同時書き込みが同じミリ秒内に発生すると、結果として生じる DELETE および INSERT 操作が不正確なデータまたは通知のないデータ損失を引き起こす可能性があります。
解決策: ジョブの実行時パラメーター設定または SQL コードに以下を追加して、upsert materialize オペレーターを明示的に無効にしてください。
SET 'table.exec.sink.upsert-materialize' = 'NONE';この設定は、Flink を介して Lindorm に書き込むすべてのジョブに適用されます。
このオペレーターを無効にすると、保証されるのは結果整合性のみとなります。この変更を適用する前に、ユースケースで結果整合性が許容できることを確認してください。