StarRocks は、さまざまなビジネスシナリオに対応する複数のデータモデルをサポートしており、すべてのデータは特定のモデルに従って構成する必要があります。本トピックでは、さまざまなロード方法の基本概念、原則、システム設定、ユースケース、ベストプラクティス、および FAQ について説明します。
背景情報
データロードとは、生データをクリーンアップ、変換し、特定のデータモデルに基づいて StarRocks にロードしてクエリを実行できるようにするプロセスです。StarRocks は、データ量、ロード頻度、その他のビジネス要件に基づいて選択できる複数のロード方法を提供しています。
次の図は、StarRocks のロード方法とさまざまなデータソースとの関係を示しています。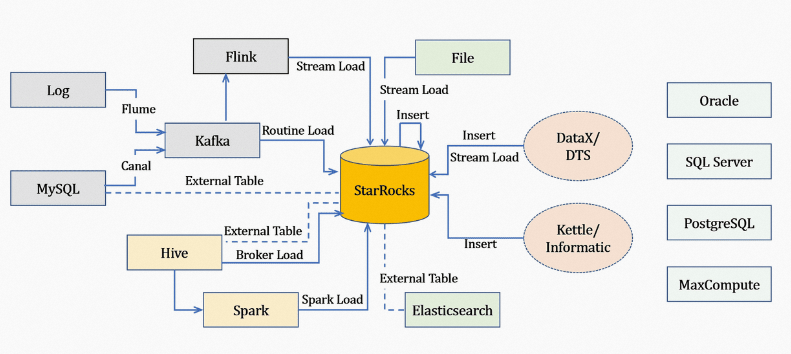
データソースに基づいて、さまざまなロード方法を選択できます。
-
オフラインでのデータロード:ソースデータが Hive または HDFS にある場合は、Broker Load を使用します。多くのデータテーブルが関わる複雑なロードには、を使用できます。この方法は Broker Load よりもパフォーマンスは低いですが、データ移行を回避できます。単一テーブルのデータ量が非常に大きい場合や、正確な重複排除のためのグローバルデータ辞書として使用する場合は、Spark Load の使用を検討してください。
-
リアルタイムでのデータロード:ログデータとデータベースのバイナリログ (binlog) を Kafka に同期した後、Routine Load を使用してデータを StarRocks にロードできます。ロードプロセスに複雑なテーブル結合や ETL (抽出、変換、ロード) の前処理が含まれる場合は、Flink (Flink コネクタ) を使用してデータを先に処理できます。その後、Stream Load を使用してデータを StarRocks に書き込みます。
-
プログラムから StarRocks への書き込み:Stream Load を使用できます。例については、Stream Load ドキュメントの Java または Python のデモをご参照ください。
-
テキストファイルのロード:Stream Load を使用できます。
-
MySQL データのロード:MySQL 外部テーブルを使用できます。データをロードするには、
insert into new_table select * from external_tableコマンドを実行します。 -
StarRocks 内部でのロード:Insert Into メソッドを使用できます。このメソッドは、外部スケジューラと連携して単純な ETL 処理を実行します。
本トピックの画像と一部のコンテンツは、オープンソース StarRocks のドキュメント「データロードの概要」から引用しています。
注意事項
StarRocks にデータをロードする際は、通常、プログラムを使用して接続を確立します。次の点にご注意ください。
-
適切なロード方法の選択:データ量、ロード頻度、データソースの場所に基づいてロード方法を選択します。
たとえば、ソースデータが HDFS 上にある場合は、Broker Load を使用できます。
-
ロード方法のプロトコルの決定:Broker Load を選択した場合、外部システムは MySQL プロトコルを使用して定期的にロードジョブをサブミットし、チェックできる必要があります。
-
ロード方法のタイプの決定:ロード方法は、同期または非同期のいずれかです。非同期ロード方法の場合、ロードジョブをサブミットした後、コマンドを実行してジョブのステータスを確認する必要があります。このコマンドの結果で、ロードが成功したかどうかがわかります。
-
ラベル生成ポリシーの作成:ポリシーは、各バッチのデータに対して各ラベルが一意かつ固定であることを保証する必要があります。
-
Exactly-Once セマンティクスの保証:外部システムは At-Least-Once のデータロードを保証する必要があります。StarRocks のラベルメカニズムは At-Most-Once のデータロードを保証します。これら 2 つのメカニズムを組み合わせることで、データロードプロセス全体で Exactly-Once セマンティクスが保証されます。
用語
|
用語 |
説明 |
|
ロードジョブ |
ユーザーがサブミットしたソースデータを読み取り、クリーンアップと変換を行った後、StarRocks システムにロードします。ロードが完了すると、データはクエリ可能になります。 |
|
ラベル |
ロードジョブを識別します。すべてのロードジョブにはラベルがあります。 ラベルはユーザー指定またはシステム生成が可能で、データベース内で一意です。ラベルは 1 つの成功したロードジョブにのみ使用できます。特定のラベルを持つロードジョブが成功した後、そのラベルを再利用して別のロードジョブをサブミットすることはできません。ロードジョブが失敗した場合、ラベルは再利用できます。このメカニズムにより、At-Most-Once のロードセマンティクスが保証されます。 |
|
原子性 |
StarRocks のすべてのロード方法は原子性を提供します。これは、単一のロードジョブにおいて、すべての有効なデータが正常にロードされるか、まったくロードされないかのいずれかであることを意味します。部分的なロードは発生しません。ここでの有効なデータには、型変換エラーなどの品質問題でフィルタリングされたデータは含まれません。データ品質問題の詳細については、データロードに関するFAQをご参照ください。 |
|
MySQL および HTTP プロトコル |
StarRocks は、ジョブをサブミットするための 2 つのアクセスプロトコルインターフェイス (MySQL プロトコルと HTTP プロトコル) を提供しています。 |
|
Broker Load |
デプロイされた Broker プログラムを介して HDFS などの外部ソースからデータを読み取り、StarRocks にロードします。Broker プロセスは、独自のコンピューティングリソースを使用してデータを前処理します。 |
|
Spark Load |
外部の Spark リソースを使用してデータを前処理し、StarRocks が読み取ってロードするための中間ファイルを生成します。Spark Load は非同期です。MySQL プロトコルを使用してロードジョブを作成し、SHOW LOAD コマンドで結果を確認します。 |
|
FE (Frontend) |
Frontend (FE)。StarRocks のメタデータおよびスケジューリングノードであり、ロード実行計画の生成とロードタスクのスケジューリングを担当します。 |
|
BE (Backend) |
Backend (BE)。StarRocks のコンピューティングおよびストレージノードであり、ロード中のデータ ETL とストレージを担当します。 |
|
タブレット |
StarRocks テーブルの論理的なシャードです。テーブルは、パーティショニングとバケット化のルールに従って、複数のタブレットに分割できます。詳細については、「データ分散」をご参照ください。 |
基本原則
ロードの実行フローを次の図に示します。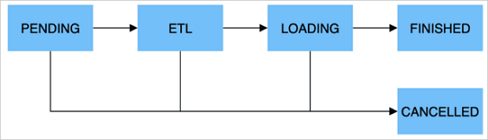
ロードジョブは、次の 5 つのステージで構成されています。
|
ステージ |
説明 |
|
PENDING |
オプション。このステージでは、ロードジョブがサブミットされ、FE による実行スケジューリングを待機しています。 Broker Load と Spark Load にはこのステージが含まれます。 |
|
ETL |
オプション。このステージでは、クレンジング、パーティショニング、ソート、集計などのデータ前処理を実行します。 Spark Load にはこのステージが含まれます。外部のコンピューティングリソースである Spark を使用して ETL プロセスを完了します。 |
|
LOADING |
このステージでは、データが最初にクリーンアップおよび変換され、処理のために BE に送信されます。すべてのデータがロードされると、ジョブはデータが有効になるのを待つ状態に入ります。この時点では、ロードジョブのステータスはまだ LOADING です。 |
|
FINISHED |
ロードジョブに関連するすべてのデータが有効になると、ジョブのステータスは FINISHED に変わります。FINISHED 状態のジョブのデータはクエリ可能です。FINISHED は、成功したロードジョブの最終状態です。 |
|
CANCELLED |
ジョブのステータスが FINISHED に変わる前であれば、いつでもキャンセルして CANCELLED 状態に移行できます。たとえば、手動でキャンセルしたり、ロード中にエラーが発生したりした場合などです。CANCELLED もロードジョブの最終状態です。 |
データロードのフォーマットを次の表に示します。
|
タイプ |
説明 |
|
整数型 |
TINYINT、SMALLINT、INT、BIGINT、および LARGEINT。例:1、1000、1234。 |
|
浮動小数点型 |
FLOAT、DOUBLE、および DECIMAL。例:1.1、0.23、0.356。 |
|
日付型 |
DATE および DATETIME。例:2017-10-03、2017-06-13 12:34:03。 |
|
文字列型 |
CHAR および VARCHAR。例:I am a student、a。 |
ロード方法
StarRocks は、HDFS、Kafka、ローカルファイルなどのさまざまなデータソースに対応するため、5 つのロード方法を提供しています。これらの方法は、同期または非同期のいずれかです。
すべてのロード方法は CSV データ形式をサポートしています。Broker Load は、Parquet および ORC データ形式もサポートしています。
ロード方法の紹介
|
ロード方法 |
説明 |
ロードタイプ |
|
Broker Load |
Broker プロセスを通じて外部データソースを読み取り、MySQL プロトコルを介して StarRocks にロードジョブを作成します。ジョブは非同期で実行されます。 HDFS などの Broker がアクセス可能なストレージシステムにある、数十から数百ギガバイトのデータ量に適しています。詳細については、「Broker Load」をご参照ください。 |
非同期ロード |
|
Spark Load |
外部の Spark リソースを使用してロード対象のデータを前処理することで、大規模なデータセットのパフォーマンスを向上させ、StarRocks クラスターのリソース使用量を削減します。この非同期メソッドでは、MySQL プロトコルを介してジョブを作成し、 Spark Load は、大量のデータ (最大テラバイトレベル) を初めて StarRocks に移行する場合に適しています。ソースデータは、HDFS など Spark がアクセスできるストレージシステムにある必要があります。詳細については、「Spark Load」をご参照ください。 |
非同期ロード |
|
Stream Load |
HTTP プロトコルを介してローカルファイルまたはデータストリームを StarRocks にロードする同期メソッドです。ロード結果はレスポンスで直接返されます。 ローカルファイルのロードや、プログラムからのストリーミングデータのロードに適しています。詳細については、「Stream Load」をご参照ください。 |
同期ロード |
|
Routine Load |
永続的なスレッドを作成して、指定されたソースからデータを自動的にロードします。MySQL プロトコルを通じて Routine Load ジョブをサブミットし、Kafka などのソースからデータを継続的に読み込んでロードします。詳細については、「Routine Load」をご参照ください。 |
非同期ロード |
|
Insert Into |
MySQL の |
同期ロード |
ロードタイプ
外部プログラムが StarRocks のデータロード機能を使用する場合、まずどのタイプのロード方法を使用するかを決定し、次に接続ロジックを定義する必要があります。
-
同期ロード
同期ロードでは、StarRocks はタスクを直ちに実行し、ロードが成功したかどうかを示す結果を返します。
手順:
-
ユーザー (外部システム) がロードタスクを作成します。
-
StarRocks がロード結果を返します。
-
ユーザー (外部システム) がロード結果を確認します。ロードに失敗した場合、ユーザーは再度ロードタスクを作成できます。
-
-
非同期ロード
非同期ロードでは、StarRocks は作成成功のメッセージを直ちに返しますが、データはまだロードされていません。コマンドを実行してジョブのステータスをポーリングする必要があります。タスクの作成に失敗した場合は、失敗情報に基づいて再試行できます。
手順:
-
ユーザー (外部システム) がロードタスクを作成します。
-
StarRocks がタスク作成の結果を返します。
-
ユーザー (外部システム) がタスク作成の結果を確認します。タスクが正常に作成された場合は、ステップ 4 に進みます。それ以外の場合は、ステップ 1 に戻り、再度ロードタスクの作成を試みます。
-
ユーザー (外部システム) は、タスクのステータスが FINISHED または CANCELLED になるまでポーリングします。
-
シナリオ
|
シナリオ |
説明 |
|
HDFS からのロード |
ソースデータが HDFS に保存されており、データ量が数十から数百ギガバイトの場合、Broker Load を使用してデータを StarRocks にロードできます。デプロイ済みの Broker プロセスは HDFS データソースにアクセスできる必要があります。ロードジョブは非同期で実行されます。 ソースデータが HDFS に保存されており、データ量がテラバイトレベルに達する場合、Spark Load を使用してデータを StarRocks にロードできます。デプロイ済みの Spark プロセスは HDFS データソースにアクセスできる必要があります。ロードジョブは非同期で実行されます。 他の外部データソースについても、Broker または Spark プロセスが対応するデータソースから読み取れる限り、Broker Load または Spark Load を使用してデータをロードできます。 |
|
ローカルファイルからのロード |
10 GB 未満のローカルファイルの場合は、Stream Load を使用します。HTTP プロトコルを介してロードジョブを作成します。ジョブは同期的に実行され、結果を直接返します。 |
|
Kafka からのロード |
Kafka などのストリーミングソースからのリアルタイムデータには、Routine Load を使用します。MySQL プロトコルを介して Routine Load ジョブを作成すると、StarRocks は継続的にデータを読み込んでロードします。 |
|
Insert Into によるロード |
手動テストや一時的なデータ処理には、
|
メモリ制限
パラメータを設定して、ロードジョブごとのメモリ使用量を制限し、メモリ不足 (OOM) エラーを防ぎます。メモリを制限する方法はロード方法によって異なります。詳細については、各方法のドキュメントをご参照ください。
ロードジョブは通常、複数の BE に分散されます。メモリ制限パラメータは、単一の BE 上での 1 つのロードジョブのメモリ使用量を制限するものであり、クラスター全体の合計ではありません。各 BE には、すべてのロードジョブに対する合計メモリ制限もあります。詳細については、「一般的なシステム設定」をご参照ください。
メモリ制限が小さいと、頻繁なディスク書き込みが発生してロード効率が低下する可能性があります。一方、制限が大きいと、高い同時実行性の下で OOM エラーのリスクがあります。ワークロードの要件に基づいてメモリパラメータを設定してください。
一般的なシステム設定
FE の設定
fe.conf ファイルで次の FE パラメータを設定します。
|
パラメータ |
説明 |
|
max_load_timeout_second |
ロードジョブのタイムアウト期間 (秒単位) の最大値と最小値です。デフォルトの最大タイムアウトは 3 日、デフォルトの最小タイムアウトは 1 秒です。ロードジョブに設定するカスタムタイムアウトは、この範囲を超えることはできません。このパラメータは、すべてのタイプのロードタスクに適用されます。 |
|
min_load_timeout_second |
|
|
desired_max_waiting_jobs |
待機キューが保持できるロードタスクの最大数です。デフォルト値は 100 です。 たとえば、FE 上で PENDING 状態 (実行待機中) のロードタスクの数がこの値に達すると、新しいロードリクエストは拒否されます。この設定は、非同期で実行されるロードにのみ適用されます。待機中の非同期ロードタスクの数が上限に達すると、それ以降のロードジョブ作成リクエストは拒否されます。 |
|
max_running_txn_num_per_db |
各データベースで実行中のロードタスクの最大数です。これは、すべてのロードタイプにわたってカウントされます。デフォルト値は 100 です。 データベースで実行中のロードタスクの数が最大値を超えると、後続のロードタスクは実行されません。同期ジョブの場合、ジョブは拒否されます。非同期ジョブの場合、ジョブはキューで待機します。 |
|
label_keep_max_second |
ロードタスクのレコードの保持期間です。 完了した (FINISHED または CANCELLED) ロードタスクのレコードは、このパラメータで決定される期間、StarRocks システムに保持されます。デフォルト値は 3 日です。このパラメータは、すべてのタイプのロードタスクに適用されます。 |
BE の設定
be.conf ファイルで次の BE パラメータを設定します。
|
パラメータ |
説明 |
|
push_write_mbytes_per_sec |
BE 上の単一タブレットの書き込み速度制限です。デフォルト値は 10 で、10 MB/s を意味します。 BE 上の単一タブレットの最大書き込み速度は、通常 10 MB/s から 30 MB/s の間であり、スキーマとシステムに依存します。このパラメータを調整してロード速度を制御できます。 |
|
write_buffer_size |
データロード中、データはまず BE 上のメモリブロックに書き込まれます。このメモリブロックがしきい値に達すると、ディスクに書き込まれます。デフォルト値は 100 MB です。 しきい値が小さいと、BE 上に多数の小さなファイルが作成される可能性があります。このしきい値を大きくすることで、ファイル数を減らすことができます。ただし、しきい値が大きいと RPC タイムアウトが発生する可能性があります。詳細については、tablet_writer_rpc_timeout_sec パラメータをご参照ください。 |
|
tablet_writer_rpc_timeout_sec |
ロードプロセス中にバッチ (1024 行) を送信するための RPC タイムアウトです。デフォルトは 600 秒です。 この RPC には、複数のタブレットメモリブロックのディスクへの書き込みが含まれる場合があります。そのため、ディスク書き込みが原因で RPC タイムアウトが発生することがあります。タイムアウトを調整することで、send batch fail などのタイムアウトエラーを減らすことができます。また、write_buffer_size パラメータを増やす場合は、tablet_writer_rpc_timeout_sec パラメータも増やす必要があります。 |
|
streaming_load_rpc_max_alive_time_sec |
ロードプロセス中、StarRocks は各タブレットに対してライターを起動し、データを受信して書き込みます。このパラメータは、ライターの待機タイムアウトを指定します。デフォルトは 600 秒です。 指定された時間内にライターがデータを受信しない場合、ライターは自動的に破棄されます。システムの処理速度が遅い場合、ライターが次のデータバッチを長時間受信できず、 |
|
load_process_max_memory_limit_percent |
これらのパラメータは、それぞれメモリの最大値と最大パーセンテージを指定します。これらは、単一の BE 上でロードタスクに使用できる合計メモリを制限します。システムは、2 つの値のうち小さい方を BE 上のロードタスクの最終的なメモリ制限として使用します。
|
|
load_process_max_memory_limit_bytes |