DataWorks のバッチデータベース同期機能は、ソースデータベースから宛先へ、一部またはすべてのテーブルのスキーマとデータを定期的に同期し、完全同期、増分同期、または組み合わせ同期モードに対応しています。以下では、MySQL から MaxCompute への移行を例に、設定手順を説明します。
前提条件
データソース
ソースデータソースと宛先データソースを作成します。 詳細については、「データソース管理」をご参照ください。
お使いのデータソースがバッチデータベース同期をサポートしていることを確認してください。 PostgreSQL や Oracle など、サポートされているソースデータソースの詳細については、「サポートされているデータソース」をご参照ください。 お使いのソースデータソースがサポートリストにない場合 (たとえば、特定の PostgreSQL バージョン) 、代わりに単一テーブルのオフライン同期を使用してください。
リソースグループ: サーバーレスリソースグループを購入し、設定します。
ネットワーク接続:リソースグループとデータソース間のネットワーク接続を確立します。
適用範囲
バッチデータベース同期タスクは、[データ開発] と [Data Integration] の両方で設定できます。 機能は両方のモジュールで同一です。
一貫した設定:タスクを DataStudio で作成するか Data Integration で作成するかにかかわらず、インターフェイス、パラメーター、および基本的な機能は同一です。
双方向同期:Data Integration はタスクを自動的に同期し、DataStudio の
data_integration_jobsディレクトリに表示します。これらのタスクは、一元管理するためにSourceType-DestinationTypeチャネルによって分類されます。T+1 データ同期:バッチデータベース同期は、T+1 データベース同期シナリオにも適用されます。 定期的なフル同期、または組み込みのワンタイムフル同期とそれに続く定期的な増分同期として設定することで、日次スケジュールのフルスナップショットまたは増分 ETL パイプラインを実装できます。
同期タスクの設定
ステップ 1:同期タスクの作成
DataWorks コンソールにログインします。 左側のナビゲーションウィンドウで、[Data Integration] をクリックします。 表示されるページで、ドロップダウンリストから目的のワークスペースを選択し、[Data Integrationに移動] をクリックします。
左側のナビゲーションペインで 同期タスク をクリックし、ページ上部の 同期タスクの作成 をクリックします。 タスク情報を設定します。
[データソースタイプ]:
MySQL。[データ宛先タイプ]:
MaxCompute。[詳細種別]:
バッチデータベース同期。[同期ステップ]: [同期ステップ] の設定は、後続の [フルおよび増分制御] の設定と連携します。 これらを組み合わせて、さまざまな同期ソリューションを作成できます。 詳細については、「フルおよび増分制御」をご参照ください。
[スキーマ移行]:ソーススキーマに合わせて、テーブル、フィールド、データ型などのデータベースオブジェクトを宛先に自動的に作成しますが、データは移行しません。
[全量同期] (オプション) :テーブルなどの指定されたソースオブジェクトからすべての履歴データを 1 回の操作で宛先にコピーします。 これは通常、初期データ移行またはデータ初期化に使用されます。
[増分同期] (オプション) :フル同期が完了した後、このモードは増分条件に基づいてソースから新しいデータを継続的にキャプチャし、宛先にデータを同期します。
ステップ 2:データソースとランタイムリソースの設定
ソースデータソース セクションで、ワークスペース内の
MySQLデータソースを選択します。 宛先データソース セクションで、追加したMaxComputeデータソースを選択します。実行中のリソース セクションで、同期タスクの[リソースグループ]を選択し、[リソースグループ]の CU を割り当てます。 メモリ不足 (OOM) エラーで同期タスクが失敗した場合は、割り当てられた[リソースグループ CU] を増やしてください。
説明ここで設定する[リソースグループ CU] の値は、バッチデータベース同期タスク全体で利用可能な CU の上限です。 単一テーブルの同期サブタスクが実際に消費する CU の数は、タスク編集ページの右上隅にある の [オフライン同期タスク CU] パラメーターによって決まります。 デフォルト値は 1 CU、最小値は 0.5 CU です。
これら 2 つの設定を組み合わせることで、同時に同期できるテーブルの数が決まります: 最大同時サブタスク数 = リソースグループ CU ÷ オフライン同期タスク CU。 たとえば、タスクに 10 CU を割り当て、各テーブルに 2 CU を割り当てた場合、最大で 5 つのサブタスクが同時に実行されます。これは、5 つのテーブルが同時に同期されることを意味します。 残りのテーブルは、先行するサブタスクが終了しリソースを解放した後にのみ開始されます。
ソースデータソースと宛先データソースの両方が[接続性チェック]に合格していることを確認します。
ステップ 3:同期ソリューションの設定
1. データソース
[ソーステーブル] セクションでソースデータソースから同期するテーブルを選択します。  アイコンをクリックして、右側の [選択したテーブル] リストに追加します。
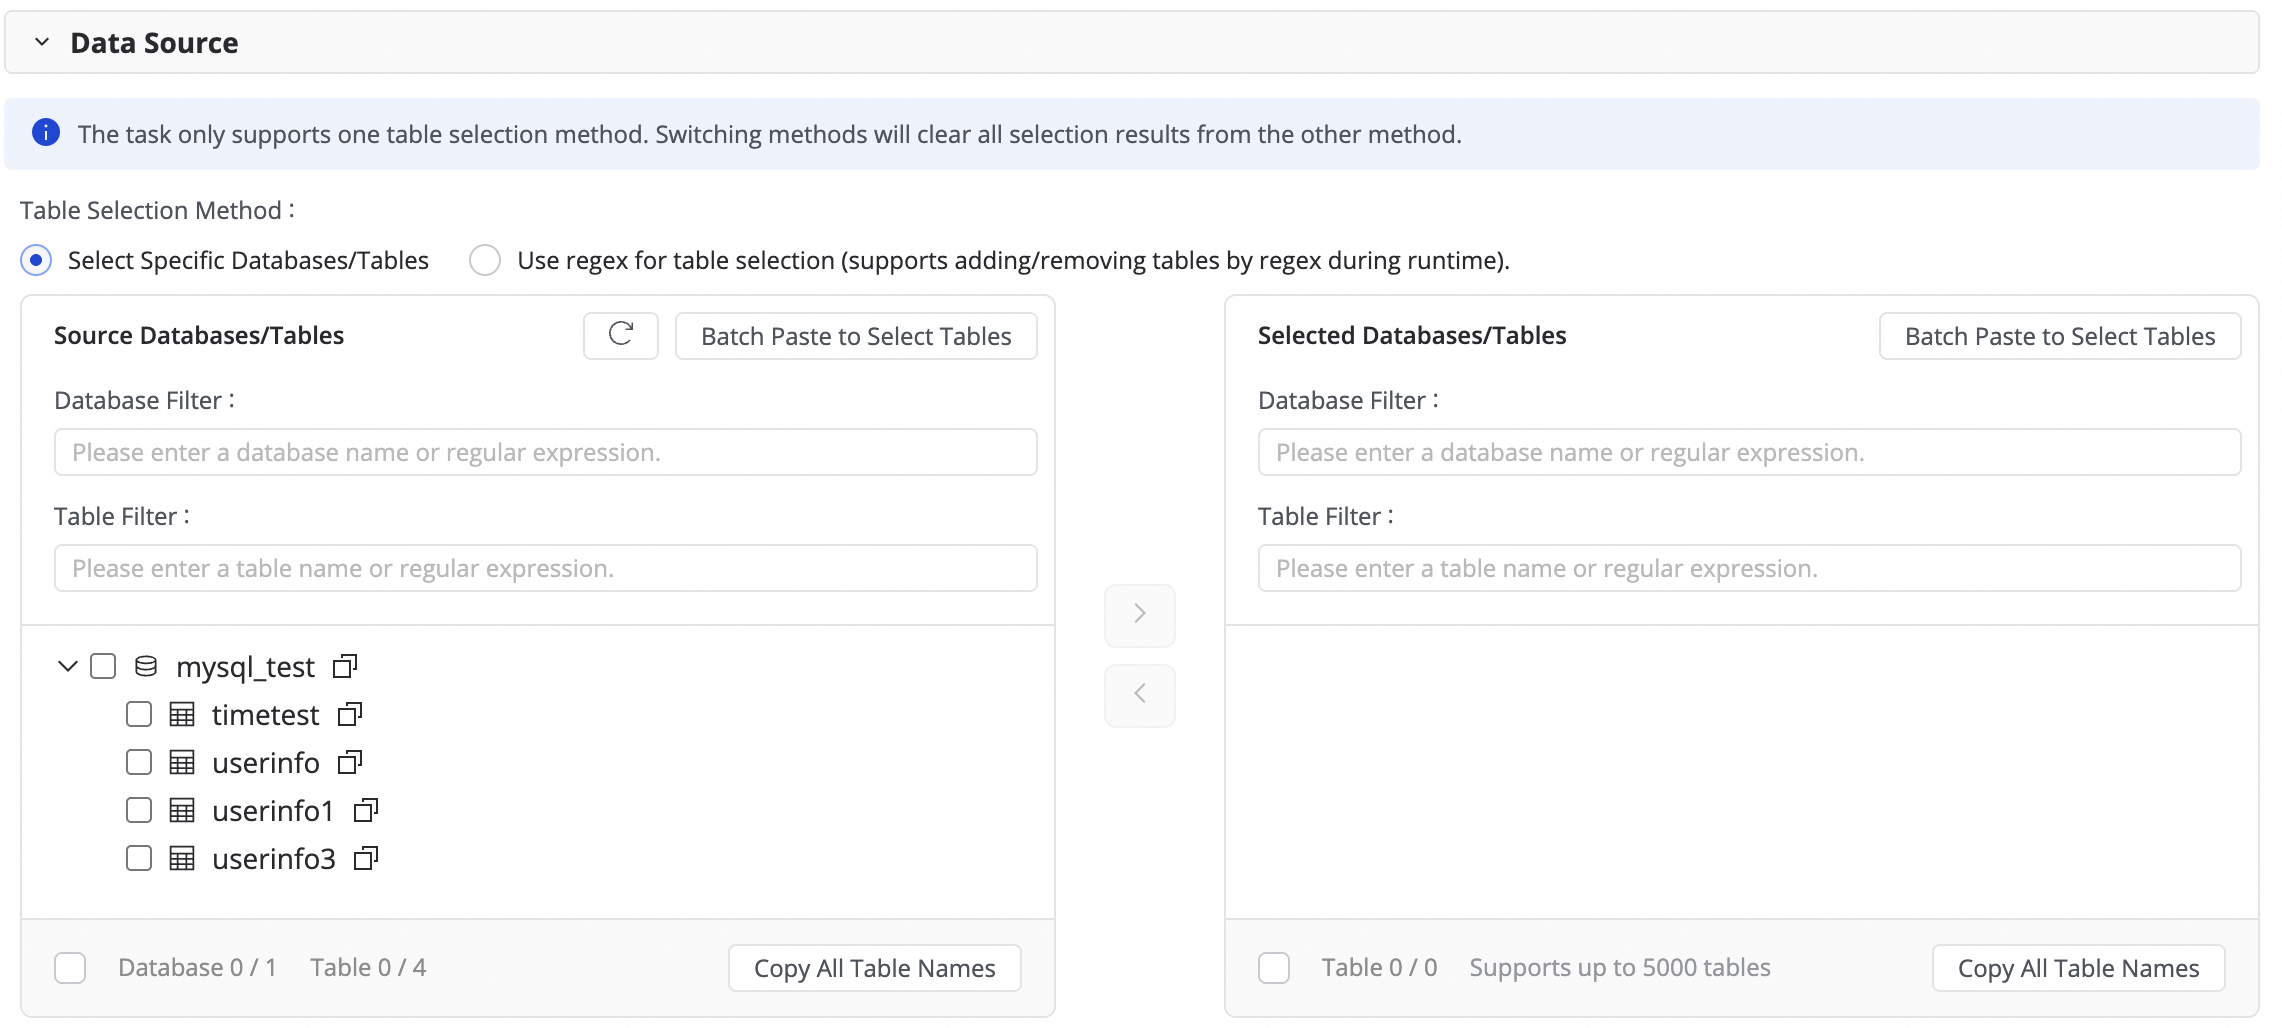
テーブル選択モードには、[指定したテーブルを選択] と [正規表現を使用してテーブルを選択] の 2 つがあります。 正規表現モードでは、タスクの実行中に一致するテーブルの追加と削除も行われます。 モードを切り替えると、もう一方のモードで選択したすべてのテーブルがクリアされます。 テーブルを一括で追加するには、右上隅の [テーブルの一括貼り付け] をクリックします。
多数のデータベースまたはテーブルがある場合は、ライブラリフィルター または テーブルフィルタ を使用し、正規表現を構成して同期するテーブルを選択できます。
2. 宛先
パーティション初期化設定 の横にある 設定 ボタンをクリックして、新しい宛先テーブルのパーティションを均一に初期化します。 ここで行った変更は、すべての新しい宛先テーブルに適用され、既存のテーブルには影響しません。
3. フルおよび増分制御
タスクの実行頻度を設定します。
「フル同期」または「増分同期」を選択した場合、タスクをワンタイムタスクまたは定期的タスクとして実行するかを選択できます。
「フル同期」と「増分同期」の両方を選択した場合、システムは「初回実行時はワンタイムのフル同期、その後は定期的な増分同期」という組み込みモードを使用します。 このオプションは変更できません。
同期ステップ
フルおよび増分制御
動作
ユースケース
フル同期
ワンタイム
タスクが開始されると、ソーステーブルからすべてのデータを一度に同期し、宛先テーブルまたは指定されたパーティションに書き込みます。
データ初期化、システム移行
定期的
設定されたスケジューリングサイクルに基づいて、ソーステーブルから宛先テーブルまたは指定されたパーティションへ定期的にすべてのデータを同期します。
データリコンシリエーション、T+1 フルスナップショット
増分同期
ワンタイム
タスクが開始されると、定義した増分条件に基づいて、増分データを一度だけ同期し、指定されたパーティションに書き込みます。
特定のデータバッチの手動修復
定期的
タスクが開始されると、設定されたスケジューリングサイクルと増分条件に基づいて、定期的に増分データを同期し、指定されたパーティションに書き込みます。
日次 ETL、履歴テーブルの構築
フル同期と増分同期
(組み込みモード、選択不可)
初回実行:ワンタイムのスキーマ移行と履歴データのフル同期を自動的に実行します。
後続の実行:設定されたスケジューリングサイクルと増分条件に基づいて、定期的に増分データを同期し、指定されたパーティションに書き込みます。
データウェアハウスまたはデータレイクへのワンクリックデータインジェスト
説明バッチデータベース同期の場合、システムは [デプロイ後すぐに開始] に設定されたタスクと同様の方法で定期タスクのインスタンスを生成します。 詳細については、「インスタンス生成方法:デプロイ後すぐに開始」をご参照ください。
後続の[ターゲットテーブルのフィールドへの値割り当て]ステップでパーティション生成方法を定義できます。 定数を使用するか、システムで事前定義された変数とスケジューリングパラメーターを使用してパーティションを動的に生成できます。
スケジューリングサイクル、増分条件、パーティション生成方法の設定は相互に依存します。 詳細については、「6. 増分条件」をご参照ください。
スケジューリングパラメーターを設定します。
タスクに定期的な同期が含まれる場合は、定期スケジュールのパラメーター をクリックして設定します。 これらのパラメーターは、後でターゲットテーブルマッピングで増分条件とフィールド値の割り当てを設定するときに使用できます。
4. ターゲットテーブルマッピング
ソーステーブルと宛先テーブル間のマッピングルールを定義し、定期設定と増分条件を通じてデータ書き込み方法を指定します。
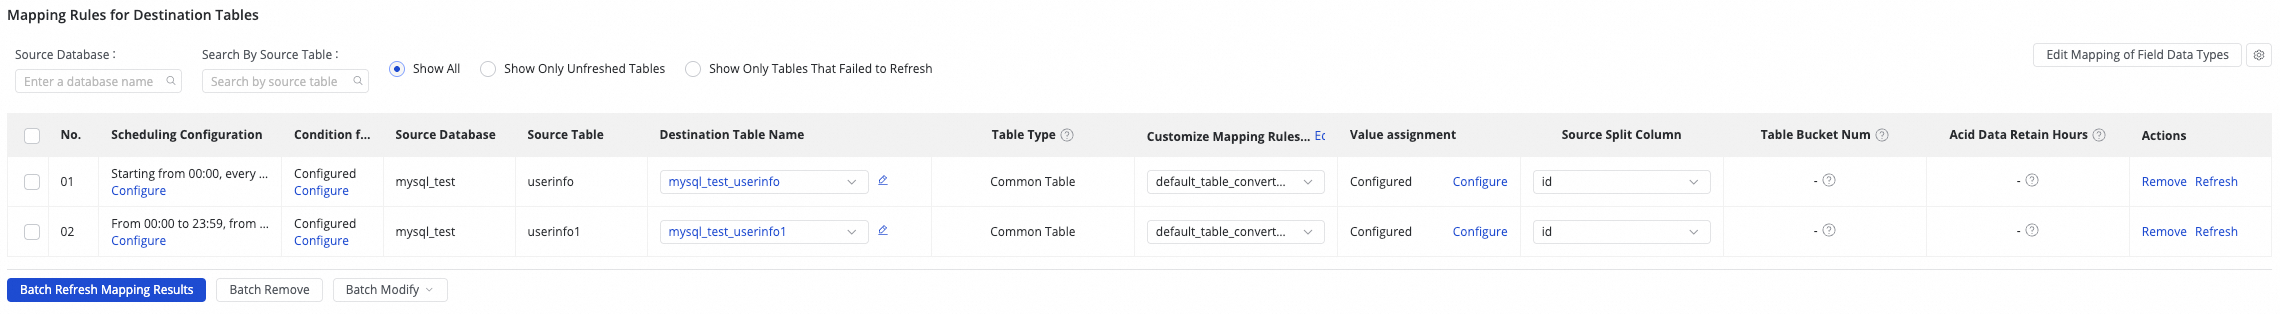
ページの上部には、[データベース名の検索] と [ソーステーブルの検索] の検索ボックスがあります。 このページには、[すべて表示]、[未更新のテーブルのみ表示]、[更新に失敗したテーブルのみ表示] のフィルターオプションもあります。 各行の [操作] 列には [削除] リンクが含まれています。 [一括削除] と [一括変更] ボタンはテーブルの下に表示されます。
操作 | 説明 | ||||||||||||
マッピングの更新 | システムは選択したソーステーブルを自動的に一覧表示しますが、宛先テーブルのプロパティを適用するにはマッピングを更新する必要があります。
| ||||||||||||
フィールドタイプマッピングの編集 (オプション) | ソースと宛先のフィールドタイプには、デフォルトのマッピングが用意されています。 右上隅の フィールド型マッピングの編集 をクリックして、マッピングをカスタマイズできます。 設定後、マッピングの適用とパージ をクリックします。 フィールドタイプのマッピングを編集する際は、変換ルールが正しいことを確認してください。 そうしないと、型変換が失敗し、ダーティデータが発生してタスクの実行に影響を与える可能性があります。 | ||||||||||||
宛先テーブル名マッピングのカスタマイズ (オプション) | システムには、
この機能は、次のシナリオをサポートしています。
| ||||||||||||
宛先データベース名マッピングのカスタマイズ (オプション) | Hologres などの一部の宛先データソースでは、宛先データベースのマッピングルールを定義できます。 設定方法は宛先テーブル名マッピングのカスタマイズと同じです。 | ||||||||||||
宛先スキーマ名マッピングのカスタマイズ (オプション) | Hologres などの一部の宛先データソースでは、宛先スキーマのマッピングルールを定義できます。 設定方法は宛先テーブル名マッピングのカスタマイズと同じです。 | ||||||||||||
宛先テーブルスキーマの編集 (オプション) | システムはソーステーブルスキーマに基づいて宛先テーブルスキーマを自動的に生成します。 通常、変更する必要はありません。 特別な要件がある場合は、次のようにカスタマイズできます。
| ||||||||||||
宛先テーブルフィールドへの値の割り当て | パーティションフィールドと新しく追加されたフィールドには、手動で値を割り当てる必要があります。 標準フィールドは、ソーステーブルと宛先テーブルで名前が一致するものに基づいて自動的にマッピングされます。 次の手順に従ってください。
定数または変数を割り当てることができます。 [テーブルフィールド] と [パーティションフィールド] の 割り当て方式 で、次のタイプを切り替えることができます。
変数とスケジューリングパラメーターは両方とも、タスクのスケジュール実行時に、日付固有の値に自動的に置き換えられます。 | ||||||||||||
ソースシャーディング列の設定 | ソースシャーディング列では、ソーステーブルからフィールドを選択するか、チャンクしない を選択できます。 同期タスクの実行時に、DataWorks はこのフィールドに基づいてタスクを複数のサブタスクに分割し、データの並列バッチ読み取りを可能にします。 テーブルのプライマリーキーをソースシャーディング列として使用することを推奨します。 文字列、浮動小数点、日付型はサポートされていません。 現在、ソースシャーディング列は MySQL ソースでのみ使用できます。 | ||||||||||||
詳細パラメーターのカスタマイズ | これらのパラメーターを完全に理解している場合にのみ変更してください。 誤った設定は、タスクの遅延、リソースの競合、またはデータの損失を引き起こす可能性があります。 サブタスクごとに個別の[書き込み側設定]と[ランタイム設定]を設定できます。 | ||||||||||||
テーブルタイプ | テーブルタイプ:MaxCompute は、標準テーブル、PK Delta テーブル、Append Delta テーブルをサポートしています。 宛先テーブルのステータスが「作成予定」の場合、宛先テーブルスキーマの編集時にテーブルタイプを選択できます。 既存のテーブルのタイプは変更できません。 Delta テーブルの詳細については、「Delta テーブル」をご参照ください。 |
 ボタンをクリックし、手動入力 と 組み込み変数 を組み合わせることで、宛先テーブル名を作成できます。 サポートされている変数には、ソースデータソース名、ソースデータベース名、ソーステーブル名が含まれます。


 ボタンをクリックしてフィールドを追加します。
 ツールチップで確認できます。
5. 定期設定
増分同期が定期実行として設定されている場合、宛先テーブルの定期設定を完了する必要があります。 これには、[スケジューリング周期]、[スケジュール時刻]、[リソースグループのスケジューリング]などの設定が含まれます。 この同期タスクのスケジューリング設定は、DataStudio のノードスケジューリング設定と一貫しています。 パラメーターの詳細については、「ノードスケジューリングの設定」をご参照ください。
ワンタイム同期に多数のテーブルが含まれる場合は、タスクの滞留とリソースの競合を防ぐために、スケジュールで実行時間をずらすことを推奨します。
6. 増分条件
タスクが増分データを同期する必要がある場合は、増分条件を設定する必要があります。 この条件により、スケジュール実行される各インスタンスがどのデータを同期するかが決まります。
機能と構文
機能:増分条件は、ソースデータをフィルタリングするための
WHERE句です。構文:設定時には、
WHEREキーワードに続く条件式のみを入力する必要があります。WHEREキーワード自体は含めないでください。
増分同期にスケジューリングパラメーターを使用する
定期的な増分同期を実現するために、増分条件でスケジューリングパラメーターを使用できます。 たとえば、条件を
STR_TO_DATE('${bizdate}', '%Y%m%d') <= columnName AND columnName < DATE_ADD(STR_TO_DATE('${bizdate}', '%Y%m%d'), INTERVAL 1 DAY)特定のパーティションへの書き込み
増分条件と宛先テーブルのパーティションフィールドを組み合わせることで、各バッチの増分データが正しいパーティションに書き込まれるようにします。
たとえば、前のステップの増分条件を使用して、パーティションフィールドを
ds=${bizdate}に設定し、宛先テーブルを日単位でパーティション分割するように設定できます。 これにより、各日次インスタンスはソース内の対応する日付のデータのみを同期し、それを宛先テーブルの一致するパーティションに書き込みます。
増分条件で指定された時間範囲、パーティション生成の時間間隔、および定期設定のスケジューリングサイクルを適切に組み合わせることで、ビジネスルールと物理パーティションが厳密に一致した自動化された T+n 増分 ETL パイプラインを作成できます。
バッチデータベース同期タスクで例外またはエラーが発生した場合 (たとえば、誤ったパーティションパラメーター設定によりデータが同期されない場合) 、まず [停止] をクリックしてタスクを完全に停止します。 次に、パーティションパラメーターまたは値の割り当て設定 (ソーステーブルのシャーディング列に関連する設定を含む) を修正してから、タスクを再発行して開始します。 タスクを直接再実行すると、タスクが不整合な状態に陥る可能性があるため、避けてください。
ステップ 4:詳細設定の構成
詳細パラメーター
カスタム同期要件に合わせてタスクを微調整するには、詳細パラメーターを変更します。
右上隅の [詳細設定] をクリックして、詳細パラメーター設定ページに移動します。
ツールチップに基づいてパラメーター値を変更します。 各パラメーターの意味は、その名前の横に説明されています。
タスクの同時実行数の調整など、自然言語の指示を入力して、AI 支援設定を使用することもできます。 AI モデルは推奨パラメーター値を生成し、それを確認して適用できます。
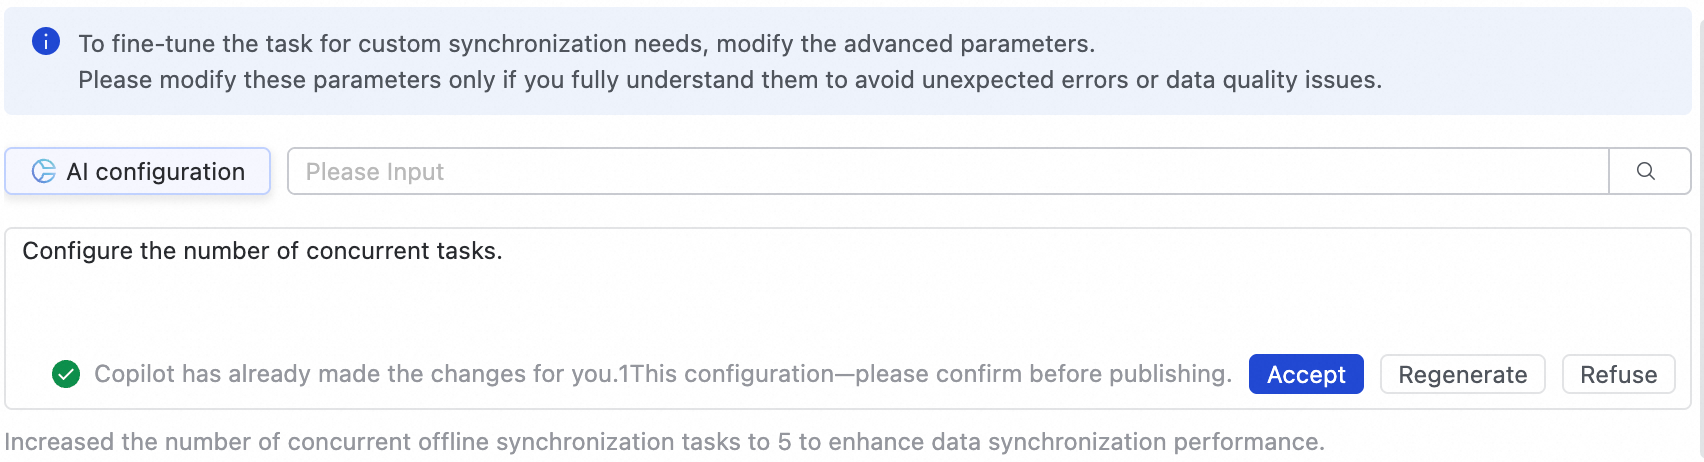
これらのパラメーターを完全に理解している場合にのみ変更してください。 誤った設定は、タスクの遅延、リソースの競合、またはデータの損失を引き起こす可能性があります。
エンジンパラメーター
通常、エンジンパラメーターを設定する必要はありません。 変更が必要な場合は、テクニカルサポートのガイダンスに従ってのみ使用してください。
ステップ 5:タスクのデプロイと実行
すべての設定が完了したら、ページ下部の 保存 をクリックしてタスクの設定を完了します。
バッチ同期タスクを直接デバッグすることはできません。 実行するには、[オペレーションセンター]に[発行]する必要があります。 したがって、新規作成または編集したタスクは、変更を有効にするためにデプロイする必要があります。
デプロイ中に 公開後すぐに起動 を選択すると、タスクは自動的に開始されます。 それ以外の場合は、デプロイが完了した後、 ページに移動し、[操作] 列からタスクを手動で開始します。
タスク一覧 リストで、対象タスクの 名前 / ID をクリックして、詳細な実行プロセスを表示します。
デプロイ後に [開始] をクリックしても応答がない場合、または進行状況バーが更新されない場合は、まずオペレーションセンターで対応するサブタスクの実行ログを確認して、具体的なエラー詳細を取得してください。 また、デプロイ中に 公開後すぐに起動 を選択したか、またはデプロイ後に [操作] 列から手動で [開始] をクリックしたかを確認します。
ステップ 6:アラートルールの設定
バッチデータベース同期タスクのアラートルールは、オペレーションセンターの対応するサブタスクで設定する必要があります。
ページで、対象タスクの[タスクID] を取得します。
列で、統合タスクの ID に基づいて対応するフルデータベースオフラインサブタスクを見つけ (たとえば、統合タスク ID が
34862の場合、増分同期自動トリガーサブタスクはoffline_odps_cyc_sync_mysql_test_timetest_to_mysql_test_timetest_34862という名前になります) 、 をクリックしてルール管理ページに移動します。カスタムルールの作成 をクリックし、ルールオブジェクト、トリガー方式、アラーム動作 を設定します。 詳細については、「ルール管理」をご参照ください。
ルールオブジェクト で取得したサブタスク ID を検索して、対象タスクを見つけ、アラートを設定できます。
同期タスクの管理
タスクの編集
ページで、作成した同期タスクを見つけます。 操作 列で もっと見る をクリックし、次に 編集 をクリックしてタスク情報を変更します。 手順はタスク設定と同じです。
実行中でないタスクについては、設定を直接変更し、保存してデプロイすることで変更が有効になります。
実行中のタスクについては、公開後すぐに起動 を選択せずに編集してデプロイすると、元のアクションボタンが アプリケーションの更新 に変わります。 本番環境で変更を有効にするには、このボタンをクリックする必要があります。
[更新の適用] をクリックすると、システムは変更を適用するために [停止]、[デプロイ]、[再起動] の 3 つのステップを実行します。
テーブルを追加した場合:
[更新の適用] をクリックすると、新しいテーブルの同期サブタスクが追加されます。 タスクのスキーマ移行とワンタイムフル同期がすぐに開始され、その後、スケジュールに従って増分同期が行われます。
宛先テーブルを切り替えた場合 (古いテーブルを削除して新しいテーブルを追加するのに相当します):
[更新の適用] をクリックすると、古いテーブルのサブタスクが削除され、新しいサブタスクが作成され、新しいタスクのスキーマ移行とワンタイムフル同期がすぐに開始されます。 その後、新しいタスクはスケジュールに従って増分同期を実行します。
他の情報が変更された場合:
テーブルのスキーマ移行とワンタイムフル同期は変更されません。 今後生成される増分同期のインスタンスは更新された設定を使用しますが、すでに生成されたインスタンスは影響を受けません。
変更されていないテーブルは影響を受けず、再実行されません。
タスクの表示
同期タスクを作成した後、同期タスクページでタスクリストと基本情報を表示します。

各タスクについて、同期タスクリストにはタスク名、タスク ID、データソースと[宛先データソース]、タスクタイプ、ステータスが表示されます。 次の列には、スキーマ移行、フル同期、増分同期のサブタスクステージのステータスが表示され、その後にグループが表示されます。
[操作] 列では、同期タスクを[起動]または[停止]できます。 [その他] メニューでは、[編集]や[詳細]などの操作を実行できます。
実行中のタスクについては、実行概要 で基本的なステータスを確認できます。 対応する概要領域をクリックして、実行の詳細を表示することもできます。
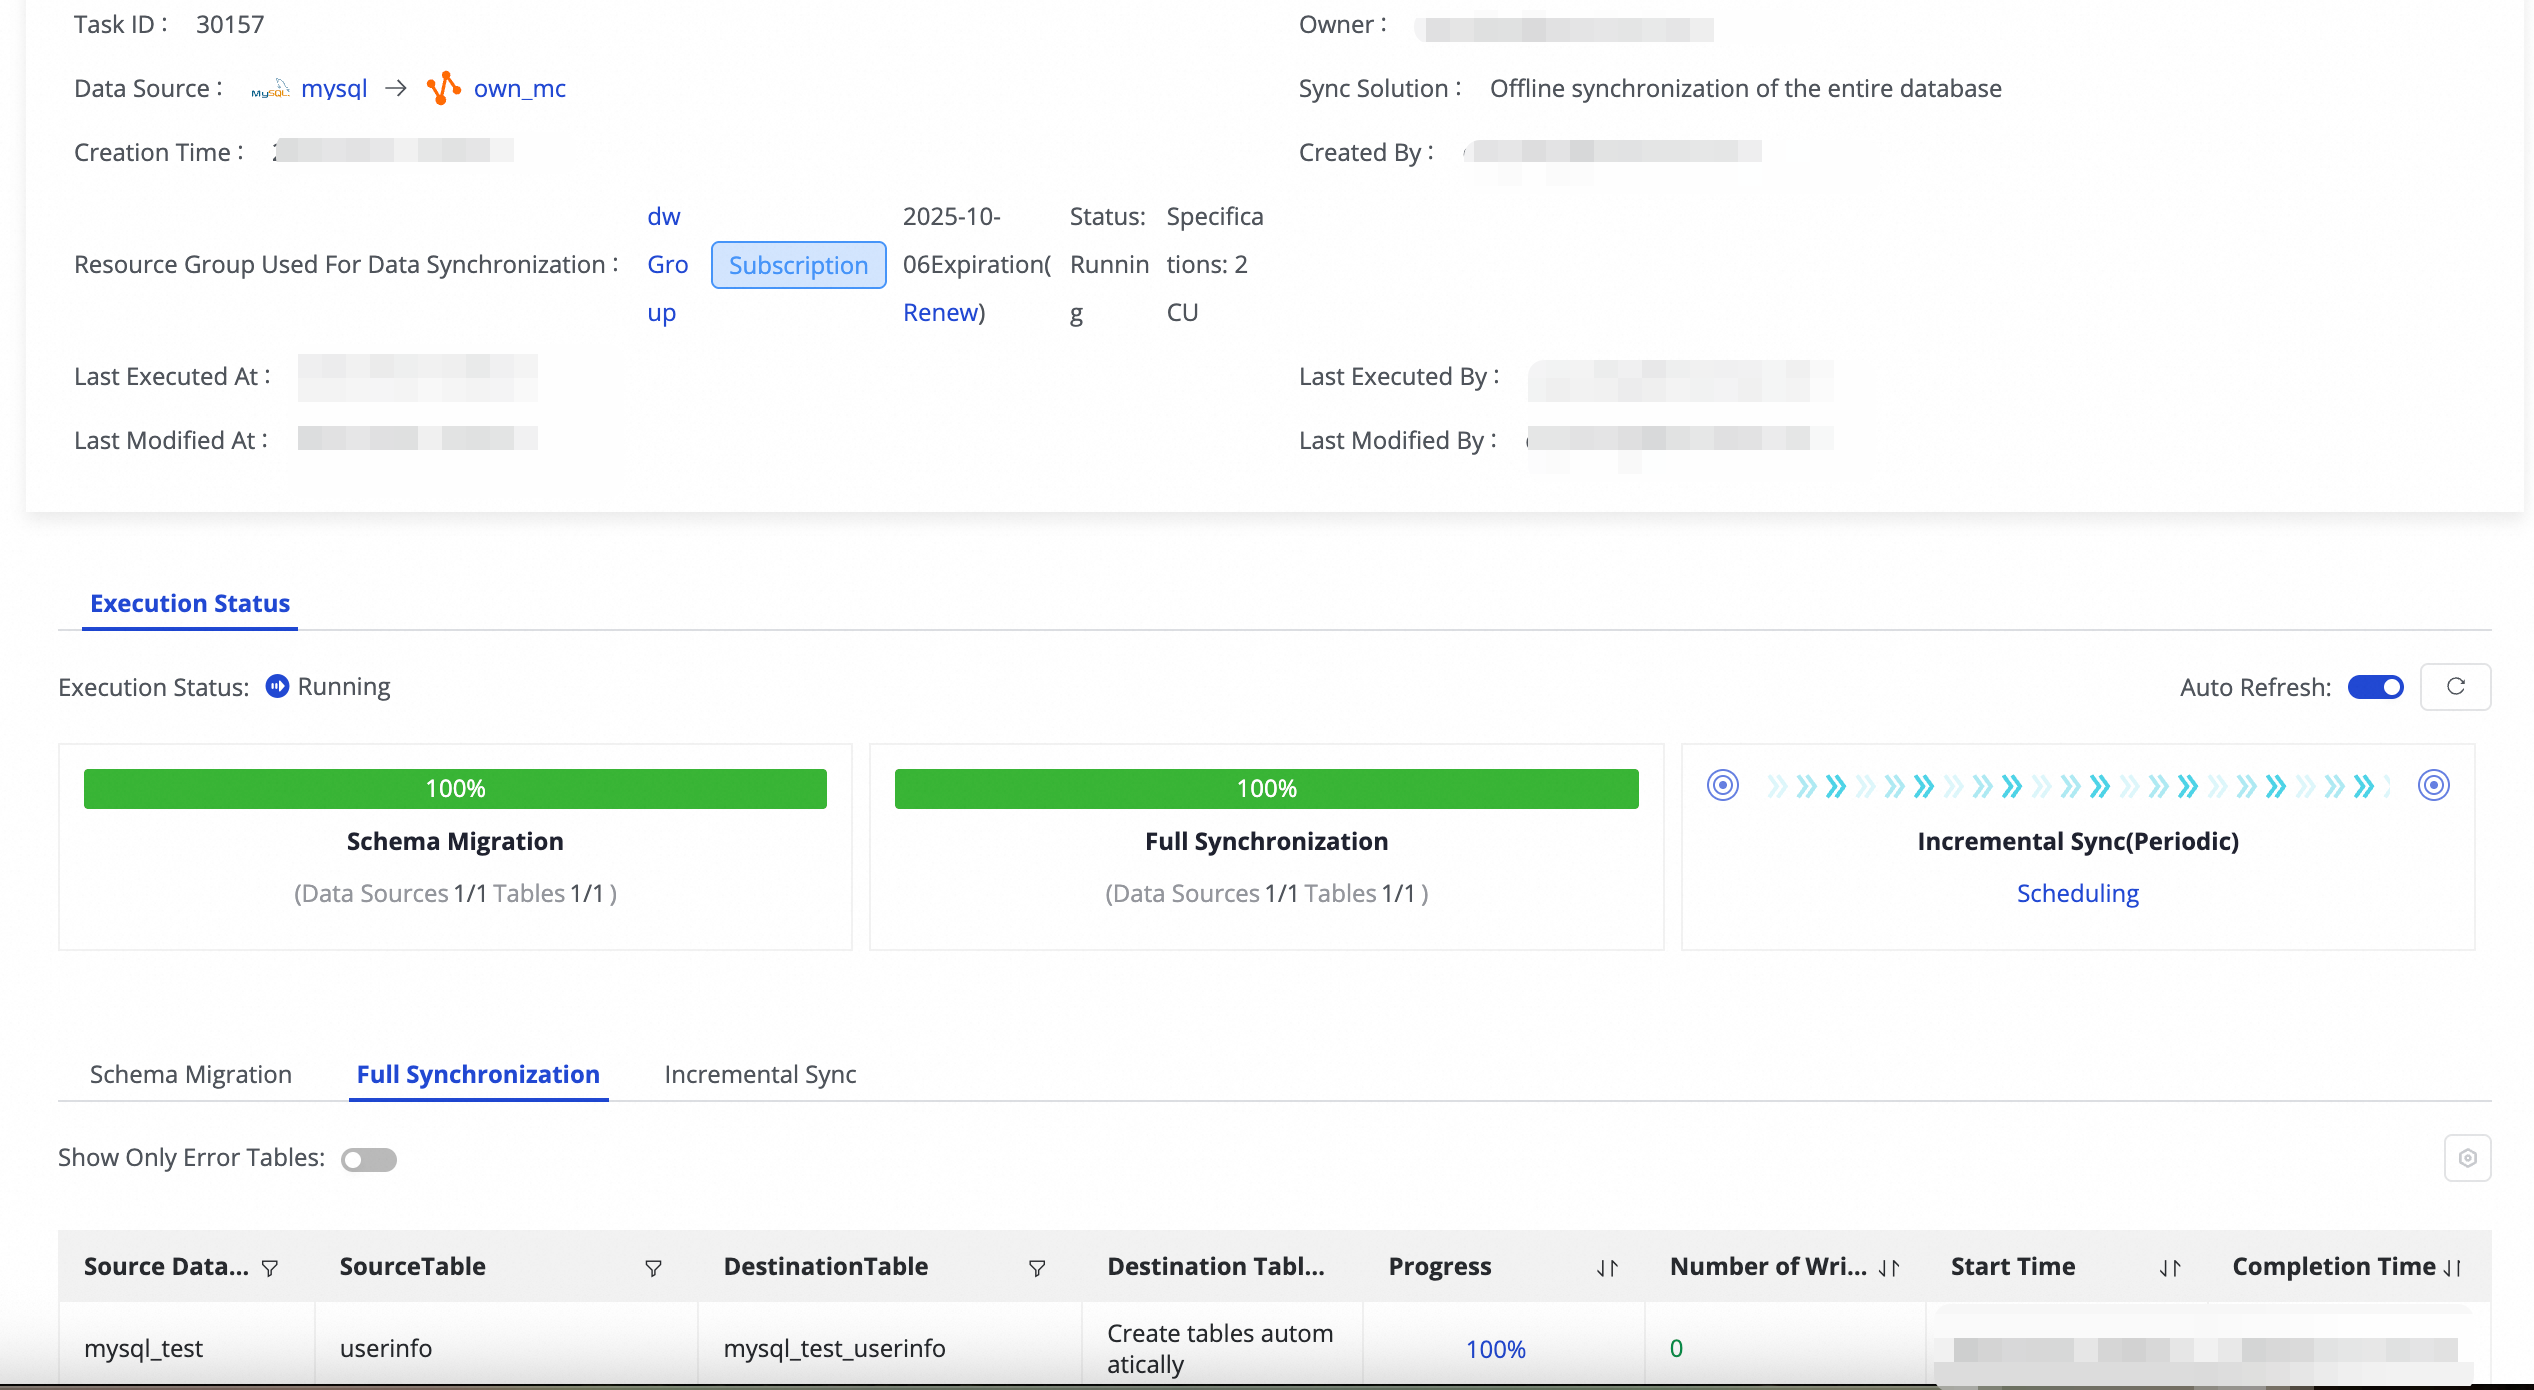
タスク詳細ページの[基本情報] セクションには、タスク ID、データソース、同期ソリューション、同期リソースグループ、ステータス、仕様が表示されます。 [実行ステータス] セクションでは、プログレスバーを使用してスキーマ移行、フル同期、増分同期の各ステージの進行状況と完了率が表示されます。 ステージタブをクリックして、各テーブルの同期詳細を表示します。 詳細には、ソースデータベース、ソーステーブル、宛先テーブル、接続方法、進行状況、書き込まれたレコード数が含まれます。
クォータと制限事項
デバッグの制限:Data Integration または DataStudio でバッチ同期タスクを直接デバッグすることはできません。 実行するには、オペレーションセンターにデプロイする必要があります。
シャーディング列の制限: [ソースシャーディング列の設定] 機能は現在、MySQL ソースのみをサポートします。 シャーディング列フィールドは数値型である必要があります。文字列、浮動小数点、日付型はサポートされていません。
スキーマ変更の制限: 宛先テーブルスキーマを編集する際、列の名前変更はサポートされていません。 既存の宛先テーブルの場合、そのテーブルタイプを変更することはできません。
フィールドレベル操作の制限:特定のフィールド (XML 形式のフィールドなど) の削除、フィルタリング、スキップはサポートされておらず、カスタムフィールドマッピングもサポートされていません。 フィールドを削除したり、複雑な変換を適用したりする必要がある場合は、代わりに単一テーブルのオフライン同期タスクを使用するか、コードノード (Spark または Python) でデータを処理してください。
大文字と小文字の区別の制限:デフォルトでは、テーブル名とフィールド名は小文字に変換されて宛先に書き込まれるため、大文字と小文字を区別する転送 (PostgreSQL など) はサポートされていません。 ソースに大文字と小文字を区別するテーブルが含まれているために同期が失敗した場合は、ソーステーブル名を小文字に名前変更するか、代わりに単一テーブルのオフライン同期を使用することを推奨します。
メタデータ説明の制限:ソーステーブルの説明を直接表示したり、宛先にマッピングしたりすることはできません。 新しい宛先テーブルを作成するときにのみ、フィールドの説明を手動で設定できます。
次のステップ
タスクが開始された後、タスク名をクリックして実行の詳細を表示し、運用保守 (O&M) とチューニングを実行します。
よくある質問
バッチデータベース同期タスクに関するよくある質問については、「フル同期タスクと増分同期タスクに関する FAQ」をご参照ください。
Q:バッチデータベース同期タスクで単一テーブルの同期に失敗した場合、他のテーブルに影響はありますか?
A:Data Integration タスク内のテーブル間にアップストリームまたはダウンストリームの依存関係がない場合、1 つのテーブルの同期が失敗しても、他のテーブルの同期には影響しません。 その特定のテーブルのサブタスクのみが失敗し、他のテーブルは正常に実行され続けます。
Q:バッチデータベース同期 (オフライン) タスクで、ソーステーブルに追加されたフィールドが宛先テーブルに同期されない場合はどうすればよいですか?
A:バッチデータベース同期 (オフライン) は、ソースでの DDL 変更を自動的に検出しません。 したがって、追加されたソースフィールドは宛先に自動的に反映されません。 追加されたフィールドを同期するには、まず宛先テーブルを削除します。 次に、タスク編集ページでターゲットテーブルマッピングに移動し、[マッピングの一括更新] をクリックしてソーステーブルスキーマを再ロードし、フル同期を再実行します。 業務上、追加されたソースフィールドの自動同期が必要な場合は、代わりにリアルタイムのバッチデータベース同期を使用してください。 その詳細設定には [DDLサポート設定] があり、テーブルの作成、テーブルの削除、列の追加、列の削除、テーブルの名前変更、列の名前変更、列のタイプの変更、テーブルの切り捨てといった DDL イベントの処理ポリシーを設定できます。 列の追加イベントは、デフォルトで正常に処理されます。
その他のユースケース
「バッチデータベース同期のユースケース」をご参照ください。