診断チェックと AI 支援の根本原因分析で、ノードの問題を特定して解決します。
ノード診断が実行されると、ACK は各ノードからシステムバージョン、ワークロード、Docker、kubelet のステータス、および主要なシステムログエラーを収集します。
ノード診断は 2 つのコンポーネントから構成されます:
診断項目: ノード、ノードコンポーネント、クラスターコンポーネント、Elastic Compute Service (ECS) の controller manager、および GPU アクセラレーションノードを診断します。
根本原因: クラスターとノードのデータを収集し、異常を検出し、詳細な分析を実施することで、根本原因を特定して修正を提案します。
仕組み
ノード診断は、エキスパートの経験に基づく障害診断システムと、大量のデータで学習した AI 障害診断モデルを基盤に構築されています。エキスパートの経験と AI 支援診断の 2 つの診断モードを融合し、根本原因を詳細に特定します。
診断は、次の 4 つのステージで構成されます。
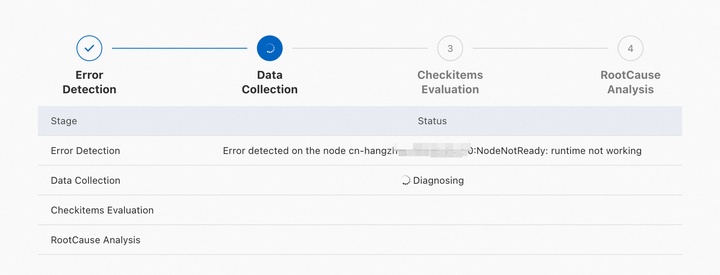
[異常の特定]:基本シグナル (ノードのステータス、Pod のステータス、クラスターイベントストリーム) を収集し、異常を特定します。
[データ収集]:特定した異常に基づいて、Kubernetes ノード情報、ECS インスタンスの詳細、Docker/kubelet のプロセスステータスなど、コンテキスト固有のデータを収集します。
[診断項目のチェック]:主要なメトリクスが正常範囲内にあるかどうかを確認します。項目はカテゴリ別にグループ化されており、それぞれに説明があります。
[根本原因分析]:一部の問題については、収集したデータとチェック結果に基づいて根本原因を自動的に特定します。
診断結果
結果は 2 種類に分かれます:
[根本原因分析結果]:検出された異常、特定された根本原因、および修正の提案が含まれます。
[診断項目のチェック結果]:項目ごとのチェック結果が含まれます。これにより、根本原因分析では見逃す可能性がある原因を明らかにできます。
診断項目はクラスター構成によって異なり、実際のクラスター設定を反映します。
ユースケース
ノード診断と AI 支援診断は、これらのシナリオに対応しています。
カテゴリ | シナリオ |
ノード診断 | Node NotReady:ネットワーク準備未完了、プロセス ID (PID) 不足、メモリ不足、ディスク領域不足、ランタイム例外、またはハートビート未検出 |
inode 不足 | |
Insufficient PIDs | |
不正確なノード時刻 | |
読み取り専用のノードファイルシステム | |
ノードカーネルのデッドロック | |
AI 支援診断 | ノードステータスの異常 |
ECS インスタンスステータスの異常 | |
ノード上の kubelet エラー | |
ノード上のランタイム例外 | |
ディスク領域不足 | |
ノードでの高い CPU 使用率 |
診断項目
カテゴリ | チェック内容 |
ノードステータス、ネットワークステータス、カーネルログ、コアプロセス、およびサービスの可用性 | |
主要なノードコンポーネント (ネットワークおよびストレージコンポーネントを含む) のステータス | |
API サービスの可用性、DNS の可用性、および NAT ゲートウェイステータス | |
ECS インスタンスステータス、ネットワーク接続、オペレーティングシステムの正常性、およびディスク I/O | |
GPU アクセラレーションノード上の NVIDIA モジュールステータスおよびコンテナランタイム設定 |
ノード
提案された修正を適用しても問題が解決しない場合は、ノードのログを収集して チケットを送信してください。
診断項目 | 検出内容 | 修正 |
Kubernetes API サーバーへの接続エラー | ノードがクラスターの API サーバーに到達できるかどうか。 | クラスター構成を確認してください。「ACK クラスターのトラブルシューティング」をご参照ください。 |
AUFS マウントのハング | ノードで AUFS マウントのハングが発生しているかどうか。 | チケットを送信してください。 |
BufferIOError | ノードカーネルに BufferIOError が存在するかどうか。 | チケットを送信してください。 |
Cgroup リーク | Cgroup リークが発生しているかどうか。 | Cgroup リークは、監視データの収集を中断させ、コンテナの起動失敗を引き起こす可能性があります。ノードにログインし、影響を受ける Cgroup ディレクトリを削除してください。 |
chronyd プロセスのステータス異常 | chronyd プロセスが正常に実行されているかどうか。chronyd プロセスが異常な場合、システムクロックの同期に影響を与える可能性があります。 |
|
containerd によるイメージのプル | containerd ランタイムが期待どおりにイメージをプルできるかどうか。 | ノードのネットワーク設定とイメージ設定を確認してください。 |
containerd のステータス | containerd ランタイムが実行中かどうか。 | チケットを送信してください。 |
CoreDNS Pod の可用性 | ノードが CoreDNS Pod の IP アドレスに到達できるかどうか。 | ノードが CoreDNS Pod の IP アドレスにアクセスできるか確認してください。「DNS クエリの負荷が CoreDNS Pod 間で分散されない場合の対処方法」をご参照ください。 |
イメージのステータス | イメージが破損していないかどうか。 | チケットを送信してください。 |
イメージの Overlay2 ステータス | イメージ内の overlay2 ファイルシステムが破損しているかどうか。 | チケットを送信してください。 |
システム時刻 | システムクロックが正確かどうか。 | なし。 |
Docker コンテナの起動 | Docker コンテナの起動に失敗しているかどうか。 | チケットを送信してください。 |
Docker イメージのプル | ノードが期待どおりに Docker イメージをプルできるかどうか。 | ノードのネットワーク設定とイメージ設定を確認してください。 |
Docker のステータス | Docker ランタイムが実行中かどうか。 | チケットを送信してください。 |
Docker の起動時間 | Dockerd の起動時間。 | なし。 |
Docker のハング | ノードで Docker のハングが発生しているかどうか。 |
|
ECS インスタンスの存在 | 基盤となる ECS インスタンスが存在するかどうか。 | ECS インスタンスのステータスを確認してください。「ノードとノードプールに関する FAQ」をご参照ください。 |
ECS インスタンスのステータス | ECS インスタンスが正常な状態であるかどうか。 | ECS インスタンスのステータスを確認してください。「ノードとノードプールに関する FAQ」をご参照ください。 |
Ext4FsError | ノードカーネルに Ext4FsError が存在するかどうか。 | チケットを送信してください。 |
読み取り専用のノードファイルシステム | ノードのファイルシステムが読み取り専用になったかどうか。これは通常、ディスクの障害を示し、すべての書き込み操作をブロックするため、ワークロードに影響します。 |
|
ハードウェアクロック | ハードウェアクロックとシステムクロックが同期しているかどうか。2 分を超える差があると、コンポーネントエラーが発生する可能性があります。 |
|
ノード DNS | ノードでドメイン名を解決できるかどうか。 | 「DNS のトラブルシューティング」をご参照ください。 |
カーネル oops | ノードカーネルに oops が存在するかどうか。 | チケットを送信してください。 |
カーネルバージョン | カーネルバージョンが古いかどうか。古いカーネルには、既知の安定性の問題がある場合があります。 | ノードカーネルを更新してください。「ノードとノードプールに関する FAQ」をご参照ください。 |
クラスター DNS の可用性 | ノードが、クラスターの DNS サービスを使用するために kube-dns Service のクラスター IP に到達できるかどうか。 | CoreDNS Pod のステータスとログを確認してください。「DNS のトラブルシューティング」をご参照ください。 |
kubelet のステータス | kubelet が正常に実行されているかどうか。 | kubelet のログを確認してください。「ACK クラスターのトラブルシューティング」をご参照ください。 |
kubelet の起動時間 | kubelet の起動時間。 | なし。 |
CPU 使用率 | ノードの CPU 使用率が過度に高いかどうか。 | なし。 |
メモリ使用率 | ノードのメモリ使用率が過度に高いかどうか。 | なし。 |
メモリの断片化 | ノードにメモリの断片化が存在するかどうか。 | ノードにログインし、 |
スワップメモリ | スワップメモリが有効になっているかどうか。 | ノードにログインし、スワップメモリを無効にしてください。 |
ネットワークデバイスドライバーの読み込み | ネットワークデバイス上の VirtIO ドライバーが正しく読み込まれているかどうか。 | チケットを送信してください。 |
ノードの過度に高い CPU 使用率 | 過去 1 週間にわたって CPU 使用率が高かったかどうか。CPU 使用率が一貫して高いノードに多数の Pod がスケジュールされると、リソース競合によってサービスが中断される可能性があります。 | ノードの過負荷を避けるために、リソースリクエストとリソースリミットを適切に設定してください。 |
プライベートノード IP の存在 | ノードにプライベート IP アドレスが割り当てられているかどうか。 | ノードをクラスターから削除し、再度追加してください。削除する際に ECS インスタンスを解放しないでください。「ノードの削除」および「既存の ECS インスタンスの追加」をご参照ください。 |
ノードの過度に高いメモリ使用率 | 過去 1 週間にわたってメモリ使用率が高かったかどうか。高いメモリ使用率と大量の Pod スケジューリングが組み合わさると、メモリ不足 (OOM) エラーやサービスの中断が発生する可能性があります。 | ノードの過負荷を避けるために、リソースリクエストとリソースリミットを適切に設定してください。 |
ノードステータス | ノードが Ready 状態であるかどうか。 | ノードを再起動してください。「ノードとノードプールに関する FAQ」をご参照ください。 |
ノードのスケジュール可否 | ノードがスケジュール不可としてマークされているかどうか。 | ノードのスケジューリング設定を確認してください。「ノードのドレインとスケジューリングステータス」をご参照ください。 |
OOM エラー | ノードでメモリ不足 (OOM) エラーが発生しているかどうか。 | チケットを送信してください。 |
ランタイムチェック | ノードのコンテナランタイムが、クラスターで設定されたランタイムと一致するかどうか。 | |
古い OS バージョン | ノードの OS バージョンに既知のバグや安定性の問題があるかどうか。古い OS バージョンは、Docker および containerd ランタイムの誤動作を引き起こす可能性があります。 | OS バージョンを更新してください。 |
インターネットアクセス | ノードがインターネットに到達できるかどうか。 | クラスターで SNAT が有効になっているかどうかを確認してください。「既存の ACK クラスターがインターネットにアクセスできるようにする」をご参照ください。 |
RCUStallError | ノードカーネルに RCUStallError が存在するかどうか。 | チケットを送信してください。 |
OS バージョン | ノードで使用されている OS バージョン。古い OS バージョンは、クラスターが正常に動作するのを妨げる可能性があります。 | なし。 |
runc プロセスリーク | runc プロセスリークが発生しているかどうか。runc プロセスリークは、ノードが定期的に NotReady 状態になる原因となる可能性があります。 | リークした runc プロセスを特定し、手動で終了させてください。 |
SoftLockupError | ノードカーネルに SoftLockupError が存在するかどうか。 | チケットを送信してください。 |
systemd のハング | systemd のハングが発生しているかどうか。 | ノードにログインし、 |
古い systemd バージョン | systemd のバージョンに既知のバグがあるかどうか。古いバージョンは、Docker および containerd の誤動作を引き起こす可能性があります。 | systemd のバージョンを更新してください。「systemd」をご参照ください。 |
ハングしたプロセス | ノードにハングしたプロセスが存在するかどうか。 | チケットを送信してください。 |
unregister_netdevice エラー | ノードカーネルに unregister_netdevice エラーが存在するかどうか。 | チケットを送信してください。 |
ノードコンポーネント
診断項目 | 検出内容 | 修正 |
CNI コンポーネントステータス | Container Network Interface (CNI) プラグインが期待どおりに実行されているかを確認します。 | クラスターのネットワークコンポーネントのステータスを確認してください。「ネットワーク管理に関するよくある質問」をご参照ください。 |
CSI コンポーネントステータス | Container Storage Interface (CSI) プラグインが期待どおりに実行されているかを確認します。 | クラスターのストレージコンポーネントのステータスを確認してください。「CSI に関するよくある質問」をご参照ください。 |
クラスターコンポーネント
診断項目 | 検出内容 | 修正 |
aliyun-acr-credential-helper のバージョン | aliyun-acr-credential-helper コンポーネントのバージョンが古いかどうかを確認します。 | aliyun-acr-credential-helper を更新します。詳細については、「Secret を使用せずにイメージをプルするための aliyun-acr-credential-helper コンポーネントの使用」をご参照ください。 |
API Service の可用性 | クラスターの API Service が利用可能かどうかを確認します。 |
|
利用可能な Pod CIDR ブロックの不足 | Flannel クラスターに残っている Pod CIDR ブロックが 5 未満かどうかを確認します。各ノードは 1 つのブロックを使用するため、ブロックがなくなると、新しいノードは正しく機能できません。 | チケットを送信してください。 |
CoreDNS の Endpoints | アクティブな CoreDNS の Endpoints の数を確認します。 | CoreDNS Pod のステータスとログを確認してください。詳細については、「DNS トラブルシューティング」をご参照ください。 |
CoreDNS の ClusterIP アドレス | クラスターの DNS Service に ClusterIP が割り当てられているかどうかを確認します。割り当てられていない場合、クラスターでの DNS 名前解決が失敗し、ワークロードに影響が出ます。 | CoreDNS Pod のステータスとログを確認してください。詳細については、「DNS トラブルシューティング」をご参照ください。 |
NAT ゲートウェイのステータス | クラスターの NAT ゲートウェイが正常に機能しているかどうかを確認します。 | NAT ゲートウェイコンソールにログオンし、料金滞納によりゲートウェイがロックされているかどうかを確認します。 |
NAT ゲートウェイでの同時接続ドロップの過度に高いレート | NAT ゲートウェイが異常に高いレートで同時接続をドロップしているかどうかを確認します。 | NAT ゲートウェイをアップグレードします。詳細については、「標準インターネット NAT ゲートウェイから拡張インターネット NAT ゲートウェイへのアップグレードに関するよくある質問」をご参照ください。 |
ECSControllerManager
診断項目 | 検出内容 | 修正方法 |
ECS インスタンスコンポーネントに関する料金滞納 | 料金滞納により、インスタンスのディスクまたはネットワーク帯域幅が制限されているかどうか。 | アカウントにチャージして、アクセスを復元してください。 |
ECS インスタンスに関する料金滞納 | 料金滞納により、従量課金 ECS インスタンスが停止されているかどうか。 | アカウントにチャージしてから、インスタンスを再起動してください。 |
ECS インスタンス NIC ステータス | インスタンスのネットワークインターフェイスカード (NIC) が正常に機能しているかどうか。 | インスタンスを再起動してください。 |
ECS インスタンス起動ステータス | インスタンスが正常に起動できるかどうか。 | 起動に失敗した場合は、新しいインスタンスを作成してください。 |
ECS インスタンスバックエンド管理システムのステータス | インスタンスのバックエンド管理システムが正常に動作しているかどうか。 | インスタンスを再起動してください。 |
ECS インスタンス CPU ステータス | インスタンスの基盤レイヤーで、CPU 競合または CPU バインディングの失敗が発生しているかどうか。 | CPU 競合により、インスタンスが CPU リソースを取得できなくなる可能性があります。インスタンスを再起動してください。 |
ECS インスタンスの CPU でのスプリットロック | ECS インスタンスの CPU でスプリットロックが発生しているかどうか。 | ECS インスタンスの CPU でスプリットロックが発生しています。 |
ECS インスタンスの DDoS 対策ステータス | インスタンスのパブリック IP アドレスが DDoS 攻撃を受けているかどうか。 | DDoS 対策サービスを購入してください。詳細については、「Alibaba Cloud DDoS 対策ソリューションの比較」をご参照ください。 |
クラウドディスクの読み書き機能の制限 | クラウドディスクの読み書きスループットが制限されているかどうか。 | ディスクの読み書き頻度を減らすか、より高性能なクラウドディスクタイプにアップグレードしてください。クラウドディスクの読み書きパフォーマンスメトリクスの詳細については、「ブロックストレージのパフォーマンス」をご参照ください。 |
ECS インスタンスのディスクアタッチ | インスタンスの起動時にクラウドディスクをアタッチできるかどうか。 | インスタンスを停止してから、再度起動してください。 |
ECS インスタンスの有効期限切れ | サブスクリプションインスタンスの有効期限が切れているかどうか。 | インスタンスを更新してください。詳細については、「サブスクリプションインスタンスの更新」をご参照ください。 |
ECS インスタンス OS クラッシュ | 過去 48 時間以内に OS クラッシュが発生したかどうか。 | システムログを確認して原因を特定してください。詳細については、「システムログとスクリーンショットの表示」をご参照ください。 |
ECS インスタンスホストのステータス | インスタンスをホストしている物理サーバーで障害が発生しているかどうか。 | ホストの障害により、インスタンスのパフォーマンスが低下する可能性があります。インスタンスを再起動してください。 |
ECS インスタンスイメージの読み込み | 初期化時にインスタンスがイメージを読み込めるかどうか。 | インスタンスを再起動してください。 |
ECS インスタンスディスクでの I/O ハング | システムディスクで I/O ハングが発生しているかどうか。 | ディスクメトリクスを確認してください。詳細については、「クラウドディスクの監視データの表示」をご参照ください。Alibaba Cloud Linux 2 については、「ファイルシステムとブロックレイヤーの I/O ハングの検出」をご参照ください。 |
ECS インスタンスの帯域幅上限 | インスタンスの合計帯域幅が、そのインスタンスタイプの最大値に達しているかどうか。 | より帯域幅の広いインスタンスタイプにアップグレードしてください。詳細については、「インスタンス構成変更の概要」をご参照ください。 |
ECS インスタンスのバースト帯域幅の上限 | インスタンスのバースト帯域幅が、そのインスタンスタイプで許可されている最大値を超えているかどうか。 | より帯域幅の広いインスタンスタイプにアップグレードしてください。詳細については、「インスタンス構成変更の概要」をご参照ください。 |
ECS インスタンス NIC の読み込み | インスタンスに NIC を読み込めるかどうか。 | NIC の読み込みに失敗すると、インスタンスはネットワーク接続を失います。インスタンスを再起動してください。 |
ECS インスタンスでの NIC セッション確立 | NIC へのセッションを確立できるかどうか。 | NIC がセッションを確立できない場合、またはセッション制限に達した場合、ネットワーク接続またはスループットが影響を受けます。インスタンスを再起動してください。 |
ECS インスタンスでの主要な操作 | 起動、停止、アップグレードなど、インスタンスでの最近の操作が正常に完了したかどうか。 | 失敗した操作を再試行してください。 |
ECS インスタンス NIC でのパケット損失 | NIC でインバウンドまたはアウトバウンドのパケット損失が発生しているかどうか。 | インスタンスを再起動してください。 |
ECS インスタンスのパフォーマンス低下 (ソフトウェア/ハードウェア) | ソフトウェアまたはハードウェアの問題により、インスタンスのパフォーマンスが一時的に低下しているかどうか。 | インスタンスの過去のイベントまたはシステムログを確認して、原因を特定してください。詳細については、「過去のシステムイベントの表示」をご参照ください。 |
ECS インスタンスのパフォーマンス低下 (CPU クレジット不足) | インスタンスのパフォーマンスが低下しているかどうか。 | 利用可能な CPU クレジットが不足しているため、ECS インスタンスはベースラインパフォーマンスしか提供できません。 |
ECS インスタンスディスクのサイズ変更 | ディスクのサイズが変更されたが、OS がまだファイルシステムを拡張していないかどうか。 | ディスクのサイズ変更後、OS がファイルシステムのサイズ変更に失敗したため、追加されたスペースは利用できません。ディスクのサイズを再度変更してください。 |
ECS インスタンスリソースの申請 | インスタンスに十分な物理 CPU およびメモリリソースが利用可能かどうか。 | 物理リソースが不足していると、インスタンスを起動できません。数分待ってから、インスタンスの起動を再試行してください。問題が解決しない場合は、別のリージョンまたはゾーンでインスタンスを作成してください。 |
ECS インスタンス OS ステータス | インスタンス OS でカーネルパニック、OOM エラー、または内部障害が発生したかどうか。 | このような障害は、多くの場合、インスタンス設定の誤りまたはユーザープログラムによって引き起こされます。インスタンスを再起動してください。 |
ECS インスタンスの仮想化ステータス | 基盤の仮想化レイヤーで例外が発生しているかどうか。 | このような例外により、インスタンスが応答しなくなったり、予期せず停止したりする可能性があります。インスタンスを再起動してください。 |
GPU ノード
診断項目 | 検出内容 | 修正 |
コンテナランタイム | GPU アクセラレーションノードのコンテナランタイムが有効かどうか。ACK は、GPU アクセラレーションノードでは Docker と containerd のみをサポートしています。 | ノードの Docker または containerd ランタイムのステータスを確認してください。 |
NVIDIA-Container-Runtime のバージョン | NVIDIA-Container-Runtime のバージョンがクラスターと互換性があるかどうか。 |
|
cGPU モジュールのステータス | GPU 共有が有効なノードで cGPU モジュールが期待どおりに実行されているかどうか。 |
|
コンテナランタイム設定 | GPU アクセラレーションノードのコンテナランタイムが正しく設定されているかどうか。設定を誤ると、GPU コンテナを実行できません。 | ランタイム設定ファイルで |
NVIDIA-Container-Runtime のステータス | NVIDIA-Container-Runtime が期待どおりに実行されているかどうか。 | 診断データを収集して チケットを送信してください。「GPU アクセラレーションノードから診断データを収集」をご参照ください。 |
NVIDIA モジュールのステータス | GPU アクセラレーションノードで NVIDIA カーネルモジュールが期待どおりに実行されているかどうか。NVIDIA モジュールが失敗すると、すべての GPU ワークロードを実行できなくなります。 |
|