Gunakan PAI untuk membangun model prediksi user churn secara cepat.
Latar Belakang
Membangun model prediksi user churn memungkinkan Anda mengidentifikasi pelanggan yang berpotensi churn dan mengambil langkah proaktif untuk mempertahankan mereka.
Solusi pemantauan churn tradisional umumnya berbasis aturan, sehingga tidak memiliki kemampuan prediksi cerdas dan berisiko gagal mengidentifikasi pengguna berisiko secara akurat.
Solusi
PAI menyediakan solusi lengkap untuk pengkodean fitur, pelatihan model klasifikasi, dan evaluasi model berdasarkan data berlabel. Persyaratannya sebagai berikut:
-
Keahlian: Pengetahuan dasar tentang pemodelan machine learning.
-
Siklus pengembangan: 1 hingga 2 hari.
-
Data: Set data berlabel dengan ribuan catatan yang menggambarkan karakteristik pelanggan yang telah churn.
Prasyarat
-
Anda telah mengaktifkan PAI dan membuat ruang kerja. Untuk informasi selengkapnya, lihat Aktifkan PAI dan buat ruang kerja default.
-
Ruang kerja telah dikaitkan dengan sumber daya MaxCompute. Untuk informasi selengkapnya, lihat Mulai cepat - Persiapan.
Set Data
Pipeline ini menggunakan set data anonim berdasarkan perilaku pelanggan nyata dari sektor telekomunikasi. Set data tersebut berisi 7.043 sampel, termasuk informasi dasar pengguna dan atribut churn. Data fitur mencakup bidang-bidang berikut.
|
Parameter |
Deskripsi |
|
customerid |
ID pelanggan. |
|
gender |
Jenis kelamin pelanggan. |
|
SeniorCitizen |
Menunjukkan apakah pelanggan merupakan warga senior. Nilai yang valid:
|
|
Partner |
Menunjukkan apakah pelanggan memiliki pasangan. |
|
Dependents |
Menunjukkan apakah pelanggan memiliki tanggungan. |
|
tenure |
Jumlah bulan pelanggan telah bergabung dengan perusahaan. |
|
PhoneService |
Menunjukkan apakah pelanggan berlangganan layanan telepon. |
|
MultipleLines |
Menunjukkan apakah pelanggan memiliki beberapa saluran. |
|
InternetService |
Penyedia layanan internet pelanggan. Misalnya, DSL atau Fiber optic. |
|
OnlineSecurity |
Menunjukkan apakah pelanggan berlangganan layanan keamanan online. |
|
OnlineBackup |
Menunjukkan apakah pelanggan menggunakan layanan backup online. |
|
DeviceProtection |
Menunjukkan apakah pelanggan memiliki layanan perlindungan perangkat. |
|
TechSupport |
Menunjukkan apakah pelanggan telah meminta dukungan teknis. |
|
StreamingTV |
Menunjukkan apakah pelanggan berlangganan layanan streaming TV. |
|
StreamingMovies |
Menunjukkan apakah pelanggan berlangganan layanan streaming film. |
|
Contract |
Jangka waktu kontrak. Misalnya, Month-to-month atau Two-year. |
|
PaperlessBilling |
Menunjukkan apakah pelanggan menggunakan penagihan tanpa kertas. |
|
PaymentMethod |
Metode pembayaran. |
|
MonthlyCharges |
Biaya bulanan. |
|
TotalCharges |
Total biaya. |
Data target mencakup bidang berikut.
|
Parameter |
Deskripsi |
|
churn |
Menunjukkan apakah pelanggan telah churn. |
Prosedur
Buka halaman Machine Learning Designer.
Masuk ke Konsol PAI.
Di panel navigasi sebelah kiri, klik Workspaces. Di halaman Workspaces, klik nama ruang kerja yang ingin Anda kelola.
Di panel navigasi sebelah kiri, pilih .
-
Bangun pipeline.
-
Di halaman Designer, klik tab Preset Templates.
-
Buka kategori Risk Control di bawah Business Area, temukan bagian Churn User Monitoring, lalu klik Create.
-
Di kotak dialog Create Pipeline, konfigurasikan parameter. Anda dapat menggunakan pengaturan default untuk semua parameter.
Parameter Data Storage menentukan path bucket OSS untuk menyimpan data temporary dan model yang dihasilkan selama eksekusi pipeline.
-
Klik Confirm.
Pembuatan pipeline memerlukan waktu sekitar 10 detik.
-
Di daftar pipeline, klik ganda pipeline Churn User Monitoring untuk membukanya di Kanvas.
-
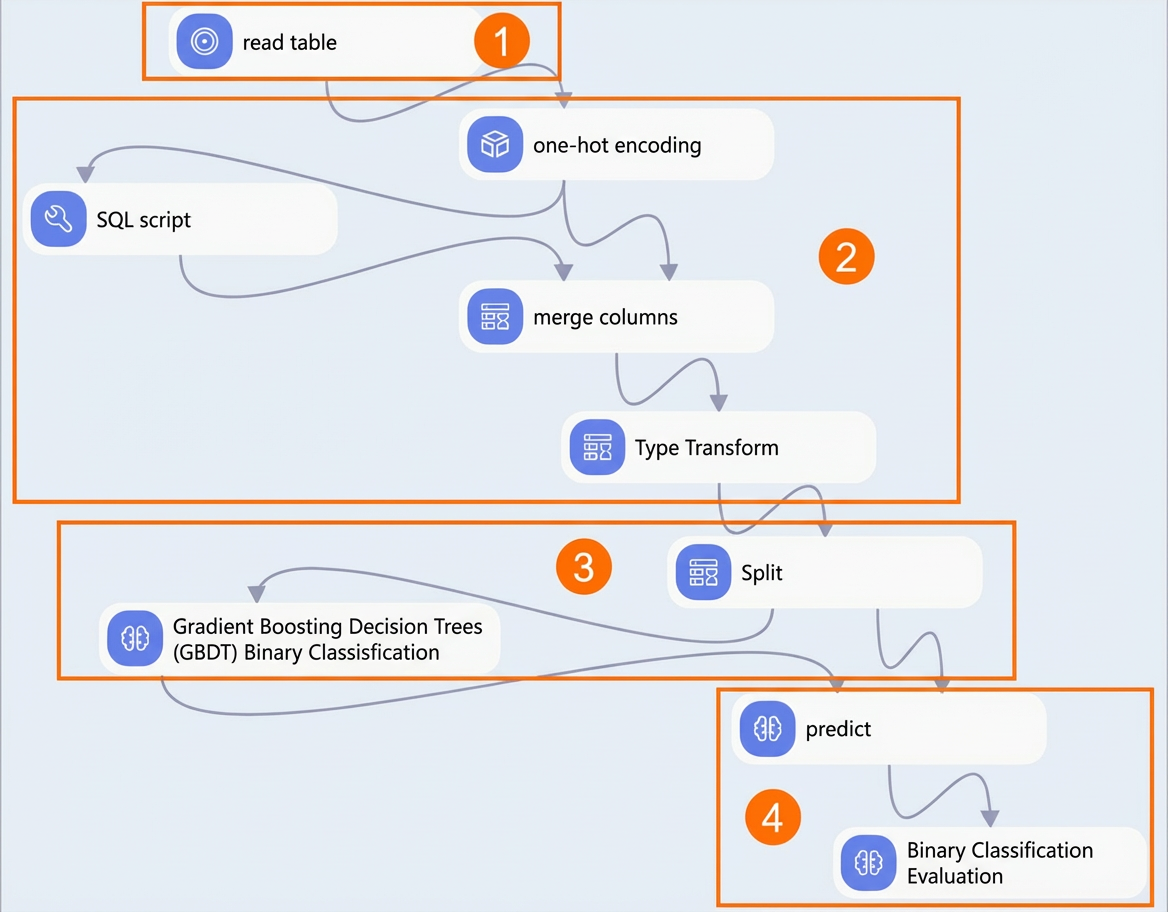
Sistem secara otomatis membangun pipeline berdasarkan template preset, seperti yang ditunjukkan pada gambar berikut.
Bagian
Deskripsi
①
Set data untuk pipeline.
②
Anda dapat menggunakan komponen One Hot Encoding dan SQL Script untuk melakukan rekayasa fitur dan mengonversi fitur bertipe string asli menjadi fitur numerik. Sebagai contoh, untuk bidang target churn yang memiliki nilai asli Yes atau No, Anda dapat menggunakan pernyataan SQL untuk mengonversi Yes menjadi 1 dan No menjadi 0, seperti pada contoh berikut.
select (case churn when 'Yes' then 1 else 0 end) as churn from ${t1};③
Data dibagi menjadi set data pelatihan dan set data prediksi. Karena pelanggan hanya dapat churn atau tidak churn, prediksi user churn merupakan masalah klasifikasi biner yang dapat diselesaikan dengan algoritma klasifikasi biner.
④
Komponen Binary Classification Evaluation memvalidasi model. Anda dapat mengevaluasi kinerjanya menggunakan metrik seperti AUC, nilai KS, dan Skor F1.
-
-
Jalankan pipeline dan lihat hasil model.
-
Di bagian atas Kanvas, klik Run.
-
Setelah eksekusi pipeline selesai, klik kanan komponen Binary Classification Evaluation di Kanvas, lalu pilih Visual Analysis dari menu pintasan.
-
Di kotak dialog Binary Classification Evaluation, klik tab Indicator Data untuk melihat metrik evaluasi model.
Metrik tersebut mencakup nilai KS, AUC, Skor F1, Negative Samples, Positive Samples, dan Total Samples. Nilai AUC yang lebih mendekati 1 menunjukkan akurasi prediksi yang lebih tinggi. Pada contoh ini, nilai AUC lebih besar dari 0,8, yang menunjukkan akurasi prediksi model yang tinggi.
-