Fitur prediksi kategori menggunakan model yang telah dilatih untuk mencocokkan kueri pencarian dengan kategori produk, lalu memberi peringkat lebih tinggi pada hasil dari kategori tersebut. Misalnya, kueri seperti "running shoes" dipetakan ke "Sports > Footwear", sehingga sepatu atletis muncul di atas hasil yang tidak relevan. Kueri seperti "denim" dipetakan ke "Clothing > Pants", sehingga celana jins diberi peringkat lebih tinggi dibanding barang rumah tangga bertema denim.
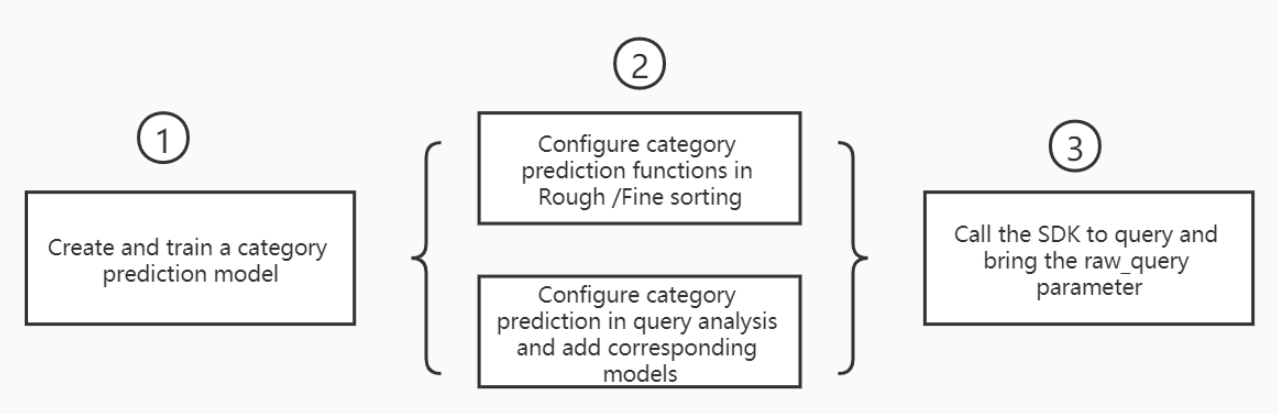
Untuk mengaktifkan prediksi kategori, lengkapi tiga konfigurasi berikut: buat dan latih model, konfigurasikan aturan analisis kueri yang mereferensikan model tersebut, serta tambahkan ekspresi pengurutan yang memanggil category_score.
Prasyarat
Sebelum memulai, pastikan Anda telah memiliki:
-
Bidang Category ID, commodity title, dan category name yang dikonfigurasikan sebagai bidang atribut dalam skema aplikasi Anda
-
(Jika menggunakan Commodity Data) Data dokumen yang berisi bidang category ID, commodity title, dan category name
-
(Jika menggunakan Behavior Data) Data perilaku klik yang dikumpulkan melalui data collection
Buat dan latih model prediksi kategori
-
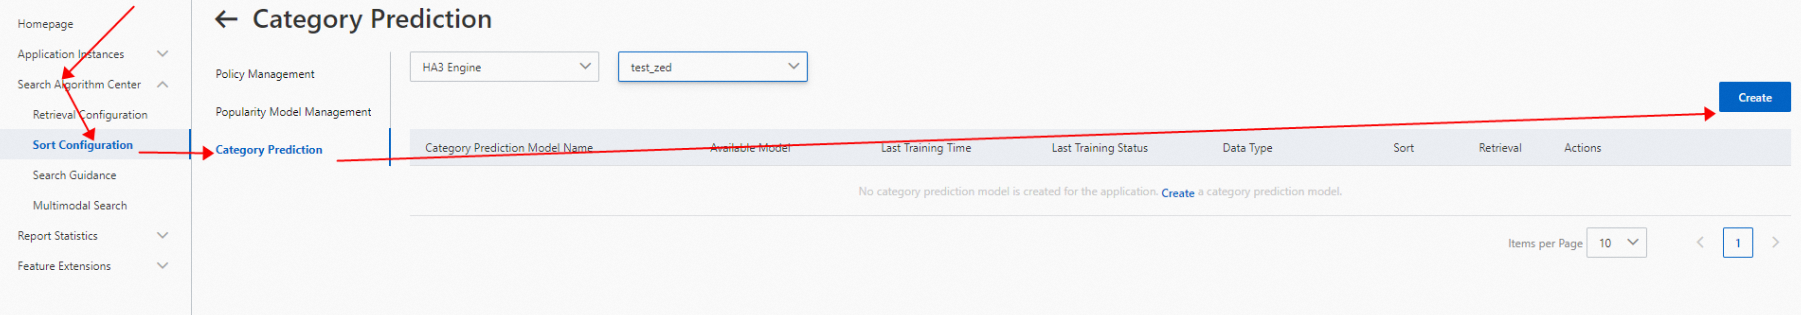
Di panel navigasi sebelah kiri, pilih Search Algorithm Center > Sort Configuration. Di pohon navigasi, klik Category Prediction Model, lalu klik Create.
-
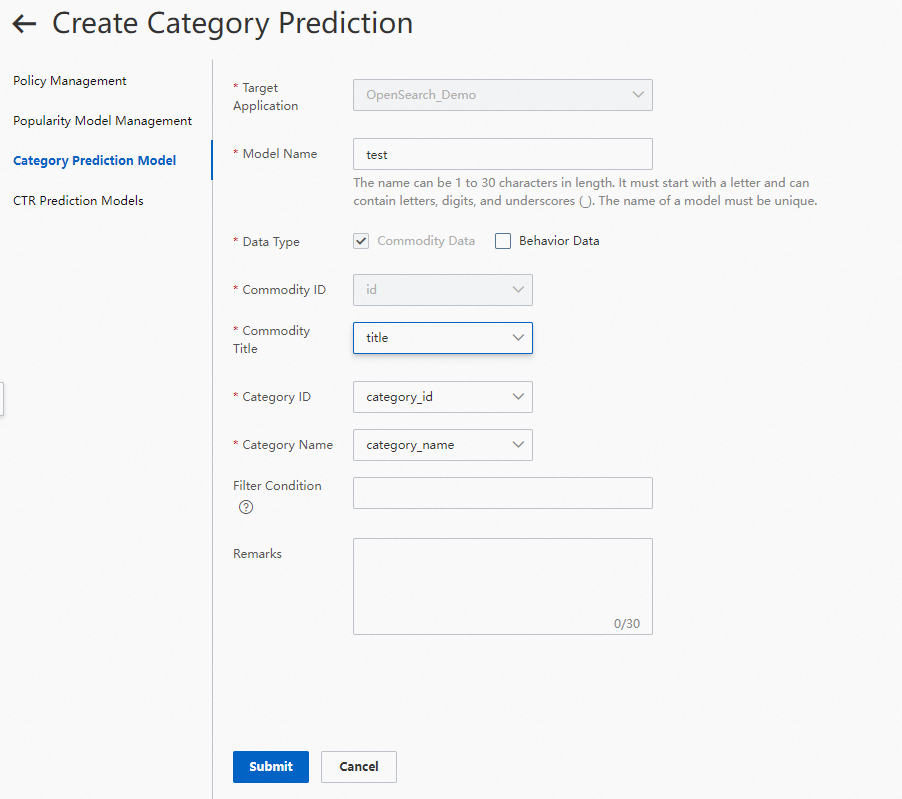
Di halaman Create Category Prediction, isi detail model.
Field
Description
Required
Model name
Nama untuk model
Yes
Data Type
Commodity Data: data dokumen dari aplikasi Anda. Memerlukan bidang category ID, commodity title, dan category name. Behavior Data: data perilaku klik yang dikumpulkan.
Yes
Category ID
Bidang yang merepresentasikan category ID dalam dokumen aplikasi Anda. Mendukung tipe data INT. Harus berupa bilangan bulat positif—nilai non-positif menyebabkan error server.
Yes
Commodity Title
Bidang yang merepresentasikan commodity title. Mendukung tipe data TEXT dan LITERAL.
Yes
Category Name
Bidang yang merepresentasikan category name. Mendukung tipe data TEXT dan LITERAL.
Yes
Filter Condition
Kondisi untuk memfilter data pelatihan. Nama bidang harus sesuai dengan yang ada di skema aplikasi. Mendukung:
<,>,<=,>=,=,!=. Pisahkan beberapa kondisi dengan koma (,)—semua kondisi menggunakan logika AND. Logika OR tidak didukung. Contoh:is_onsale > 0No
-
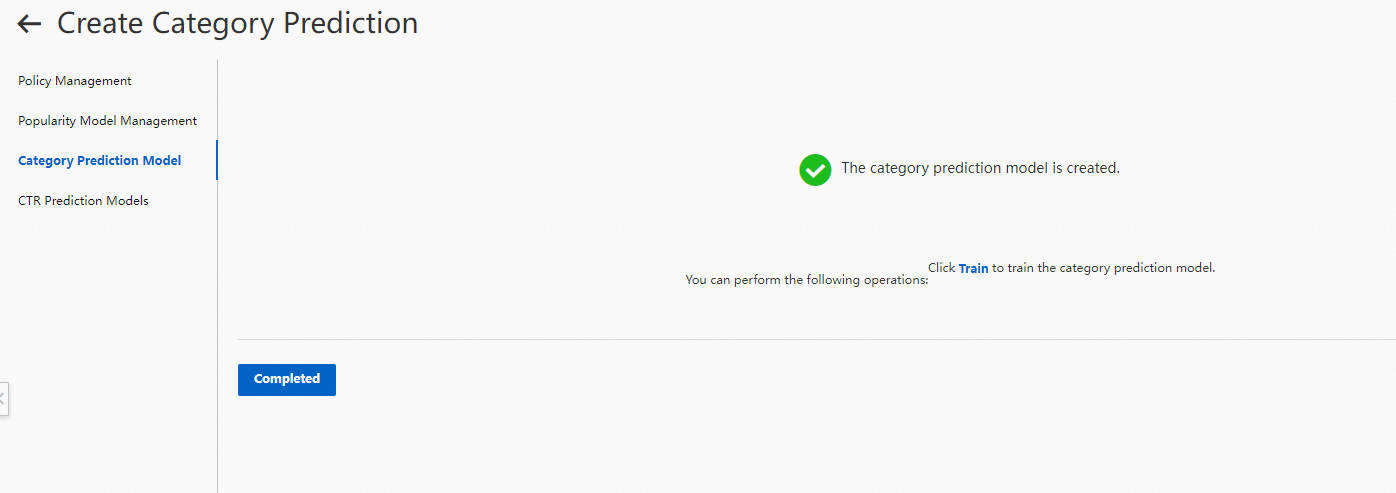
Klik Completed untuk menuju halaman detail model.
-
Di halaman Category Prediction Model, status model adalah Pending Training. Klik Train di kolom Actions untuk memulai pelatihan.
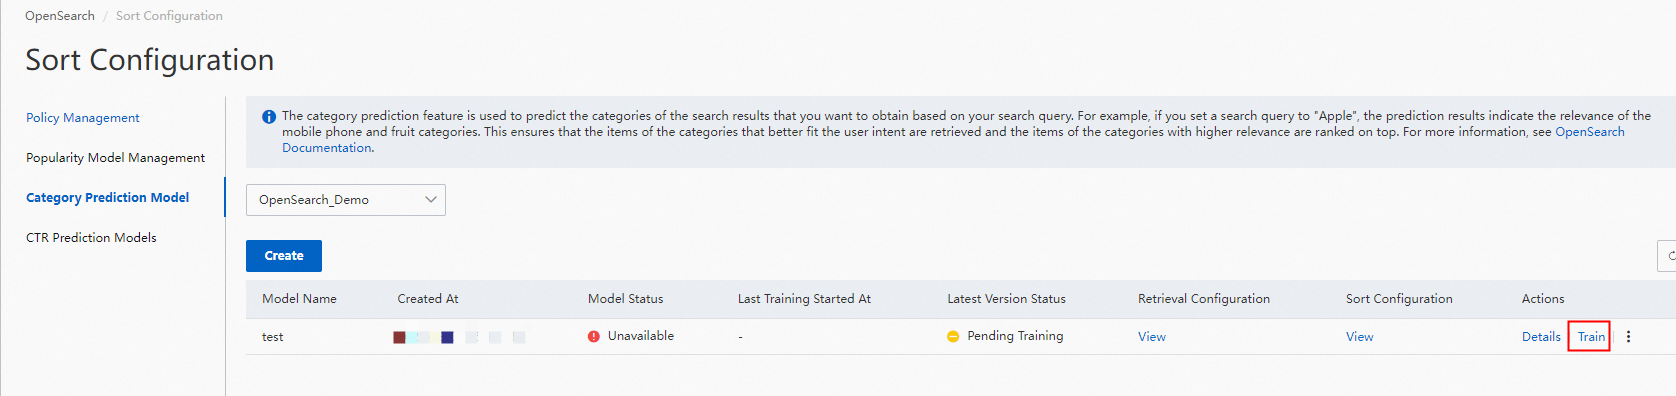
Model melewati status berikut:
State
Meaning
Pending Training
Model dibuat, pelatihan belum dimulai
Training
Model sedang dilatih
Training Failed
Pelatihan gagal karena error data
Not Applied
Pelatihan selesai, belum direferensikan untuk retrieval atau sorting
Trained and Not Passed
Pelatihan selesai, tetapi model gagal lolos pelatihan
Jika Anda memiliki pertanyaan, kirim tiket.
Konfigurasikan analisis kueri dan ekspresi pengurutan
Buat aturan analisis kueri
-
Di panel navigasi sebelah kiri, pilih Search Algorithm Center > Retrieval Configuration. Di pohon navigasi, klik Query Analysis Rule Configuration, lalu klik Create.

-
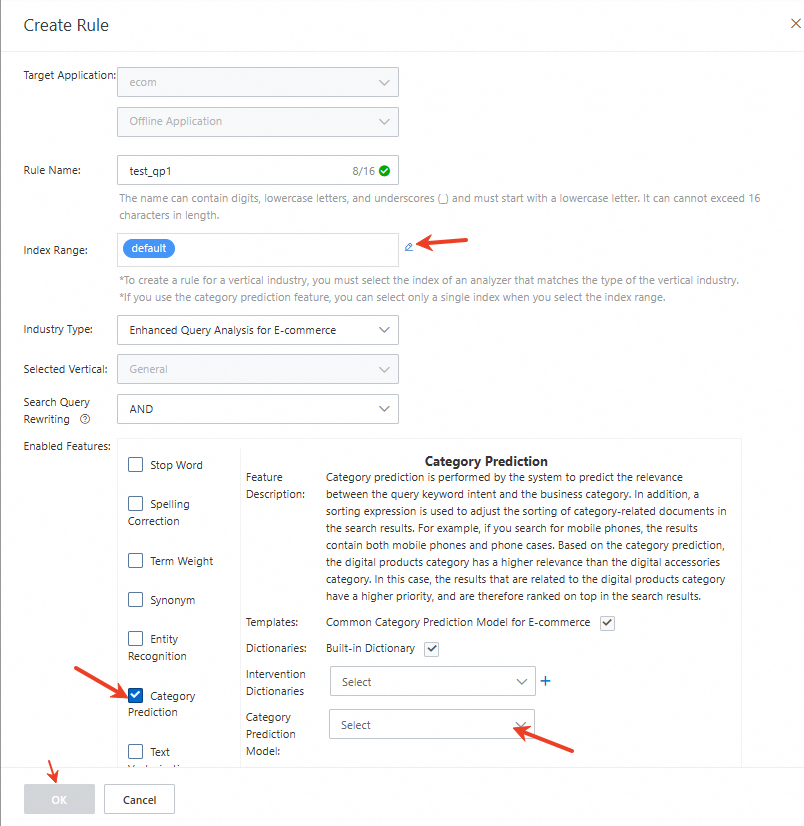
Konfigurasikan aturan analisis kueri dan simpan.
Terapkan model ke pengurutan kasar
Pengurutan kasar adalah putaran pertama peringkat.
-
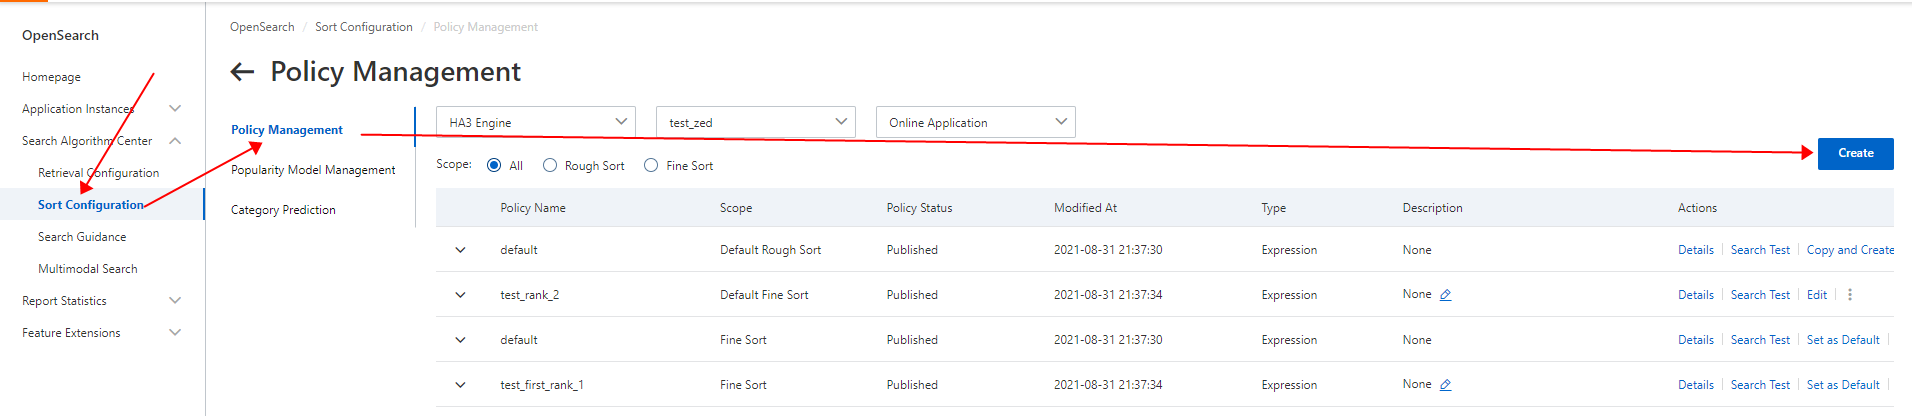
Di panel navigasi sebelah kiri, pilih Search Algorithm Center > Sort Configuration. Di halaman Policy Management, klik Create.
-
Di halaman Create Policy, masukkan nama kebijakan. Atur Scope ke Rough Sort dan Type ke Expression. Hanya ekspresi yang didukung di konsol. Plugin kustom akan didukung nanti.

-
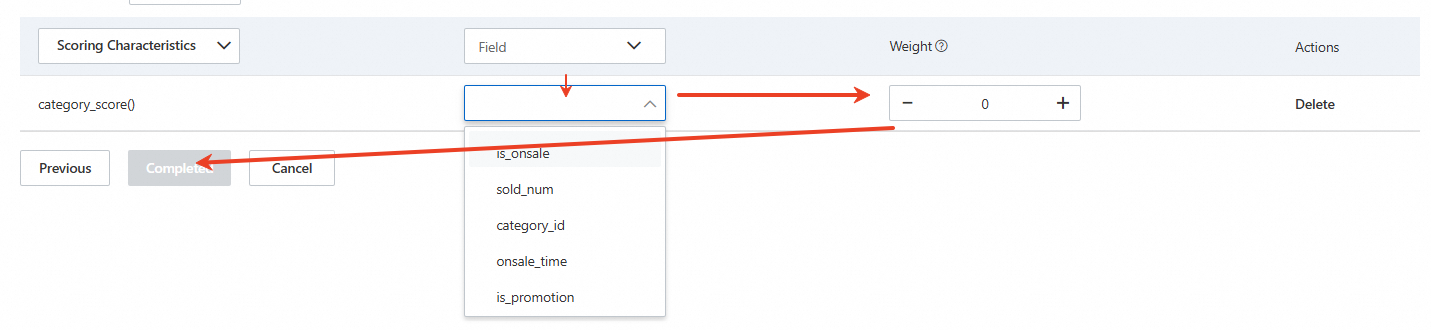
Di langkah Sort Configuration, pilih
category_score()dari daftar drop-down Scoring Characteristics.
-
Pilih bidang, atur bobot, dan simpan konfigurasi.
Terapkan model ke pengurutan presisi
Pengurutan presisi adalah putaran kedua peringkat.
-
Di halaman Create Policy, masukkan nama kebijakan. Atur Scope ke Fine Sort dan Type ke Expression. Hanya ekspresi yang didukung di konsol. Plugin kustom akan didukung nanti.

-
Di langkah Sort Configuration, pilih
category_score(cate_id_field)dari daftar drop-down Built-in Functions.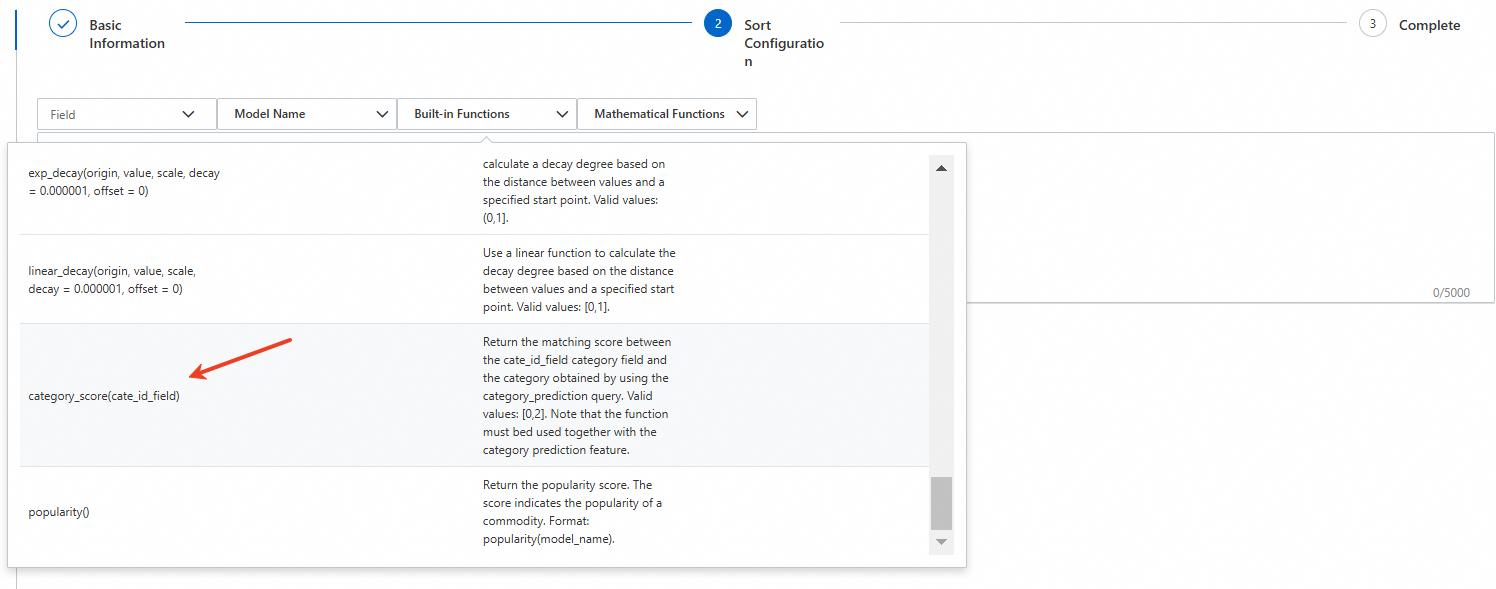
-
Ganti
cate_id_fielddengan category ID model Anda dan simpan konfigurasi.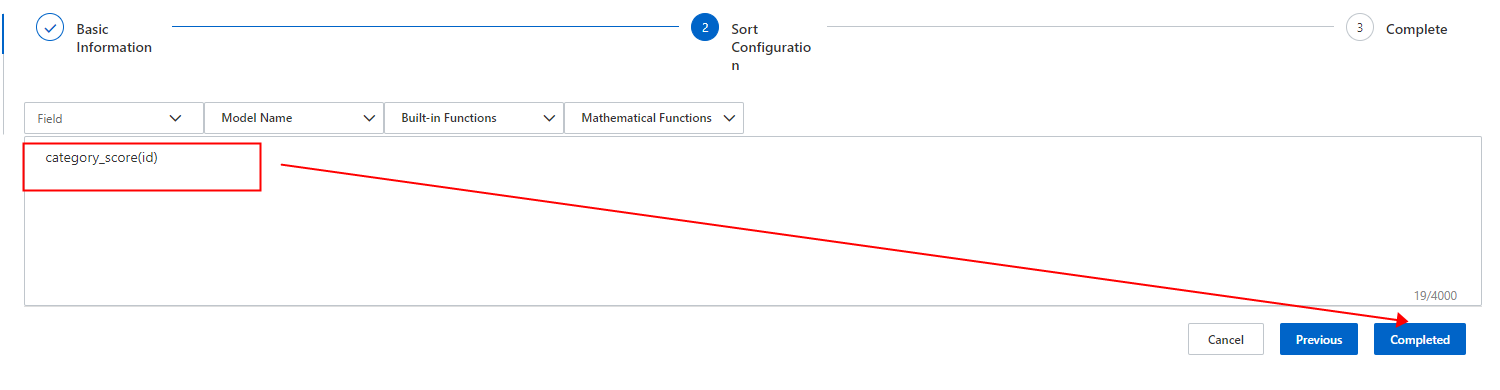
-
Verifikasi status model setelah direferensikan oleh kebijakan pengurutan.
-
Lakukan uji pencarian pada aplikasi. Atur parameter
raw_queryke kueri pencarian untuk menguji hasil prediksi kategori.
Aktifkan prediksi kategori dalam panggilan API dan SDK
Prediksi kategori hanya mengurutkan hasil pencarian ketika parameter raw_query tersedia dan nilainya sesuai dengan kueri pencarian dalam indeks.
Atur raw_query ke kueri pencarian yang dimasukkan pengguna:
raw_query=<search_query>-
Saat memanggil melalui API: encode nilai menggunakan
URL_ENCODE. -
Saat memanggil melalui SDK: tidak perlu encoding.
Kapan prediksi kategori berlaku
Tabel di bawah ini menunjukkan kapan prediksi kategori diterapkan, berdasarkan konfigurasi indeks dan nilai raw_query.
|
Index configuration |
|
|
Category prediction applies? |
|
Disabled |
Yes |
— |
No |
|
Disabled |
No |
— |
No |
|
Enabled |
No |
— |
No |
|
Enabled |
Yes |
No |
No |
|
Enabled |
Yes |
Yes |
Yes |
Perilaku multi-indeks: Jika permintaan mencakup beberapa indeks, prediksi kategori diterapkan per indeks berdasarkan aturan di atas.
# prediksi index3 berlaku (kueri cocok dengan raw_query hanya untuk index3)
query=index2:'index_query' AND index3:'search_query'&raw_query=search_query

# prediksi index2 berlaku lebih dulu;
# jika konfigurasi index2 tidak berlaku, index3 berlaku
query=index2:'search_query' AND index3:'search_query'&raw_query=search_query
Batasan
-
Maksimal lima model prediksi kategori dapat dibuat per aplikasi.
-
Bidang data yang digunakan untuk melatih model harus disertakan dalam indeks tempat aturan analisis kueri diterapkan.
-
Sebelum membuat model, konfigurasikan category ID dan bidang terkait sebagai bidang atribut.
-
Jika aturan analisis kueri mereferensikan model prediksi kategori dan permintaan berisi parameter
category_prediction, terjadi error. -
Agar prediksi kategori berlaku, ketiganya harus dikonfigurasikan: aturan analisis kueri yang mereferensikan model, ekspresi pengurutan yang berisi fungsi
category_score, dan parameterraw_querydalam permintaan. -
Operasi API terkait: Algorithms
Pemecahan masalah kegagalan pelatihan model
Jika pelatihan model prediksi kategori Anda gagal, ikuti langkah-langkah berikut untuk memecahkan masalah:
-
Periksa laporan anomali: Di halaman detail model, lihat Latest Version Status. Jika status menunjukkan error data, buka Anomaly Report untuk mengidentifikasi penyebab kegagalan.
-
Periksa tingkat kelengkapan: Lihat Completeness Level dan Upgrade Conditions yang sesuai. Sesuaikan data Anda sesuai kondisi peningkatan untuk meningkatkan tingkat kelengkapan.
-
Logika data T-1: Pelatihan model menggunakan data statistik dari hari sebelumnya (T-1). Saat model baru dibuat dan dilatih pertama kali, pelatihan mungkin gagal dengan error "Training field does not exist" karena tidak tersedia data dari hari sebelumnya. Tunggu hingga hari berikutnya saat data sudah tersedia, lalu latih ulang model.
-
Persyaratan volume data: Pelatihan memerlukan jumlah kueri unik dari hari terbaru melebihi 100. Jumlah kueri unik mengacu pada jumlah permintaan pencarian sukses yang menyertakan parameter
raw_query. -
Format kondisi filter: Jika kondisi filter dikonfigurasi, nama bidang harus sesuai dengan bidang dalam skema aplikasi. Beberapa kondisi menggunakan logika AND dan harus dipisahkan dengan koma (
,). Format yang salah dapat menyebabkan kegagalan pelatihan. Contoh:is_onsale > 0.
Penggunaan lanjutan
Kombinasikan dengan Named Entity Recognition (NER)
Jika Anda mengonfigurasi NER bersama prediksi kategori dalam aturan analisis kueri, lebih banyak dokumen diambil. Hasil NER juga digunakan untuk retrieval. Jika tidak ada dokumen yang sesuai dengan kategori yang diprediksi, kata-kata dalam kueri pencarian secara selektif diabaikan untuk memperluas hasil—hasil yang lebih luas ini menjadi output akhir prediksi kategori. Untuk informasi selengkapnya, lihat Named entity recognition.
Intervensi hasil prediksi
Intervensi memungkinkan Anda mengganti prediksi model yang telah dilatih, mirip dengan intervensi analisis kueri. Untuk informasi selengkapnya, lihat Intervention dictionaries for category prediction.