Topik ini memperkenalkan fitur prediksi kategori, mencakup prinsip dasar dan cara penggunaannya, untuk membantu Anda memahami serta menerapkannya secara efektif.
Results
Konsep utama
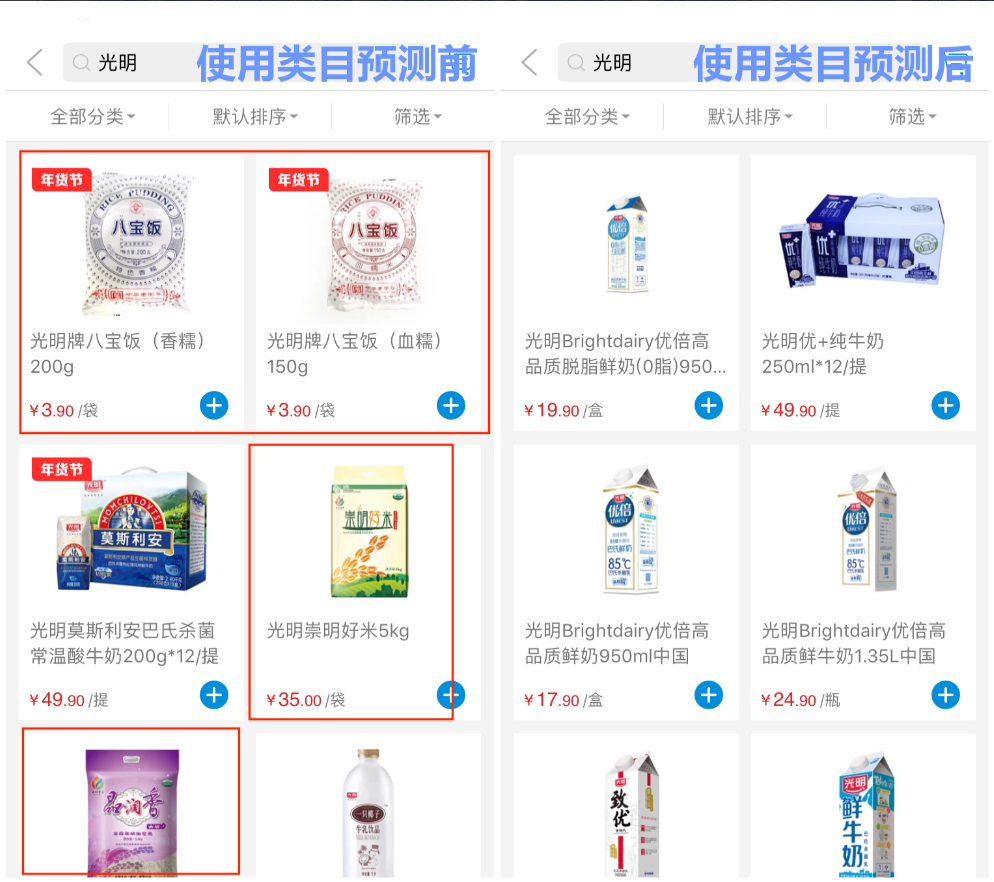
Prediksi kategori mengurutkan hasil pencarian dengan menghitung relevansi antara kueri pencarian pengguna dan kategori komoditas. Komoditas dalam kategori yang memiliki relevansi lebih tinggi memperoleh skor peringkat lebih tinggi dan muncul lebih awal dalam hasil pencarian.
Contoh:
Misalnya, seorang pengguna mencari "Bright" dan mendapatkan sekumpulan komoditas, sebagian termasuk dalam kategori "Milk" dan lainnya dalam kategori "Rice". Berdasarkan data perilaku pencarian historis, jumlah klik pada komoditas dalam kategori "Milk" jauh lebih banyak dibandingkan dengan kategori "Rice" di antara pengguna yang mencari "Bright". Oleh karena itu, model prediksi kategori memprediksi bahwa kategori "Milk" lebih relevan terhadap kueri "Bright" dibandingkan kategori "Rice". Akibatnya, saat menghitung skor peringkat setiap komoditas, komoditas dalam kategori "Milk" memperoleh skor lebih tinggi daripada yang berada di kategori "Rice", sehingga menempati posisi lebih atas dalam hasil pencarian dan meningkatkan nilai bisnis dari pencarian tersebut.
Prinsip dasar prediksi kategori
Tujuan prediksi kategori adalah memprediksi relevansi antara kueri pencarian dan suatu kategori. Proses ini memerlukan data kueri historis, data perilaku klik, serta informasi komoditas di bawah setiap kategori. Secara spesifik, sistem mengumpulkan kueri yang pernah dicari sebelumnya, menggabungkannya dengan data perilaku klik setelah pencarian, lalu menghubungkannya dengan informasi komoditas di bawah setiap kategori untuk menggambarkan pola hubungan antara kueri dan kategori.
Pelatihan model memerlukan sumber data. Saat membuat model prediksi kategori, Anda harus terlebih dahulu mengaitkannya dengan sebuah aplikasi. Setelah aplikasi dikaitkan, Anda perlu menentukan tiga jenis data berikut yang diperlukan untuk melatih model:
Semua kueri yang pernah dicari dalam aplikasi. Anda perlu menambahkan parameter raw_query ke permintaan pencarian.
Data kategori dan data komoditas. Anda menentukan bidang-bidang ini dari aplikasi saat menyiapkan pelatihan model. Minimal, Anda harus menentukan bidang Category ID dan Commodity Title dalam aplikasi.
Data perilaku klik aplikasi. Semakin lengkap dan berkualitas data perilaku yang dilaporkan, semakin kaya fitur model dan semakin baik hasilnya.
Fitur prediksi kategori OpenSearch mendukung pelatihan model baik dengan maupun tanpa data perilaku.
Pelatihan model dengan data perilaku berlaku ketika data perilaku telah diunggah. Sebelum pelatihan dimulai, sistem melakukan pemeriksaan entri secara otomatis untuk memastikan bahwa kuantitas, kualitas, dan integritas data memenuhi persyaratan. Pelatihan model mencakup langkah-langkah berikut:
Gunakan kueri historis dan informasi kategori untuk mengambil sampel serta menghasilkan data sampel, lalu gunakan data perilaku untuk memberi label pada data sampel tersebut.
Lakukan operasi seperti statistik metrik dan perhitungan fitur pada data perilaku untuk menghasilkan fitur perilaku klik.
Gabungkan kueri dengan judul komoditas di bawah setiap kategori, lakukan tokenisasi pada kueri dan judul, lalu hitung fitur semantik antara teks kueri dan teks judul komoditas.
Jika data perilaku transaksi diunggah, lakukan statistik metrik dan perhitungan fitur pada data perilaku transaksi untuk menghasilkan fitur transaksi, sehingga komoditas dengan performa transaksi lebih kuat mendapatkan peringkat lebih tinggi.
Gabungkan data sampel yang dihasilkan di atas dengan fitur perilaku, fitur semantik, fitur transaksi, dan label data sampel sebagai data pelatihan, lalu masukkan ke dalam algoritma untuk pelatihan iteratif.
Setelah pelatihan selesai, Anda memperoleh model yang menggambarkan relevansi antara kueri dan kategori dalam sampel. Model ini dapat digunakan untuk memprediksi relevansi antara kueri dan kategori.
Saat melatih model prediksi kategori dengan opsi "behavioral data" dipilih, suatu kueri harus memiliki lebih dari satu klik pada suatu kategori dalam rentang 14 hari terakhir.
Pelatihan model tanpa data perilaku berlaku pada skenario di mana data perilaku belum diunggah atau kualitasnya rendah. Dalam hal ini, Anda hanya perlu menentukan bidang Category ID dan Commodity Title dalam aplikasi untuk memulai pelatihan model. Tanpa data perilaku, tidak ada dasar untuk memberi label pada sampel, sehingga digunakan algoritma lain yang hanya menghitung relevansi semantik antara teks kueri dan teks judul komoditas berdasarkan data teks setelah tokenisasi, lalu menurunkan relevansi antara kueri dan kategori.
Model yang menggunakan data perilaku memberikan hasil lebih baik dibandingkan model yang tidak menggunakannya. Semakin kaya fitur pelatihan, semakin komprehensif model menggambarkan pola data antara kueri dan kategori, dan semakin akurat prediksinya.
Baik model menggunakan data perilaku maupun tidak, proses pelatihan telah melalui eksperimen ekstensif dengan data dari berbagai skenario dan penyetelan parameter yang cermat untuk memastikan hasil sesuai harapan.
Cara menggunakan prediksi kategori
Prasyarat
Pelatihan model memerlukan sumber data, dan Anda harus mengaitkan aplikasi sebelum melatih model. Data aplikasi, data kueri aplikasi, dan data perilaku aplikasi semuanya merupakan data yang diperlukan oleh model prediksi kategori.
Jika Anda belum mengunggah data perilaku klik, tidak ingin menggunakannya untuk pelatihan, atau data tersebut belum memenuhi syarat pelatihan, Anda dapat melatih model tanpa data perilaku klik terlebih dahulu. Dalam kasus ini, model prediksi kategori perlu memilih data dari tiga bidang berikut dari aplikasi: Category ID, Commodity Title, dan Category Name. Bidang Category ID dan Commodity Title wajib disediakan, sedangkan Category Name bersifat opsional. Setelah pelatihan model selesai, sebagian hasil prediksi model dikeluarkan untuk evaluasi. Category Name digunakan pada halaman evaluasi untuk menilai apakah relevansi antara kueri dan kategori sesuai harapan, sehingga kami merekomendasikan Anda menyediakan bidang ini selama pelatihan.
Jika data perilaku klik telah diunggah, selain memilih bidang di atas, Anda juga dapat memilih opsi untuk mengaitkan data perilaku selama pelatihan model. Selama data perilaku memenuhi syarat pelatihan, data tersebut akan digunakan untuk melatih model.
Prosedur
Create model prediksi kategori di bawah suatu aplikasi.
Apply model prediksi kategori: Pertama, terapkan model dalam query analysis, lalu aktifkan model dalam basic sorting dan business sorting.
Buat query analysis, konfigurasikan prediksi kategori, dan pilih model yang dibuat pada langkah 1.
Enable model prediksi kategori dalam kueri: Panggil API query melalui SDK dan masukkan parameter raw_query.
Untuk prosedur lengkapnya, lihat Gunakan fitur prediksi kategori.