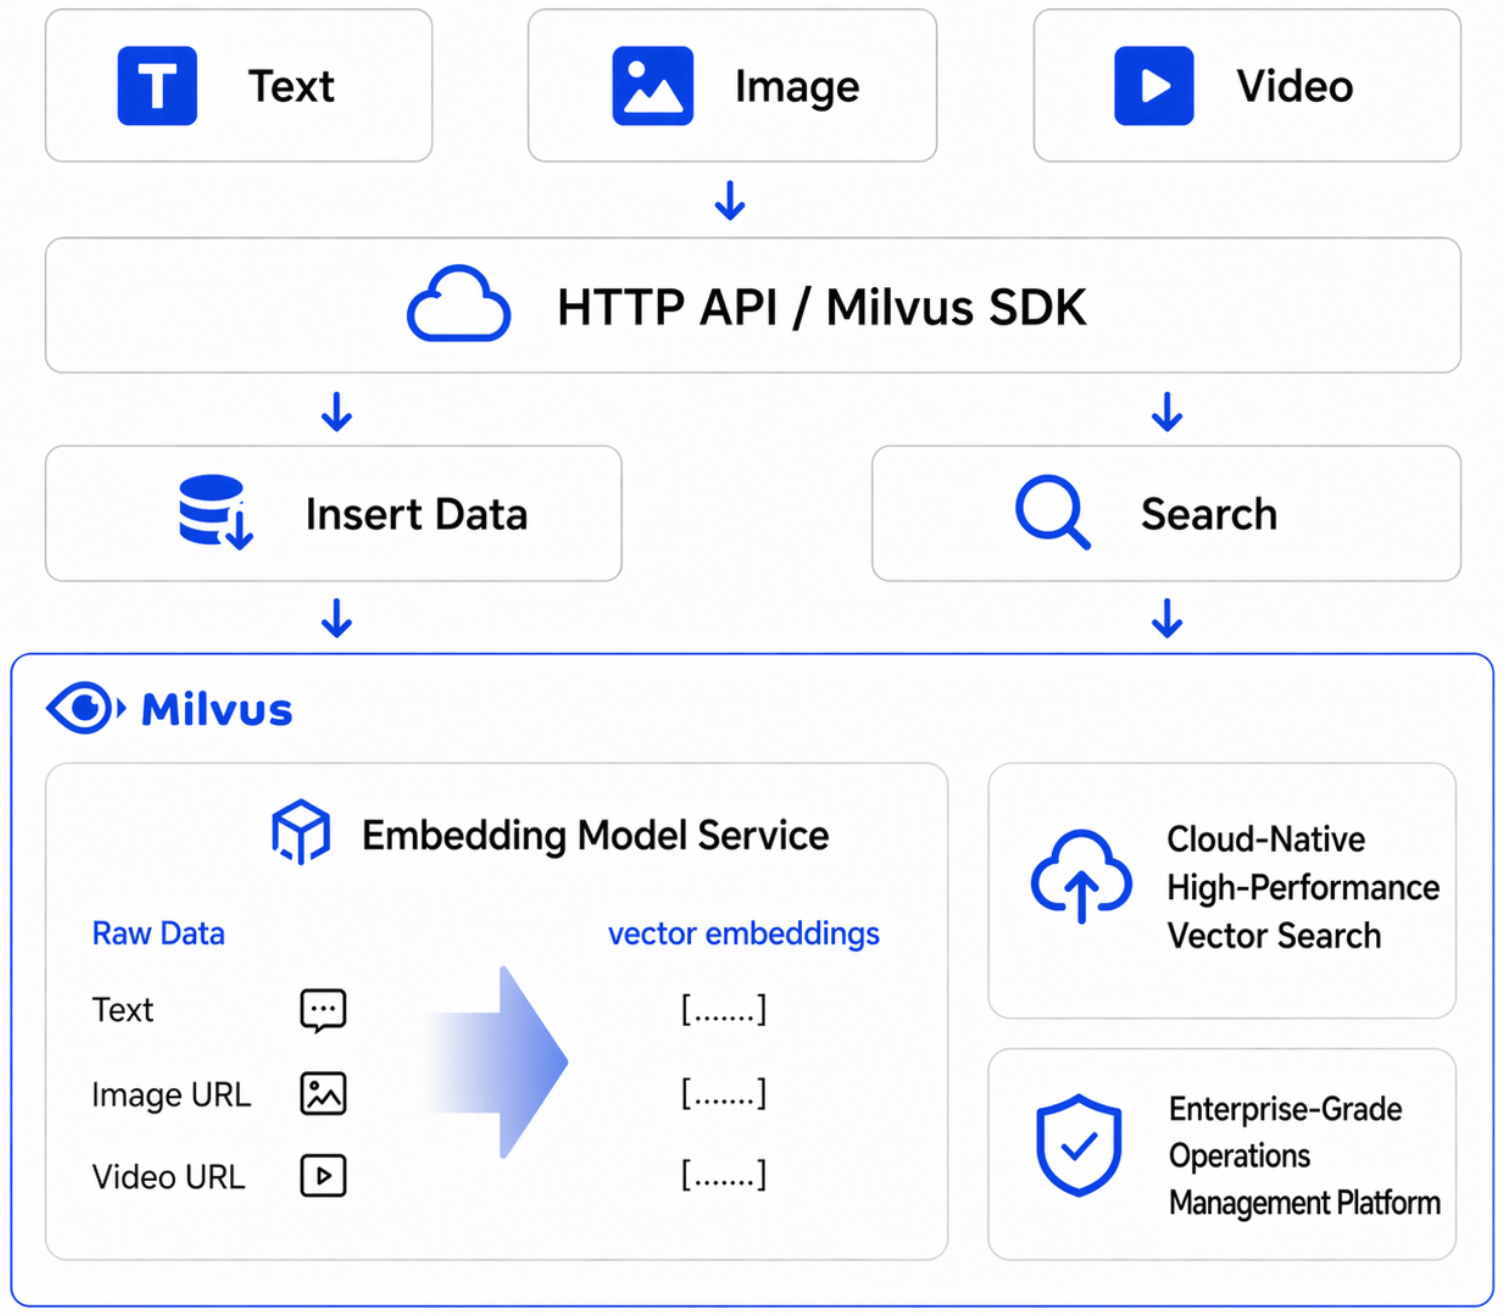
Alibaba Cloud Milvus AI Center adalah layanan model terkelola yang terintegrasi langsung ke dalam Milvus. Setelah diaktifkan, Anda dapat langsung mengirimkan teks mentah atau data multimodal (gambar, video) selama ingest data dan pencarian. Sistem secara otomatis menghasilkan vektor tanpa perlu men-deploy layanan inferensi embedding terpisah.
Ikhtisar fitur
|
Feature |
Description |
|
One-stop console management |
Lihat, konfigurasikan, dan dapatkan contoh pemanggilan untuk layanan model di Konsol tanpa perlu berpindah antar platform. |
|
Managed model capabilities |
Platform menyediakan layanan inferensi model terkelola tanpa perlu membangun layanan inferensi sendiri atau memelihara infrastruktur. |
|
Direct ingestion and search of raw data |
Kirimkan konten teks mentah atau multi-modal secara langsung saat melakukan insert, update, dan kueri. Sistem secara otomatis menyelesaikan vektorisasi. |
|
Flexible multi-model switching |
Tersedia beberapa model vektorisasi. Anda dapat memilih secara fleksibel berdasarkan efektivitas, latensi, dan biaya sesuai skenario bisnis Anda. |
|
Invocation and token statistics |
Statistik penggunaan token dan jumlah pemanggilan tersedia berdasarkan dimensi kluster maupun model. |
|
Invocation monitoring |
Lihat metrik operasional seperti Success Rate dan Average RT (average response time). |
Selain vektorisasi, AI Center juga menyediakan kemampuan model terpadu seperti reranking, generasi teks, pemahaman multimodal, dan pengeditan video, yang dapat langsung digunakan untuk skenario pencarian semantik, basis pengetahuan RAG, chat AI perusahaan, rekomendasi konten, dan pencarian multimodal. Topik ini menggunakan vektorisasi sebagai contoh untuk menjelaskan proses integrasi lengkap untuk pencarian teks dan pencarian multimodal.
Prosedur
Lihat model vektorisasi yang tersedia
Masuk ke Konsol Milvus, lalu pada panel navigasi sebelah kiri, pilih AI Center. Pada tab Model Service, lihat grup Vectorization untuk melihat jenis input, dimensi output, dan API Example setiap model.
Model vektorisasi berikut saat ini tersedia:
|
Model |
Supported input |
Description |
|
|
Text |
Model text embedding yang direkomendasikan. Dimensi default: 1024. |
|
|
Text |
Model text embedding multibahasa. Mendukung dimensi vektor kustom. |
|
|
Text |
Model text embedding tujuan umum. |
|
|
Text |
Model text embedding tujuan umum. Dijadwalkan untuk ditinggalkan. Tidak direkomendasikan untuk beban kerja baru. |
|
|
Text, image, video |
Model embedding multimodal yang direkomendasikan. Dimensi default: 2560. Anda dapat menentukan dimensi lain dengan menggunakan parameter |
|
|
Text, image, video |
Model embedding multimodal. |
AI Center menyediakan layanan secara independen berdasarkan wilayah. Setelah beralih ke wilayah berbeda, Anda harus melihat dan mengonfigurasi ulang layanan di wilayah tersebut.
Siapkan instans Milvus
Fitur vektorisasi memerlukan instans Milvus versi 2.6. Setelah membuat instans versi 2.6, Anda dapat langsung mendeklarasikan Function di dalam Collection untuk memanggil model. Tidak diperlukan operasi binding model ke instans secara terpisah.
Untuk mengakses instans melalui Internet, buka halaman produk instans tersebut dan pada tab Security Configuration, aktifkan Public Network Access serta konfigurasikan daftar putih akses publik.
Lihat penggunaan dan pemantauan
Buka AI Center dan klik tab Monitoring. Anda dapat melihat detail pemanggilan dari dua perspektif: By Milvus Cluster atau By Model.
-
Token usage / Invocation count: Detail penggunaan token dan jumlah pemanggilan yang dikelompokkan berdasarkan kluster dan model.
-
Total tokens / Total text input tokens: Konsumsi token agregat dalam rentang waktu yang dipilih.
-
Success Rate: Tingkat keberhasilan permintaan.
-
Average RT: Waktu respons rata-rata.
Anda dapat memilih kluster atau model, mengatur interval pengambilan sampel, dan menerapkan filter berdasarkan rentang waktu cepat seperti 1 jam, 3 jam, 6 jam, 12 jam, 1 hari, atau 7 hari, atau menentukan jendela waktu kustom.
Contoh 1: Pencarian semantik teks-ke-teks
Skenario
Ingest batch teks mentah ke Milvus tanpa perlu menghasilkan vektor terlebih dahulu. Saat kueri, kirimkan pertanyaan dalam bahasa alami secara langsung. Milvus secara otomatis melakukan vektorisasi terhadap kueri dan mengembalikan hasil yang paling relevan secara semantik. Skema ini berlaku untuk skenario tanya jawab basis pengetahuan, pencarian dokumen, dan pengambilan FAQ.
Prosedur
-
Buat Collection dan definisikan bidang teks mentah
documentserta bidang vektordense. -
Bind model
qwen3.7-text-embeddingdengan menggunakanFunction. -
Masukkan data teks uji dan panggil
flushuntuk memastikan data dapat dicari. -
Lakukan pencarian dengan menggunakan pertanyaan dalam bahasa alami dan ambil segmen teks yang paling relevan.
Setelah memasukkan data, Anda harus memanggil flush. Jika tidak, pencarian yang dilakukan segera setelah insert dapat mengembalikan hasil kosong.
Kode contoh
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://c-xxxx.milvus.aliyuncs.com:19530",
    token='root:xxx',
)

# ========== Buat Collection ==========
collection_name = 'demo1'
schema = client.create_schema()

schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=9000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1024)
text_embedding_function = Function(
    name="dashscope_api_test123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["document"],
    output_field_names=["dense"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3.7-text-embedding"
    }
)

schema.add_function(text_embedding_function)
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
client.drop_collection(collection_name)
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params
)

insert_data = []
record_id = 1

mock_texts = [
    "A vector database converts text into high-dimensional vectors for semantic search, understanding the true intent of queries.",
    "Deep learning models learn feature representations from large image datasets for tasks such as image classification and object detection.",
    "Retrieval augmented generation recalls relevant documents to provide external knowledge for large language models, reducing hallucinations and improving answer reliability.",
    "In customer service scenarios, semantic search can quickly locate historical tickets, improving first-response efficiency and resolution rates.",
    "Similarity search commonly uses cosine distance to measure vector direction proximity, suitable for text semantic matching tasks.",
    "Data cleaning is a critical step before vectorization. Denoising and format standardization significantly improve recall quality.",
    "Higher embedding dimensions are not always better. You need to balance effectiveness, latency, and storage cost.",
    "Chunking strategies that split long documents into small segments can improve search hit rates and reduce context redundancy.",
    "Adding a source field to each piece of knowledge aids result explainability, making it easy to display citation evidence on the frontend.",
    "Multilingual search leverages a unified vector space for cross-language matching, enhancing the experience of internationalized systems.",
    "Index parameters such as ef and M affect the recall rate and query performance of HNSW and need to be tuned based on your business requirements.",
    "Running offline evaluations before going live can quantify differences in search quality across different models and parameter combinations.",
    "Metadata filtering in a vector database can be combined with semantic recall for more precise scoped search.",
    "For high-frequency queries, caching search results briefly can reduce backend computation pressure and response time.",
    "A semantic search pipeline should log queries to facilitate analysis of zero-result queries and continuous optimization of the knowledge base.",
    "When knowledge content updates frequently, incremental indexing strategies can reduce the resource consumption of full rebuilds.",
    "Adding a reranking model in a Q&A system can improve the relevance and readability of the top results.",
    "Establishing access control policies for sensitive data is a fundamental security requirement for enterprise-grade vector search systems.",
    "Setting topK appropriately balances coverage and noise, avoiding the return of too many low-relevance results.",
    "Feeding user feedback back into the training and evaluation pipeline can continuously improve overall search and Q&A performance.",
]

for text in mock_texts:
    insert_data.append({
        "id": record_id,
        "document": text,
    })
    record_id += 1

BATCH_SIZE = 30
print(f"Preparing to insert {len(insert_data)} records, batch_size={BATCH_SIZE}...")
for batch_start in range(0, len(insert_data), BATCH_SIZE):
    batch = insert_data[batch_start:batch_start + BATCH_SIZE]
    client.insert(collection_name, batch)
    print(f"  Inserted {min(batch_start + BATCH_SIZE, len(insert_data))}/{len(insert_data)} records")
client.flush(collection_name)
print("Data insertion complete!\n")

# ========== Uji 1: Pencarian teks-ke-teks (pencarian semantik melalui bidang dense) ==========
print("=" * 60)
print("Uji 1: Pencarian teks-ke-teks - kueri konten terkait database vektor")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['What is semantic search? How does a vector database work?'],
    anns_field='dense',
    limit=3,
    output_fields=['document'],
)
for hits in results:
    for hit in hits:
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, document={hit['entity']['document'][:50]}")
Output
Preparing to insert 20 records, batch_size=30...
  Inserted 20/20 records
Data insertion complete!

============================================================
Uji 1: Pencarian teks-ke-teks - kueri konten terkait database vektor
============================================================
  id=1, distance=0.8668, document=A vector database converts text into high-d
  id=13, distance=0.5989, document=Metadata filtering in a vector database can
  id=15, distance=0.5414, document=A semantic search pipeline should log queri
Hasil pencarian diurutkan berdasarkan relevansi semantik, dengan teks yang paling dekat dengan maksud kueri ditempatkan di urutan teratas. Skor kemiripan aktual bervariasi tergantung pada versi model dan konten data.
Contoh 2: Pencarian multimodal
Skenario
Dalam skenario ritel, e-commerce, dan platform konten, target pencarian mencakup gambar dan video selain teks. Model embedding multimodal di AI Center mendukung penyatuan konten teks dan visual dalam satu pipeline vektorisasi dan pencarian, sehingga memungkinkan kemampuan pencarian lintas modal seperti teks-ke-gambar/video dan gambar-ke-gambar/video.
Contoh ini mendefinisikan dua bidang vektor dalam Collection yang sama: dense dihasilkan oleh model teks untuk pencarian semantik teks, dan dense_mm dihasilkan oleh model multimodal untuk pencarian lintas modal.
Prosedur
-
Unggah gambar atau video ke OSS atau layanan object storage lainnya dan hasilkan URL yang dapat diakses oleh layanan model.
-
Buat Collection dan definisikan bidang teks
document, bidang URL multimediaurl, bidang vektor teksdense, dan bidang vektor multimodaldense_mm. -
Bind
qwen3.7-text-embeddingdanqwen3-vl-embeddingke bidang teks dan bidang multimedia, masing-masing. -
Masukkan aset uji beserta deskripsi teksnya.
-
Lakukan verifikasi pencarian untuk skenario teks-ke-teks, teks-ke-gambar/video, dan gambar-ke-gambar/video.
Saat mengikat model multimodal ke bidang multimedia, Anda harus mengatur params dengan is_multimodal bernilai true. Jika tidak, pembuatan Collection akan gagal karena model tidak dapat mengurai input. Nilai dim harus sesuai dengan dimensi yang dideklarasikan di bidang vektor.
Bidang multimedia juga dapat menerima teks biasa secara langsung. Model multimodal menghasilkan vektor teks dalam ruang vektor yang sama, sehingga memungkinkan pencarian campuran gambar-teks.
Kode contoh
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://c-xxxx.milvus.aliyuncs.com:19530",
    token='root:xxx',
)

# Ganti dengan URL gambar atau video Anda sendiri yang dapat diakses oleh layanan model
IMAGE_URL = "https://example.com/your-image.jpg"
VIDEO_URL = "https://example.com/your-video.mp4"

# ========== Buat Collection ==========
collection_name = 'demo11'
schema = client.create_schema()

schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=9000)
schema.add_field("url", DataType.VARCHAR, max_length=9000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1024)
schema.add_field("dense_mm", DataType.FLOAT_VECTOR, dim=1024)

text_embedding_function = Function(
    name="dashscope_api_test123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["document"],
    output_field_names=["dense"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3.7-text-embedding"
    }
)
mm_embedding_function = Function(
    name="dashscope_api_mm123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["url"],
    output_field_names=["dense_mm"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3-vl-embedding",
        "dim": "1024",
        "is_multimodal": "true"
    }
)

schema.add_function(text_embedding_function)
schema.add_function(mm_embedding_function)
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
index_params.add_index(
    field_name="dense_mm",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
client.drop_collection(collection_name)
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params
)

# ========== Insert data: aset multimedia menggunakan URL, teks biasa dikirim langsung ==========
insert_data = [
    {"id": 1, "document": "A clothing product image showing the appearance details of an upper garment worn by a person.", "url": IMAGE_URL},
    {"id": 2, "document": "A short clothing showcase video showing the dynamic wearing effect of the garment.", "url": VIDEO_URL},
    {"id": 3,
     "document": "A vector database converts text into high-dimensional vectors for semantic search, understanding the true intent of queries.",
     "url": "A vector database converts text into high-dimensional vectors for semantic search, understanding the true intent of queries."},
    {"id": 4,
     "document": "Deep learning models learn feature representations from large image datasets for tasks such as image classification and object detection.",
     "url": "Deep learning models learn feature representations from large image datasets for tasks such as image classification and object detection."},
    {"id": 5,
     "document": "Clothing e-commerce platforms typically need to search product images by style, color, and material.",
     "url": "Clothing e-commerce platforms typically need to search product images by style, color, and material."},
]

print(f"Preparing to insert {len(insert_data)} records...")
client.insert(collection_name, insert_data)
client.flush(collection_name)
print("Data insertion complete!\n")

# ========== Uji 1: Pencarian teks-ke-teks (pencarian semantik melalui bidang dense) ==========
print("=" * 60)
print("Uji 1: Pencarian teks-ke-teks - kueri konten terkait produk pakaian")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['Clothing product appearance showcase'],
    anns_field='dense',
    limit=3,
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, document={hit['entity']['document'][:40]}")

# ========== Uji 2: Pencarian teks-ke-gambar/video (kueri konten multimedia menggunakan deskripsi teks, filter catatan ber-URL) ==========
print("\n" + "=" * 60)
print("Uji 2: Pencarian teks-ke-gambar/video - cari aset terkait pakaian menggunakan deskripsi teks")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['A garment being worn for display'],
    anns_field='dense_mm',
    limit=3,
    filter='url like "http%"',
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        is_media = "media" if str(hit['entity']['url']).startswith('http') else "text"
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, [{is_media}] document={hit['entity']['document'][:40]}")

# ========== Uji 3: Pencarian gambar-ke-gambar/video (kueri konten multimedia menggunakan URL gambar) ==========
print("\n" + "=" * 60)
print("Uji 3: Pencarian gambar-ke-gambar/video - cari aset serupa menggunakan URL gambar")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=[IMAGE_URL],
    anns_field='dense_mm',
    limit=3,
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        is_media = "media" if str(hit['entity']['url']).startswith('http') else "text"
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, [{is_media}] document={hit['entity']['document'][:40]}")
Output
Preparing to insert 5 records...
Data insertion complete!

============================================================
Uji 1: Pencarian teks-ke-teks - kueri konten terkait produk pakaian
============================================================
  id=1, distance=0.6412, document=A clothing product image showing the appea
  id=5, distance=0.5901, document=Clothing e-commerce platforms typically nee
  id=2, distance=0.5689, document=A short clothing showcase video showing the

============================================================
Uji 2: Pencarian teks-ke-gambar/video - cari aset terkait pakaian menggunakan deskripsi teks
============================================================
  id=2, distance=0.1861, [media] document=A short clothing showcase video showing the
  id=1, distance=0.1153, [media] document=A clothing product image showing the appea

============================================================
Uji 3: Pencarian gambar-ke-gambar/video - cari aset serupa menggunakan URL gambar
============================================================
  id=1, distance=1.0000, [media] document=A clothing product image showing the appea
  id=2, distance=0.0732, [media] document=A short clothing showcase video showing the
  id=3, distance=0.0294, [text] document=A vector database converts text into high-di
Pada Uji 3, gambar kueri memiliki kemiripan 1,0000 dengan gambar yang sama di database, yang mengonfirmasi bahwa pipeline pencarian gambar-ke-gambar berfungsi dengan benar. Pencarian lintas modal (teks mengkueri multimedia) biasanya menghasilkan skor kemiripan lebih rendah dibandingkan pencarian dalam modal yang sama. Hal ini merupakan perilaku normal. Evaluasi efektivitas berdasarkan peringkat relatif dalam skenario pencarian yang sama, bukan dengan membandingkan skor absolut antar skenario.