Topik ini menjawab pertanyaan yang sering diajukan mengenai Elasticsearch open source.
Ikhtisar
-
Bagaimana cara mengonfigurasi ukuran thread pool untuk indeks?
-
Apa yang harus saya lakukan jika terjadi Out of Memory (OOM)?
-
Berapa lama waktu yang dibutuhkan untuk membuat snapshot yang disimpan di OSS?
-
Bagaimana cara mengubah zona waktu untuk visualisasi data di Konsol Kibana?
-
Jenis data apa yang dapat saya jalankan kueri term Elasticsearch?
-
Apa saja hal yang perlu diperhatikan saat menggunakan alias di Elasticsearch?
-
Apa yang harus saya lakukan jika error too_many_buckets_exception dikembalikan selama kueri?
-
Dapatkah saya mengubah nilai parameter script.painless.regex.enabled?
-
Bagaimana cara mengontrol apakah suatu field dapat diajak agregasi?
-
Bagaimana cara menggunakan kueri scroll Elasticsearch untuk pengambilan data skala besar?
-
Bagaimana cara menemukan entri manajemen role di Kibana atau memodifikasi mapping indeks?
Bagaimana cara mengonfigurasi ukuran thread pool untuk indeks?
Sebelum mengubah ukuran thread pool, pastikan apakah thread pool write berada di bawah tekanan. Jalankan perintah berikut untuk memeriksa:
GET /_cat/thread_pool?v=true&h=id,name,queue,active,rejected,completedRasio tinggi antara tugas yang ditolak (rejected) dan tugas yang selesai (completed) pada thread pool write menunjukkan bahwa ukuran antrian perlu ditingkatkan.
Untuk mengonfigurasi ukuran thread pool, atur parameter thread_pool.write.queue_size dalam file konfigurasi YAML kluster Anda. Untuk informasi lebih lanjut, lihat Konfigurasi file YML.
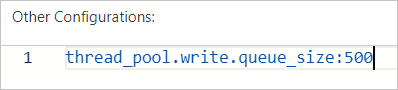
Untuk kluster Elasticsearch versi sebelum 6.X, gunakan parameter thread_pool.index.queue_size sebagai gantinya.
Apa yang harus saya lakukan jika terjadi Out of Memory (OOM)?
Jalankan perintah berikut untuk menghapus cache. Kemudian, analisis penyebabnya, lalu lakukan upgrade konfigurasi kluster Elasticsearch Anda atau sesuaikan bisnis Anda.
curl -u elastic:<password> -XPOST "localhost:9200/<index_name>/_cache/clear?pretty"| Parameter | Deskripsi |
|---|---|
<password> |
Password yang digunakan untuk mengakses kluster Elasticsearch Anda. Diatur saat pembuatan kluster atau inisialisasi Kibana. |
<index_name> |
Nama indeks yang cachenya ingin Anda hapus. |
Untuk petunjuk mengenai upgrade, lihat Upgrade konfigurasi kluster.
Bagaimana cara mengelola shard secara manual?
Gunakan API reroute atau Cerebro. Untuk detail mengenai API reroute, lihat Cluster reroute API.
Apa saja kebijakan penghapusan cache untuk Elasticsearch?
Elasticsearch mendukung tiga cakupan penghapusan cache:
-
Hapus cache semua indeks:
curl localhost:9200/_cache/clear?pretty -
Hapus cache indeks tertentu:
curl localhost:9200/<index_name>/_cache/clear?pretty -
Hapus cache beberapa indeks sekaligus:
curl localhost:9200/<index_name1>,<index_name2>,<index_name3>/_cache/clear?pretty
Bagaimana cara melakukan reroute index shards?
Jika shard hilang atau salah alokasi, jalankan perintah berikut untuk memindahkan atau mengalokasikan ulang shard tersebut:
curl -XPOST 'localhost:9200/_cluster/reroute' -d '{
    "commands" : [ {
        "move" :
            {
              "index" : "test", "shard" : 0,
              "from_node" : "node1", "to_node" : "node2"
            }
        },
        {
          "allocate" : {
              "index" : "test", "shard" : 1, "node" : "node3"
          }
        }
    ]
}'
Saat saya melakukan kueri pada suatu indeks, muncul error "statusCode: 500". Apa yang harus saya lakukan?
Gunakan alat pihak ketiga seperti Cerebro untuk melakukan kueri pada indeks yang sama:
-
Jika kueri berhasil di Cerebro, nama indeks tidak valid. Ganti nama indeks tersebut. Nama indeks hanya boleh berisi huruf, garis bawah (
_), dan angka. -
Jika kueri gagal di Cerebro, masalahnya ada pada indeks atau kluster itu sendiri. Periksa apakah kluster berisi indeks tersebut dan berjalan normal.
Bagaimana cara mengubah nilai parameter auto_create_index?
Jalankan perintah berikut:
PUT /_cluster/settings
{
    "persistent" : {
        "action": {
          "auto_create_index": "false"
        }
    }
}Nilai default auto_create_index adalah false, yang mencegah Elasticsearch membuat indeks secara otomatis. Hindari mengubah nilai ini — jika Anda melakukannya, Elasticsearch mungkin membuat terlalu banyak indeks dengan mapping atau pengaturan yang tidak sesuai ekspektasi Anda.
Berapa lama waktu yang dibutuhkan untuk membuat snapshot yang disimpan di OSS?
Ketika jumlah shard, penggunaan memori, penggunaan disk, dan utilisasi CPU semuanya berada pada level normal, pembuatan snapshot untuk data indeks sebesar 80 GB membutuhkan waktu sekitar 30 menit.
Bagaimana cara menentukan jumlah shard saat membuat indeks?
Anda dapat membagi total ukuran data dengan ukuran data setiap shard untuk mendapatkan jumlah shard. Kami menyarankan agar Anda membatasi ukuran data setiap shard hingga 30 GB. Jika ukuran data setiap shard melebihi 50 GB, performa kueri akan sangat terganggu.
Anda dapat meningkatkan jumlah shard secara proporsional untuk mempercepat pembuatan indeks. Performa kueri akan terpengaruh baik jika jumlah shard terlalu sedikit maupun terlalu banyak.
-
Terlalu banyak shard — lebih banyak handle file dan overhead komunikasi antar-node, yang memperlambat kueri.
-
Terlalu sedikit shard — setiap shard menyimpan lebih banyak data, yang juga memperlambat kueri.
Saat saya menggunakan plugin elasticsearch-repository-oss untuk memigrasikan data dari kluster Elasticsearch self-managed, muncul error. Apa yang harus saya lakukan?
Pesan error:
ERROR: This plugin was built with an older plugin structure. Contact the plugin author to remove the intermediate "elasticsearch" directory within the plugin zip.Solusi: Ubah nama paket ZIP dari elasticsearch menjadi elasticsearch-repository-oss, lalu salin ke direktori plugins.
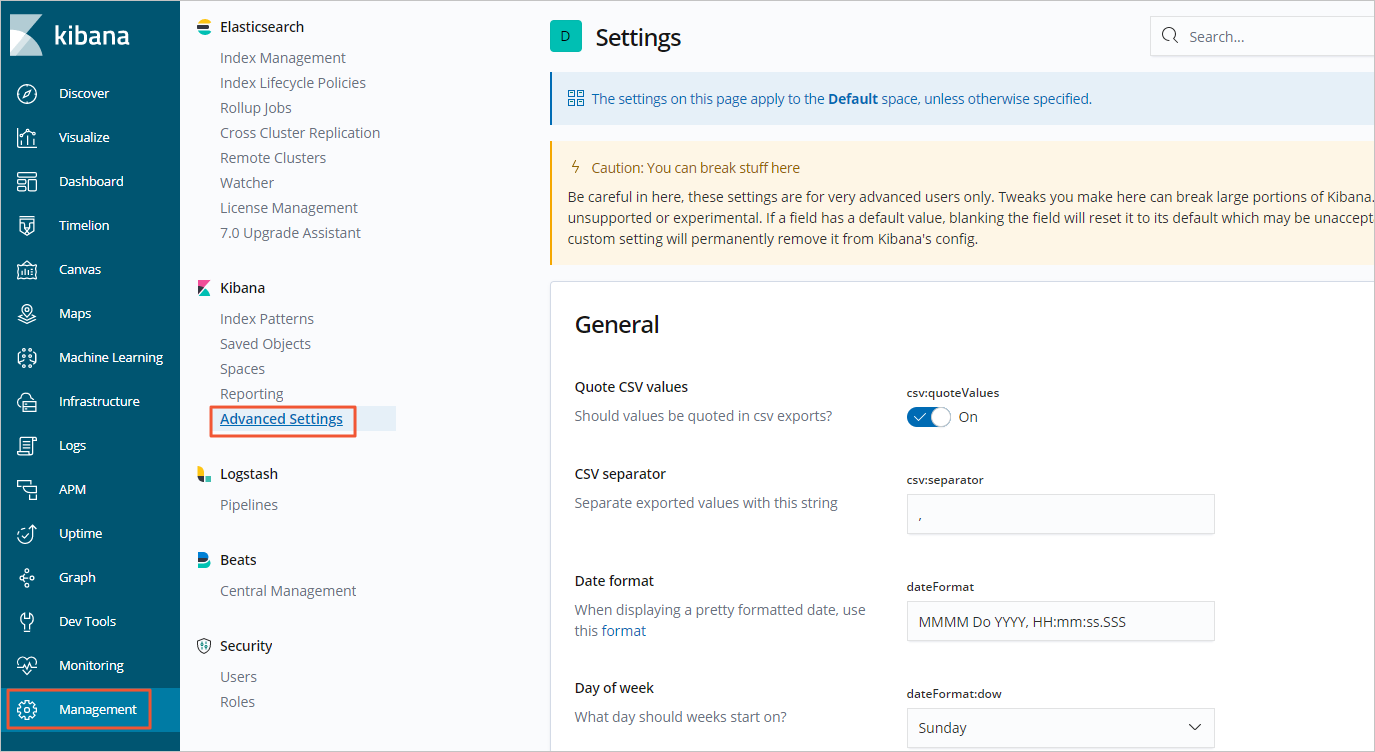
Bagaimana cara mengubah zona waktu untuk visualisasi data di Konsol Kibana?
Ubah zona waktu langsung di Konsol Kibana. Contoh berikut menggunakan kluster Elasticsearch 6.7.0.
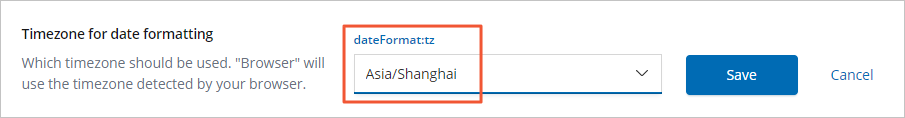
Gambar berikut menunjukkan zona waktu yang dipilih.
Jenis data apa yang dapat saya jalankan kueri term Elasticsearch?
Kueri term adalah kueri tingkat kata yang bekerja pada data terstruktur: angka, tanggal, dan bidang keyword. Kueri ini mencari langsung pada indeks terbalik tanpa memecah teks menjadi token.
Gunakan kueri full-text untuk bidang teks — kueri full-text melakukan tokenisasi input sebelum mencari.
Apa saja hal yang perlu diperhatikan saat menggunakan alias di Elasticsearch?
Jumlah total shard dari semua indeks yang berbagi alias yang sama harus kurang dari 1.024.
Apa yang harus saya lakukan jika error too_many_buckets_exception dikembalikan selama kueri?
Pesan error:
"type": "too_many_buckets_exception", "reason": "Trying to create too many buckets. Must be less than or equal to: [10000] but was [10001]"Kurangi parameter size untuk agregasi bucket Anda agar tetap dalam batas 10.000 bucket. Untuk detailnya, lihat Batasi jumlah bucket yang dapat dibuat dalam agregasi. Anda juga dapat mengikuti pendekatan yang dijelaskan dalam Meningkatkan max_buckets untuk visualisasi tertentu.
Bagaimana cara menghapus beberapa indeks sekaligus?
Secara default, Elasticsearch tidak mengizinkan penghapusan indeks massal. Untuk mengaktifkannya, jalankan:
PUT /_cluster/settings
{
  "persistent": {
     "action.destructive_requires_name": false
  }
}
Setelah pengaturan ini berlaku, gunakan wildcard untuk menghapus beberapa indeks sekaligus.
Dapatkah saya mengubah nilai parameter script.painless.regex.enabled?
Nilai default-nya adalah false. Ekspresi reguler dalam skrip Painless mengonsumsi sumber daya yang signifikan, jadi biarkan pengaturan ini dinonaktifkan kecuali Anda benar-benar membutuhkan dukungan regex dalam skrip Anda.
Untuk mengaktifkan ekspresi reguler, atur script.painless.regex.enabled menjadi true dalam file konfigurasi elasticsearch.yml.
Bagaimana cara mengubah konfigurasi mapping, jumlah primary shard, atau jumlah replica shard untuk suatu indeks?
Konfigurasi mapping
Mengubah mapping indeks yang sudah ada memerlukan pengindeksan ulang. Untuk tipe field yang didukung, lihat Tipe field data.
Primary shard
Jumlah primary shard tidak dapat diubah setelah indeks dibuat. Jika jumlah saat ini tidak lagi memenuhi kebutuhan Anda, gunakan API reindex untuk memigrasikan data ke indeks baru dengan jumlah shard yang sesuai.
Replica shard
Untuk mengubah jumlah replica shard untuk setiap primary shard, jalankan:
PUT test/_settings
{
  "number_of_replicas": 0
}Rencanakan jumlah primary dan replica shard sebelum membuat indeks untuk menghindari pengindeksan ulang yang mahal di kemudian hari.
Bagaimana cara menyimpan nilai suatu field?
Secara default, Elasticsearch tidak menyimpan nilai field individual — hanya menyimpan field _source, yang berisi dokumen JSON asli lengkap dan memungkinkan Anda mengambil field apa pun saat kueri.
Untuk menyimpan nilai field tertentu secara terpisah, atur store: true dalam mapping field tersebut:
PUT /my_index
{
  "mappings": {
    "properties": {
      "my_field": {
        "type": "text",
        "store": true
      }
    }
  }
}Mengaktifkan penyimpanan tingkat field meningkatkan penggunaan disk. Kecuali Anda memiliki alasan khusus untuk menyimpan nilai field secara terpisah, lebih baik andalkan _source.
Bagaimana cara mengontrol apakah suatu field dapat diajak agregasi?
Apakah suatu field dapat diajak agregasi bergantung pada tipe datanya dan apakah field data dasar (doc_values atau fielddata) diaktifkan.
Bidang yang Dapat Diagregasi Secara Default
Field numerik, tanggal, dan keyword mendukung agregasi melalui doc_values, yang menggunakan model penyimpanan berorientasi kolom yang dioptimalkan untuk pengurutan, agregasi, dan skrip.
Bidang teks (tidak dapat diagregasi secara default)
Untuk mengagregasi field teks, aktifkan fielddata dalam mapping:
PUT /my_index
{
  "mappings": {
    "properties": {
      "my_text_field": {
        "type": "text",
        "fielddata": true
      }
    }
  }
}Mengaktifkan fielddata memuat semua data teks untuk field tersebut ke dalam memori heap JVM, yang secara signifikan meningkatkan penggunaan memori.
Menonaktifkan agregasi untuk suatu field
Untuk mencegah suatu bidang diagregasi:
-
Atur
enabled: falseuntuk field tersebut dalam mapping. -
Keluarkan field tersebut dari dokumen sepenuhnya.
Apa yang harus saya lakukan jika muncul error "Unknown char_filter type [stop] for **" saat mengonfigurasi Elasticsearch?
Tipe stop adalah token filter, bukan character filter. Menempatkannya di bagian char_filter menyebabkan error ini.
Pindahkan konfigurasi stop dari char_filter ke bagian filter alat analisis Anda:
"settings": {
  "analysis": {
    "analyzer": {
      "my_custom_analyzer": {
        "type": "custom",
        "tokenizer": "standard",
        "filter": [
          "lowercase",
          "stop"
        ]
      }
    },
    "filter": {
      "stop": {
        "type": "stop",
        "stopwords": "_english_"
      }
    }
  }
}
Verifikasi juga bahwa semua tipe komponen yang ditentukan dalam char_filter, tokenizer, dan filter adalah tipe filter Elasticsearch yang valid.
Bagaimana cara menentukan apakah ingest pipeline Elasticsearch saya merupakan default_pipeline atau final_pipeline?
Elasticsearch menyediakan dua pengaturan tingkat indeks untuk mengonfigurasi ingest pipeline: index.default_pipeline dan index.final_pipeline. Pengaturan ini berbeda dalam tahap pemrosesan dan perilaku override.
default_pipeline
Pengaturan index.default_pipeline menentukan ingest pipeline yang diterapkan pada permintaan pengindeksan yang tidak secara eksplisit menentukan pipeline. Jika permintaan mencakup parameter ?pipeline=, pipeline yang ditentukan dalam permintaan akan menggantikan pipeline default.
final_pipeline
Pengaturan index.final_pipeline menentukan ingest pipeline yang selalu dijalankan paling akhir. Pipeline ini diterapkan setelah pipeline default dan pipeline yang ditentukan dalam permintaan. Berbeda dengan pipeline default, pipeline final tidak dapat diganti oleh parameter tingkat permintaan.
Periksa konfigurasi pipeline saat ini
Jalankan perintah berikut untuk memeriksa pipeline ingest yang dikonfigurasi untuk indeks tertentu:
GET /<index_name>/_settings?filter_path=*.settings.index.default_pipeline,*.settings.index.final_pipelineContoh tanggapan:
{
  "<index_name>": {
    "settings": {
      "index": {
        "default_pipeline": "my_default_pipeline",
        "final_pipeline": "my_final_pipeline"
      }
    }
  }
}
Jika baik default_pipeline maupun final_pipeline tidak dikembalikan dalam tanggapan, berarti tidak ada ingest pipeline yang dikonfigurasi untuk indeks tersebut.
Bagaimana cara menggunakan kueri scroll Elasticsearch untuk pengambilan data skala besar?
API scroll mengambil sejumlah besar hasil dari satu permintaan pencarian. Berbeda dengan pencarian biasa, scroll mempertahankan snapshot point-in-time, sehingga cocok untuk ekspor data massal atau pemrosesan batch. Jangan gunakan scroll untuk permintaan pencarian real-time yang berorientasi pengguna karena konteks scroll mengonsumsi sumber daya kluster dan tidak dioptimalkan untuk kueri latensi rendah.
Langkah 1: Mulai permintaan scroll awal
Kirim permintaan pencarian dengan parameter scroll untuk menentukan berapa lama konteks scroll tetap aktif. Misalnya, 1m menjaga konteks selama satu menit.
POST /<index_name>/_search?scroll=1m
{
  "size": 1000,
  "query": {
    "match_all": {}
  }
}
Tanggapan mencakup _scroll_id dan batch hasil pertama. Simpan _scroll_id untuk permintaan berikutnya.
Langkah 2: Ambil batch berikutnya
Gunakan _scroll_id dari tanggapan sebelumnya untuk mengambil batch hasil berikutnya.
POST /_search/scroll
{
  "scroll": "1m",
  "scroll_id": "<scroll_id_from_previous_response>"
}
Setiap tanggapan mengembalikan _scroll_id baru. Selalu gunakan _scroll_id terbaru untuk permintaan berikutnya.
Langkah 3: Ulangi hingga semua data diambil
Lanjutkan memanggil API scroll dengan _scroll_id terbaru hingga array hits.hits dalam tanggapan kosong. Array kosong menandakan bahwa semua dokumen yang sesuai telah diambil.
Langkah 4: Hapus konteks scroll
Setelah semua data diambil, hapus secara eksplisit konteks scroll untuk membebaskan sumber daya kluster.
DELETE /_search/scroll
{
  "scroll_id": "<scroll_id>"
}Konteks scroll mengonsumsi memori kluster. Selalu hapus konteks scroll ketika tidak lagi diperlukan, dan atur timeout scroll sesingkat mungkin untuk meminimalkan penggunaan sumber daya.
Bagaimana cara menemukan entri manajemen role di Kibana atau memodifikasi mapping indeks?
Manajemen role
Untuk mengelola role di Kibana, login ke Konsol Kibana instance Elasticsearch Alibaba Cloud Anda melalui konsol visual. Di panel navigasi kiri Kibana, buka Stack Management > Security > Roles untuk membuat atau mengedit role.
Modifikasi mapping indeks
Untuk instance Elasticsearch standar (bukan Edisi Lanjutan), mapping indeks tidak dapat dimodifikasi langsung di konsol Elasticsearch Alibaba Cloud. Untuk menambahkan field baru ke mapping indeks, lakukan langkah-langkah berikut:
-
Login ke Konsol Kibana instance Elasticsearch Alibaba Cloud Anda melalui konsol visual.
-
Di panel navigasi kiri Kibana, buka Stack Management > Index Management dan temukan indeks target.
-
Di panel navigasi kiri Kibana, buka Dev Tools.
-
Jalankan permintaan mapping
PUTuntuk menambahkan field baru ke indeks. Contoh:PUT /<index_name>/_mapping { "properties": { "new_field_name": { "type": "keyword" } } }
Elasticsearch hanya mendukung penambahan field baru ke mapping yang sudah ada. Mengubah tipe data field yang sudah ada tidak didukung. Untuk mengubah tipe field, buat indeks baru dengan mapping yang benar dan lakukan pengindeksan ulang data dari indeks asli.