Di DataWorks, Anda dapat membuat node E-MapReduce (EMR) MapReduce (MR) untuk memecah dataset besar menjadi tugas map paralel, sehingga secara signifikan meningkatkan efisiensi pemrosesan data. Topik ini menyediakan contoh pengembangan dan konfigurasi pekerjaan EMR MR yang membaca file teks dari Object Storage Service (OSS) dan menghitung jumlah kemunculan setiap kata di dalamnya.
Prasyarat
Anda telah membuat kluster Alibaba Cloud EMR dan mendaftarkannya ke DataWorks. Untuk informasi selengkapnya, lihat Data Studio: Bind an EMR computing resource.
-
(Opsional, untuk pengguna RAM) Pengguna RAM untuk pengembangan tugas telah ditambahkan ke ruang kerja yang sesuai dan diberikan peran Development atau Workspace Administrator (peran ini memiliki izin yang luas, berikan dengan hati-hati). Untuk informasi lebih lanjut tentang cara menambahkan anggota, lihat Add members to a workspace.
Jika Anda menggunakan akun Alibaba Cloud, Anda dapat melewati langkah ini.
Untuk mengikuti contoh dalam topik ini, buat bucket di Object Storage Service (OSS). Untuk informasi selengkapnya, lihat Create buckets.
Batasan
Anda hanya dapat menjalankan jenis node ini pada serverless resource group (disarankan) atau exclusive resource group for scheduling.
Untuk mengelola metadata kluster DataLake atau kluster kustom di DataWorks, Anda harus terlebih dahulu mengonfigurasi EMR-HOOK di kluster tersebut. Untuk informasi selengkapnya, lihat Configure Hive EMR-HOOK.
CatatanJika EMR-HOOK tidak dikonfigurasi di kluster, DataWorks tidak dapat menampilkan metadata secara real-time, menghasilkan log audit, menampilkan alur data, atau melakukan tugas tata kelola data terkait EMR.
Persiapkan data awal dan paket JAR
Persiapkan data awal
Buat file sampel bernama input01.txt dengan konten berikut.
hadoop emr hadoop dw
hive hadoop
dw emr
Unggah file data awal
Login ke OSS console. Di panel navigasi kiri, klik Buckets.
Klik nama bucket target Anda untuk membuka halaman File Management.
Contoh ini menggunakan bucket bernama
onaliyun-bucket-2.Klik Create Directory untuk membuat direktori bagi data awal dan resource JAR.
Atur Directory Name menjadi
emr/datas/wordcount02/inputsuntuk membuat direktori bagi data awal.Atur Directory Name menjadi
emr/jarsuntuk membuat direktori bagi resource JAR.
Unggah file data awal ke direktorinya.
Buka path
/emr/datas/wordcount02/inputsdan klik Upload File.Di area Files to Upload, klik Select Files, tambahkan file
input01.txtke bucket, lalu klik Upload File.
Buat pekerjaan MapReduce dan paket JAR
Buka proyek IntelliJ IDEA Anda dan tambahkan dependensi berikut ke file pom.xml Anda.
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-mapreduce-client-common</artifactId>
            <version>2.8.5</version> <!--Use version 2.8.5, which is the version used by EMR MR.-->
        </dependency>
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-common</artifactId>
            <version>2.8.5</version>
        </dependency>
Untuk membaca dan menulis file OSS dalam MapReduce, Anda harus mengonfigurasi parameter berikut.
PentingPeringatan risiko: Pasangan AccessKey akun Alibaba Cloud Anda memberikan akses penuh ke semua operasi API. Mengekspos ID AccessKey dan Secret AccessKey Anda membahayakan keamanan semua sumber daya di bawah akun Anda. Kami sangat menyarankan menggunakan pengguna RAM untuk panggilan API dan operasi sehari-hari. Jangan menyematkan ID AccessKey atau Secret AccessKey Anda secara langsung dalam kode proyek atau lokasi lain yang dapat diakses publik. Kode berikut hanya untuk tujuan demonstrasi. Lindungi informasi AccessKey Anda dengan aman.
conf.set("fs.oss.accessKeyId", "${accessKeyId}");
conf.set("fs.oss.accessKeySecret", "${accessKeySecret}");
conf.set("fs.oss.endpoint","${endpoint}");
Tabel berikut menjelaskan parameter tersebut.
${accessKeyId}: ID AccessKey akun Alibaba Cloud Anda.${accessKeySecret}: Secret AccessKey akun Alibaba Cloud Anda.${endpoint}: Titik akhir publik OSS. Titik akhir tersebut bergantung pada wilayah tempat kluster EMR Anda berada. Bucket OSS dan kluster harus berada di wilayah yang sama. Untuk informasi selengkapnya, lihat Regions and endpoints.
Kode Java berikut merupakan versi modifikasi dari contoh WordCount resmi Hadoop. Kode ini mencakup konfigurasi untuk ID AccessKey dan Secret AccessKey guna memberikan izin kepada pekerjaan untuk mengakses file OSS.
Setelah mengedit kode Java, kemas menjadi file JAR. Contoh ini menghasilkan file JAR bernama
onaliyun_mr_wordcount-1.0-SNAPSHOT.jar.
Prosedur
Pada tab konfigurasi node EMR MR, kembangkan tugas sebagai berikut:
Kembangkan tugas EMR MR
Pilih salah satu metode berikut sesuai kebutuhan Anda:
Metode 1: Unggah dan referensikan JAR
Anda juga dapat mengunggah resource dari mesin lokal ke DataStudio lalu mereferensikannya di node. Jika ukuran resource terlalu besar untuk diunggah melalui konsol DataWorks, Anda dapat menyimpannya di HDFS dan mereferensikannya dalam kode Anda.
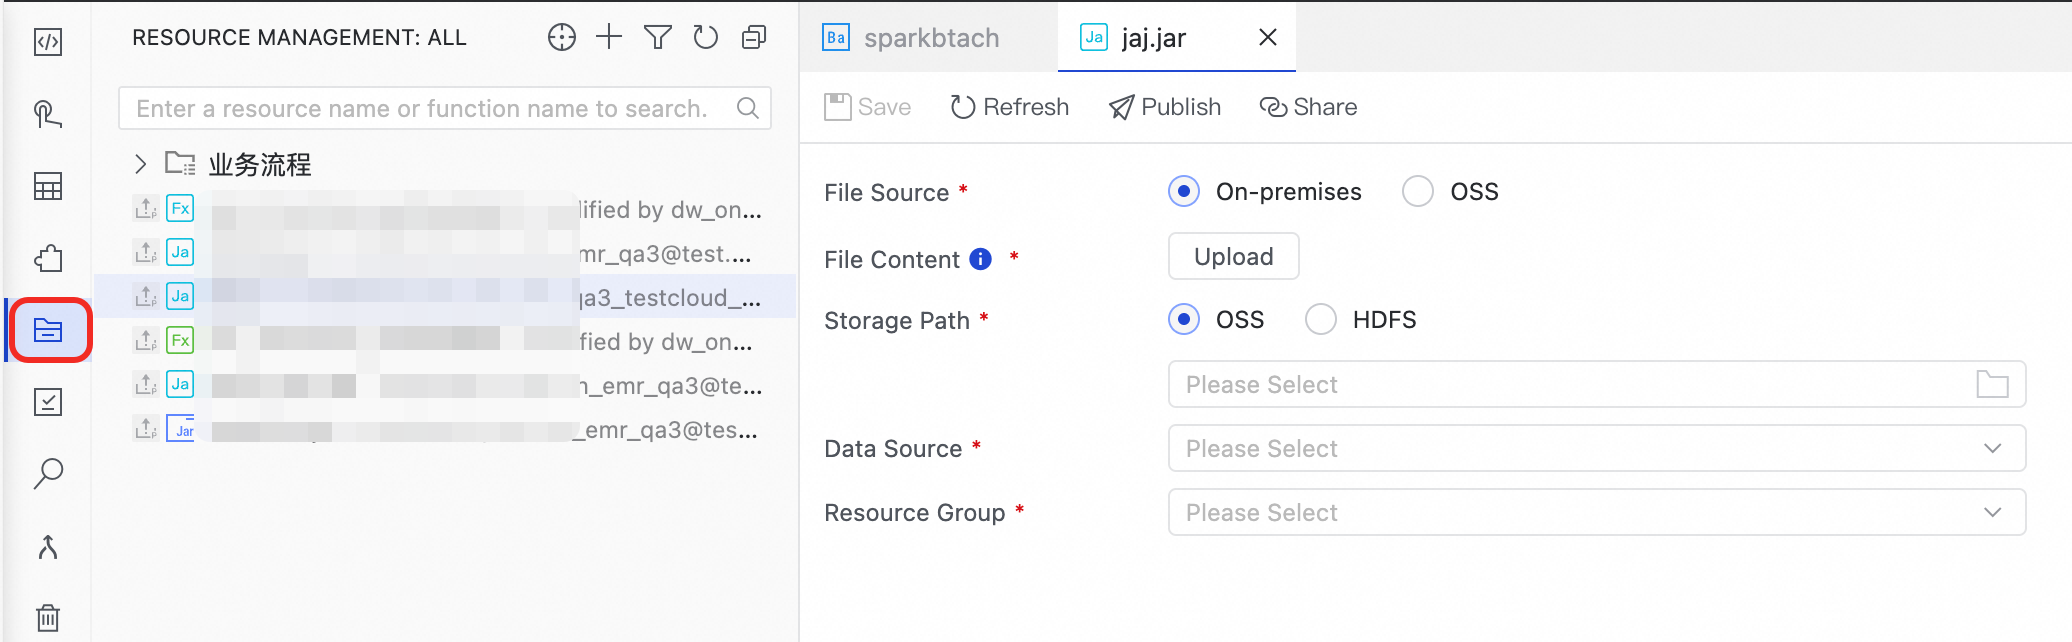
Buat resource JAR.
Untuk informasi selengkapnya, lihat Manage resources. Simpan paket JAR dari langkah Prepare initial data and a JAR package di direktori
emr/jars. Klik Click Upload.Konfigurasi parameter Storage Path, Data Sources, dan Resource Group.
Klik Save.
Referensikan resource JAR.
Buka node EMR MR untuk membuka tab konfigurasinya.
Di panel Resource Management di sebelah kiri, temukan resource yang ingin Anda referensikan. Dalam contoh ini, resource-nya adalah
onaliyun_mr_wordcount-1.0-SNAPSHOT.jar. Klik kanan resource tersebut dan pilih Insert Resource Path.Setelah mereferensikan resource, pernyataan referensi muncul di tab konfigurasi node EMR MR, yang menunjukkan bahwa resource berhasil direferensikan. Jalankan perintah berikut. Ganti paket resource, nama bucket, dan path dengan informasi aktual Anda.
##@resource_reference{"onaliyun_mr_wordcount-1.0-SNAPSHOT.jar"} onaliyun_mr_wordcount-1.0-SNAPSHOT.jar cn.apache.hadoop.onaliyun.examples.EmrWordCount oss://onaliyun-bucket-2/emr/datas/wordcount02/inputs oss://onaliyun-bucket-2/emr/datas/wordcount02/outputsCatatanKomentar tidak didukung di editor kode untuk node EMR MR.
Metode 2: Referensikan resource OSS
Anda dapat menggunakan metode OSS REF untuk langsung mereferensikan sumber daya dari OSS. Saat node berjalan, DataWorks secara otomatis mengunduh sumber daya OSS yang direferensikan ke lingkungan lokal. Metode ini sering digunakan dalam skenario di mana Tugas EMR bergantung pada file JAR atau skrip.
Unggah resource JAR.
Setelah mengembangkan kode, login ke OSS console. Di panel navigasi kiri, klik Buckets.
Klik nama bucket target Anda untuk membuka halaman File Management.
Contoh ini menggunakan bucket bernama
onaliyun-bucket-2.Unggah resource JAR ke direktorinya.
Buka direktori
emr/jars. Klik Upload File. Di area Files to Upload, klik Select Files, tambahkan fileonaliyun_mr_wordcount-1.0-SNAPSHOT.jar, lalu klik Upload File.
Referensikan resource JAR.
Pada tab konfigurasi node EMR MR, tulis kode untuk mereferensikan resource JAR.
hadoop jar ossref://onaliyun-bucket-2/emr/jars/onaliyun_mr_wordcount-1.0-SNAPSHOT.jar cn.apache.hadoop.onaliyun.examples.EmrWordCount oss://onaliyun-bucket-2/emr/datas/wordcount02/inputs oss://onaliyun-bucket-2/emr/datas/wordcount02/outputsCatatanPerintah tersebut memiliki format berikut:
hadoop jar <Path of the JAR to run> <Full name of the main class> <Input file directory> <Output directory>.Tabel berikut menjelaskan parameter untuk path JAR.
Parameter
Deskripsi
Path of the JAR to run
Formatnya adalah
ossref://{endpoint}/{bucket}/{object}Endpoint: Titik akhir publik OSS. Jika parameter ini dikosongkan, Anda hanya dapat mereferensikan resource dari bucket di wilayah yang sama dengan kluster EMR.
Bucket: Kontainer yang digunakan OSS untuk menyimpan objek. Setiap Bucket memiliki nama unik. Anda dapat login ke OSS console untuk melihat semua Bucket di bawah akun Anda.
object: Objek spesifik, yang bisa berupa file atau path, yang disimpan di dalam bucket.
(Opsional) Konfigurasi parameter lanjutan
Di panel kanan, klik tab Scheduling Settings. Anda dapat mengonfigurasi parameter berikut di bagian .
CatatanParameter lanjutan yang tersedia bervariasi tergantung jenis kluster EMR, seperti yang ditunjukkan pada tabel berikut.
Konfigurasi properti Spark open-source tambahan pada tab Scheduling Settings di bagian .
DataLake dan kluster kustom: EMR on ECS
Parameter
Deskripsi
queue
Antrian tempat pekerjaan dikirimkan. Nilai default-nya adalah default. Untuk informasi selengkapnya tentang EMR YARN, lihat Basic queue configurations.
priority
Prioritas pekerjaan. Nilai default-nya adalah 1.
FLOW_SKIP_SQL_ANALYZE
Mode eksekusi untuk pernyataan SQL. Nilai yang valid:
true: Mengeksekusi beberapa pernyataan SQL sekaligus.false(Default): Mengeksekusi satu pernyataan SQL dalam satu waktu.
CatatanParameter ini hanya didukung untuk pengujian di lingkungan pengembangan data.
Others
Anda juga dapat menambahkan parameter pekerjaan MR kustom di bagian konfigurasi lanjutan. Saat Anda meng-commit kode, DataWorks secara otomatis menambahkan parameter baru tersebut ke perintah menggunakan pernyataan
-D key=value.Kluster Hadoop: EMR on ECS
Parameter
Deskripsi
queue
Antrian tempat pekerjaan dikirimkan. Nilai default-nya adalah default. Untuk informasi selengkapnya tentang EMR YARN, lihat Basic queue configurations.
priority
Prioritas pekerjaan. Nilai default-nya adalah 1.
USE_GATEWAY
Menentukan apakah pekerjaan dikirimkan dari node ini melalui kluster gateway. Nilai yang valid:
true: Mengirimkan pekerjaan melalui kluster gateway.false(Default): Tidak mengirimkan pekerjaan melalui kluster gateway. Pekerjaan dikirimkan ke node master secara default.
CatatanJika Anda mengatur parameter ini ke
truetetapi kluster node tersebut tidak dikaitkan dengan kluster gateway, pengiriman pekerjaan EMR akan gagal.Jalankan tugas
Di Run Configuration, di bawah Compute Resource, konfigurasi Compute Resource dan Resource Group.
CatatanAnda juga dapat menentukan CUs for Scheduling sesuai kebutuhan tugas Anda. Nilai default-nya adalah
0.25.Untuk mengakses sumber data melalui internet publik atau di Virtual Private Cloud (VPC), Anda harus menggunakan resource group untuk penjadwalan yang dapat terhubung ke sumber data tersebut. Untuk informasi selengkapnya, lihat Network connectivity solutions.
Di kotak dialog parameter di bilah alat, pilih sumber data yang telah Anda buat lalu klik Run.
Jika Anda perlu menjalankan tugas node secara berkala, konfigurasikan properti penjadwalannya. Untuk informasi selengkapnya, lihat Configure scheduling properties for a node.
Setelah mengonfigurasi node, Anda harus mendeploynya. Untuk informasi selengkapnya, lihat Deploy nodes.
Setelah tugas dideploy, Anda dapat melihat statusnya di Operation Center. Untuk informasi selengkapnya, lihat Introduction to Operation Center.
Lihat hasilnya
Login ke OSS console. Anda dapat melihat file output di direktori tujuan dalam bucket Anda. Dalam contoh ini, path-nya adalah emr/datas/wordcount02/outputs.

Baca hasil statistik di DataWorks.
Buat node EMR Hive. Untuk informasi selengkapnya, lihat Create a node for a scheduled workflow.
Di node EMR Hive, buat tabel eksternal Hive yang dipetakan ke data di OSS, lalu kueri data tabel tersebut. Berikut adalah kode contohnya:
CREATE EXTERNAL TABLE IF NOT EXISTS wordcount02_result_tb
(
    `word` STRING COMMENT 'Word',
    `count` STRING COMMENT 'Count'
)
ROW FORMAT delimited fields terminated by '\t'
location 'oss://onaliyun-bucket-2/emr/datas/wordcount02/outputs/';

SELECT * FROM wordcount02_result_tb;
Gambar berikut menunjukkan hasilnya.
