Pour détecter les anomalies, utilisez une fonction de prédiction et de détection d'anomalies afin de prévoir une courbe de série temporelle et d'identifier les écarts Ksigma ainsi que les quantiles entre la courbe prévue et la courbe réelle.
Liste des fonctions
|
Fonction |
Description |
|
Utilise des paramètres par défaut pour modéliser les données de série temporelle et effectue une prédiction simple ainsi qu'une détection d'anomalies. |
|
|
Recourt à un modèle autorégressif (AR) pour modéliser les données de série temporelle et réalise une prédiction simple accompagnée d'une détection d'anomalies. |
|
|
S'appuie sur un modèle autorégressif à moyenne mobile (ARMA) pour modéliser les données de série temporelle et exécute une prédiction simple avec détection d'anomalies. |
|
|
Employe un modèle autorégressif intégré à moyenne mobile (ARIMA) pour modéliser les données de série temporelle et assure une prédiction simple ainsi qu'une détection d'anomalies. |
|
|
Prédit avec précision la tendance d'une courbe de série temporelle périodique. Scénario : Cette fonction permet de prévoir des données de facturation, le trafic réseau, des données financières et diverses données métier suivant certaines règles. |
|
|
Filtre les anomalies détectées lors de l'analyse de plusieurs courbes de séries temporelles selon un mode d'anomalie personnalisé. Cette fonction vous aide à identifier rapidement les courbes anormales. |
ts_predicate_simple
Format de la fonction :
select ts_predicate_simple(x, y, nPred, isSmooth) Le tableau suivant répertorie les paramètres du format de la fonction.
|
Paramètre |
Description |
Valeur |
|
x |
La séquence temporelle. Les points temporels sont triés par ordre croissant sur l'axe horizontal. |
Chaque point temporel correspond à un horodatage Unix. Unité : secondes. |
|
y |
La séquence de données numériques correspondant à chaque point temporel spécifié. |
S.O. |
|
nPred |
Le nombre de points à prédire. |
La valeur est de type long et doit être supérieure ou égale à 1. |
|
isSmooth |
Indique s'il faut filtrer les données brutes. |
La valeur est de type booléen. La valeur par défaut est true, ce qui signifie que les données brutes sont filtrées. |
Exemple :
-
L'instruction de requête est la suivante :
* | select ts_predicate_simple(stamp, value, 6) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp) Résultat de sortie
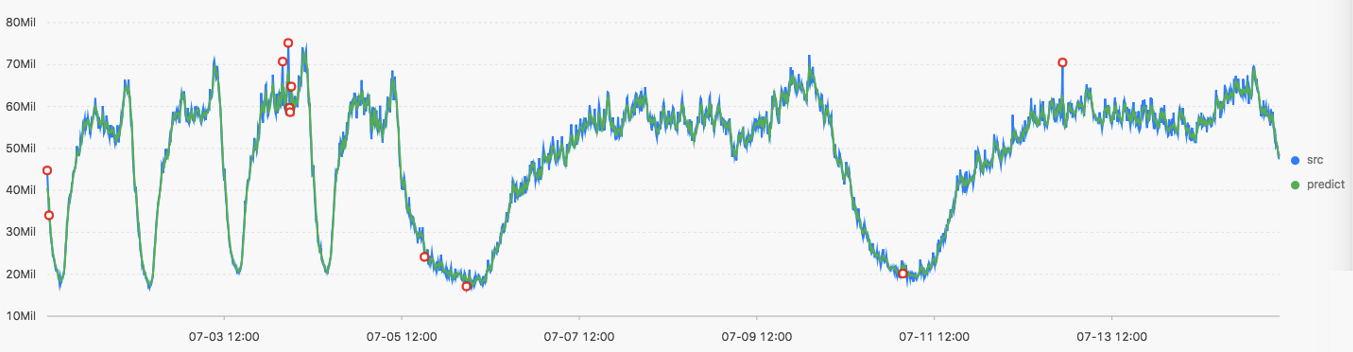
Le tableau suivant liste les éléments affichés.
Élément affiché | Description | |
Axe horizontal | unixtime | L'horodatage Unix des données. Unité : secondes. |
Axe vertical | src | Les données brutes. |
predict | Les données générées après l'opération de filtrage. | |
upper | La limite supérieure de l'intervalle de confiance. Le niveau de confiance est de 0,85 et ne peut pas être modifié. | |
lower | La limite inférieure de l'intervalle de confiance. Le niveau de confiance est de 0,85 et ne peut pas être modifié. | |
anomaly_prob | La probabilité que le point soit une anomalie. Valeurs valides : [0, 1]. | |
ts_predicate_ar
Format de la fonction :
select ts_predicate_ar(x, y, p, nPred, isSmooth) Le tableau suivant répertorie les paramètres du format de la fonction.
|
Paramètre |
Description |
Valeur |
|
x |
La séquence temporelle. Les points temporels sont triés par ordre croissant sur l'axe horizontal. |
Chaque point temporel correspond à un horodatage Unix. Unité : secondes. |
|
y |
La séquence de données numériques correspondant à chaque point temporel spécifié. |
S.O. |
|
p |
L'ordre du modèle AR. |
La valeur est de type long. Valeurs valides : 2, 3, 4, 5, 6, 7 et 8. |
|
nPred |
Le nombre de points à prédire. |
La valeur est de type long. Valeurs valides : [1, 5 × p]. |
|
isSmooth |
Indique s'il faut filtrer les données brutes. |
La valeur est de type booléen. La valeur par défaut est true, ce qui signifie que les données brutes sont filtrées. |
Voici un exemple d'instruction de requête :
* | select ts_predicate_ar(stamp, value, 3, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp)Le résultat de sortie est similaire à celui de la fonction ts_predicate_simple. Pour plus de détails, reportez-vous au résultat de sortie de la fonction ts_predicate_simple.
ts_predicate_arma
Format de la fonction :
select ts_predicate_arma(x, y, p, q, nPred, isSmooth) Le tableau suivant répertorie les paramètres du format de la fonction.
|
Paramètre |
Description |
Valeur |
|
x |
La séquence temporelle. Les points temporels sont triés par ordre croissant sur l'axe horizontal. |
Chaque point temporel correspond à un horodatage Unix. Unité : secondes. |
|
y |
La séquence de données numériques correspondant à chaque point temporel spécifié. |
S.O. |
|
p |
L'ordre du modèle AR. |
La valeur est de type long. Valeurs valides : [2, 100]. |
|
q |
L'ordre du modèle ARMA. |
La valeur est de type long. Valeurs valides : 2, 3, 4, 5, 6, 7 et 8. |
|
nPred |
Le nombre de points à prédire. |
La valeur est de type long. Valeurs valides : [1, 5 × p]. |
|
isSmooth |
Indique s'il faut filtrer les données brutes. |
La valeur est de type booléen. La valeur par défaut est true, ce qui signifie que les données brutes sont filtrées. |
Voici un exemple d'instruction de requête :
* | select ts_predicate_arma(stamp, value, 3, 2, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp) Le résultat de sortie est similaire à celui de la fonction ts_predicate_simple. Pour plus de détails, reportez-vous au résultat de sortie de la fonction ts_predicate_simple.
ts_predicate_arima
Format de la fonction :
select ts_predicate_arima(x, y, p, d, q, nPred, isSmooth) Le tableau suivant répertorie les paramètres du format de la fonction.
|
Paramètre |
Description |
Valeur |
|
x |
La séquence temporelle. Les points temporels sont triés par ordre croissant sur l'axe horizontal. |
Chaque point temporel correspond à un horodatage Unix. Unité : secondes. |
|
y |
La séquence de données numériques correspondant à chaque point temporel spécifié. |
S.O. |
|
p |
L'ordre du modèle AR. |
La valeur est de type long. Valeurs valides : 2, 3, 4, 5, 6, 7 et 8. |
|
d |
L'ordre du modèle ARIMA. |
La valeur est de type long. Valeurs valides : [1, 3]. |
|
q |
L'ordre du modèle ARMA. |
La valeur est de type long. Valeurs valides : 2, 3, 4, 5, 6, 7 et 8. |
|
nPred |
Le nombre de points à prédire. |
La valeur est de type long. Valeurs valides : [1, 5 × p]. |
|
isSmooth |
Indique s'il faut filtrer les données brutes. |
La valeur est de type booléen. La valeur par défaut est true, ce qui signifie que les données brutes sont filtrées. |
Voici un exemple d'instruction de requête :
* | select ts_predicate_arima(stamp, value, 3, 1, 2, 4) from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log GROUP BY stamp order by stamp)Le résultat de sortie est similaire à celui de la fonction ts_predicate_simple. Pour plus de détails, reportez-vous au résultat de sortie de la fonction ts_predicate_simple.
ts_regression_predict
Format de la fonction :
select ts_regression_predict(x, y, nPred, algotype,processType)Le tableau suivant répertorie les paramètres du format de la fonction.
Paramètre | Description | Valeur |
x | La séquence temporelle. Les points temporels sont triés par ordre croissant sur l'axe horizontal. | Chaque point temporel correspond à un horodatage Unix. Unité : secondes. |
y | La séquence de données numériques correspondant à chaque point temporel spécifié. | S.O. |
nPred | Le nombre de points à prédire. | La valeur est de type long. Valeurs valides : [1, 500]. |
algotype | Le type d'algorithme utilisé pour la prédiction. | Valeurs valides :
|
processType | Indique s'il faut prétraiter les données. | Valeurs valides :
|
Exemple :
-
L'instruction de requête est la suivante :
* and h : nu2h05202.nu8 and m: NET | select ts_regression_predict(stamp, value, 200, 'origin') from (select ("__time__" - ("__time__" % 60)) as stamp, avg(v) as value from log group by stamp order by stamp) Résultat de sortie
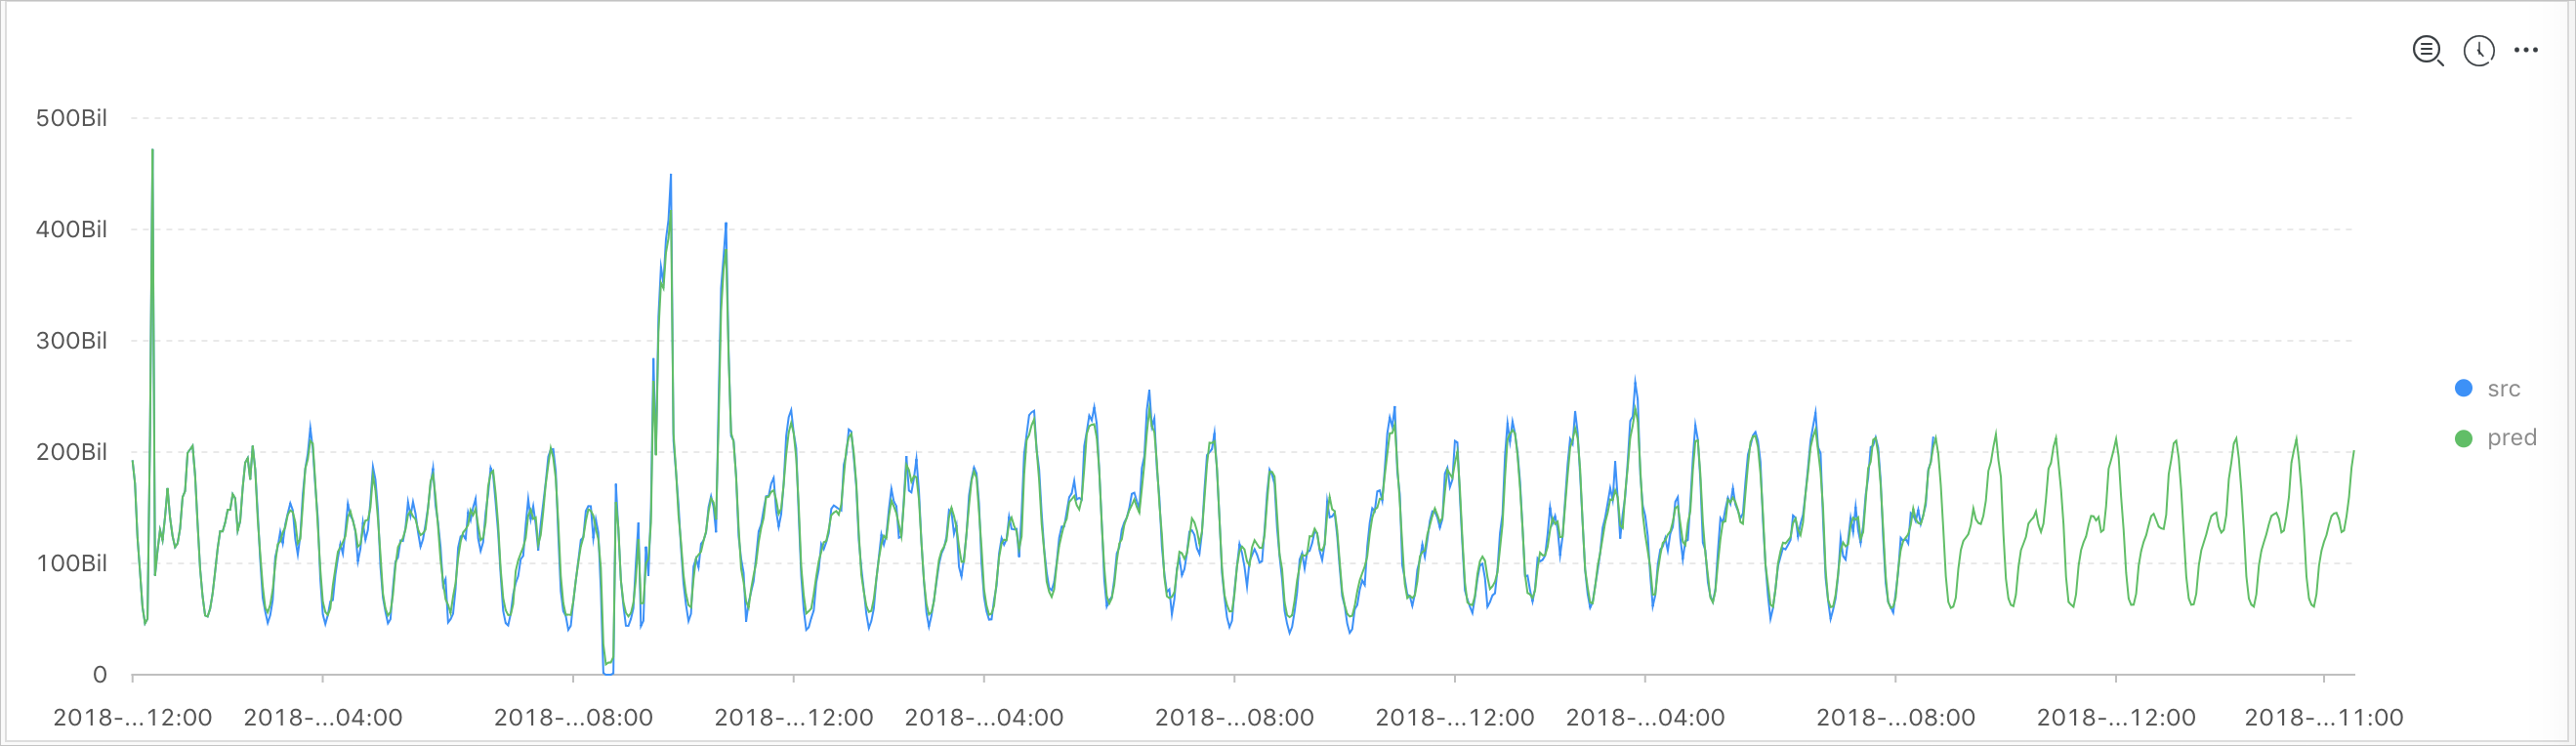
Le tableau suivant liste les éléments affichés.
Élément affiché | Description | |
Axe horizontal | unixtime | L'horodatage Unix des données. Unité : secondes. |
Axe vertical | src | Les données brutes. |
predict | Les données générées après l'opération de filtrage. | |
ts_anomaly_filter
Format de la fonction :
select ts_anomaly_filter(lineName, ts, ds, preds, probs, nWatch, anomalyType)Le tableau suivant répertorie les paramètres du format de la fonction.
Paramètre | Description | Valeur |
lineName | Le nom de chaque courbe. La valeur est de type varchar. | S.O. |
ts | La séquence temporelle de la courbe, indiquant le temps sur la courbe actuelle. La valeur du paramètre est un tableau de points temporels de type double, triés par ordre croissant. | S.O. |
ds | La séquence de valeurs réelles de la courbe. La valeur du paramètre est un tableau de points de données de type double. Cette valeur a la même longueur que celle du paramètre ts. | S.O. |
preds | La séquence de valeurs prédites de la courbe. La valeur du paramètre est un tableau de points de données de type double. Cette valeur a la même longueur que celle du paramètre ts. | S.O. |
probs | La séquence des résultats de détection d'anomalies de la courbe. La valeur du paramètre est un tableau de points de données de type double. Cette valeur a la même longueur que celle du paramètre ts. | S.O. |
nWatch | Le nombre de valeurs réelles récemment observées sur la courbe. La valeur est de type long. Elle doit être inférieure au nombre de points temporels sur la courbe. | S.O. |
anomalyType | Le type d'anomalie à filtrer. La valeur est de type long. | Valeurs valides :
|
Exemple :
-
L'instruction de requête est la suivante :
* | select res.name, res.ts, res.ds, res.preds, res.probs from ( select ts_anomaly_filter(name, ts, ds, preds, probs, cast(5 as bigint), cast(1 as bigint)) as res from ( select name, res[1] as ts, res[2] as ds, res[3] as preds, res[4] as uppers, res[5] as lowers, res[6] as probs from ( select name, array_transpose(ts_predicate_ar(stamp, value, 10)) as res from ( select name, stamp, value from log where name like '%asg-%') group by name)) ); -
Résultat de sortie
| name                     | ts                                                   | ds          | preds     | probs       |
| ------------------------ | ---------------------------------------------------- | ----------- | --------- | ----------- |
| asg-bp1hylzdi2wx7civ0ivk | [1.5513696E9, 1.5513732E9, 1.5513768E9, 1.5513804E9] | [1,2,3,NaN] | [1,2,3,4] | [0,0,1,NaN] |