L'In-Memory Column Index (IMCI) ajoute une couche de stockage en colonnes et de calcul en mémoire à PolarDB for MySQL. Cette fonctionnalité permet le traitement hybride transactionnel et analytique (HTAP) sur un seul cluster, sans sacrifier les performances OLTP ni exiger la migration de vos données.
Pourquoi MySQL nécessite un stockage en colonnes
MySQL a été conçu pour le traitement des transactions en ligne (OLTP) : recherches par ligne unique, écritures concurrentes et transactions à faible latence. Les clusters PolarDB stockant couramment des centaines de téraoctets, les utilisateurs ont de plus en plus besoin d'analyses en temps réel sur les mêmes données que celles qui alimentent leurs applications. Trois approches architecturales ont émergé pour répondre à ce besoin.
MySQL + base de données AP dédiée
Cette approche déploie deux systèmes distincts — MySQL pour l'OLTP et une base de données OLAP spécialisée pour l'analytique — reliés par un pipeline de synchronisation. Bien qu'elle offre le meilleur moteur pour chaque charge de travail, son coût reste élevé : maintenance de deux piles technologiques, latence de synchronisation rendant les données analytiques obsolètes, et absence de chemin simple vers une cohérence en temps réel.

Conception divergente multi-réplicas
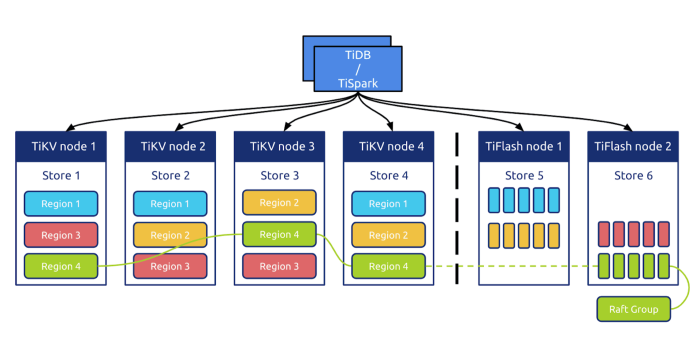
Les bases de données NewSQL distribuées comme TiDB (à partir de la version 4.0) attribuent différents formats de stockage aux réplicas au sein de chaque groupe Raft. Un réplica exécute TiFlash, un stockage en colonnes, pour traiter les requêtes analytiques, tandis que les autres gèrent l'OLTP. Un routage intelligent sélectionne automatiquement le réplica approprié. Cette solution fonctionne bien pour les nouveaux déploiements, mais exige une migration depuis MySQL, source de problèmes de compatibilité.
Stockage hybride ligne-colonne intégré
L'approche la plus avancée stocke simultanément des données orientées lignes et colonnes dans la même instance de base de données. Toutes les grandes bases de données commerciales utilisent cette conception :
Oracle a introduit la suite Database In-Memory dans Oracle Database 12c (2013), exploitant un stockage en colonnes en mémoire avec une exécution hybride ligne-colonne et des optimisations de requêtes basées sur des expressions matérialisées et JoinGroup.
SQL Server a ajouté les index columnstore dans SQL Server 2016 SP1, prenant en charge les tables orientées lignes, les tables orientées colonnes et les combinaisons hybrides.
IBM Db2 a livré BLU Acceleration dans Kepler 10.5 (2013), combinant stockage en colonnes, calcul en mémoire et saut de données (data skipping).

Ces trois systèmes ont convergé vers cette conception pour la même raison : un stockage en colonnes offre une meilleure efficacité d'E/S (compression, saut de données, élagage de colonnes) et une meilleure efficacité CPU (modèles d'accès favorables au cache). Cependant, les index de stockage en colonnes sont clairsemés et ne permettent pas de localiser efficacement des lignes individuelles comme le ferait un index B+ tree. Un moteur hybride ligne-colonne résout ce problème : le stockage en lignes gère l'OLTP avec une indexation précise au niveau de la ligne, tandis que le stockage en colonnes accélère les scans analytiques en masse. La faible latence de la DRAM compense l'écart de performance lors des mises à jour du stockage en colonnes.
Pourquoi PolarDB nécessitait un nouveau moteur d'exécution
La pile de capacités de PolarDB reflète celle de MySQL open source. Bien que PolarDB gère efficacement l'OLTP et prenne en charge jusqu'à 500 To de données par cluster, les requêtes analytiques complexes restent lentes. Ces goulots d'étranglement sont inhérents à l'architecture de MySQL :
Modèle d'exécution en série. Le modèle d'itérateur Volcan de MySQL traite une ligne à la fois. Chaque récupération de ligne déclenche plusieurs couches d'appels de fonctions, y compris la distribution de fonctions virtuelles. Cela nuit à l'efficacité du pipeline CPU et empêche l'utilisation des instructions SIMD.
Absence de requête parallèle. L'exécuteur de MySQL est monothread. La prise en charge des requêtes parallèles dans MySQL 8.0 ne couvre que des opérations de base telles que
COUNT(*); les requêtes SQL analytiques complexes s'exécutent en série, quel que soit le nombre de cœurs CPU disponibles.Gaspillage d'E/S du stockage en lignes. Lorsqu'une requête analytique n'a besoin que de 3 colonnes d'une table de 50 colonnes, MySQL lit tout de même les 50 colonnes depuis le disque. Le format de stockage en lignes rend l'accès sélectif aux colonnes intrinsèquement inefficace.
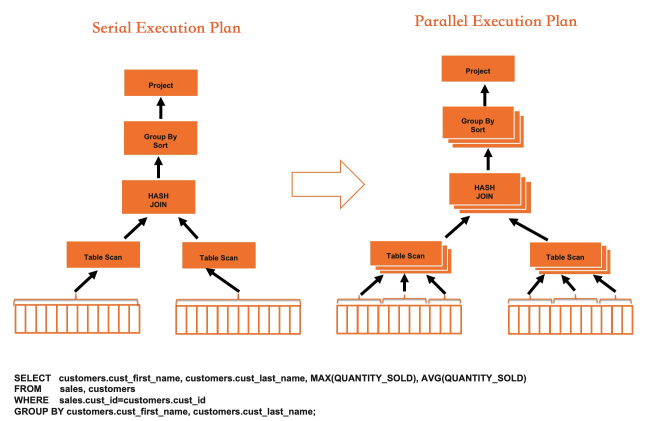
Le framework de requêtes parallèles de PolarDB répond au goulot d'étranglement CPU en répartissant le travail de scan sur plusieurs threads et en agrégeant les résultats sur le thread principal :
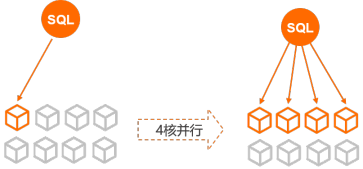
La requête parallèle brise le plafond du cœur unique et réduit le temps de requête pour les charges de travail intensives en scans. Toutefois, l'inefficacité des E/S du stockage en lignes impose une limite que l'exécution parallèle seule ne peut franchir. Seul un stockage en colonnes permet d'éliminer ce plafond.
Un stockage en colonnes améliore les performances à deux niveaux :
Efficacité des E/S. Les requêtes ne lisent que les colonnes nécessaires. Les données en colonnes se compressent avec une efficacité supérieure à 10x par rapport au stockage en lignes. Combiné à des index approximatifs (statistiques MIN/MAX par bloc de données), cela permet de sauter de grands blocs de données non pertinentes avant la décompression. Dans l'architecture à séparation calcul-stockage de PolarDB, la réduction des données transférées sur le réseau accélère directement la réponse aux requêtes.
Efficacité CPU. Le stockage contigu des données en colonnes améliore les taux de réussite du cache CPU et réduit les arrêts dus aux défauts de cache L1/L2. Cette contiguïté permet également la vectorisation SIMD, multipliant ainsi le débit sur un seul cœur.
Termes clés
| Terme | Définition |
|---|---|
| IMCI | In-Memory Column Index. Implémentation par PolarDB d'un stockage hybride ligne-colonne. |
| Index colonnaire | Index secondaire dans InnoDB stockant les données en format colonnaire plutôt qu'en format ligne. |
| Groupe de lignes | Unité d'organisation des données dans un index colonnaire. Chaque groupe contient 64 000 lignes. |
| Data pack | Données d'une seule colonne au sein d'un groupe de lignes, stockées de manière contiguë et compressée. |
| Index approximatif | Statistiques précalculées (MIN, MAX, SUM, nombre de valeurs nulles, nombre de lignes) pour chaque data pack, utilisées pour sauter les data packs non pertinents sans les décompresser. |
| Zone de stockage en colonnes en mémoire | Région mémoire où les data packs actifs sont mis en cache pour l'exécution des requêtes. Les données en colonnes sont compressées sur le disque et mises en cache ici. |
| Degré de parallélisme (DOP) | Nombre de threads parallèles utilisés pour exécuter une requête. Le DOP automatique sélectionne cette valeur automatiquement en fonction des ressources système. |
| Modèle Volcan | Modèle d'exécution de requêtes où chaque opérateur expose une interface Next(), extrayant les données des opérateurs enfants une ligne (ou un lot) à la fois. |
| Exécution vectorisée | Variante du modèle Volcan où chaque appel Next() renvoie un lot de lignes plutôt qu'une seule ligne, permettant l'accélération SIMD. |
Fonctionnement de l'IMCI
L'IMCI combine quatre innovations techniques :
Index columnaires dans InnoDB. Créez des index columnaires sur des colonnes sélectionnées à l'aide d'instructions DDL. Ces index utilisent un stockage compressé en colonnes — nettement plus compact que le stockage en lignes — et résident par défaut dans la zone de stockage en colonnes en mémoire. En cas de mémoire insuffisante, ils débordent sur le stockage partagé.
Moteur d'exécution orienté colonnes. L'exécuteur de PolarDB accède aux données par lots de 4 096 lignes et applique des instructions SIMD pour traiter plusieurs valeurs en une seule opération CPU. Tous les opérateurs clés (Scan, Hash Join, Nested Loop Join, Group By) prennent en charge l'exécution parallèle. Comparé à l'exécuteur en lignes de MySQL, l'exécuteur en colonnes offre des performances supérieures de plusieurs ordres de grandeur sur les charges de travail analytiques.
Optimiseur hybride ligne-colonne. Lors de la soumission d'une requête, l'optimiseur évalue le coût de trois chemins d'exécution — exécution en série sur stockage en lignes, requête parallèle sur stockage en lignes, et IMCI — et sélectionne le plan le moins coûteux. Un mécanisme de liste d'autorisation garantit que les requêtes utilisant des types de colonnes ou des opérateurs non pris en charge basculent automatiquement vers le stockage en lignes, préservant ainsi une compatibilité MySQL à 100 %.
Isolation des charges de travail AP/TP. Configurez un nœud en lecture seule (RO) dédié comme nœud analytique avec des index columnaires. Les requêtes analytiques s'exécutent sur le nœud RO en utilisant toutes les ressources CPU et mémoire disponibles, sans impact sur les charges de travail OLTP s'exécutant sur les nœuds en lecture/écriture (RW).

Architecture technique
Optimiseur hybride ligne-colonne
L'optimiseur décide d'exécuter une requête sur le stockage en lignes, le moteur de requête parallèle ou l'IMCI. Cela implique deux mécanismes : une liste d'autorisation pour la compatibilité et une sélection de plan basée sur les coûts pour la performance.
Atteindre une compatibilité MySQL à 100 %
Toutes les requêtes ne peuvent pas s'exécuter sur l'IMCI. Deux contraintes limitent la couverture :
Couverture des colonnes. Une requête référençant des colonnes non incluses dans un index colonnaire ne peut pas utiliser l'IMCI pour ces colonnes.
Couverture des opérateurs. Le moteur d'exécution IMCI est une réécriture complète, et non une extension de l'exécuteur en lignes de MySQL. Certains types de colonnes, opérateurs et formes d'expressions ne sont pas encore implémentés dans le moteur IMCI.
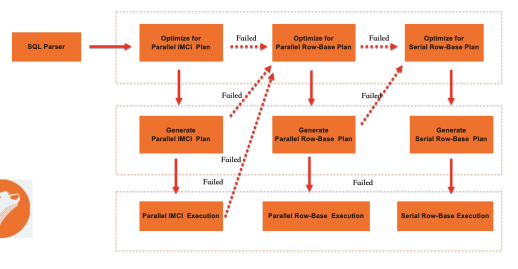
Le mécanisme de liste d'autorisation vérifie les types de données, les opérateurs, les expressions et les scénarios non pris en charge (tels que les instructions multiples) par rapport à une liste de référence valide. Si une requête passe la liste d'autorisation, elle est éligible à l'exécution IMCI. Dans le cas contraire, elle bascule vers l'exécuteur en lignes natif de MySQL. Ce repli garantit une compatibilité à 100 % : l'IMCI accélère ce qu'il peut, et MySQL gère le reste.
Conversion du plan de requête
La conversion de plan transforme la représentation en arbre de syntaxe abstraite (AST) de MySQL en un plan logique IMCI. Le processus parcourt l'arbre du plan d'exécution et réécrit les nœuds AST sous forme d'opérateurs relationnels, en gérant les conversions de types implicites pour maintenir la compatibilité avec le système de types flexible de MySQL.
Le plan logique est ensuite optimisé en un plan physique. Outre les optimisations standard (sélection entre Hash Join et Nested Loop Join), l'optimiseur IMCI convertit les sous-requêtes que l'exécuteur IMCI ne peut pas gérer directement en opérations de jointure équivalentes.
Sélection tripartite basée sur les coûts
L'optimiseur de PolarDB choisit parmi trois chemins d'exécution :
| Chemin d'exécution | Description | Compatibilité | Performance sur les charges AP |
|---|---|---|---|
| Exécution en série sur stockage en lignes | Exécuteur natif monothread de MySQL | La plus élevée | La plus faible |
| Requête parallèle sur stockage en lignes | Exécution multithread sur des données en stockage en lignes | Élevée | Moyenne |
| IMCI | Exécution vectorisée et parallèle sur des index columnaires | Couverture SQL la plus restreinte | La plus élevée |
L'optimiseur suit ce processus :
Analysez l'instruction SQL et générez un plan logique. Transmettez le plan à la fois à l'optimiseur natif de MySQL et au compilateur de plans de l'IMCI.
Calculez le coût d'exécution sur le stockage en lignes. S'il dépasse un seuil défini, tentez de pousser la requête vers l'IMCI.
Si l'IMCI ne peut pas exécuter la requête, tentez de générer un plan de requête parallèle.
Si ni l'IMCI ni la requête parallèle ne peuvent traiter la requête, revenez à l'exécution en série sur le stockage en lignes.
Ce modèle de coût suppose que l'IMCI surpasse la requête parallèle, qui elle-même surpasse l'exécution en série. En pratique, une jointure d'index parallèle sur des index de stockage en lignes peut parfois être moins coûteuse qu'une jointure par fusion-tri sur un stockage en colonnes. L'optimiseur peut sélectionner l'IMCI dans des cas où un plan de stockage en lignes serait plus rapide.
Moteur d'exécution orienté colonnes
Le moteur d'exécution IMCI est une réécriture complète, indépendante de l'exécuteur en lignes de MySQL. Son objectif est d'éliminer deux goulots d'étranglement fondamentaux : la surcharge des fonctions virtuelles par ligne et l'incapacité à paralléliser l'exécution.
Exécuteur parallèle vectorisé
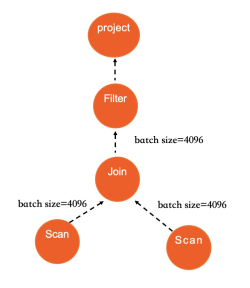
Le moteur utilise un modèle Volcan modifié : chaque appel Next() renvoie un lot de 4 096 lignes au lieu d'une seule ligne à la fois. Ce modèle de traitement par lots permet deux optimisations :
Vectorisation. Le traitement des données par lots orientés colonnes rend les instructions SIMD applicables. Au lieu d'une opération par cycle d'horloge CPU, les instructions SIMD traitent plusieurs valeurs simultanément. Combinée au stockage contigu des colonnes, qui maximise l'utilisation du cache CPU, l'exécution vectorisée atteint un débit sur un seul cœur nettement supérieur à celui de l'exécuteur en lignes de MySQL.
Exécution parallèle. Scan, Hash Join, Nested Loop Join et Group By prennent tous en charge l'exécution parallèle. Lorsque l'optimiseur détermine qu'un scan de table dépasse le seuil d'exécution parallèle, il calcule un DOP recommandé en fonction des ressources CPU, mémoire et E/S disponibles, de la file d'attente des tâches planifiées, de la complexité de la requête et des paramètres configurables. Tous les opérateurs d'un plan utilisent le même DOP. Remplacez le DOP pour une requête spécifique à l'aide de hints.
Le diagramme suivant illustre l'exécution d'un Hash Join dans l'IMCI, montrant comment la parallélisation et la vectorisation fonctionnent ensemble :
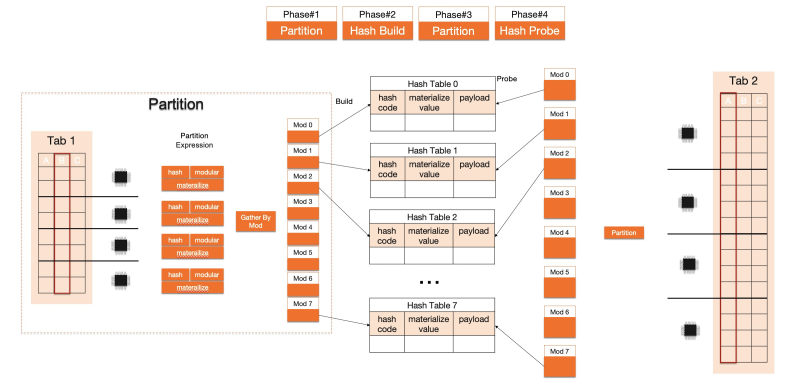
La vectorisation augmente le débit sur un seul cœur ; le parallélisme brise le plafond du cœur unique. Ensemble, ils rendent le moteur d'exécution IMCI plusieurs ordres de grandeur plus rapide que l'exécuteur en lignes de MySQL sur les requêtes SQL analytiques.
Système d'expressions vectorisé
Le SQL analytique repose fortement sur les expressions : filtres, projections, agrégations et colonnes calculées impliquent tous l'évaluation d'expressions. Dans l'exécuteur en lignes de MySQL, chaque évaluation de ligne déclenche un parcours récursif de l'arbre d'expression, avec un appel de fonction virtuelle par nœud d'expression et par ligne. Ce modèle nuit aux caches CPU et à la prédiction de branchement.
Le système d'expression IMCI remplace le modèle d'itérateur d'arbre par deux optimisations :
Traitement par lots avec SIMD. Comme les données en colonnes sont contiguës, la même expression peut être appliquée à un lot entier de valeurs à l'aide d'instructions SIMD. PolarDB réécrit le noyau d'expression pour les types de données courants — opérations arithmétiques (+, -, ×, /, et abs) sur INT, DECIMAL et DOUBLE — en utilisant les instructions AVX512. Le débit sur un seul cœur est amélioré plusieurs fois par rapport à l'exécution scalaire.
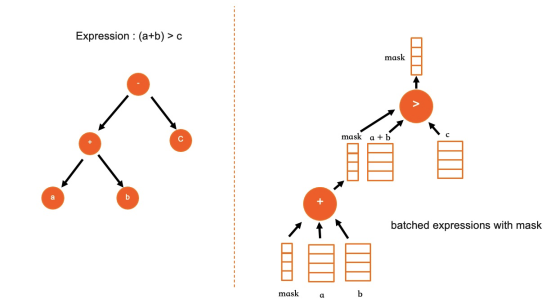
Disposition linéaire des expressions. Lors de la compilation de la requête, les expressions IMCI sont stockées sous forme d'arbre (similaire à la structure de MySQL). Avant l'exécution, l'arbre est aplati en un tableau unidimensionnel selon un parcours post-fixe. L'exécution itère linéairement sur le tableau, éliminant totalement les appels de fonctions récursives. Cette disposition linéaire sépare également les données du calcul, ce qui simplifie l'exécution parallèle.
Stockage hybride ligne-colonne
L'OLTP et l'OLAP ont des exigences de stockage fondamentalement différentes. L'OLTP nécessite une indexation précise au niveau de la ligne et des modifications efficaces de lignes uniques. L'OLAP exige des scans de colonnes en masse et une compression élevée. Le stockage hybride ligne-colonne de PolarDB — utilisant la même conception qu'Oracle Database In-Memory et l'index columnstore de SQL Server — stocke les deux formats simultanément dans un seul moteur :
Cohérence en temps réel. Les données orientées lignes et orientées colonnes restent synchronisées au niveau de la transaction. Les données écrites dans le stockage en lignes apparaissent dans les requêtes analytiques immédiatement après la validation (commit).
Efficacité des coûts. Spécifiez uniquement les colonnes nécessitant une accélération analytique comme index columnaires. Les données complètes continuent de résider dans le stockage en lignes. N'indexez que les colonnes analysées réellement, et non la table entière.
Opérations simplifiées. Aucun pipeline de synchronisation de données à maintenir, aucun écart de cohérence à surveiller.
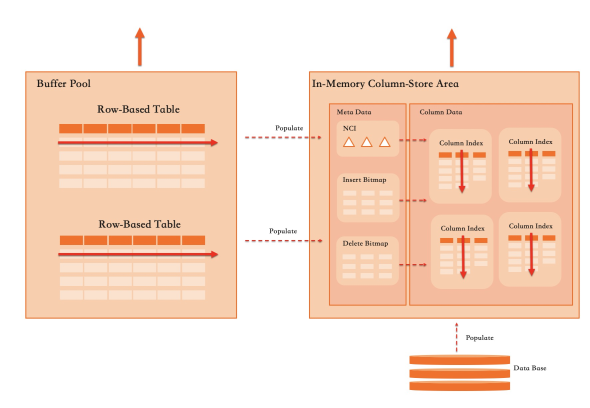
La maintenance du stockage en colonnes doit être suffisamment légère pour ne pas dégrader les performances OLTP. En cas de conflit, la performance OLTP est prioritaire. Cette contrainte façonne chaque décision de conception ci-dessous.
Stockage en colonnes comme index secondaire
L'IMCI implémente le stockage en colonnes comme un index secondaire d'InnoDB, plutôt que comme un moteur de stockage séparé. Cette conception offre plusieurs avantages :
Réutilisation des transactions. InnoDB applique déjà les opérations INSERT, UPDATE et DELETE à tous les index secondaires de manière atomique, au sein de la même transaction. L'IMCI hérite de ce framework transactionnel sans modification.
Réutilisation de l'encodage. Les index columnaires utilisent le même encodage de données que les autres index de stockage en lignes. Aucune conversion de jeu de caractères ou d'interclassement n'est nécessaire lors du déplacement des données entre les formats.
Sélection flexible des colonnes. Créez des index columnaires sur n'importe quel sous-ensemble de colonnes. Ajoutez ou supprimez des colonnes à l'aide de DDL. Indexez les colonnes analytiques à haute cardinalité (INT, FLOAT, DOUBLE) tout en conservant les grandes colonnes utilisées uniquement pour les requêtes ponctuelles (TEXT, BLOB) dans le stockage en lignes.
Réutilisation de la récupération. La récupération après incident réutilise le module de journal redo d'InnoDB. Les index columnaires sur les nœuds RO ou de secours sont reconstruits à partir du journal redo, s'intégrant proprement au processus de réplication physique de PolarDB.
Gestion du cycle de vie. Un index colonnaire partage le cycle de vie de l'index primaire, simplifiant ainsi la gestion du schéma.
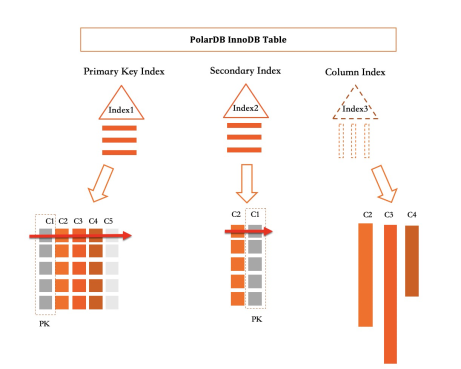
Dans PolarDB, l'index primaire et tous les index secondaires sont des arbres B+. Un index colonnaire est logiquement un index — il capture toutes les insertions, mises à jour et suppressions sur les colonnes indexées — mais physiquement, il stocke les colonnes indépendamment plutôt que de les encoder ensemble dans une seule ligne.
Pour la table illustrée ci-dessus : l'index primaire stocke les cinq colonnes (C1–C5) ; un index secondaire stocke deux colonnes (C2, C1) encodées ensemble dans un arbre B+ ; l'index colonnaire stocke trois colonnes (C2, C3, C4) dans un format de colonne indépendant et fractionné.
Lorsque toutes les colonnes requises par une requête sont couvertes par un index colonnaire, l'exécution de la requête utilise uniquement cet index, sans jamais toucher l'index primaire. Il s'agit de la même optimisation d'index couvrant que MySQL prend déjà en charge, appliquée aux données au format colonne. Les requêtes analytiques sur les colonnes couvertes s'exécutent des dizaines, voire des centaines de fois plus vite que les requêtes équivalentes sur le stockage en lignes.
Organisation des données orientées colonnes
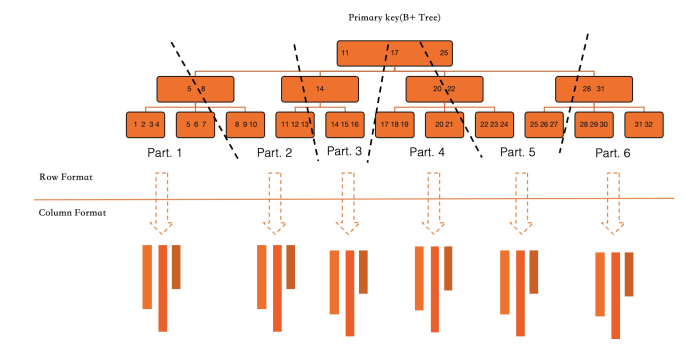
Chaque colonne d'un index colonnaire est stockée en mode d'écriture par ajout, sans ordre spécifique. La récupération d'espace utilise des étiquettes de suppression et un compactage en arrière-plan plutôt que des mises à jour sur place. Points clés de la conception :
Groupes de lignes. Les enregistrements sont organisés en groupes de lignes de 64 000 lignes chacun. Au sein d'un groupe de lignes, chaque colonne est stockée sous forme de data pack distinct.
Groupe de lignes actif. Un groupe de lignes est actif à tout moment, acceptant les nouvelles écritures. Lorsqu'il est plein, il est figé. Tous ses data packs sont compressés et vidés sur le disque, et des statistiques d'index approximatif sont calculées pour chaque pack.
ID de ligne. Chaque nouvelle ligne se voit attribuer un ID de ligne. Le système utilise cet ID pour localiser les données de cette ligne dans tous les data packs de colonnes. Un index de mappage des clés primaires vers les ID de ligne prend en charge les suppressions et mises à jour ultérieures.
Étiquettes de suppression. Les opérations de suppression définissent un bit dans un bitmap de suppression plutôt que de modifier les données de colonne sur place. Les opérations de mise à jour combinent une étiquette de suppression sur l'ancienne ligne avec une écriture par ajout des nouvelles données de ligne dans le groupe de lignes actif.
Compactage en arrière-plan. Lorsque les enregistrements invalides (supprimés) dans un groupe de lignes dépassent un certain seuil, le compactage en arrière-plan récupère l'espace et améliore la densité de stockage pour les scans analytiques.
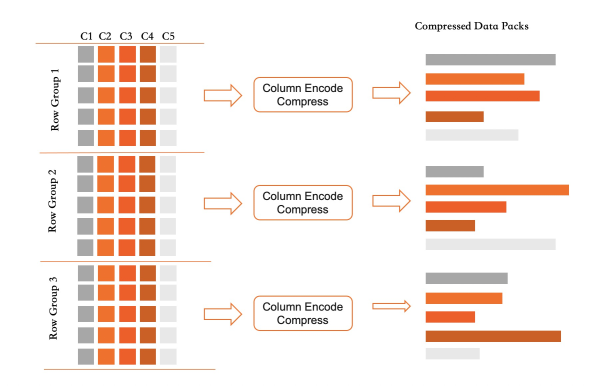
Cette conception maintient la légèreté des opérations d'écriture : une écriture ajoute des données de colonne en mémoire ; une suppression définit une étiquette ; une mise à jour définit une étiquette et ajoute des données. La maintenance du stockage en colonnes ajoute une surcharge minimale aux transactions OLTP, et l'isolation au niveau de la transaction est préservée tout au long du processus.
Conversion ligne-colonne complète et incrémentielle
Les index columnaires sont alimentés dans deux scénarios :
Conversion complète (construction initiale de l'index). Lors de la création d'un index colonnaire sur une table existante, PolarDB scanne l'index primaire InnoDB en parallèle et convertit toutes les colonnes indexées au format colonne. Il s'agit d'une opération DDL en ligne : elle ne bloque pas les transactions en cours, et sa vitesse n'est limitée que par le débit d'E/S disponible et les ressources CPU.
Conversion incrémentielle (transactions en cours). Après la création d'un index colonnaire, chaque transaction modifiant les colonnes indexées met à jour à la fois le stockage en lignes et le stockage en colonnes :
Sans IMCI : la transaction verrouille les lignes, modifie les pages de données et libère les verrous avant la validation.
Avec IMCI : la transaction crée en outre un cache de mise à jour du stockage en colonnes. Les modifications des pages de données sont enregistrées dans le cache. Avant que la transaction ne libère les verrous et ne soit validée, le cache est appliqué au stockage en colonnes.
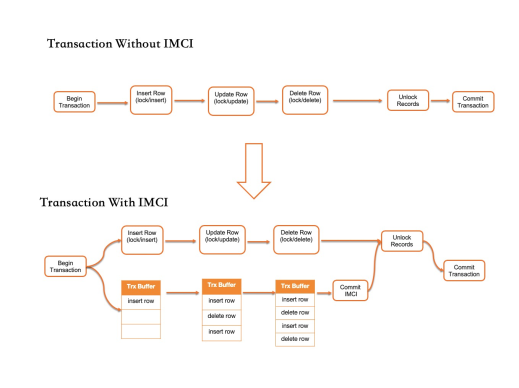
Pour les transactions OLTP typiques, le temps passé à modifier les pages de données en mémoire représente une petite fraction du temps total de la transaction. La mise à jour du stockage en colonnes ajoute une latence minimale. Pour les transactions volumineuses affectant de nombreuses lignes, les mises à jour du stockage en colonnes sont appliquées en temps réel mais restent invisibles jusqu'à la validation de la transaction, maintenant ainsi la latence de validation dans une plage étroite. Pour les charges de travail tolérant un certain retard de fraîcheur des données, les mises à jour du stockage en colonnes peuvent être appliquées de manière asynchrone afin de réduire davantage l'impact sur les performances OLTP.
L'isolation des transactions dans le stockage en colonnes reflète celle du stockage en lignes. Chaque ligne d'un groupe de lignes enregistre l'ID de la transaction qui l'a écrite. Chaque étiquette de suppression dans un bitmap de suppression enregistre l'ID de la transaction qui l'a définie. Les requêtes AP utilisent ces ID de transaction pour construire un snapshot globalement cohérent, avec une surcharge minimale.
Schéma d'index approximatif
Tous les data packs sont non ordonnés et écrits par ajout, de sorte que les index columnaires ne peuvent pas prendre en charge le filtrage précis au niveau de la ligne comme le font les index B+ tree ordonnés. À la place, l'IMCI utilise un schéma d'index approximatif basé sur des statistiques précalculées pour sauter les data packs non pertinents avant la décompression.
Lorsqu'un data pack actif termine son écriture et est figé, le système calcule et stocke ces statistiques dans les métadonnées du data pack :
Valeur minimale
Valeur maximale
Somme des valeurs
Nombre de valeurs nulles
Nombre total d'enregistrements
Ces statistiques persistent en mémoire. Pour les data packs figés comportant des suppressions, les statistiques sont mises à jour en arrière-plan.
Au moment de la requête, l'optimiseur classe chaque data pack comme pertinent, non pertinent ou potentiellement pertinent en fonction des prédicats de la requête et des statistiques du pack. Les packs non pertinents sont entièrement ignorés. Pour les opérations d'agrégation telles que COUNT et SUM, les packs pertinents peuvent souvent être résolus directement à partir des statistiques précalculées, évitant ainsi toute décompression.
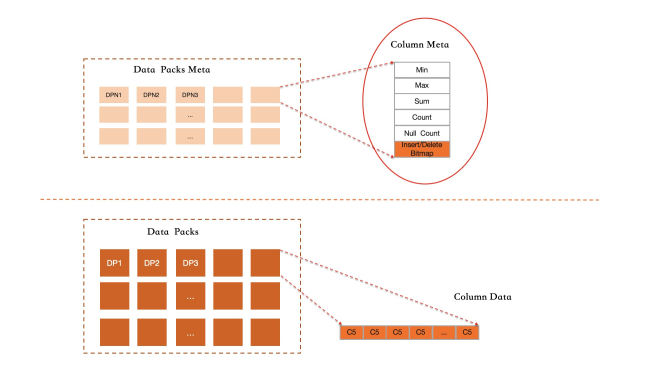
Les index approximatifs sont particulièrement efficaces pour les requêtes scannant de grands volumes de données, correspondant exactement à la charge de travail ciblée par l'IMCI. Pour les requêtes localisant un petit nombre de lignes spécifiques, l'optimiseur basé sur les coûts redirige vers un index de stockage en lignes.
Isolation des ressources TP/AP
L'exécution de l'OLTP et de l'OLAP sur le même cluster crée un risque de contention des ressources : une requête analytique volumineuse peut consommer suffisamment de CPU et d'E/S pour provoquer un pic de latence OLTP. PolarDB prend en charge trois modes de déploiement pour isoler ces charges de travail, en utilisant son architecture write-once-read-many pour ajouter des nœuds RO indépendants.
| Mode | Configuration | Niveau d'isolation | Cas d'utilisation |
|---|---|---|---|
| Mode 1 | IMCI activé sur le nœud RW | Aucun — TP et AP partagent le CPU et la mémoire | Charge AP légère ; requêtes de rapport sur des données importées par lots |
| Mode 2 | IMCI activé sur un nœud RO dédié de type AP | CPU et mémoire entièrement isolés ; E/S partagées | Charge AP modérée ; la plupart des déploiements HTAP en production |
| Mode 3 | IMCI activé sur un nœud de secours dédié avec stockage partagé indépendant | CPU, mémoire et E/S entièrement isolés | Charge AP lourde ; SLA de latence stricts pour l'OLTP |
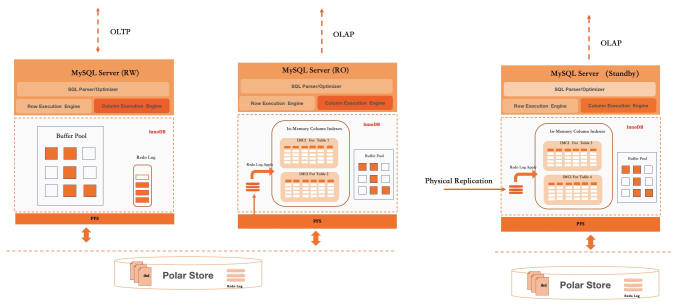
En plus de l'isolation au niveau du déploiement, le DOP automatique limite les ressources que toute requête analytique unique peut consommer. Le calcul du DOP prend en compte la charge système actuelle, le CPU et la mémoire disponibles, ainsi que la file d'attente des requêtes planifiées, empêchant ainsi une seule requête volumineuse d'affamer les autres demandes.
Performances OLAP
Pour les résultats des benchmarks, consultez Performances de l'IMCI.