Compatibilité
Cette fonction peut être utilisée dans les expressions de filtre, de tri et de formule.
Les champs de document utilisés comme paramètres de fonction doivent être créés en tant qu'attribut.
tag_match : Correspondance de tags pour le scoring
1. Aperçu
La fonction tag_match répond à de nombreuses exigences en matière de requêtes et de correspondance de documents. Elle est particulièrement utile pour personnaliser les résultats de recherche. Par exemple, vous pouvez privilégier les magasins qu'un utilisateur a aimés ou afficher les actualités sportives et de divertissement qu'il préfère. Le principe de base de tag_match consiste à stocker une série de paires clé-valeur dans un champ de type tableau d'un document. Vous pouvez ensuite transmettre les informations clé-valeur correspondantes dans la requête via la clause kvpairs. La fonction tag_match recherche les clés spécifiées dans la requête au sein du document, calcule un score pour chaque clé correspondante, puis combine ces scores pour obtenir un score final. Ce résultat peut servir au scoring et à la pondération, ou encore au filtrage.
Le processus de calcul est le suivant :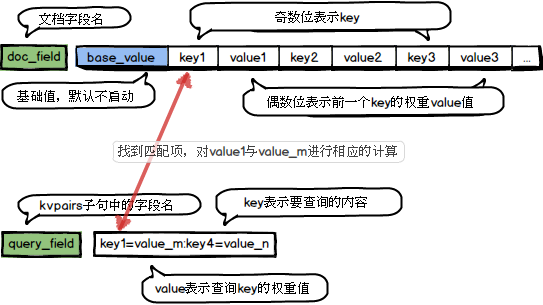
2. Utilisation
Syntaxe de base :
tag_match(query_key, doc_field, kv_op, merge_op)
Syntaxe avancée :
tag_match(query_key, doc_field, kv_op, merge_op, has_default, doc_kv, max_kv_count)
3. Paramètres
query_key : Spécifie les paires clé-valeur de la requête utilisées pour la correspondance. Ces paires sont transmises via la clause kvpairs. Les clés et les valeurs sont séparées par un signe égal (=), et plusieurs paires clé-valeur sont séparées par des deux-points (:). Par exemple,
kvpairs=query_tags:10=0.67:960=0.85:1=48indique que le paramètrequery_tagscontient trois éléments (10, 960 et 1) avec leurs valeurs respectives (0,67, 0,85 et 48). La requête peut également contenir uniquement une liste de clés, commekvpairs=cats:10:960:1.doc_field : Spécifie le champ du document qui stocke les paires clé-valeur. Ce champ doit être un tableau d'entiers (
int_array) ou un tableau de nombres à virgule flottante (float_array,double_array). Si vous utilisez un tableau de nombres à virgule flottante, les valeurs des clés sont converties enint64pour la correspondance. Le tableau stocke les clés et les valeurs en séquence alternée :[key0, value0, key1, value1, ...]. Les clés se trouvent aux indices pairs (0, 2, etc.) et leurs valeurs correspondantes aux indices impairs suivants.kv_op : Opération effectuée sur les valeurs des clés de la requête et du document lorsqu'elles correspondent. Les opérateurs pris en charge incluent :
max(maximum),min(minimum),sum(somme),avg(moyenne),mul(produit),query_value(utilise la valeur de la clé de la requête),doc_value(utilise la valeur du document) etnumber(une constante spécifiée).merge_op : Fusionne les résultats provenant de plusieurs correspondances de clés. Les opérateurs pris en charge incluent :
max(maximum),min(minimum),sum(somme),avg(moyenne) etfirst_match(utilise le résultat du premier calculkv_opet ignore les autres).has_default : Valeur booléenne indiquant s'il faut utiliser un score initial. La valeur par défaut est
false. Si elle est définie surtrue, la première valeur dudoc_fieldest traitée comme une valeur par défaut, semblable à un score de base. La structure devient alors[init_score, k0, v0, k1, v1, ...].doc_kv : Valeur booléenne spécifiant la structure du
doc_field. La valeur par défaut esttrue, ce qui signifie que le champ contient des paires clé-valeur. Si elle est définie surfalse, le champ contient uniquement des clés.max_kv_count : Nombre maximal de paires clé-valeur pouvant être transmises dans la requête. La valeur par défaut est 50. Vous pouvez augmenter cette limite, mais elle ne peut pas dépasser 512.
4. Valeur de retour
Renvoie une valeur double représentant le score final. Si has_default est false et qu'aucune correspondance n'est trouvée, la fonction renvoie 0. Pour obtenir un résultat int64, utilisez la fonction int_tag_match. La fonction int_tag_match est fonctionnellement identique à tag_match, mais elle ne peut pas être utilisée dans une expression de classement.
5. Cas d'utilisation
Scénario 1 : Dans un grand forum en ligne, les publications peuvent recevoir divers tags (humour, sport, actualités, musique, sciences, etc.). Lorsque vous envoyez des documents à OpenSearch, vous pouvez attribuer un ID de tag à chaque tag (par exemple, humour : 1, sport : 5, actualités : 3, musique : 6) et stocker ces tags dans un champ tag. Si vous prétraitez les publications, vous pouvez même déterminer un poids pour chaque tag. Par exemple, une publication concernant des actualités sportives amusantes pourrait avoir un poids de 0,5 pour l'humour, 0,5 pour le sport et 0,1 pour les actualités. Le champ tag pour cette publication serait [1, 0.5, 5, 0.5, 3, 0.1]. Pour les utilisateurs inscrits, vous pouvez apprendre leurs tags d'intérêt au fil du temps.
Par exemple, un utilisateur nommé nba_fans s'intéresse au sport et à l'humour, avec des poids respectifs de 0,6 et 0,3. Lorsque cet utilisateur effectue une requête, vous pouvez ajouter ces informations à la requête à l'aide de la clause kvpairs. Si la clause kvpairs est nommée user_tag, sa valeur pour nba_fans serait 5=0.6:1=0.3. En configurant tag_match(user_tag, tag, mul, sum) dans l'expression de classement fin, vous pouvez booster les publications correspondant aux intérêts de l'utilisateur, en les classant plus haut.
Avec le paramètre kv_op défini sur mul, la fonction multiplie les valeurs de la requête et du document. Les scores individuels sont calculés comme suit : sport (0,5 0,6 = 0,3) et humour (0,5 0,3 = 0,15). Avec le paramètre merge_op défini sur sum, la fonction additionne les scores pour le sport et l'humour (0,3 + 0,15 = 0,45). Ce score total est ajouté au score de classement final. De cette manière, vous pouvez appliquer un scoring et une pondération aux publications en fonction des intérêts de l'utilisateur.
Scénario 2 :
Les produits peuvent posséder plusieurs tags d'attribut, tels que 1 pour « jeune adulte » (âge), 2 pour « âge mûr » (âge), 3 pour « minimaliste » (style), 4 pour « à la mode » (style), 5 pour « femme » (genre) et 6 pour « homme » (genre).
Supposons que vous souhaitiez uniquement marquer les tags d'un produit sans leur attribuer de poids. Vous pouvez stocker ces tags dans un champ options. Par exemple, un vêtement à la mode pour jeunes femmes aurait un champ options de [1, 4, 5]. Notez que ce tableau contient uniquement des clés de tag, pas de valeurs. Les utilisateurs ont également leurs propres tags d'attribut qui correspondent aux tags des produits. Par exemple, une jeune utilisatrice qui achète souvent des vêtements minimalistes pourrait avoir une requête comme user_options=1:3:5. Notez que cette clause kvpairs contient également uniquement des clés de tag.
Pour booster les produits correspondant aux préférences de tags de l'utilisateur, vous pouvez utiliser tag_match(user_options, options, 10, sum, false, false) dans la formule. Ici, user_options et options spécifient respectivement les informations de tag de la requête et du document. Le kv_op est défini sur une valeur constante de 10, attribuant un score de 10 à chaque tag correspondant. Le paramètre has_default est false car nous n'avons pas besoin de valeur initiale. Le paramètre doc_kv est false, indiquant que le champ du document stocke uniquement des clés.
Lorsque la jeune utilisatrice interroge le vêtement décrit ci-dessus, les tags « jeune adulte » et « femme » correspondent. Le score pour chaque correspondance est de 10. Avec sum comme merge_op, le score de boost final pour ce produit est de 20. Cette méthode vous permet d'appliquer un scoring et une pondération aux documents correspondants, même sans information de poids de tag.
Notes d'utilisation
Les champs utilisés comme paramètres de fonction doivent être créés en tant qu'attribut.
Lors de l'utilisation de
tag_matchdans une clausefilterousort, entourez les paramètresquery_key,kv_op,merge_op,has_defaultetdoc_kvde guillemets doubles. Par exemple :sort=-tag_match("user_options", options, "mul", "sum", "false", "true", 100).La fonction
tag_matcheffectue la correspondance des clés par comparaison d'entiers. Par conséquent, les clés de la requête et du document doivent être des entiers. Si une clé est un nombre à virgule flottante,tag_matchla convertit en entier pour la comparaison.
Exemples
Supposons que les documents puissent avoir les 10 types de tags suivants :
1 - Finance
2 - Technology
3 - Sports
4 - Entertainment
5 - Fashion
6 - Education
7 - Travel
8 - Gaming
9 - Popular Science
10 - Healthcare
Exemple 1 : Même mot-clé, tags différents
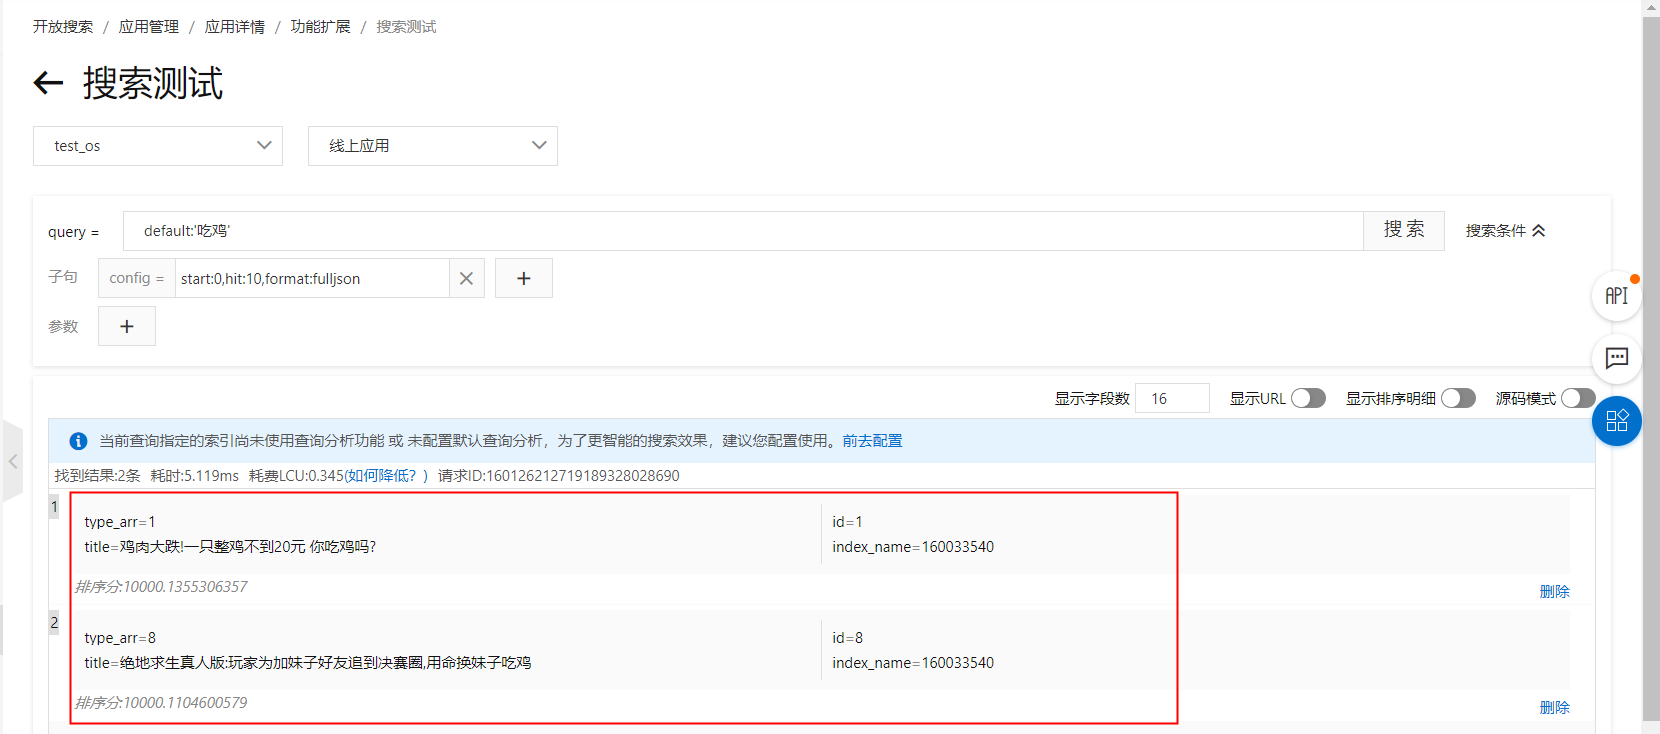 Comme illustré dans la figure ci-dessus, une recherche pour « battle royale » renvoie deux documents. Cependant, les documents sont de types différents : 1-Finance et 8-Jeu. Si vous souhaitez afficher en premier le document avec le tag « Jeu », vous pouvez configurer la fonction tag_match. Les sections suivantes montrent comment configurer cette fonction dans une expression de classement et une clause de tri :
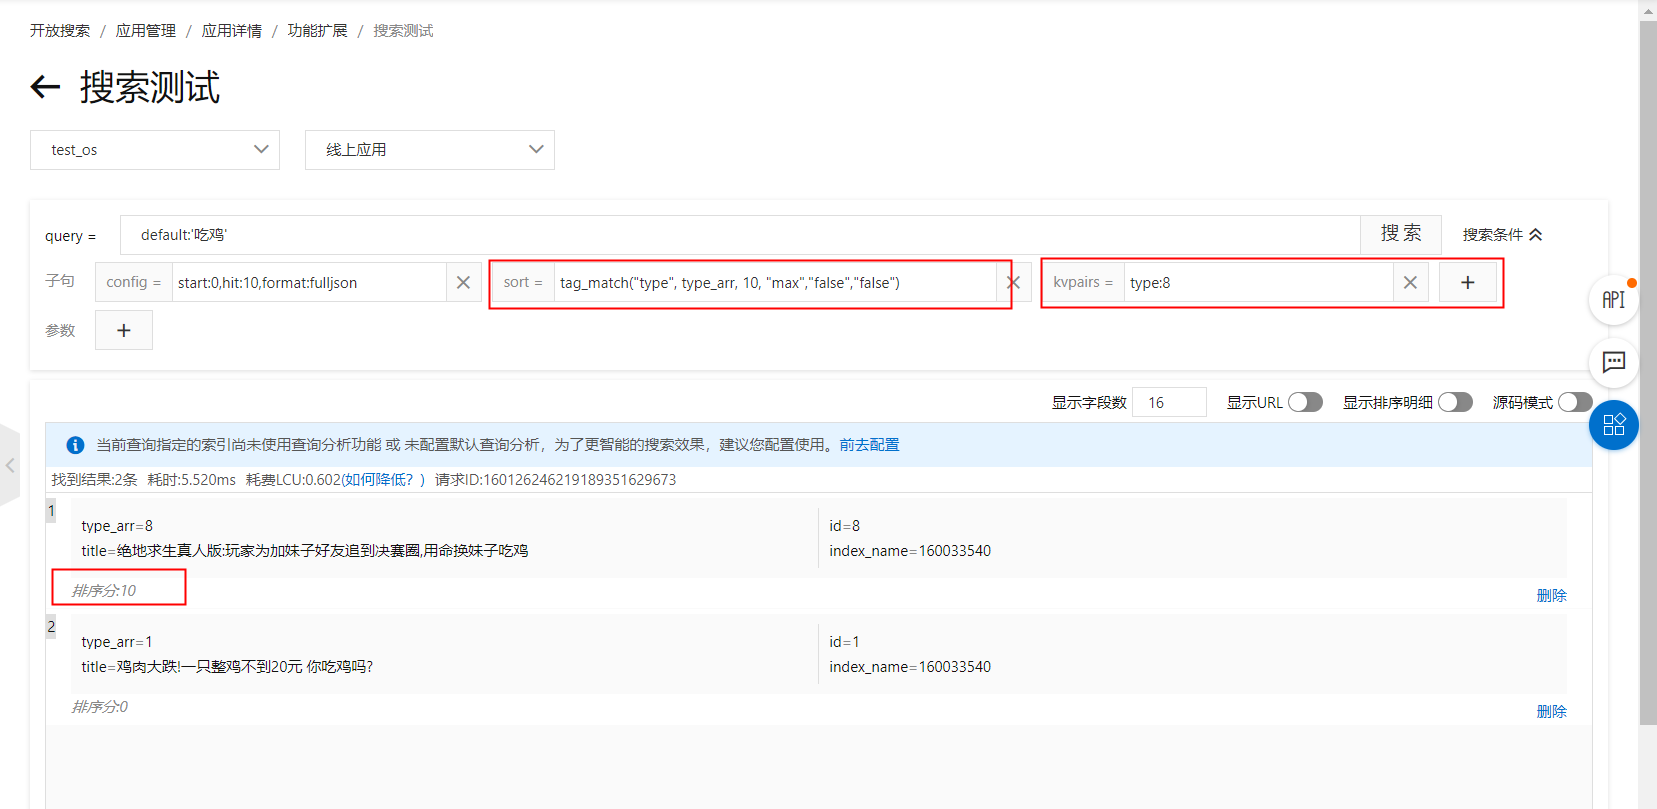
kvpairs: type:8
Ranking expression: tag_match(type, type_arr, 10, max,false,false)
sort clause: tag_match("type", type_arr, 10, "max","false","false")
Résultat avec l'expression de classement :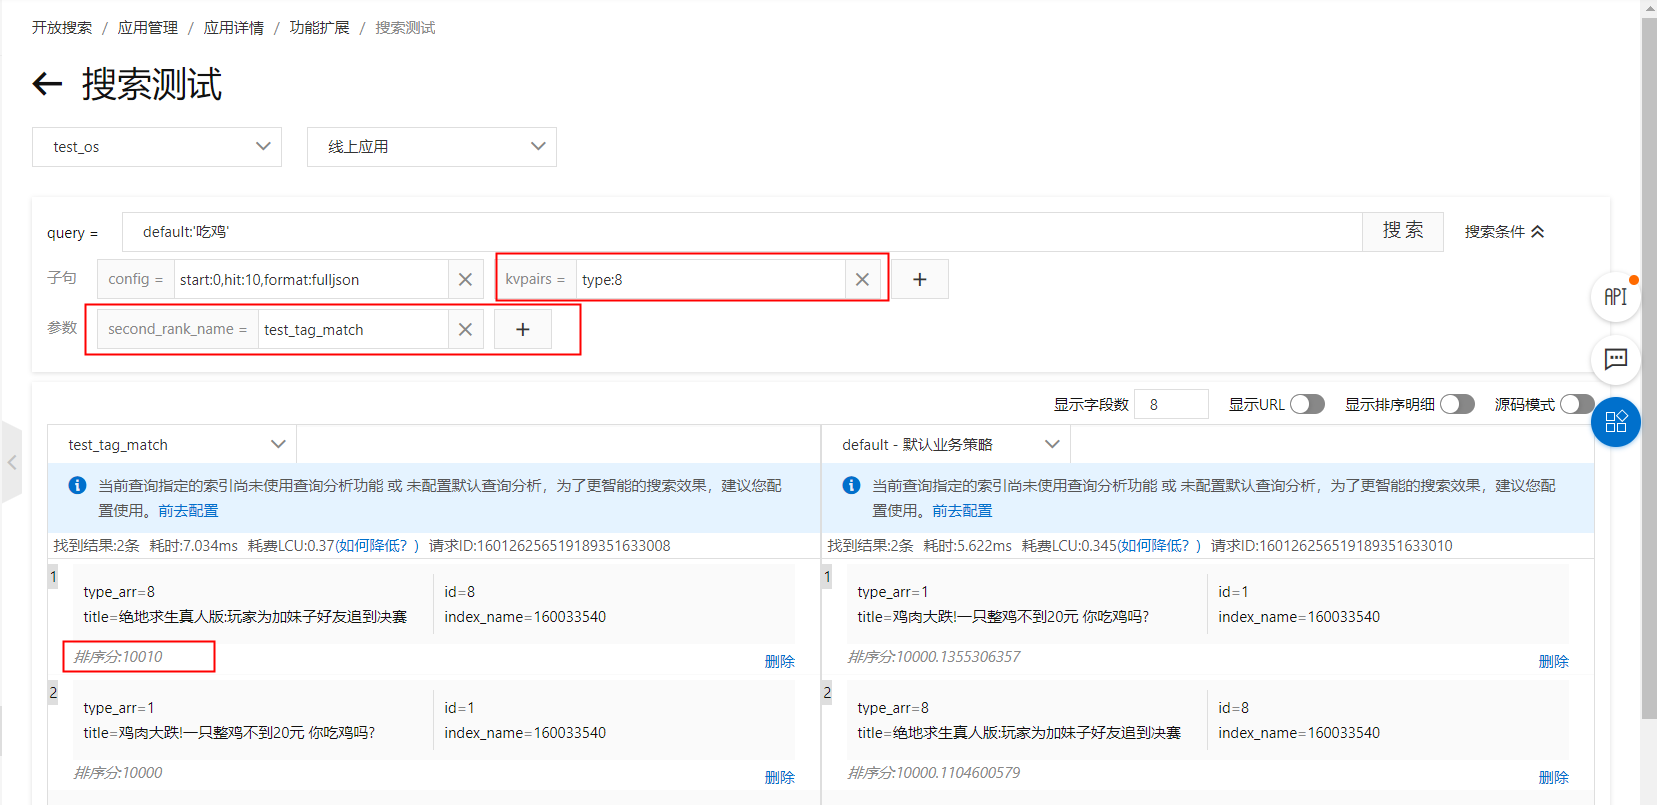 Résultat avec la clause de tri :
Exemple 2 : Score combiné pour plusieurs tags (pour la personnalisation utilisateur)
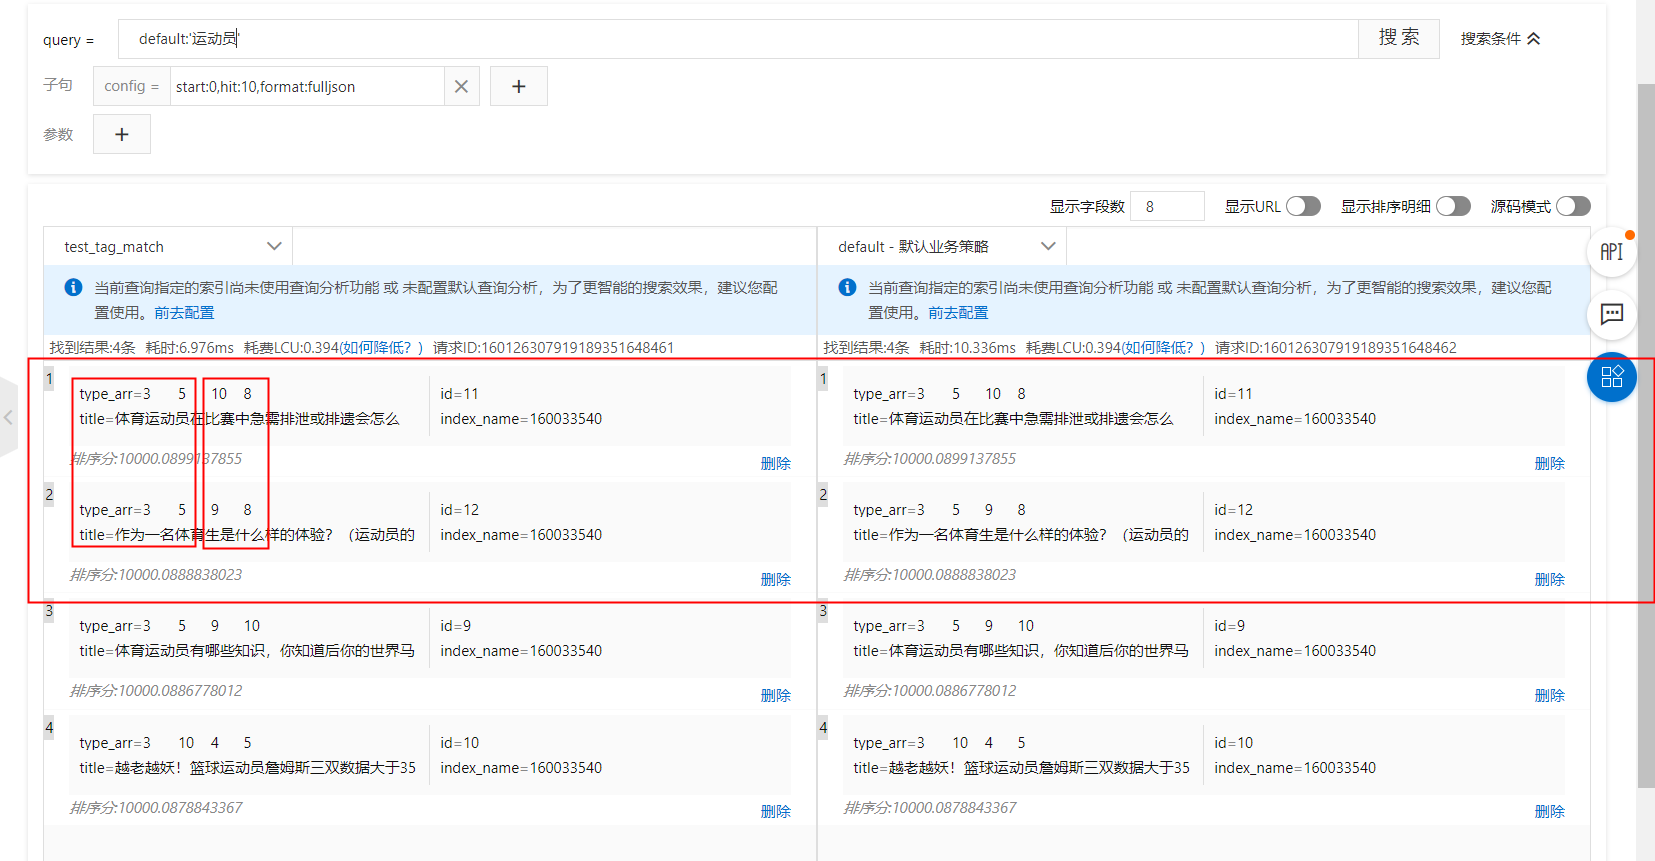 Comme indiqué dans l'image, lorsque les tags principaux sont identiques, vous devez faire correspondre les scores des tags secondaires. Les exemples suivants montrent comment configurer cela dans une expression de classement et une clause de tri :
kvpairs: type:3=2:10=1
Ranking expression: tag_match(type, type_arr, 10, sum,false,true)
sort clause: tag_match("type", type_arr, 10, "sum","false","true")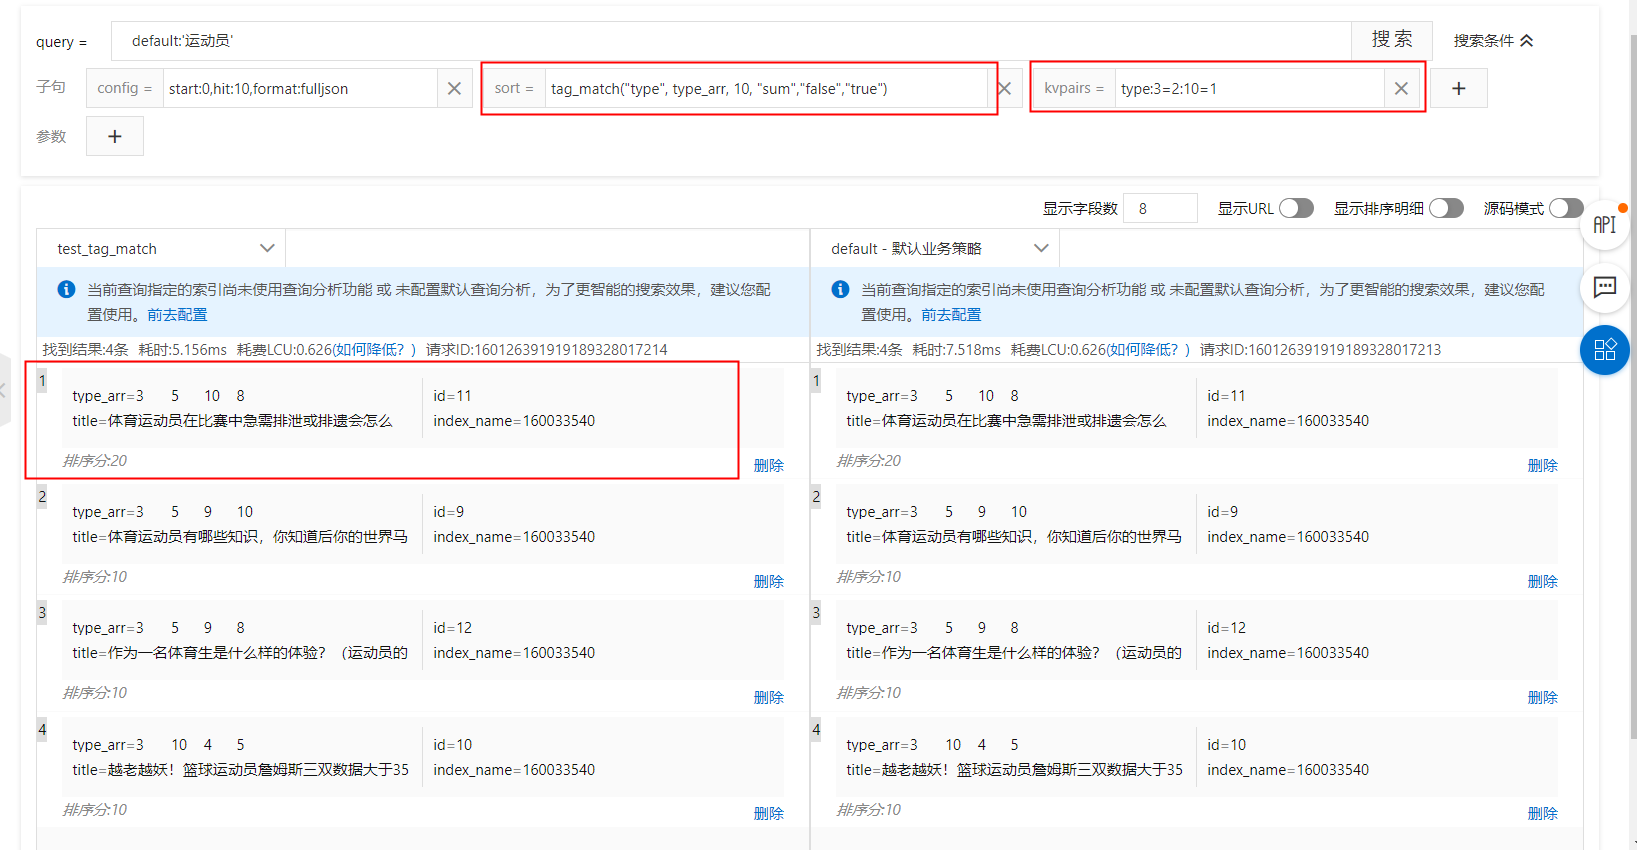
Exemple 3 : Plusieurs tags du même type avec des scores différents
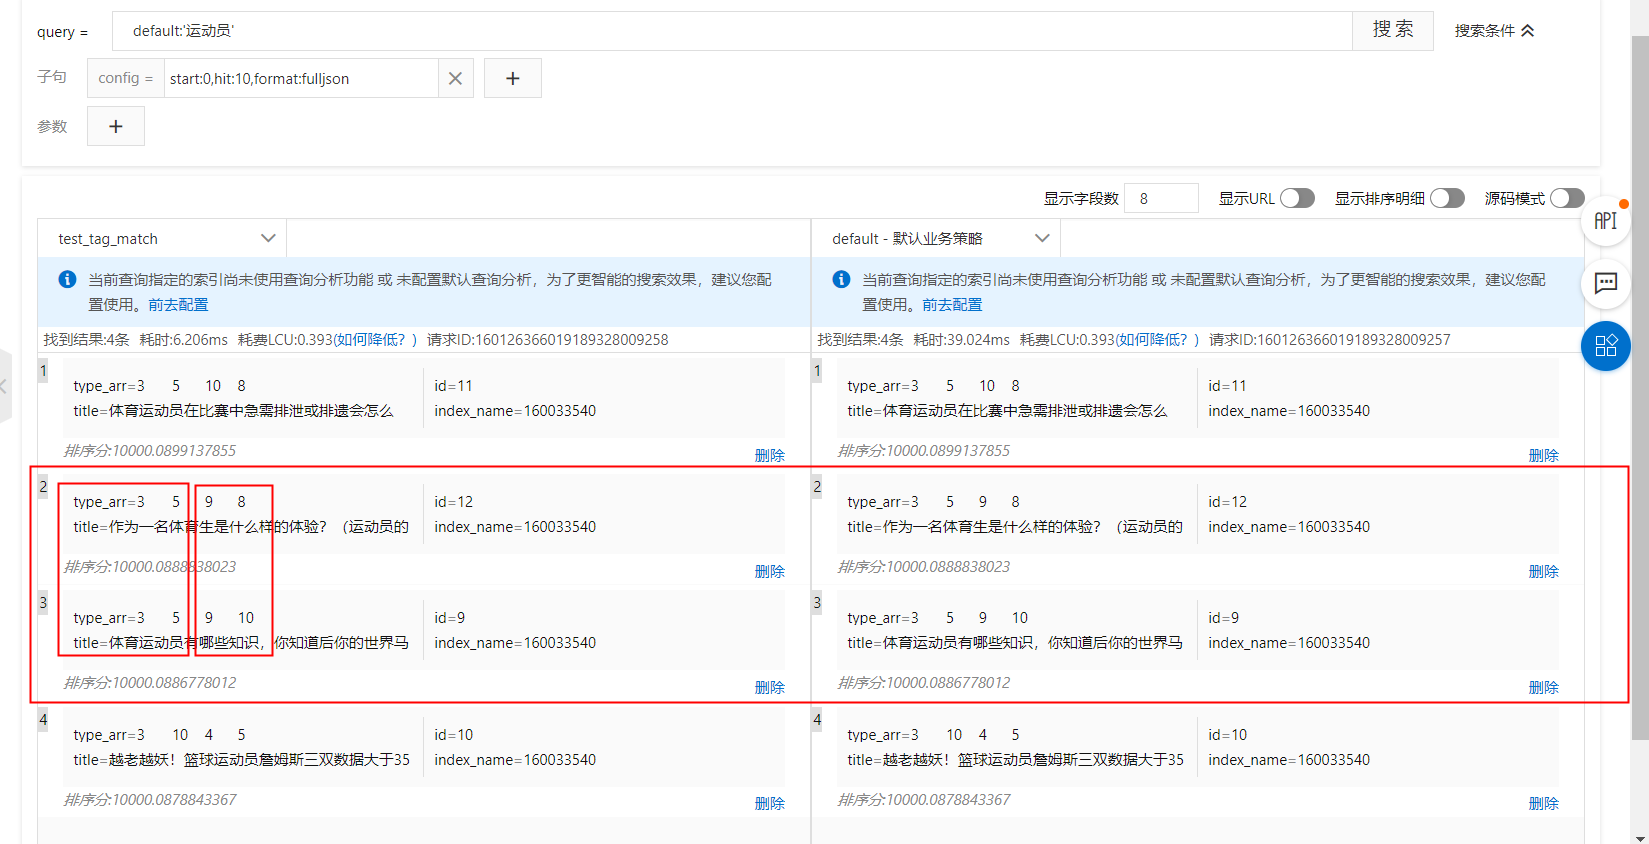 Comme indiqué dans l'image, le contenu mis en évidence en rouge possède les mêmes tags, mais chaque tag a un score différent. Les exemples suivants montrent comment configurer cela dans une expression de classement et une clause de tri :
kvpairs: type:3=2:9=2
Ranking expression: tag_match(type, type_arr, sum, sum,false,true)
sort clause: tag_match("type", type_arr, "sum", "sum","false","true")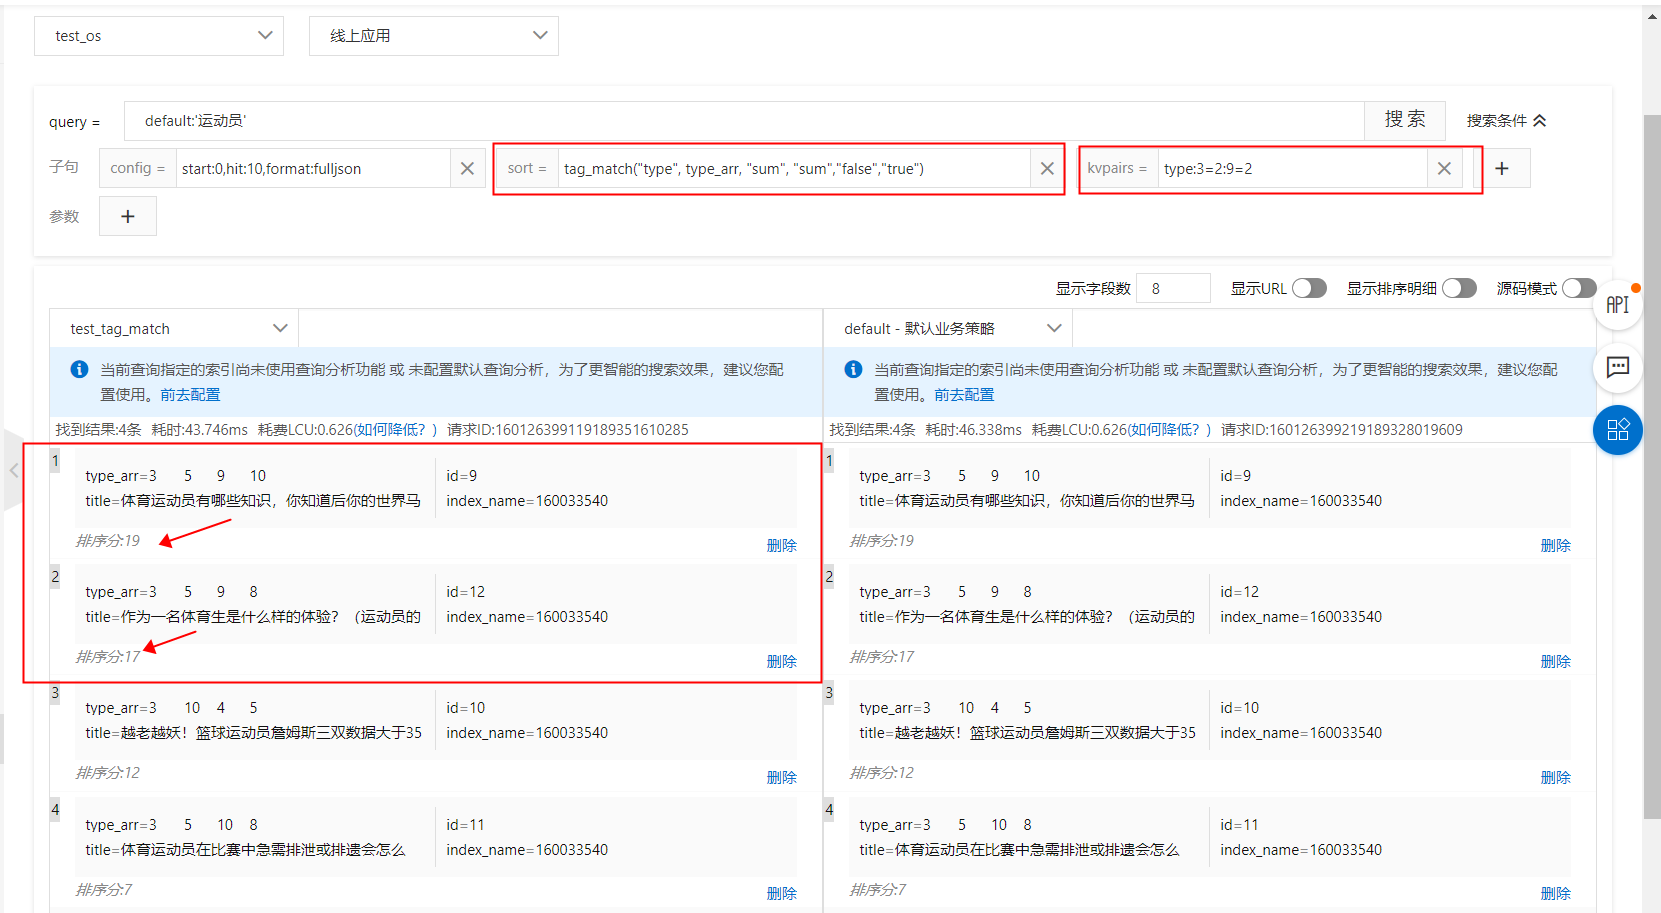
Exemple Java SDK : Démo de recherche Java SDK