La console ApsaraDB for MongoDB propose une vaste gamme de métriques de performance pour vous aider à surveiller l'état de vos instances.
Contexte
Tenez compte des informations suivantes concernant la fonctionnalité de surveillance dans ApsaraDB for MongoDB :
La fonctionnalité de surveillance diffère entre les nouvelles et les anciennes versions de la console ApsaraDB for MongoDB. Nous vous recommandons d'utiliser la nouvelle console pour accéder à davantage de fonctionnalités.
-
Si vous utilisez la nouvelle console de gestion, une fréquence de collecte d'une fois par seconde ou d'une fois toutes les 300 secondes est normale pour une instance dans les cas suivants :
Certaines instances existantes héritent de leurs paramètres de fréquence de collecte d'origine.
-
L'instance utilise une fréquence de collecte configurée dans l'ancienne console ApsaraDB for MongoDB.
Si vous utilisez l'ancienne console de gestion et que la fréquence de collecte d'une instance est d'une fois toutes les 60 secondes, cela est normal. Cela indique que l'instance a été créée après la standardisation de la fréquence de collecte à une fois toutes les 60 secondes. Pour plus d'informations, consultez l'annonce concernant le changement de la fréquence de collecte à 60 secondes.
Remarques
Si vous recevez un message d'alerte d'Alibaba Cloud, par exemple une alerte indiquant que l'utilisation du CPU dépasse 80 %, analysez les données de surveillance dans la console pour résoudre le problème. Filtrez par nœud pour vérifier et identifier toute anomalie.
Les données de surveillance sont conservées pendant 7 jours maximum.
Procédure
Connectez-vous à la console ApsaraDB for MongoDB.
Dans le coin supérieur gauche de la page, sélectionnez le groupe de ressources et la région auxquels appartient l'instance.
Dans le volet de navigation de gauche, cliquez sur Replica Set Instances ou Sharded Cluster Instance en fonction du type d'instance.
Sur la page qui s'affiche, repérez l'instance que vous souhaitez gérer et cliquez sur son ID.
Dans le volet de navigation de gauche, cliquez sur Monitoring Data.
-
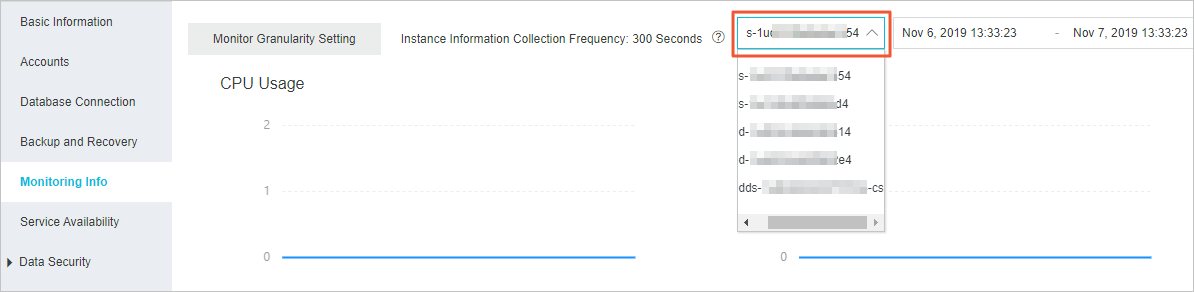
En fonction du type d'instance, sélectionnez le nœud pour afficher ses données de surveillance.
RemarquePar défaut, la console affiche les données de surveillance des dernières 24 heures. Vous pouvez également sélectionner une plage de temps pour consulter les données historiques.
Instance à nœud unique : les données de surveillance du nœud principal s'affichent. La sélection ne peut pas être modifiée.
Instance de jeu de réplicas : en haut de la page, sélectionnez un nœud principal ou secondaire.
-
Instance de cluster fragmenté : en haut de la page, sélectionnez un nœud mongos, un nœud shard ou un nœud ConfigServer.
RemarqueLes ID de nœuds préfixés par
s-
sont des nœuds mongos, ceux préfixés par
d-
sont des nœuds shard et ceux suffixés par
-cs
sont des nœuds ConfigServer.
Métriques
| Métrique | Description |
| Utilisation du CPU | cpu_usage : Utilisation du CPU de l'instance. |
| Utilisation de la mémoire | mem_usage : Utilisation de la mémoire de l'instance. |
| IOPS | Nombre d'opérations d'E/S par seconde (IOPS). Cette métrique inclut :
|
| Utilisation des IOPS | iops_usage : Ratio entre les IOPS utilisées par l'instance et les IOPS maximales disponibles. |
| Utilisation de l'espace disque | Espace disque utilisé par l'instance. Cette métrique inclut :
|
| Utilisation du disque | disk_usage : Ratio entre l'espace disque total utilisé par l'instance et l'espace disque maximal disponible. |
| QPS des opérations | Nombre d'opérations par seconde (QPS) sur l'instance. Cette métrique inclut le nombre d'opérations :
|
| Connexions | current_conn : Nombre actuel de connexions à l'instance. |
| Curseurs | Nombre de curseurs actuellement utilisés par l'instance. Cette métrique inclut :
|
| Trafic réseau | Trafic réseau de l'instance. Cette métrique inclut :
|
| Longueur de la file d'attente de verrouillage global | Longueur des files d'attente en attente de verrous globaux sur l'instance. Cette métrique inclut :
|
| WiredTiger | Métriques au niveau du cache du moteur WiredTiger. Cette métrique inclut :
|
| Latence de réplication | repl_lag : Latence de synchronisation des données entre les nœuds principaux et secondaires. |
| Files d'attente de requêtes WT | Nombre de requêtes de lecture et d'écriture concurrentes en cours de traitement (out) et nombre d'emplacements de requêtes concurrentes disponibles (available). Cette métrique inclut :
|
| Latence des E/S | iocheck_cost : Mesure le temps de réponse des opérations d'E/S.Remarque Cette métrique s'applique uniquement aux instances de jeu de réplicas. |