Si les performances d'un modèle ne répondent pas à vos attentes après l'application de méthodes d'optimisation telles que le prompt engineering ou les appels de plugins, vous pouvez recourir au fine-tuning de modèle dans Alibaba Cloud Model Studio. Stratégie centrale pour améliorer les performances, le fine-tuning renforce considérablement les capacités d'un modèle dans des secteurs industriels ou des scénarios métier spécifiques. Il permet également d'aligner les sorties sur les préférences humaines et de réduire la latence. Trois méthodes d'entraînement sont disponibles : le supervised fine-tuning (SFT), le continual pre-training (CPT) et le direct preference optimization (DPO).
Présentation du fine-tuning de modèle
Le fine-tuning de modèle constitue une méthode essentielle pour optimiser les performances d'un modèle. Il permet notamment :
- D'améliorer les performances du modèle pour des secteurs d'activité ou des besoins métier spécifiques
- De réduire la latence de sortie du modèle
- De limiter les hallucinations du modèle
- D'aligner le modèle sur les valeurs ou les préférences humaines
- De remplacer des modèles de grande taille par des modèles légers après fine-tuning
Au cours du processus de fine-tuning, le modèle acquiert à partir des données d'entraînement des caractéristiques propres à un métier ou à un scénario donné, telles que des connaissances, un ton, des styles d'expression et une conscience de soi. Étant donné que le modèle a déjà assimilé de nombreux exemples liés à des secteurs ou scénarios spécifiques durant l'entraînement, ses performances en inférence one-shot ou zero-shot après entraînement surpassent ses performances few-shot avant entraînement. Cette approche permet ainsi d'économiser des tokens en entrée et de réduire la latence de sortie du modèle.
Processus de fine-tuning de modèle

Pour plus d'informations, consultez :
Modèles pris en charge
Modèles pris en charge
Singapour
Génération de texte
Nom du modèle | Code du modèle | Entraînement SFT tous paramètres (sft) | Entraînement SFT efficace (efficient_sft) |
|---|---|---|---|
Qwen3-14B | qwen3-14b | × | Supported |
Compréhension visuelle (Qwen-VL)
Nom du modèle | Code du modèle | Entraînement SFT tous paramètres (sft) | Entraînement SFT efficace (efficient_sft) |
|---|---|---|---|
- | - | - | - |
Chine du Nord 2 (Pékin)
Génération de texte
Service de modèle | Code du modèle | Entraînement CPT tous paramètres (cpt) | Entraînement SFT tous paramètres (sft) | Entraînement SFT efficace (efficient_sft) | Entraînement DPO tous paramètres (dpo_full) | Entraînement DPO efficace (dpo_lora) |
|---|---|---|---|---|---|---|
Qwen3.6-Flash-2026-04-16 | qwen3.6-flash-2026-04-16 | × | Supported | × | × | × |
Qwen3.5-27B | qwen3.5-27b | × | Supported | Supported | × | × |
Qwen3.5-9B | qwen3.5-9b | × | Supported | Supported | × | × |
Qwen3.5-Flash-2026-02-23 | qwen3.5-flash-2026-02-23 | × | Supported | × | × | × |
Qwen3-32B | qwen3-32b | Supported | Supported | Supported | Supported | Supported |
Qwen3-30B-A3B-Instruct-2507 | qwen3-30b-a3b-instruct-2507 | Supported | Supported | Supported | × | × |
Qwen3-14B | qwen3-14b | × | Supported | Supported | Supported | Supported |
Qwen3-8B | qwen3-8b | × | Supported | Supported | Supported | Supported |
Qwen3-4B-Instruct-2507 | qwen3-4b-instruct-2507 | Supported | Supported | Supported | Supported | Supported |
Qwen3-1.7B | qwen3-1.7b | Supported | Supported | Supported | Supported | Supported |
Qwen3-0.6B | qwen3-0.6b | Supported | Supported | Supported | Supported | Supported |
Qwen2.5-72B-Instruct | qwen2.5-72b-instruct | Supported | Supported | Supported | Supported | Supported |
Qwen2.5-32B-Instruct | qwen2.5-32b-instruct | Supported | Supported | Supported | Supported | Supported |
Qwen2.5-14B-Instruct | qwen2.5-14b-instruct | Supported | Supported | Supported | Supported | Supported |
Qwen2.5-7B-Instruct | qwen2.5-7b-instruct | Supported | Supported | Supported | Supported | Supported |
Qwen-Plus-Character-2025-11-06 | qwen-plus-character-2025-11-06 | × | Supported | Supported | Supported | Supported |
Compréhension visuelle (Qwen-VL)
Service de modèle | Code du modèle | Entraînement CPT tous paramètres (cpt) | Entraînement SFT tous paramètres (sft) | Entraînement SFT efficace (efficient_sft) | Entraînement DPO tous paramètres (dpo_full) | Entraînement DPO efficace (dpo_lora) |
|---|---|---|---|---|---|---|
Qwen3-VL-8B-Instruct | qwen3-vl-8b-instruct | × | Supported | Supported | × | × |
Qwen3-VL-8B-Thinking | qwen3-vl-8b-thinking | × | Supported | Supported | × | × |
Qwen3-VL-4B-Instruct | qwen3-vl-4b-instruct | × | Supported | Supported | × | × |
Qwen2.5-VL-72B-Instruct | qwen2.5-vl-72b-instruct | × | Supported | Supported | × | × |
Qwen2.5-VL-32B-Instruct | qwen2.5-vl-32b-instruct | × | Supported | Supported | × | × |
Qwen2.5-VL-7B-Instruct | qwen2.5-vl-7b-instruct | × | Supported | Supported | × | × |
Comparaison des méthodes d'ajustement
Fonctionnalité | CPT (Continual Pre-training) | SFT (Supervised Fine-tuning) | DPO (Direct Preference Optimization) |
|---|---|---|---|
Résumé | Complète les connaissances (Injecte des connaissances métier) | Apprend à exécuter des tâches (Suit les instructions) | Exécute mieux les tâches (S'aligne sur les préférences humaines) |
Données d'entrée | Plus de 10 millions de tokens Texte métier non étiqueté | Plus de 1 000 entrées Paires « question-réponse » de haute qualité | Plus de 100 ensembles Paires de réponses « meilleure-moins bonne » pour la même instruction |
Objectif principal | Adaptation au domaine. Acquisition d'un vocabulaire spécialisé et de faits spécifiques. | Enseigne au modèle les formats de conversation et les capacités d'exécution de tâches. | Aligne davantage les sorties du modèle sur les valeurs et préférences humaines. |
Méthode d'apprentissage | Apprentissage auto-supervisé (Prédit le mot suivant) | Apprentissage supervisé (Imite la vérité terrain) | Apprentissage direct par préférence (Augmente la probabilité de bonnes réponses et diminue celle des mauvaises) |
Étape du modèle | Généralement avant le SFT | Après le CPT et avant le DPO | Généralement après le SFT, comme étape finale d'alignement. |
Comparaison des modes d'entraînement
Entraînement tous paramètres | Entraînement efficace (LoRA, recommandé) | |
|---|---|---|
Scénarios | • Le modèle doit acquérir de nouvelles capacités • Obtention de performances globales optimales. | • Optimisation des performances du modèle pour des scénarios spécifiques. • Scénarios sensibles aux coûts et au temps. |
Durée d'entraînement | Plus longue, avec une convergence plus lente. | Plus courte, avec une convergence plus rapide. |
Facturation
| Mode de facturation | Paiement à l'utilisation basé sur le volume de données d'entraînement |
| Formule de facturation | Frais d'entraînement du modèle = (Total des tokens dans les données d'entraînement + Total des tokens dans les données d'entraînement mixtes) × Nombre d'époques × Prix unitaire d'entraînement (Unité de facturation minimale : 1 token)
|
Prix unitaire de l'entraînement
Le tableau suivant présente les prix unitaires d'entraînement pour les modèles prédéfinis. Le prix unitaire d'entraînement d'un modèle personnalisé est identique à celui du modèle prédéfini correspondant.
Singapour
Qwen
Service de modèle | Code du modèle | Tarif |
|---|---|---|
Qwen3-14B | qwen3-14b | 0,0016 $/1 000 tokens |
Qwen-VL
Service de modèle | Code du modèle | Tarif |
|---|---|---|
- | - | - |
Calculer les tokens pour les images et les vidéos
Images
Formule : Image Tokens = h_bar * w_bar / token_pixels + 2
-
h_bar, w_bar: hauteur et largeur de l'image redimensionnée. Avant le traitement, le modèle effectue un prétraitement pour réduire l'image à une limite de pixels spécifique. Cette limite dépend des valeurs des paramètresmax_pixelsetvl_high_resolution_images. Pour plus d'informations, reportez-vous à Traiter les images haute résolution. -
token_pixels: valeur en pixels correspondant à chaquetokenvisuel. Cette valeur varie selon le modèle :qwen3.8-series,qwen3.7-series,qwen3.6-series,qwen3.5-series,Qwen3-VL,qwen-vl-maxetqwen-vl-plus: chaquetokencorrespond à32x32pixels.QVQet autres modèlesQwen2.5-VL: chaque token correspond à28x28pixels.
Le code suivant illustre la logique approximative de mise à l'échelle des images utilisée par le modèle. Utilisez-le pour estimer le nombre de tokens d'une image. Pour la facturation réelle, reportez-vous à la réponse de l'API.
import math
from PIL import Image  # pip install Pillow

def smart_size(image_path, max_pixels, vl_high_resolution_images):
    """Calculates the scaled dimensions of an image based on model parameters to estimate image tokens."""
    image = Image.open(image_path)
    height, width = image.height, image.width

    # The scaling factor is 32 for models such as Qwen3.6, Qwen3.5, and Qwen3-VL. For other models, it is 28.
    factor = 32
    h_bar = round(height / factor) * factor
    w_bar = round(width / factor) * factor

    # Token lower limit: 4 tokens
    min_pixels = 4 * factor * factor

    # If vl_high_resolution_images=True, the token upper limit is fixed at 16384, and max_pixels is ignored.
    if vl_high_resolution_images:
        max_pixels = 16384 * factor * factor

    # Constrains the total number of pixels to the range [min_pixels, max_pixels].
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = math.floor(height / beta / factor) * factor
        w_bar = math.floor(width / beta / factor) * factor
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = math.ceil(height * beta / factor) * factor
        w_bar = math.ceil(width * beta / factor) * factor

    return h_bar, w_bar

if __name__ == "__main__":
    # Note: The values of max_pixels and vl_high_resolution_images must match the parameters passed when calling the model.
    h_bar, w_bar = smart_size("xxx/test.jpg", max_pixels=2560 * 32 * 32, vl_high_resolution_images=False)
    print(f"Scaled image dimensions: Height {h_bar}, Width {w_bar}")

    # Each image includes one <vision_bos> and one <vision_eos> token.
    token = int(h_bar * w_bar / (32 * 32)) + 2
    print(f"Number of image tokens: {token}")
Vidéos
-
Fichiers vidéo :
Lors du traitement d'un fichier vidéo, le modèle extrait d'abord les images, puis calcule le nombre total de tokens pour l'ensemble des images vidéo. Ce calcul étant complexe, utilisez le code suivant pour estimer la consommation totale de tokens d'une vidéo en fournissant son chemin d'accès :
# Before use, install: pip install opencv-python import math import os import logging import cv2 logger = logging.getLogger(__name__) FRAME_FACTOR = 2 # For models such as Qwen3.6, Qwen3.5, Qwen3-VL, qwen-vl-max-0813, qwen-vl-plus-0815, and qwen-vl-plus-0710, the image scaling factor is 32. IMAGE_FACTOR = 32 # For other models, the image scaling factor is 28. # IMAGE_FACTOR = 28 # Maximum aspect ratio for video frames MAX_RATIO = 200 # Pixel lower limit for video frames VIDEO_MIN_PIXELS = 4 * 32 * 32 # Pixel upper limit for video frames. For the Qwen3-VL-Plus model, VIDEO_MAX_PIXELS is 640 * 32 * 32. For other models, it is 768 * 32 * 32. VIDEO_MAX_PIXELS = 640 * 32 * 32 # If the user does not pass the FPS parameter, the default value is used for fps. FPS = 2.0 # Minimum number of extracted frames FPS_MIN_FRAMES = 4 # Maximum number of extracted frames (set based on the selected model) FPS_MAX_FRAMES = 2000 # Maximum pixel value for video input. For the Qwen3-VL-Plus model, set VIDEO_TOTAL_PIXELS to 131072 * 32 * 32. For other models, set it to 65536 * 32 * 32. VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_MAX_PIXELS', 131072 * 32 * 32))) def round_by_factor(number: int, factor: int) -> int: """Returns the integer closest to 'number' that is divisible by 'factor'.""" return round(number / factor) * factor def ceil_by_factor(number: int, factor: int) -> int: """Returns the smallest integer that is greater than or equal to 'number' and divisible by 'factor'.""" return math.ceil(number / factor) * factor def floor_by_factor(number: int, factor: int) -> int: """Returns the largest integer that is less than or equal to 'number' and divisible by 'factor'.""" return math.floor(number / factor) * factor def extract_vision_info(conversations): vision_infos = [] if isinstance(conversations[0], dict): conversations = [conversations] for conversation in conversations: for message in conversation: if isinstance(message["content"], list): for ele in message["content"]: if ( "image" in ele or "image_url" in ele or "video" in ele or ele.get("type","") in ("image", "image_url", "video") ): vision_infos.append(ele) return vision_infos def smart_nframes(ele,total_frames,video_fps): """Calculates the number of extracted video frames. Args: ele (dict): A dictionary containing the video configuration. - fps: Controls the number of input frames extracted for the model. total_frames (int): The original total number of frames in the video. video_fps (int | float): The original frame rate of the video. Raises: An error is reported if nframes is not within the interval [FRAME_FACTOR, total_frames]. Returns: The number of video frames for model input. """ assert not ("fps" in ele and "nframes" in ele), "Only accept either `fps` or `nframes`" fps = ele.get("fps", FPS) min_frames = ceil_by_factor(ele.get("min_frames", FPS_MIN_FRAMES), FRAME_FACTOR) max_frames = floor_by_factor(ele.get("max_frames", min(FPS_MAX_FRAMES, total_frames)), FRAME_FACTOR) duration = total_frames / video_fps if video_fps != 0 else 0 if duration-int(duration)>(1/fps): total_frames = math.ceil(duration * video_fps) else: total_frames = math.ceil(int(duration)*video_fps) nframes = total_frames / video_fps * fps if nframes > total_frames: logger.warning(f"smart_nframes: nframes[{nframes}] > total_frames[{total_frames}]") nframes = int(min(min(max(nframes, min_frames), max_frames), total_frames)) if not (FRAME_FACTOR <= nframes and nframes <= total_frames): raise ValueError(f"nframes should in interval [{FRAME_FACTOR}, {total_frames}], but got {nframes}.") return nframes def get_video(video_path): # Get video information cap = cv2.VideoCapture(video_path) frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH)) # Get video height frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT)) total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT)) video_fps = cap.get(cv2.CAP_PROP_FPS) return frame_height, frame_width, total_frames, video_fps def smart_resize(ele, path, factor=IMAGE_FACTOR): # Get the original width and height of the video height, width, total_frames, video_fps = get_video(path) # Token lower limit for video frames min_pixels = VIDEO_MIN_PIXELS total_pixels = VIDEO_TOTAL_PIXELS # Number of extracted video frames nframes = smart_nframes(ele, total_frames, video_fps) max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR),int(min_pixels * 1.05)) # The aspect ratio of the video should not exceed 200:1 or 1:200. if max(height, width) / min(height, width) > MAX_RATIO: raise ValueError( f"absolute aspect ratio must be smaller than {MAX_RATIO}, got {max(height, width) / min(height, width)}" ) h_bar = max(factor, round_by_factor(height, factor)) w_bar = max(factor, round_by_factor(width, factor)) if h_bar * w_bar > max_pixels: beta = math.sqrt((height * width) / max_pixels) h_bar = floor_by_factor(height / beta, factor) w_bar = floor_by_factor(width / beta, factor) elif h_bar * w_bar < min_pixels: beta = math.sqrt(min_pixels / (height * width)) h_bar = ceil_by_factor(height * beta, factor) w_bar = ceil_by_factor(width * beta, factor) return h_bar, w_bar def token_calculate(video_path, fps): # Pass the video path and the fps frame extraction parameter. messages = [{"content": [{"video": video_path, "fps": fps}]}] vision_infos = extract_vision_info(messages)[0] resized_height, resized_width = smart_resize(vision_infos, video_path) height, width, total_frames, video_fps = get_video(video_path) num_frames = smart_nframes(vision_infos, total_frames, video_fps) print(f"Original video dimensions: {height}*{width}, Model input dimensions: {resized_height}*{resized_width}, Total video frames: {total_frames}, Total frames extracted when fps is {fps}: {num_frames}", end=", ") video_token = int(math.ceil(num_frames / 2) * resized_height / 32 * resized_width / 32) video_token += 2 # The system automatically adds <|vision_bos|> and <|vision_eos|> visual markers (1 token each). return video_token video_token = token_calculate("xxx/test.mp4", 1) print("Video tokens:", video_token) -
Liste d'images :
Si une vidéo est transmise sous forme de liste d'images, cela signifie que l'extraction des images a déjà été effectuée. Utilisez le code suivant pour calculer la consommation de tokens en fournissant le chemin d'accès et le nombre d'images :
# Before use, install: pip install Pillow
import math
import os
import logging
from typing import Tuple
from PIL import Image

logger = logging.getLogger(__name__)

# ==================== Constant Definitions ====================
FRAME_FACTOR = 2
# For models such as Qwen3-VL, qwen-vl-max-0813, qwen-vl-plus-0815, and qwen-vl-plus-0710, the scaling factor is 32.
IMAGE_FACTOR = 32

# For other models, the scaling factor is 28.
# IMAGE_FACTOR = 28

# Constants for token calculation
TOKEN_DIVISOR = 32  # Divisor for token calculation
VISION_SPECIAL_TOKENS = 2  # <|vision_bos|> and <|vision_eos|> markers

# Maximum aspect ratio for video frames
MAX_RATIO = 200
# Pixel lower limit for video frames
VIDEO_MIN_PIXELS = 4 * 32 * 32
# Pixel upper limit for video frames. For the Qwen3-VL-Plus model, VIDEO_MAX_PIXELS is 640 * 32 * 32. For other models, it is 768 * 32 * 32.
VIDEO_MAX_PIXELS = 640 * 32 * 32

# Maximum pixel value for video input. For the Qwen3-VL-Plus model, set VIDEO_TOTAL_PIXELS to 131072 * 32 * 32. For other models, set it to 65536 * 32 * 32.
VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_MAX_PIXELS', 131072 * 32 * 32)))

def round_by_factor(number: int, factor: int) -> int:
    """Returns the integer closest to 'number' that is divisible by 'factor'."""
    return round(number / factor) * factor

def ceil_by_factor(number: int, factor: int) -> int:
    """Returns the smallest integer that is greater than or equal to 'number' and divisible by 'factor'."""
    return math.ceil(number / factor) * factor

def floor_by_factor(number: int, factor: int) -> int:
    """Returns the largest integer that is less than or equal to 'number' and divisible by 'factor'."""
    return math.floor(number / factor) * factor

def get_image_size(image_path: str) -> Tuple[int, int]:
    if not os.path.exists(image_path):
        raise FileNotFoundError(f"Image file not found: {image_path}")

    try:
        image = Image.open(image_path)
        height = image.height
        width = image.width
        image.close()  # Close the file promptly
        return height, width
    except Exception as e:
        raise ValueError(f"Cannot read image file {image_path}: {str(e)}")

def smart_resize(height: int, width: int, nframes: int, factor: int = IMAGE_FACTOR) -> Tuple[int, int]:
    """
    Calculates the scaled dimensions of an image

    Args:
        height: Original image height
        width: Original image width
        nframes: Number of video frames
        factor: Scaling factor, defaults to IMAGE_FACTOR

    Returns:
        (resized_height, resized_width) The scaled height and width

    Raises:
        ValueError: Aspect ratio exceeds the limit
    """
    # Token lower limit for video frames
    min_pixels = VIDEO_MIN_PIXELS
    total_pixels = VIDEO_TOTAL_PIXELS
    # Number of extracted video frames
    max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR), int(min_pixels * 1.05))

    # The aspect ratio of the video should not exceed 200:1 or 1:200.
    aspect_ratio = max(height, width) / min(height, width)
    if aspect_ratio > MAX_RATIO:
        raise ValueError(
            f"Image aspect ratio must be less than {MAX_RATIO}:1, but is currently {aspect_ratio:.2f}:1"
        )

    h_bar = max(factor, round_by_factor(height, factor))
    w_bar = max(factor, round_by_factor(width, factor))
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = floor_by_factor(height / beta, factor)
        w_bar = floor_by_factor(width / beta, factor)
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = ceil_by_factor(height * beta, factor)
        w_bar = ceil_by_factor(width * beta, factor)
    return h_bar, w_bar

def calculate_video_tokens(image_path: str, nframes: int = 1, factor: int = IMAGE_FACTOR, verbose: bool = True) -> int:
    """

    Args:
        image_path: Path to the video frame file
        nframes: Number of video frames,
        factor: Scaling factor, defaults to IMAGE_FACTOR
        verbose: Whether to print detailed information

    Returns:
        The number of tokens consumed

    Raises:
        FileNotFoundError: The file does not exist
        ValueError: The file format is invalid or the aspect ratio exceeds the limit
    """
    # Get the original image dimensions (read only once)
    height, width = get_image_size(image_path)

    # Calculate the scaled dimensions
    resized_height, resized_width = smart_resize(height, width, nframes, factor)

    # Calculate the number of tokens
    # Formula: ceil(nframes/2) * (height/TOKEN_DIVISOR) * (width/TOKEN_DIVISOR) + VISION_SPECIAL_TOKENS
    video_token = int(
        math.ceil(nframes / 2) *
        (resized_height / TOKEN_DIVISOR) *
        (resized_width / TOKEN_DIVISOR)
    )
    # Add visual marker tokens (<|vision_bos|> and <|vision_eos|>)
    video_token += VISION_SPECIAL_TOKENS

    if verbose:
        print(f"Original video frame dimensions: {height}x{width}, Model input dimensions: {resized_height}x{resized_width}, ", end="")

    return video_token

if __name__ == "__main__":
    try:
        video_token = calculate_video_tokens("xxx/test.jpg", nframes=30)
        print(f"Video tokens: {video_token}\n")
    except Exception as e:
        print(f"Error: {str(e)}\n")
Chine du Nord 2 (Pékin)
Qwen
Service de modèle | Code du modèle | Tarif |
|---|---|---|
Qwen3.5-27B | qwen3.5-27b | 0,006876 $/1 000 tokens |
Qwen3.5-9B | qwen3.5-9b | 0,00275 $/1 000 tokens |
Qwen3-32B | qwen3-32b | 0,005501 $/1 000 tokens |
Qwen3-30B-A3B-Instruct-2507 | qwen3-30b-a3b-instruct-2507 | 0,004126 $/1 000 tokens |
Qwen3-14B | qwen3-14b | 0,004126 $/1 000 tokens |
Qwen3-8B | qwen3-8b | 0,000825 $/1 000 tokens |
Qwen3-4B-Instruct-2507 | qwen3-4b-instruct-2507 | 0,000825 $/1 000 tokens |
Qwen3-1.7B | qwen3-1.7b | 0,000619 $/1 000 tokens |
Qwen3-0.6B | qwen3-0.6b | 0,000413 $/1 000 tokens |
Qwen2.5-72B-Instruct | qwen2.5-72b-instruct | 0,020628 $/1 000 tokens |
Qwen2.5-32B-Instruct | qwen2.5-32b-instruct | 0,004126 $/1 000 tokens |
Qwen2.5-14B-Instruct | qwen2.5-14b-instruct | 0,004126 $/1 000 tokens |
Qwen2.5-7B-Instruct | qwen2.5-7b-instruct | 0,000825 $/1 000 tokens |
Qwen-Plus-Character-2025-11-06 | qwen-plus-character-2025-11-06 | 0,020628 $/1 000 tokens |
Qwen-VL
Service de modèle | Code du modèle | Tarif |
|---|---|---|
Qwen3-VL-8B-Instruct | qwen3-vl-8b-instruct | 0,00165 $/1 000 tokens |
Qwen3-VL-8B-Thinking | qwen3-vl-8b-thinking | 0,00165 $/1 000 tokens |
Qwen3-VL-4B-Instruct | qwen3-vl-4b-instruct | 0,000825 $/1 000 tokens |
Qwen2.5-VL-72B-Instruct | qwen2.5-vl-72b-instruct | 0,006876 $/1 000 tokens |
Qwen2.5-VL-32B-Instruct | qwen2.5-vl-32b-instruct | 0,00275 $/1 000 tokens |
Qwen2.5-VL-7B-Instruct | qwen2.5-vl-7b-instruct | 0,001375 $/1 000 tokens |
Calculer les tokens pour les images et les vidéos
Images
Formule : Image Tokens = h_bar * w_bar / token_pixels + 2
-
h_bar, w_bar: hauteur et largeur de l'image redimensionnée. Avant le traitement, le modèle effectue un prétraitement pour réduire l'image à une limite de pixels spécifique. Cette limite dépend des valeurs des paramètresmax_pixelsetvl_high_resolution_images. Pour plus d'informations, reportez-vous à Traiter les images haute résolution. -
token_pixels: valeur en pixels correspondant à chaquetokenvisuel. Cette valeur varie selon le modèle :qwen3.8-series,qwen3.7-series,qwen3.6-series,qwen3.5-series,Qwen3-VL,qwen-vl-maxetqwen-vl-plus: chaquetokencorrespond à32x32pixels.QVQet autres modèlesQwen2.5-VL: chaque token correspond à28x28pixels.
Le code suivant illustre la logique approximative de mise à l'échelle des images utilisée par le modèle. Utilisez-le pour estimer le nombre de tokens d'une image. Pour la facturation réelle, reportez-vous à la réponse de l'API.
import math
from PIL import Image  # pip install Pillow

def smart_size(image_path, max_pixels, vl_high_resolution_images):
    """Calculates the scaled dimensions of an image based on model parameters to estimate image tokens."""
    image = Image.open(image_path)
    height, width = image.height, image.width

    # The scaling factor is 32 for models such as Qwen3.6, Qwen3.5, and Qwen3-VL. For other models, it is 28.
    factor = 32
    h_bar = round(height / factor) * factor
    w_bar = round(width / factor) * factor

    # Token lower limit: 4 tokens
    min_pixels = 4 * factor * factor

    # If vl_high_resolution_images=True, the token upper limit is fixed at 16384, and max_pixels is ignored.
    if vl_high_resolution_images:
        max_pixels = 16384 * factor * factor

    # Constrains the total number of pixels to the range [min_pixels, max_pixels].
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = math.floor(height / beta / factor) * factor
        w_bar = math.floor(width / beta / factor) * factor
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = math.ceil(height * beta / factor) * factor
        w_bar = math.ceil(width * beta / factor) * factor

    return h_bar, w_bar

if __name__ == "__main__":
    # Note: The values of max_pixels and vl_high_resolution_images must match the parameters passed when calling the model.
    h_bar, w_bar = smart_size("xxx/test.jpg", max_pixels=2560 * 32 * 32, vl_high_resolution_images=False)
    print(f"Scaled image dimensions: Height {h_bar}, Width {w_bar}")

    # Each image includes one <vision_bos> and one <vision_eos> token.
    token = int(h_bar * w_bar / (32 * 32)) + 2
    print(f"Number of image tokens: {token}")
Vidéos
-
Fichiers vidéo :
Lors du traitement d'un fichier vidéo, le modèle extrait d'abord les images, puis calcule le nombre total de tokens pour l'ensemble des images vidéo. Ce calcul étant complexe, utilisez le code suivant pour estimer la consommation totale de tokens d'une vidéo en fournissant son chemin d'accès :
# Before use, install: pip install opencv-python import math import os import logging import cv2 logger = logging.getLogger(__name__) FRAME_FACTOR = 2 # For models such as Qwen3.6, Qwen3.5, Qwen3-VL, qwen-vl-max-0813, qwen-vl-plus-0815, and qwen-vl-plus-0710, the image scaling factor is 32. IMAGE_FACTOR = 32 # For other models, the image scaling factor is 28. # IMAGE_FACTOR = 28 # Maximum aspect ratio for video frames MAX_RATIO = 200 # Pixel lower limit for video frames VIDEO_MIN_PIXELS = 4 * 32 * 32 # Pixel upper limit for video frames. For the Qwen3-VL-Plus model, VIDEO_MAX_PIXELS is 640 * 32 * 32. For other models, it is 768 * 32 * 32. VIDEO_MAX_PIXELS = 640 * 32 * 32 # If the user does not pass the FPS parameter, the default value is used for fps. FPS = 2.0 # Minimum number of extracted frames FPS_MIN_FRAMES = 4 # Maximum number of extracted frames (set based on the selected model) FPS_MAX_FRAMES = 2000 # Maximum pixel value for video input. For the Qwen3-VL-Plus model, set VIDEO_TOTAL_PIXELS to 131072 * 32 * 32. For other models, set it to 65536 * 32 * 32. VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_MAX_PIXELS', 131072 * 32 * 32))) def round_by_factor(number: int, factor: int) -> int: """Returns the integer closest to 'number' that is divisible by 'factor'.""" return round(number / factor) * factor def ceil_by_factor(number: int, factor: int) -> int: """Returns the smallest integer that is greater than or equal to 'number' and divisible by 'factor'.""" return math.ceil(number / factor) * factor def floor_by_factor(number: int, factor: int) -> int: """Returns the largest integer that is less than or equal to 'number' and divisible by 'factor'.""" return math.floor(number / factor) * factor def extract_vision_info(conversations): vision_infos = [] if isinstance(conversations[0], dict): conversations = [conversations] for conversation in conversations: for message in conversation: if isinstance(message["content"], list): for ele in message["content"]: if ( "image" in ele or "image_url" in ele or "video" in ele or ele.get("type","") in ("image", "image_url", "video") ): vision_infos.append(ele) return vision_infos def smart_nframes(ele,total_frames,video_fps): """Calculates the number of extracted video frames. Args: ele (dict): A dictionary containing the video configuration. - fps: Controls the number of input frames extracted for the model. total_frames (int): The original total number of frames in the video. video_fps (int | float): The original frame rate of the video. Raises: An error is reported if nframes is not within the interval [FRAME_FACTOR, total_frames]. Returns: The number of video frames for model input. """ assert not ("fps" in ele and "nframes" in ele), "Only accept either `fps` or `nframes`" fps = ele.get("fps", FPS) min_frames = ceil_by_factor(ele.get("min_frames", FPS_MIN_FRAMES), FRAME_FACTOR) max_frames = floor_by_factor(ele.get("max_frames", min(FPS_MAX_FRAMES, total_frames)), FRAME_FACTOR) duration = total_frames / video_fps if video_fps != 0 else 0 if duration-int(duration)>(1/fps): total_frames = math.ceil(duration * video_fps) else: total_frames = math.ceil(int(duration)*video_fps) nframes = total_frames / video_fps * fps if nframes > total_frames: logger.warning(f"smart_nframes: nframes[{nframes}] > total_frames[{total_frames}]") nframes = int(min(min(max(nframes, min_frames), max_frames), total_frames)) if not (FRAME_FACTOR <= nframes and nframes <= total_frames): raise ValueError(f"nframes should in interval [{FRAME_FACTOR}, {total_frames}], but got {nframes}.") return nframes def get_video(video_path): # Get video information cap = cv2.VideoCapture(video_path) frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH)) # Get video height frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT)) total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT)) video_fps = cap.get(cv2.CAP_PROP_FPS) return frame_height, frame_width, total_frames, video_fps def smart_resize(ele, path, factor=IMAGE_FACTOR): # Get the original width and height of the video height, width, total_frames, video_fps = get_video(path) # Token lower limit for video frames min_pixels = VIDEO_MIN_PIXELS total_pixels = VIDEO_TOTAL_PIXELS # Number of extracted video frames nframes = smart_nframes(ele, total_frames, video_fps) max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR),int(min_pixels * 1.05)) # The aspect ratio of the video should not exceed 200:1 or 1:200. if max(height, width) / min(height, width) > MAX_RATIO: raise ValueError( f"absolute aspect ratio must be smaller than {MAX_RATIO}, got {max(height, width) / min(height, width)}" ) h_bar = max(factor, round_by_factor(height, factor)) w_bar = max(factor, round_by_factor(width, factor)) if h_bar * w_bar > max_pixels: beta = math.sqrt((height * width) / max_pixels) h_bar = floor_by_factor(height / beta, factor) w_bar = floor_by_factor(width / beta, factor) elif h_bar * w_bar < min_pixels: beta = math.sqrt(min_pixels / (height * width)) h_bar = ceil_by_factor(height * beta, factor) w_bar = ceil_by_factor(width * beta, factor) return h_bar, w_bar def token_calculate(video_path, fps): # Pass the video path and the fps frame extraction parameter. messages = [{"content": [{"video": video_path, "fps": fps}]}] vision_infos = extract_vision_info(messages)[0] resized_height, resized_width = smart_resize(vision_infos, video_path) height, width, total_frames, video_fps = get_video(video_path) num_frames = smart_nframes(vision_infos, total_frames, video_fps) print(f"Original video dimensions: {height}*{width}, Model input dimensions: {resized_height}*{resized_width}, Total video frames: {total_frames}, Total frames extracted when fps is {fps}: {num_frames}", end=", ") video_token = int(math.ceil(num_frames / 2) * resized_height / 32 * resized_width / 32) video_token += 2 # The system automatically adds <|vision_bos|> and <|vision_eos|> visual markers (1 token each). return video_token video_token = token_calculate("xxx/test.mp4", 1) print("Video tokens:", video_token) -
Liste d'images :
Si une vidéo est transmise sous forme de liste d'images, cela signifie que l'extraction des images a déjà été effectuée. Utilisez le code suivant pour calculer la consommation de tokens en fournissant le chemin d'accès et le nombre d'images :
# Before use, install: pip install Pillow
import math
import os
import logging
from typing import Tuple
from PIL import Image

logger = logging.getLogger(__name__)

# ==================== Constant Definitions ====================
FRAME_FACTOR = 2
# For models such as Qwen3-VL, qwen-vl-max-0813, qwen-vl-plus-0815, and qwen-vl-plus-0710, the scaling factor is 32.
IMAGE_FACTOR = 32

# For other models, the scaling factor is 28.
# IMAGE_FACTOR = 28

# Constants for token calculation
TOKEN_DIVISOR = 32  # Divisor for token calculation
VISION_SPECIAL_TOKENS = 2  # <|vision_bos|> and <|vision_eos|> markers

# Maximum aspect ratio for video frames
MAX_RATIO = 200
# Pixel lower limit for video frames
VIDEO_MIN_PIXELS = 4 * 32 * 32
# Pixel upper limit for video frames. For the Qwen3-VL-Plus model, VIDEO_MAX_PIXELS is 640 * 32 * 32. For other models, it is 768 * 32 * 32.
VIDEO_MAX_PIXELS = 640 * 32 * 32

# Maximum pixel value for video input. For the Qwen3-VL-Plus model, set VIDEO_TOTAL_PIXELS to 131072 * 32 * 32. For other models, set it to 65536 * 32 * 32.
VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_MAX_PIXELS', 131072 * 32 * 32)))

def round_by_factor(number: int, factor: int) -> int:
    """Returns the integer closest to 'number' that is divisible by 'factor'."""
    return round(number / factor) * factor

def ceil_by_factor(number: int, factor: int) -> int:
    """Returns the smallest integer that is greater than or equal to 'number' and divisible by 'factor'."""
    return math.ceil(number / factor) * factor

def floor_by_factor(number: int, factor: int) -> int:
    """Returns the largest integer that is less than or equal to 'number' and divisible by 'factor'."""
    return math.floor(number / factor) * factor

def get_image_size(image_path: str) -> Tuple[int, int]:
    if not os.path.exists(image_path):
        raise FileNotFoundError(f"Image file not found: {image_path}")

    try:
        image = Image.open(image_path)
        height = image.height
        width = image.width
        image.close()  # Close the file promptly
        return height, width
    except Exception as e:
        raise ValueError(f"Cannot read image file {image_path}: {str(e)}")

def smart_resize(height: int, width: int, nframes: int, factor: int = IMAGE_FACTOR) -> Tuple[int, int]:
    """
    Calculates the scaled dimensions of an image

    Args:
        height: Original image height
        width: Original image width
        nframes: Number of video frames
        factor: Scaling factor, defaults to IMAGE_FACTOR

    Returns:
        (resized_height, resized_width) The scaled height and width

    Raises:
        ValueError: Aspect ratio exceeds the limit
    """
    # Token lower limit for video frames
    min_pixels = VIDEO_MIN_PIXELS
    total_pixels = VIDEO_TOTAL_PIXELS
    # Number of extracted video frames
    max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR), int(min_pixels * 1.05))

    # The aspect ratio of the video should not exceed 200:1 or 1:200.
    aspect_ratio = max(height, width) / min(height, width)
    if aspect_ratio > MAX_RATIO:
        raise ValueError(
            f"Image aspect ratio must be less than {MAX_RATIO}:1, but is currently {aspect_ratio:.2f}:1"
        )

    h_bar = max(factor, round_by_factor(height, factor))
    w_bar = max(factor, round_by_factor(width, factor))
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = floor_by_factor(height / beta, factor)
        w_bar = floor_by_factor(width / beta, factor)
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = ceil_by_factor(height * beta, factor)
        w_bar = ceil_by_factor(width * beta, factor)
    return h_bar, w_bar

def calculate_video_tokens(image_path: str, nframes: int = 1, factor: int = IMAGE_FACTOR, verbose: bool = True) -> int:
    """

    Args:
        image_path: Path to the video frame file
        nframes: Number of video frames,
        factor: Scaling factor, defaults to IMAGE_FACTOR
        verbose: Whether to print detailed information

    Returns:
        The number of tokens consumed

    Raises:
        FileNotFoundError: The file does not exist
        ValueError: The file format is invalid or the aspect ratio exceeds the limit
    """
    # Get the original image dimensions (read only once)
    height, width = get_image_size(image_path)

    # Calculate the scaled dimensions
    resized_height, resized_width = smart_resize(height, width, nframes, factor)

    # Calculate the number of tokens
    # Formula: ceil(nframes/2) * (height/TOKEN_DIVISOR) * (width/TOKEN_DIVISOR) + VISION_SPECIAL_TOKENS
    video_token = int(
        math.ceil(nframes / 2) *
        (resized_height / TOKEN_DIVISOR) *
        (resized_width / TOKEN_DIVISOR)
    )
    # Add visual marker tokens (<|vision_bos|> and <|vision_eos|>)
    video_token += VISION_SPECIAL_TOKENS

    if verbose:
        print(f"Original video frame dimensions: {height}x{width}, Model input dimensions: {resized_height}x{resized_width}, ", end="")

    return video_token

if __name__ == "__main__":
    try:
        video_token = calculate_video_tokens("xxx/test.jpg", nframes=30)
        print(f"Video tokens: {video_token}\n")
    except Exception as e:
        print(f"Error: {str(e)}\n")
Avant d'affiner un modèle
-
Bien que l'affinage des modèles de génération de texte permette d'obtenir d'excellents résultats dans des scénarios métier spécifiques, cette approche présente les limites suivantes :
- Durée importante : Cela inclut la création d'un jeu de données CPT à grande échelle (au moins 50 millions de tokens), la constitution d'un jeu de données SFT efficace (plus de 1 000 entrées), la collecte d'un nombre suffisant de cas négatifs (plus de 100) pour élaborer un jeu de données DPO pertinent destiné à la facturation du déploiement de modèle, ainsi que la lenteur des itérations d'optimisation du modèle.
- Coût élevé : Un modèle affiné ne peut être utilisé qu'après son déploiement, et la facturation du déploiement de modèle est onéreuse.
-
Alibaba Cloud Model Studio recommande d'essayer en premier lieu le Prompt Engineering ou le Function Calling pour personnaliser votre application. L'affinage de modèle constitue généralement le « dernier recours » pour améliorer les performances. En effet :
- Dans de nombreuses tâches, un modèle peut initialement offrir des résultats médiocres, mais l'application de techniques de prompt appropriées permet d'améliorer ces résultats sans nécessiter d'affinage.
- L'optimisation itérative des prompts et des plugins s'avère plus agile et plus rentable que les itérations d'affinage, car l'affinage peut exiger une nouvelle collecte, un nettoyage et une optimisation des données, ainsi que le recueil de cas négatifs et la réalisation d'enquêtes clients.
- Même si vous décidez finalement de procéder à un affinage, le travail initial sur l'ingénierie des prompts et l'optimisation des plugins ne sera pas perdu. Ces travaux préliminaires peuvent être entièrement réutilisés lors de la constitution du jeu de données d'affinage.
Prise en main
Affiner un modèle via la console
| Étapes d'affinage | Capture d'écran de la console |
|---|---|
Étape 1 : Sur la page Model Fine-tuning, cliquez sur Create Training Task. | 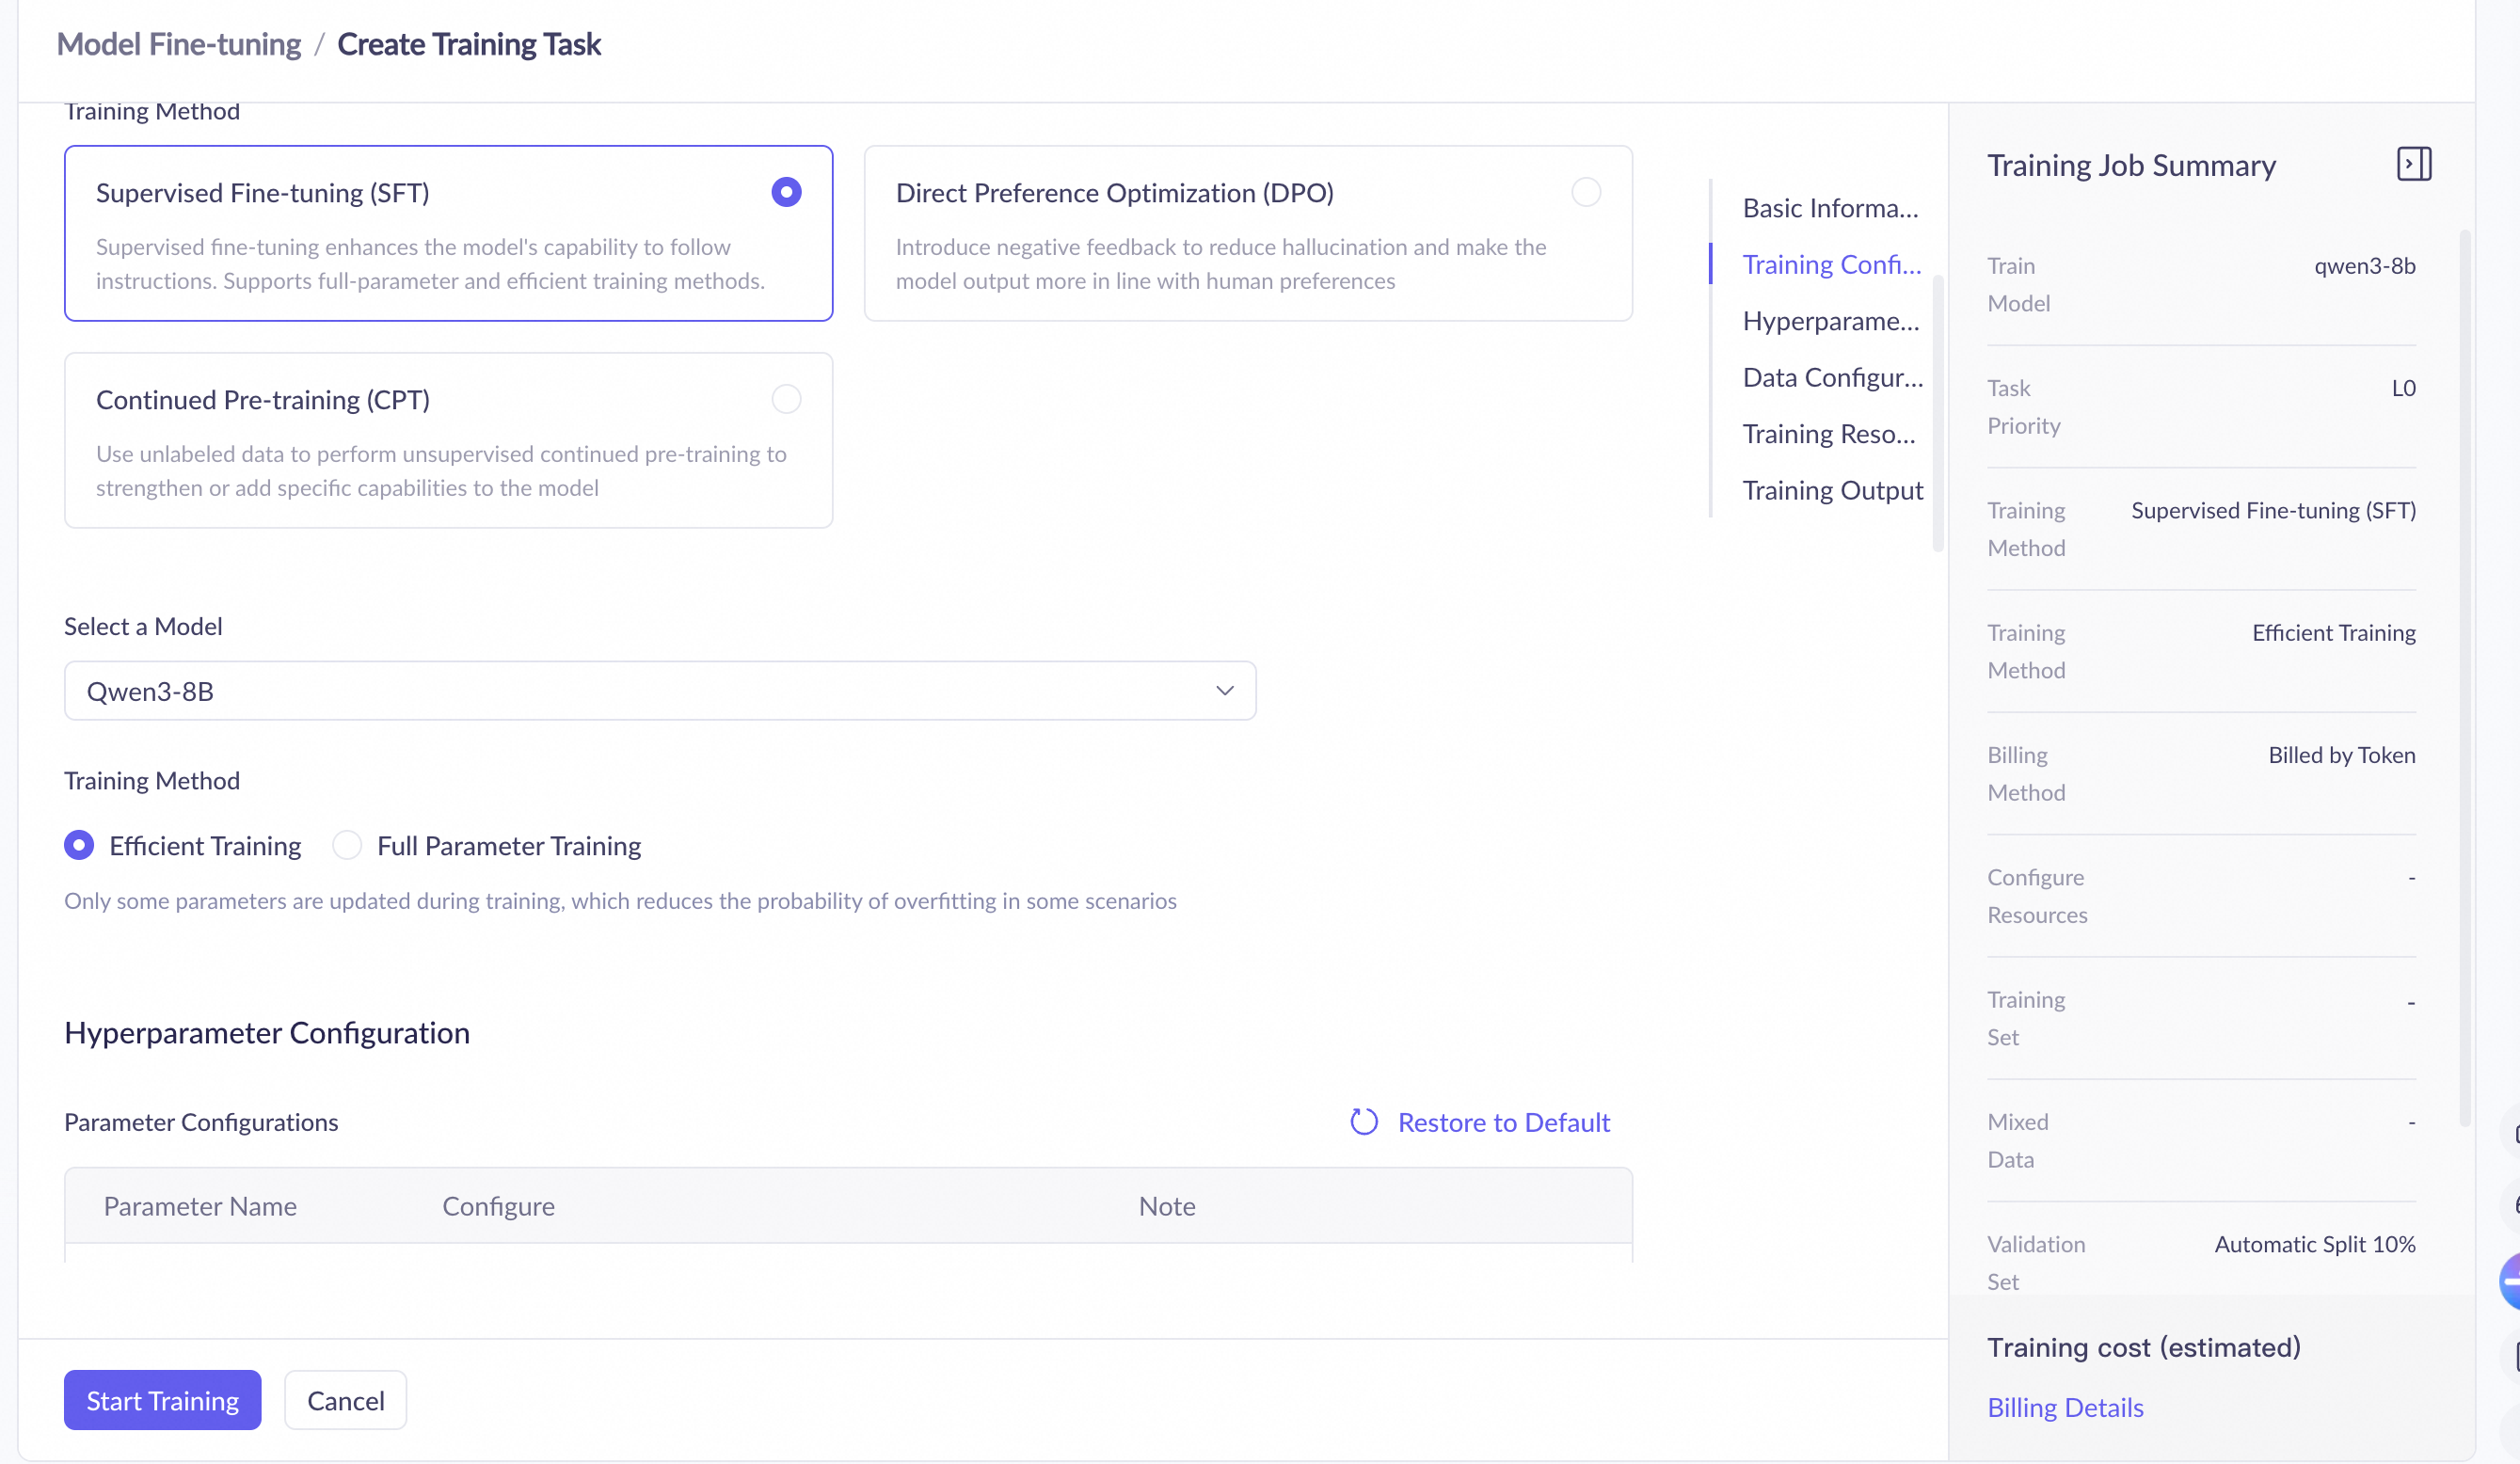 |
Étape 2 : Configurer l'entraînement
Cette combinaison offre un temps d'entraînement court et des exigences réduites en matière de données. | |
Étape 3 : Configurer les données
| 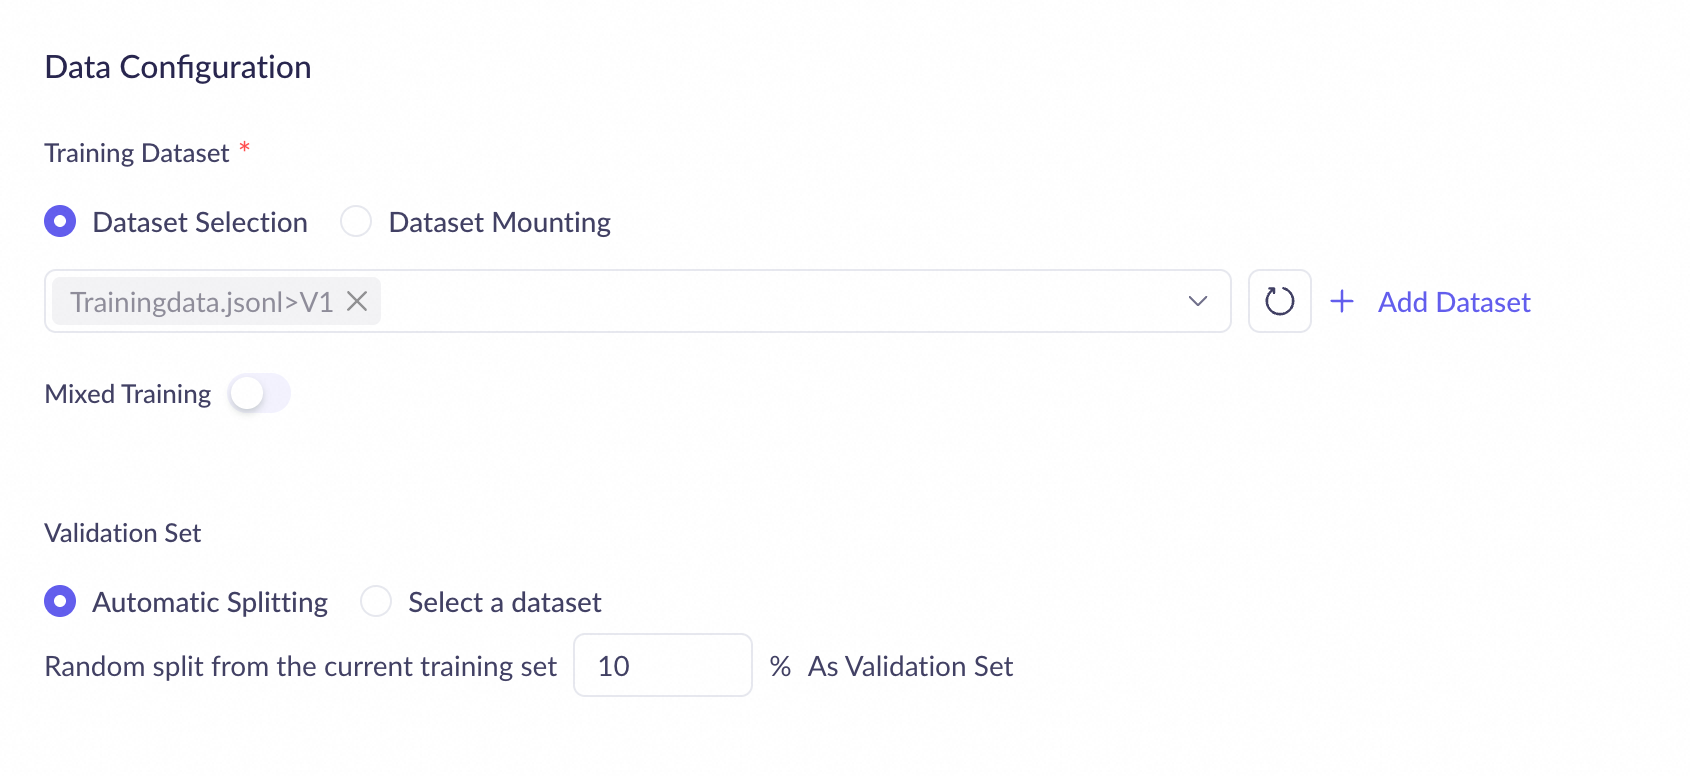 |
Étape 4 : Configurer les paramètres de sauvegarde des snapshots de paramètres du modèle (checkpoint)
RemarqueUne fois l'affinage du modèle terminé, vous pouvez exporter un snapshot de paramètres sur la plateforme Model Studio. Vous pouvez ensuite déployer le modèle sur Model Studio à partir de ce snapshot de paramètres. Les snapshots de paramètres exportés sont stockés dans le stockage cloud et ne peuvent être ni consultés ni téléchargés. | 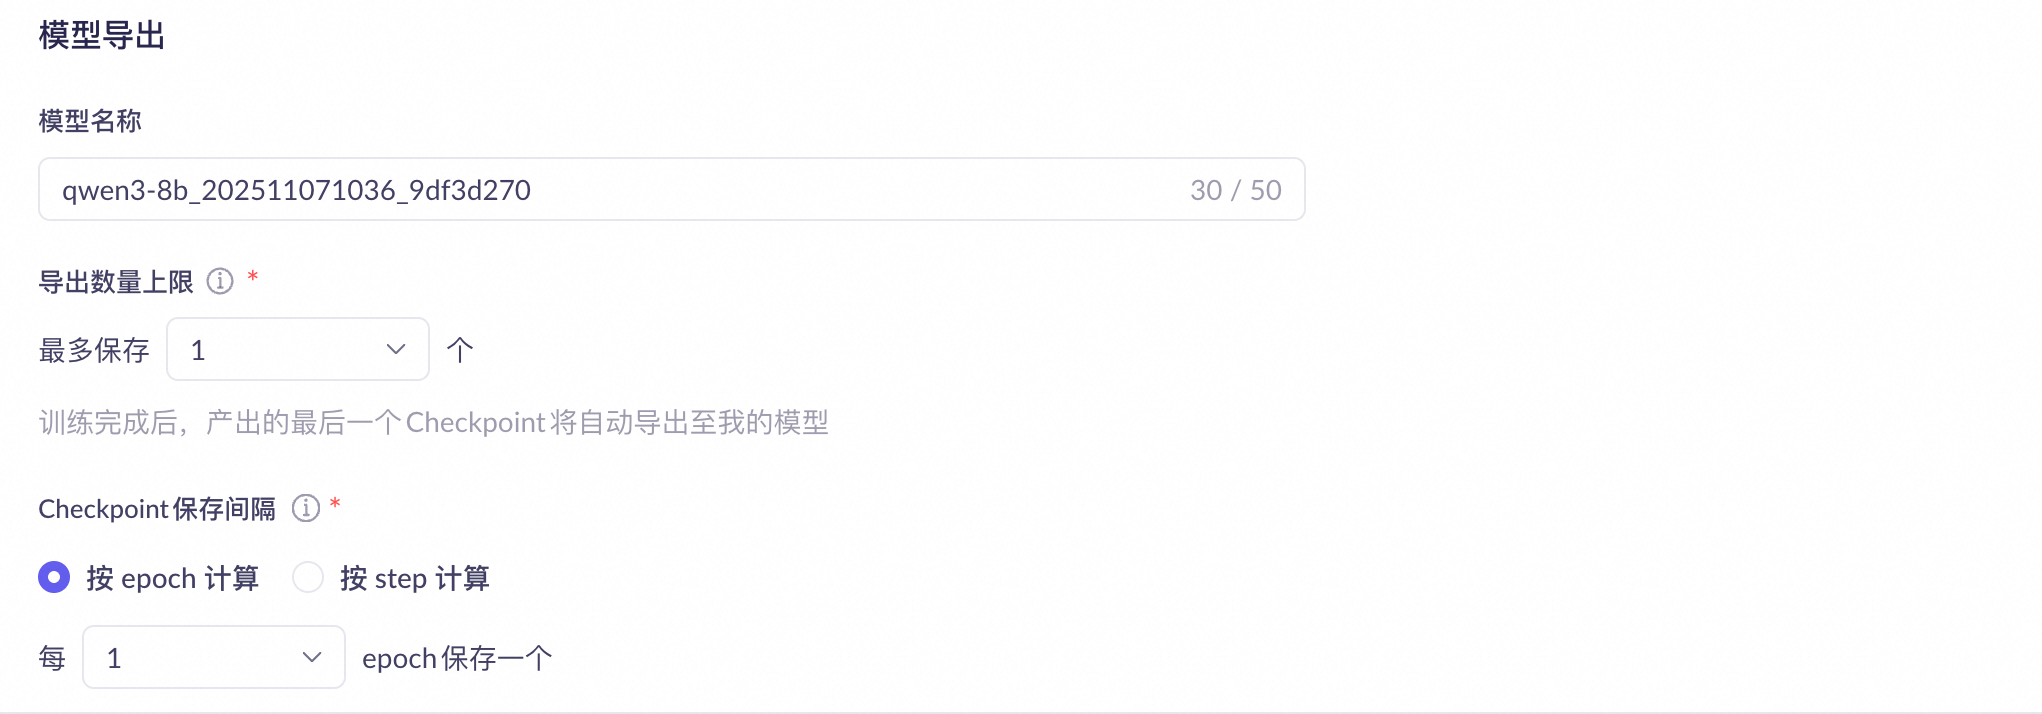 |
Étape 5 : Cliquez sur « Start Training » et attendez la fin de l'entraînement du modèle. | |
Étape 6 : Utilisez la fonctionnalité Model Deployment d'Alibaba Cloud Model Studio pour déployer le modèle personnalisé entraîné. Après le déploiement, vous pouvez évaluer le modèle affiné. Pour plus d'informations, consultez Déploiement de modèle. | |
Processus typique d'affinage
Les trois méthodes d'affinage proposées par Model Studio ne s'excluent pas mutuellement ; elles sont progressives et complémentaires.
CPT (facultatif) → SFT → DPO (facultatif)
-
CPT (Continual Pre-Training) - Complète les connaissances (Les modèles généraux possèdent des connaissances vastes mais peu profondes, qui peuvent ne pas répondre aux exigences de précision et de profondeur des domaines spécialisés)
- Modèle financier :
Apprend la terminologie financière - Modèle médical :
Mémorise la pathologie médicamenteuse - Modèle juridique :
Comprend les articles de loi et la jurisprudence
- Modèle financier :
-
SFT (Supervised Fine-Tuning) - Apprend à exécuter des tâches
- Bot de service client :
Apprend les procédures de service client - Assistant de code :
Apprend les paradigmes de programmation - Appel d'outils (Agent) :
Apprend à utiliser MCP
- Bot de service client :
-
DPO (Direct Preference Optimization) - Exécute mieux les tâches
- Sécurité et responsabilité :
Rejette les suggestions nuisibles - Concision et efficacité :
Fournit des réponses concises - Objectivité et neutralité :
Évalue de manière juste et objective
- Sécurité et responsabilité :
Format des données d'affinage
Jeu d'entraînement SFT
Les données d'entraînement au format SFT ChatML (Chat Markup Language) prennent en charge les conversations multi-tours et divers paramétrages de rôles.
Les paramètres OpenAI
nameetweightne sont pas pris en charge. Toutes les sorties assistant seront entraînées.
# A single line of training data (in JSON format) has the following typical structure when expanded:
{"messages": [
  {"role": "system", "content": "System input 1"},
  {"role": "user", "content": "User input 1"},
  {"role": "assistant", "content": "Expected model output 1"},
  {"role": "user", "content": "User input 2"},
  {"role": "assistant", "content": "Expected model output 2"}
  ...
]}
Pour plus d'informations sur les différences entre system, user et assistant, consultez Vue d'ensemble. Jeux de données d'entraînement exemples : SFT-ChatML_format_example.jsonl, SFT-ChatML_format_example.xlsx. Les formats XLS et XLSX ne prennent en charge que les conversations à tour unique.
Toutes les lignes assistant d'une seule entrée de données d'entraînement prennent en charge le paramètre "loss_weight", qui définit l'importance relative de cette ligne pendant l'entraînement. (Plage : de 0.0 à 1.0. Une valeur plus élevée indique une importance supérieure.)
Ce paramètre est disponible en avant-première sur invitation. Pour l'utiliser, contactez votre gestionnaire de compte.
 {"role": "assistant", "content": "Expected model output 1", "loss_weight": 1.0},
 {"role": "assistant", "content": "Expected model output 2", "loss_weight": 0.5}
Conseils pour la constitution des jeux de données
Exigences relatives à la taille du jeu de données
Pour le CPT, le jeu de données nécessite au moins 50 millions de tokens de données de pré-entraînement de haute qualité. Pour le SFT, il faut au moins 1 000 entrées de données d'affinage de haute qualité. Pour le DPO, le jeu de données requiert généralement plusieurs centaines d'entrées de données de préférences humaines. Si les résultats de l'évaluation du modèle après affinage des données ne sont pas satisfaisants, le moyen le plus simple d'améliorer les performances consiste à collecter davantage de données pour l'entraînement.
Si vous manquez de données, nous vous recommandons de créer une application agent et d'utiliser un index de base de connaissances pour renforcer les capacités du modèle. Dans de nombreux scénarios métier complexes, vous pouvez également combiner l'affinage de modèle et la récupération via base de connaissances.
Par exemple, dans un scénario de service client, vous pouvez utiliser l'affinage de modèle pour corriger le ton de l'agent, ses styles d'expression et sa conscience de soi. Les connaissances professionnelles liées au scénario peuvent être introduites dynamiquement dans le contexte du modèle via une base de connaissances.
Alibaba Cloud Model Studio recommande de commencer par créer et tester une application de génération augmentée par récupération (RAG). Après avoir collecté suffisamment de données d'application, vous pourrez alors utiliser l'affinage de modèle pour améliorer encore les performances du modèle.
Vous pouvez également recourir aux stratégies suivantes pour enrichir votre jeu de données :
- Utilisez un grand modèle linguistique (LLM) pour simuler la génération de contenu adapté à des scénarios métier spécifiques, afin de produire davantage de données pour l'affinage. (Nous recommandons de sélectionner un modèle plus volumineux et performant pour la génération.)
- Acquérez davantage de données par divers moyens, tels que la collecte à partir de scénarios d'application, l'extraction Web, les réseaux sociaux et forums en ligne, les jeux de données publics, les partenaires et ressources sectorielles, ainsi que les contributions des utilisateurs.
Diversité et équilibre des données
Les exigences en matière d'affinage de modèle varient selon le scénario. Par exemple, le professionnalisme est crucial pour des scénarios métier spécifiques, tandis que la polyvalence prime dans les scénarios de questions-réponses. Vous devez concevoir des cas d'utilisation des données en fonction des modules métier ou des contextes d'usage dont le modèle a la charge. Ainsi, l'efficacité de l'entraînement dépend non seulement du volume de données, mais aussi du professionnalisme et de la diversité des données adaptées au scénario visé.
À titre d'exemple, dans un scénario de conversation IA intelligente, un jeu de données professionnel et diversifié devrait couvrir les cas métier suivants :
Activité spécifique | Scénarios/activités diversifiés |
|---|---|
Service client e-commerce | Notifications promotionnelles, conseil avant-vente, accompagnement pendant la vente, service après-vente, suivi post-vente, gestion des réclamations, etc. |
Services financiers | Conseil en prêt, conseils en investissement et gestion de patrimoine, services de carte de crédit, gestion de comptes bancaires, etc. |
Santé en ligne | Consultation sur les symptômes, prise de rendez-vous, instructions de visite, renseignements sur les médicaments, conseils de santé, etc. |
Secrétaire IA | Informations informatiques, informations administratives, informations RH, demandes sur les avantages sociaux, consultations du calendrier de l'entreprise, etc. |
Assistant de voyage | Planification de voyage, guides d'entrée et de sortie, conseil en assurance voyage, présentations des coutumes et cultures locales, etc. |
Conseiller juridique d'entreprise | Examen de contrats, protection de la propriété intellectuelle, vérifications de conformité, questions-réponses sur le droit du travail, conseil en transactions transfrontalières, analyse juridique de cas individuels, etc. |
Il est également important de noter que la quantité de données pour chaque scénario/activité doit être relativement équilibrée, et que la proportion des données doit correspondre à la proportion réelle du scénario. Cela évite d'avoir trop de données d'un seul type, ce qui pourrait amener le modèle à privilégier l'apprentissage de ces caractéristiques au détriment de sa capacité de généralisation.
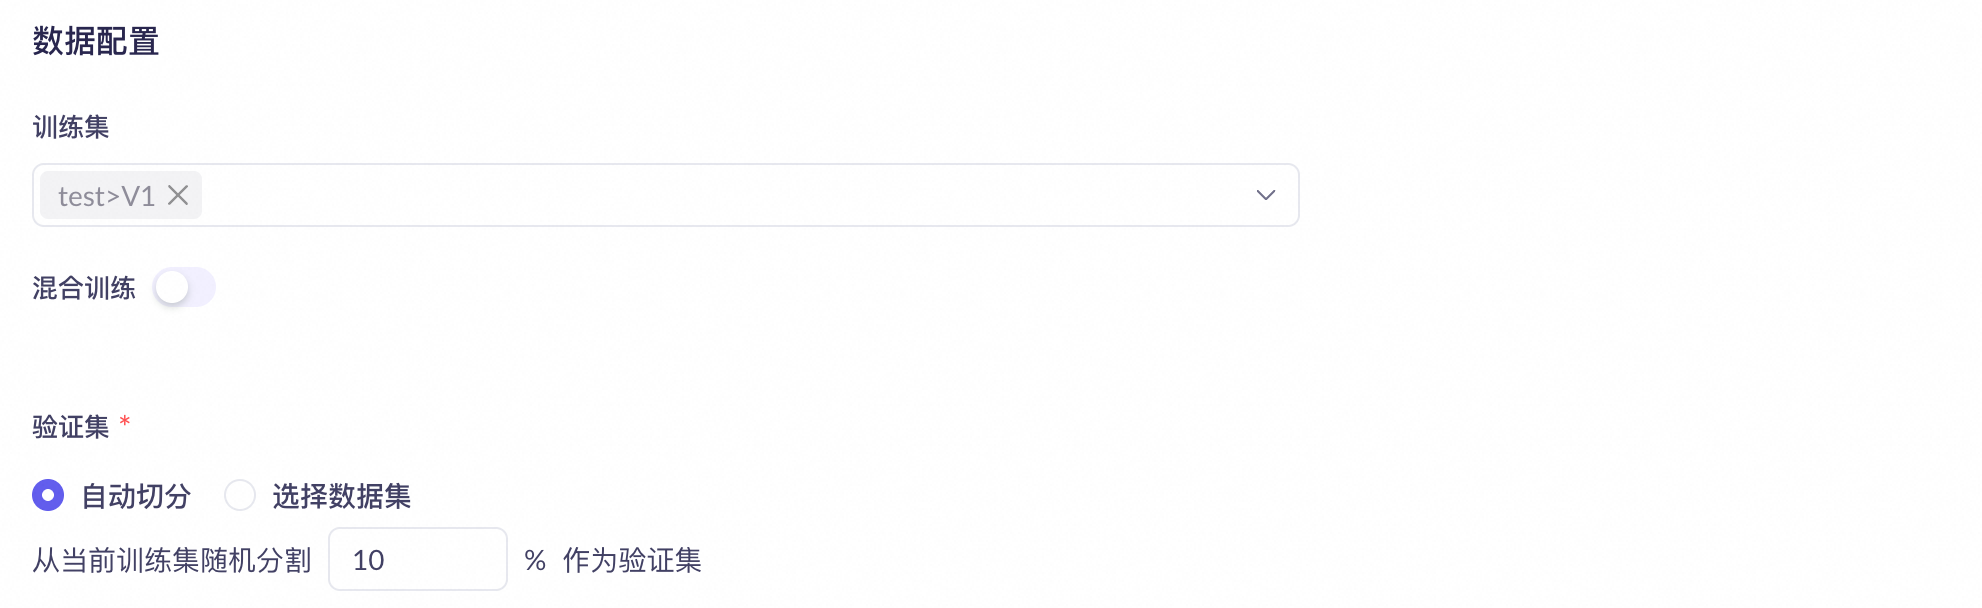
Séparation des jeux d'entraînement et de validation
Le réglage fin du modèle s'effectue directement dans la console.
- Séparez automatiquement un jeu de données d'entraînement complet et échantillonnez aléatoirement une petite quantité de données pour constituer un jeu de validation.
- Choisissez d'importer un jeu de données distinct.
Pendant l'entraînement, la console affiche en temps réel la perte du jeu de validation ainsi que la précision des tokens.
FAQ
Puis-je effectuer le réglage fin de mon propre modèle ?
Model Studio ne permet ni le réglage fin, ni l'importation de modèles personnalisés, ni l'exportation de modèles téléchargés.