La Python Software Foundation cessera bientôt de maintenir Python 2. MaxCompute prend désormais en charge Python 3, et plus précisément CPython-3.7.3. Cette rubrique explique comment écrire une fonction d'agrégation définie par l'utilisateur (UDAF) en Python 3.
Structure du code UDAF
Utilisez MaxCompute Studio pour écrire le code d'une fonction d'agrégation définie par l'utilisateur (UDAF) en Python 3. Le code doit contenir les éléments suivants :
-
Importation des modules : obligatoire.
Importez au minimum
from odps.udf import annotateetfrom odps.udf import BaseUDAF. L'instructionfrom odps.udf import annotateimporte le module de signature de fonction, ce qui permet à MaxCompute de reconnaître la signature définie dans le code.from odps.udf import BaseUDAFimporte la classe de base des UDAF Python. Implémentez des méthodes telles queiterate,mergeetterminatedans la classe dérivée.Si le code UDAF doit référencer des ressources de type fichier ou table, incluez
from odps.distcache import get_cache_filepour les ressources de type fichier oufrom odps.distcache import get_cache_tablepour les ressources de type table. -
Signature de fonction : obligatoire.
Le format est
@annotate(<signature>). Lasignaturedéfinit les types de données des paramètres d'entrée et de la valeur de retour de la fonction. Pour plus d'informations sur les signatures de fonction, consultez la section Signature de fonction et types de données. -
Classe Python personnalisée (classe dérivée) : obligatoire.
Cette classe constitue l'unité organisationnelle du code UDAF. Elle définit les variables et les méthodes qui mettent en œuvre votre logique métier. Vous pouvez également référencer des bibliothèques tierces intégrées, des fichiers ou des ressources de type table dans votre code. Pour plus d'informations, consultez les sections Bibliothèques tierces ou Référencer des ressources.
-
Implémentation des méthodes de la classe Python : obligatoire.
L'implémentation de la classe Python comprend les méthodes suivantes. Implémentez-les selon vos besoins.
Définition de la méthode Description BaseUDAF.new_buffer()Renvoie un tampon pour la valeur intermédiaire de la fonction d'agrégation. Le bufferdoit être un objet Marshal, tel qu'une LIST ou un DICT. La taille dubufferne doit pas augmenter avec le volume de données. Dans les cas extrêmes, la taille dubufferaprès sérialisation de l'objet ne doit pas dépasser 2 Mo.BaseUDAF.iterate(buffer[, args, ...])Agrège les argsdans la valeur intermédiairebuffer.BaseUDAF.merge(buffer, pbuffer)Fusionne les valeurs intermédiaires bufferetpbufferet stocke le résultat dansbuffer.BaseUDAF.terminate(buffer)Convertit le bufferen un type de données primitif de MaxCompute SQL.
Le code suivant fournit un exemple d'UDAF.
# Import the function signature module and the base class.
from odps.udf import annotate
from odps.udf import BaseUDAF
# Function signature.
@annotate('double->double')
# Custom Python class.
class Average(BaseUDAF):
# Implement the methods of the Python class.
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
        return buffer[0] / buffer[1]
La figure suivante illustre la logique d'implémentation et le flux de calcul d'une UDAF MaxCompute pour le calcul de la valeur moyenne (
avg
).
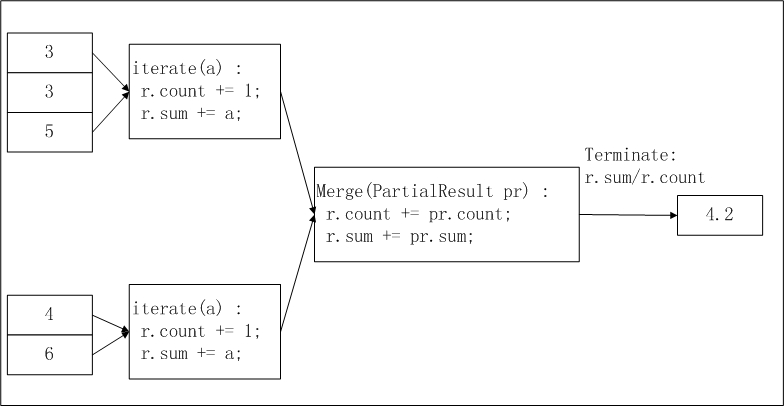
pbuffer
correspond à
pr
dans la figure, et
buffer
correspond à
r
.
La différence entre les UDAF Python 2 et Python 3 réside dans la version sous-jacente de Python. Écrivez votre UDAF en vous basant sur les capacités de la version Python correspondante.
Remarques relatives à l'utilisation
Python 3 n'est pas compatible avec Python 2 et les deux versions ne peuvent pas être utilisées dans la même instruction SQL. Tenez compte de la compatibilité avant d'effectuer la migration.
Python 2 a atteint sa fin de vie (EOL) début 2020. Nous vous recommandons de migrer vos projets en fonction de leur type.
Migration des UDAF Python 2
La Python Software Foundation cessera bientôt de maintenir Python 2. Nous vous recommandons de migrer vos projets en fonction du type de projet :
Nouveaux projets : cela s'applique aux nouveaux projets MaxCompute ou aux projets MaxCompute dans lesquels vous écrivez une UDAF Python pour la première fois. Nous vous recommandons d'écrire toutes les UDAF Python en Python 3.
-
Projets existants : cela s'applique aux projets MaxCompute qui comportent de nombreuses UDAF Python 2 existantes. Activez Python 3 avec prudence. Si vous prévoyez de migrer progressivement toutes les UDAF Python 2 vers Python 3, utilisez les méthodes suivantes :
Nouvelles tâches et nouvelles UDAF : écrivez-les en Python 3 et activez Python 3 au niveau de la session. Pour plus d'informations sur l'activation de Python 3, consultez la section Activer Python 3.
-
UDAF Python 2 : réécrivez les UDAF Python 2 afin qu'elles soient compatibles avec Python 2 et Python 3. Pour plus d'informations sur la réécriture du code, consultez la page Porting Python 2 Code to Python 3.
RemarqueSi vous souhaitez écrire une UDAF publique et accorder des permissions à plusieurs projets MaxCompute pour l'utiliser, nous vous recommandons de rendre l'UDAF compatible avec Python 2 et Python 3.
Activer Python 3
Par défaut, MaxCompute utilise Python 2. Pour utiliser Python 3, incluez l'indicateur de session suivant dans votre instruction SQL.
set odps.sql.python.version=cp37;Bibliothèques tierces
L'environnement d'exécution Python 3 intégré dans MaxCompute n'inclut pas la bibliothèque tierce NumPy. Pour utiliser une UDAF qui nécessite NumPy, vous devez télécharger manuellement le package WHEEL NumPy. Lorsque vous téléchargez le package NumPy depuis PyPI ou un miroir, le nom du fichier du package est numpy-<version_number>-cp37-cp37m-manylinux1_x86_64.whl. Pour plus d'informations sur le téléchargement d'un package, consultez les sections Opérations sur les ressources ou Exemple d'UDF : utiliser un package tiers dans une UDF Python.
Signature de fonction et types de données
La signature de fonction possède le format suivant.
@annotate(<signature>)signature
est une chaîne qui identifie les types de données des paramètres d'entrée et de la valeur de retour. Lors de l'exécution d'une UDAF, les types de données de ses paramètres d'entrée et de sa valeur de retour doivent correspondre aux types spécifiés dans la signature de fonction. Pendant la phase d'analyse de la requête, le système valide l'appel de fonction par rapport à la signature. En cas d'incompatibilité de type, une erreur est signalée. Le format spécifique est le suivant.
'arg_type_list -> type'où :
-
arg_type_list: représente les types de données des paramètres d'entrée. Plusieurs paramètres d'entrée peuvent être spécifiés, séparés par des virgules (,). Les types de données pris en charge sont BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.arg_type_listaccepte également un astérisque (*) ou une chaîne vide ('').Si
arg_type_listest un astérisque (*), cela indique que la fonction accepte n'importe quel nombre de paramètres d'entrée.Si
arg_type_listest une chaîne vide (''), cela indique que la fonction ne possède aucun paramètre d'entrée.
Pour plus d'informations sur la syntaxe étendue de l'annotation Resolve, consultez la section Paramètres dynamiques pour les UDAF et UDTF.
type: représente le type de données de la valeur de retour. Une UDAF renvoie une seule colonne. Les types de données pris en charge incluent BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.
Lorsque vous écrivez du code UDAF, sélectionnez les types de données appropriés en fonction de l'édition de type de données de votre projet MaxCompute. Pour plus d'informations sur les éditions de types de données et les types pris en charge par chaque édition, consultez la section
.
Voici des exemples de signatures de fonction valides.
| Exemple de signature de fonction | Description |
@annotate('bigint,double->string') |
Les types de paramètres d'entrée sont BIGINT et DOUBLE, et le type de valeur de retour est STRING. |
@annotate('*->string') |
La fonction accepte n'importe quel nombre de paramètres d'entrée, et le type de valeur de retour est STRING. |
@annotate('->double') |
La fonction ne possède aucun paramètre d'entrée, et le type de valeur de retour est DOUBLE. |
@annotate('array<bigint>->struct<x:string, y:int>') |
Le type de paramètre d'entrée est ARRAY |
Pour garantir que les types de données dans votre UDAF Python correspondent aux types de données pris en charge par MaxCompute, vous devez utiliser les mappages de types de données corrects. Le tableau suivant décrit ces mappages.
|
Type MaxCompute SQL |
Type Python 3 |
|
BIGINT |
INT |
|
STRING |
UNICODE |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
DATETIME.DATETIME |
|
FLOAT |
FLOAT |
|
CHAR |
UNICODE |
|
VARCHAR |
UNICODE |
|
BINARY |
BYTES |
|
DATE |
DATETIME.DATE |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
Référencer des ressources
Les UDAF Python peuvent référencer des ressources de type fichier et table à l'aide du module odps.distcache.
-
odps.distcache.get_cache_file(resource_name): renvoie un objet de type fichier pour la ressource de fichier spécifiée.-
resource_nameest de type STRING et correspond au nom d'une ressource de fichier existante dans le projet MaxCompute actuel. Si le nom de la ressource de fichier n'est pas valide ou si la ressource n'existe pas, une exception est levée.RemarquePour accéder à une ressource depuis une UDAF, vous devez déclarer la ressource référencée lors de la création de l'UDAF. Sinon, une erreur est signalée.
La valeur de retour est un objet de type fichier. Après avoir utilisé cet objet, appelez la méthode
closepour libérer le fichier de ressource ouvert.
-
-
odps.distcache.get_cache_table(resource_name): renvoie un objet générateur pour la ressource de table spécifiée.resource_nameest de type STRING et correspond au nom d'une ressource de table existante dans le projet MaxCompute actuel. Si le nom de la ressource de table n'est pas valide ou si la ressource n'existe pas, une exception est levée.La valeur de retour est de type GENERATOR. L'appelant parcourt le générateur pour récupérer le contenu de la table. Chaque itération renvoie un enregistrement de la table sous forme de tableau.
Pour plus d'informations sur l'utilisation, consultez les sections Référencer des ressources (UDF Python 3) et Référencer des ressources (UDTF Python 3).
Remarques relatives à l'utilisation
Après avoir développé une UDAF Python 3 en suivant le flux de développement, vous pouvez l'appeler dans une instruction SQL MaxCompute. Les méthodes d'appel sont les suivantes :
Utiliser une UDF dans un projet MaxCompute : la méthode est similaire à celle utilisée pour les fonctions intégrées. Vous pouvez utiliser une fonction définie par l'utilisateur de la même manière qu'une fonction intégrée.
Utiliser une UDF entre projets : utilisez une UDF du projet B dans le projet A. L'instruction suivante montre un exemple :
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Pour plus d'informations sur le partage entre projets, consultez la section Accès aux ressources entre projets basé sur les packages.
Pour la procédure complète de développement et d'appel d'une UDAF Python 3 à l'aide de MaxCompute Studio, consultez la section Développer une UDF Python.
Paramètres dynamiques pour les UDAF
Signature de fonction
Pour plus d'informations sur le format de la signature de fonction d'une UDAF Python, consultez la section Signature de fonction et types de données.
-
Vous pouvez utiliser un astérisque (
*) dans la liste des paramètres pour accepter des paramètres d'entrée en nombre et de type quelconques. Par exemple,@annotate('double,*->string')indique que le premier paramètre est de type DOUBLE, suivi d'une liste de paramètres en nombre et de type quelconques. Dans ce cas, vous devez écrire du code pour déterminer le nombre et les types des paramètres d'entrée, puis effectuer les opérations correspondantes. Cela ressemble à la fonctionprintfdu langage C.RemarqueUn astérisque (
*) a une signification différente lorsqu'il est utilisé dans la liste des valeurs de retour. -
Vous pouvez utiliser un astérisque (
*) dans la valeur de retour d'une UDTF pour indiquer un nombre quelconque de valeurs de retour de type STRING. Le nombre de valeurs de retour dépend du nombre d'alias définis lors de l'appel de la fonction. Par exemple, pour@annotate("bigint,string->double,*"), la méthode d'appel estUDTF(x, y) as (a, b, c). Dans cet exemple, trois alias sont définis aprèsas:a,betc. L'éditeur considèreacomme étant de type DOUBLE car le type de la première colonne de la valeur de retour est spécifié dans l'annotation, et considèrebetccomme étant de type STRING. Étant donné que trois valeurs de retour sont spécifiées, lorsque l'UDTF appelleforward,forwarddoit être un tableau de longueur 3. Sinon, une erreur d'exécution se produit.RemarqueCe type d'erreur ne peut pas être signalé au moment de la compilation. Par conséquent, lorsque l'appelant de l'UDTF définit le nombre d'alias dans l'instruction SQL, il doit respecter les règles définies par l'UDTF. Étant donné que le nombre de valeurs de retour pour une fonction d'agrégation est fixé à 1, cette fonctionnalité ne s'applique pas à une UDAF.
Exemple d'UDAF
from odps.udf import annotate
from odps.udf import BaseUDAF
@annotate('bigint,*->string')
class MultiColSum(BaseUDAF):
    def new_buffer(self):
        return [0]
    def iterate(self, buffer, *args):
        for arg in args:
            buffer[0] += int(arg)
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
    def terminate(self, buffer):
        return str(buffer[0])
Une UDAF ne peut avoir qu'une seule valeur de retour. Dans l'exemple d'UDAF précédent, la valeur de retour est la somme de plusieurs paramètres d'entrée, qui est ensuite agrégée et additionnée sur plusieurs lignes. Le code suivant fournit un exemple d'utilisation.
-- Sums multiple input parameters.
SELECT my_multi_col_sum(a,b,c,d,e) from values (1,"2","3","4","5"), (6,"7","8","9","10") t(a,b,c,d,e);
-- The return value is 55.