MaxCompute utilise Python 2.7. Cette rubrique explique comment écrire une fonction d'agrégation définie par l'utilisateur (UDAF) en Python 2.
Structure du code UDAF
Utilisez
pour écrire une UDAF en Python 2. Le code doit inclure les composants suivants :
-
Déclaration d'encodage : facultative.
Le format de déclaration est
#coding:utf-8ou# -*- coding: utf-8 -*-. Ces deux formats sont équivalents. Si votre code Python 2 contient des caractères chinois, une erreur se produit lors de l'exécution du programme. Ajoutez une déclaration d'encodage au début du code. -
Importation de modules : obligatoire.
Importez au moins
from odps.udf import annotateetfrom odps.udf import BaseUDAF. L'instructionfrom odps.udf import annotateimporte le module de signature de fonction, ce qui permet à MaxCompute de reconnaître la signature de fonction définie dans le code.from odps.udf import BaseUDAFimporte la classe de base pour les UDAF Python. Implémentez des méthodes telles queiterate,mergeetterminatedans la classe dérivée.Si le code UDAF doit référencer des ressources de type fichier ou table, incluez
from odps.distcache import get_cache_filepour les ressources de type fichier oufrom odps.distcache import get_cache_tablepour les ressources de type table. -
Signature de fonction : obligatoire.
Le format est
@annotate(<signature>).signaturedéfinit les types de données des paramètres d'entrée et de la valeur de retour. Pour plus d'informations sur les signatures de fonction, consultez la section Signature de fonction et types de données. -
Classe Python personnalisée (classe dérivée) : obligatoire.
Il s'agit de la structure principale du code UDAF. Elle définit les variables et les méthodes qui mettent en œuvre votre logique métier. Vous pouvez également référencer des bibliothèques tierces intégrées ou des ressources telles que des fichiers et des tables dans votre code. Pour plus d'informations, consultez les sections Bibliothèques tierces ou Référencement de ressources.
-
Implémentation des méthodes de classe Python : obligatoire.
L'implémentation de la classe Python comprend les méthodes suivantes. Implémentez les méthodes selon vos besoins.
Définition de la méthode Description BaseUDAF.new_buffer()Renvoie un tampon pour la valeur intermédiaire de la fonction d'agrégation. Le bufferdoit être un objet Marshal, tel qu'une LIST ou un DICT. La taille dubufferne doit pas augmenter avec le volume de données. Dans les cas extrêmes, la taille dubufferaprès sérialisation de l'objet ne doit pas dépasser 2 Mo.BaseUDAF.iterate(buffer[, args, ...])Agrège les argsdans la valeur intermédiairebuffer.BaseUDAF.merge(buffer, pbuffer)Fusionne les valeurs intermédiaires bufferetpbufferet stocke le résultat dansbuffer.BaseUDAF.terminate(buffer)Convertit le bufferen un type de données primitif de MaxCompute SQL.
Le code suivant fournit un exemple d'UDAF.
#coding:utf-8
# Import the function signature module and the base class.
from odps.udf import annotate
from odps.udf import BaseUDAF
# Function signature.
@annotate('double->double')
# Custom Python class.
class Average(BaseUDAF):
# Implement the methods of the Python class.
    def new_buffer(self):
        return [0, 0]
    def iterate(self, buffer, number):
        if number is not None:
            buffer[0] += number
            buffer[1] += 1
    def merge(self, buffer, pbuffer):
        buffer[0] += pbuffer[0]
        buffer[1] += pbuffer[1]
    def terminate(self, buffer):
        if buffer[1] == 0:
            return 0.0
        return buffer[0] / buffer[1]
La figure suivante illustre la logique d'implémentation et le flux de calcul d'une UDAF MaxCompute pour le calcul de la valeur moyenne (
avg
).
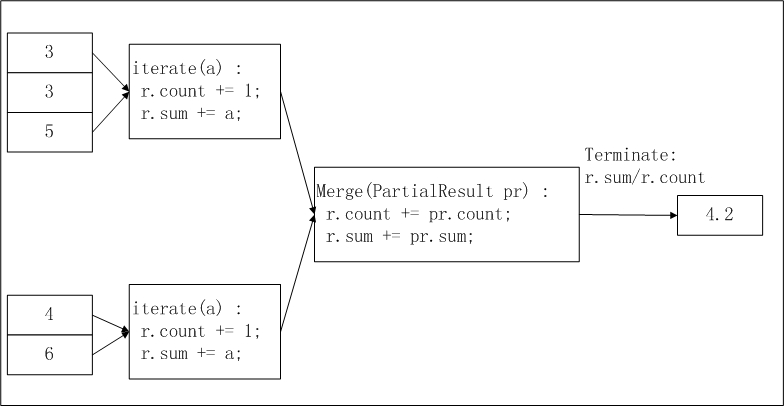
pbuffer
correspond à
pr
dans la figure, et
buffer
correspond à
r
.
Limites
Les UDAF Python 2 de MaxCompute utilisent Python 2.7 et exécutent le code utilisateur dans un environnement sandbox restreint. Les comportements suivants sont interdits :
Lire des données depuis des fichiers locaux et y écrire des données.
Démarrer des sous-processus.
Démarrer des threads.
Activer la communication socket.
Utiliser d'autres systèmes pour appeler des UDF Python 2.
En raison de ces limites, le code que vous téléchargez doit être écrit à l'aide des bibliothèques standard Python. Si des modules ou des modules d'extension C des bibliothèques standard Python sont impliqués dans les opérations précédentes, ces modules ne peuvent pas être utilisés. Tenez compte des points suivants concernant les modules des bibliothèques standard Python :
Tous les modules implémentés sur la base des bibliothèques standard Python et ne dépendant pas de modules d'extension sont disponibles.
-
Les modules d'extension C suivants sont disponibles :
array et audioop
binascii et bisect
cmath, _codecs_cn, _codecs_hk, _codecs_iso2022, _codecs_jp, _codecs_kr, _codecs_tw, _collections et cStringIO
datetime
_functools et future_builtins
_heapq et _hashlib
itertools
_json
_locale et _lsprof
math, _md5 et _multibytecodec
operator
_random
_sha256, _sha512, _sha, _struct et strop
time
unicodedata
_weakref
cPickle
Lorsque vous exécutez du code UDF dans un environnement sandbox, la taille maximale des données pouvant être écrites dans la sortie standard (sys.stdout) ou la sortie d'erreur standard (
sys.stderr) est de 20 Ko. Si la taille dépasse 20 Ko, les caractères supplémentaires sont ignorés.
Bibliothèques tierces
Des bibliothèques tierces, telles que NumPy, sont installées dans l'environnement Python 2 de MaxCompute en complément des bibliothèques standard.
L'utilisation de bibliothèques tierces est soumise à certaines limites. Par exemple, lorsque vous utilisez une bibliothèque tierce, vous n'êtes pas autorisé à accéder aux données locales et vous ne pouvez utiliser que des ressources d'E/S réseau limitées. Les API associées dans les bibliothèques tierces sont désactivées.
Signature de fonction et types de données
La signature de fonction possède le format suivant.
@annotate(<signature>)signature
est une chaîne qui identifie les types de données des paramètres d'entrée et de la valeur de retour. Lorsque vous exécutez une UDAF, les types de données de ses paramètres d'entrée et de sa valeur de retour doivent correspondre aux types spécifiés dans la signature de fonction. Lors de la phase d'analyse de la requête, le système valide l'appel de fonction par rapport à la signature de fonction. En cas d'incompatibilité de type, une erreur est signalée. Le format spécifique est le suivant.
'arg_type_list -> type'où :
-
arg_type_list: représente les types de données des paramètres d'entrée. Plusieurs paramètres d'entrée peuvent être spécifiés, séparés par des virgules (,). Les types de données pris en charge sont BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.arg_type_listprend également en charge un astérisque (*) ou une chaîne vide ('').Si
arg_type_listest un astérisque (*), cela indique que la fonction accepte n'importe quel nombre de paramètres d'entrée.Si
arg_type_listest une chaîne vide (''), cela indique que la fonction n'a aucun paramètre d'entrée.
Pour plus d'informations sur la syntaxe étendue de l'annotation Resolve, consultez la section Paramètres dynamiques pour les UDAF et UDTF.
type: représente le type de données de la valeur de retour. Une UDAF renvoie une seule colonne. Les types de données pris en charge incluent BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.
Lorsque vous écrivez du code UDAF, sélectionnez les types de données appropriés en fonction de l'édition de type de données de votre projet MaxCompute. Pour plus d'informations sur les éditions de types de données et les types de données pris en charge par chaque édition, consultez la section
.
Voici des exemples de signatures de fonction valides.
| Exemple de signature de fonction | Description |
@annotate('bigint,double->string') |
Les types de paramètres d'entrée sont BIGINT et DOUBLE, et le type de valeur de retour est STRING. |
@annotate('*->string') |
La fonction accepte n'importe quel nombre de paramètres d'entrée, et le type de valeur de retour est STRING. |
@annotate('->double') |
La fonction n'a aucun paramètre d'entrée, et le type de valeur de retour est DOUBLE. |
@annotate('array<bigint>->struct<x:string, y:int>') |
Le type de paramètre d'entrée est ARRAY |
Pour garantir que les types de données dans votre UDAF Python sont cohérents avec les types de données pris en charge par MaxCompute, vous devez utiliser les mappages de types de données corrects. Le tableau suivant décrit ces mappages.
|
Type de données MaxCompute SQL |
Type de données Python 2 |
|
BIGINT |
INT |
|
STRING |
STR |
|
DOUBLE |
FLOAT |
|
BOOLEAN |
BOOL |
|
DATETIME |
INT |
|
FLOAT |
FLOAT |
|
CHAR |
STR |
|
VARCHAR |
STR |
|
BINARY |
BYTEARRAY |
|
DATE |
INT |
|
DECIMAL |
DECIMAL.DECIMAL |
|
ARRAY |
LIST |
|
MAP |
DICT |
|
STRUCT |
COLLECTIONS.NAMEDTUPLE |
Le type DATETIME pris en charge dans MaxCompute SQL est mappé au type de données Python INT. Une valeur de type INT suit le format UNIX, qui correspond au nombre de millisecondes écoulées depuis le jeudi 1er janvier 1970 à 00:00:00. Vous pouvez traiter les données de type DATETIME à l'aide du module DATETIME des bibliothèques standard Python.
Le paramètre
silentest ajouté àodps.udf.int(value). Si le paramètresilentest défini sur True et que le type de données devaluene peut pas être converti en type INT, None est renvoyé et aucune erreur n'est retournée.NULL dans MaxCompute SQL est mappé à None dans Python 2.
Référencement de ressources
Les UDAF Python peuvent référencer des ressources de type fichier et table à l'aide du module odps.distcache.
-
odps.distcache.get_cache_file(resource_name): renvoie un objet de type fichier pour la ressource de fichier spécifiée.-
resource_nameest de type STRING et correspond au nom d'une ressource de fichier existante dans le projet MaxCompute actuel. Si le nom de la ressource de fichier n'est pas valide ou si la ressource n'existe pas, une exception est levée.RemarquePour accéder à une ressource depuis une UDAF, vous devez déclarer la ressource référencée lors de la création de l'UDAF. Sinon, une erreur est signalée.
La valeur de retour est un objet de type fichier. Après avoir utilisé cet objet, appelez la méthode
closepour libérer le fichier de ressource ouvert.
-
-
odps.distcache.get_cache_table(resource_name): renvoie un objet générateur pour la ressource de table spécifiée.resource_nameest de type STRING et correspond au nom d'une ressource de table existante dans le projet MaxCompute actuel. Si le nom de la ressource de table n'est pas valide ou si la ressource n'existe pas, une exception est levée.La valeur de retour est de type GENERATOR. L'appelant parcourt le générateur pour récupérer le contenu de la table. Chaque itération renvoie un enregistrement de la table sous forme de tableau.
Pour plus d'informations sur l'utilisation des ressources, consultez les sections Référencer des ressources (UDF Python 2) et Référencer des ressources (UDTF Python 2).
Remarques d'utilisation
Après avoir développé une UDAF Python 2 en suivant le
, vous pouvez appeler l'UDAF dans MaxCompute SQL. Vous pouvez appeler l'UDAF de la manière suivante :
Utiliser une UDF dans un projet MaxCompute : la méthode est similaire à celle de l'utilisation des fonctions intégrées. Vous pouvez utiliser une fonction définie par l'utilisateur de la même manière qu'une fonction intégrée.
Utiliser une UDF entre projets : utilisez une UDF du projet B dans le projet A. L'instruction suivante montre un exemple :
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Pour plus d'informations sur le partage entre projets, consultez la section Accès aux ressources entre projets basé sur les packages.
Pour plus d'informations sur le développement et l'appel d'une UDAF Python 2 dans MaxCompute Studio, consultez la section Développer une UDF Python.